
Rozhovory
Nikunj Bajaj, spoluzakladatel a generální ředitel TrueFoundry – série rozhovorů

 Přidejte Unite.AI mezi své preferované zdroje na Google
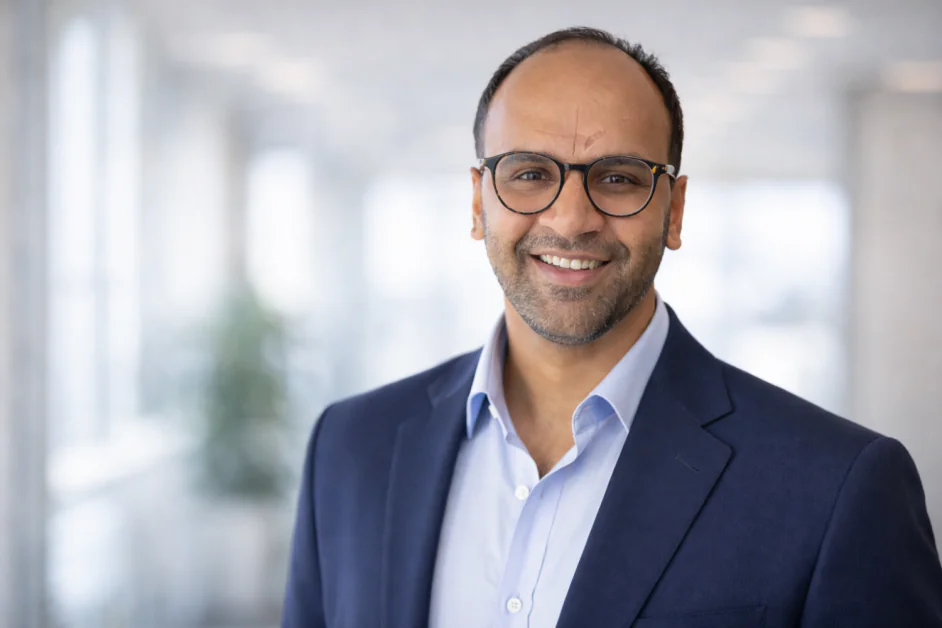
Před založením TrueFoundry jste se věnoval výzkumu strojového učení, produkční AI ve Facebooku (META ) a rozsáhlým doporučovacím systémům. Které zkušenosti vás nejpříměji přivedly k založení firmy zaměřené na infrastrukturu AI pro podniky a jaký problém podle vás tehdy zůstával nevyřešený?
Ve společnosti Meta jsme strojové učení považovali za zvláštní případ softwaru a generativní AI za zvláštní případ strojového učení. Výsledkem byl vertikální technologický stack se softwarem vespod, strojovým učením uprostřed a generativní AI nahoře. V tomto uspořádání se modely, které vytvářím jako vývojář strojového učení, nasazují stejným způsobem jako zbytek softwaru, což výrazně usnadňuje škálování systémů.
Většina podniků však nasazovala paralelní stacky, tedy samostatné stacky pro software, strojové učení a generativní AI. S těmito paralelními stacky se škálování komplikuje kvůli nutnému předávání práce mezi oblastí strojového učení a světem softwaru.
Náš tým vždy pracoval na pomezí vývoje modelů strojového učení a infrastruktury pro strojové učení. Díky této jedinečné perspektivě jsme viděli možnost přinést podobné vertikální stacky do podniků a přizpůsobit je jejich konkrétním požadavkům. Koncem roku 2021 jsme také měli hypotézu, že se strojové učení blíží bodu zlomu. Až k němu dojde, bude více firem potřebovat vertikálně integrovaný stack, aby mohly tyto systémy efektivně nasazovat a škálovat. To nás nakonec vedlo k založení TrueFoundry a naše hypotéza se potvrdila. Po uvedení ChatGPT na konci roku 2022 se zavádění AI urychlilo.
Co se změnilo v tom, jak by organizace měly přemýšlet o spolehlivosti a selháních, když systémy AI přecházejí z experimentů do každodenního provozu?
U generativní AI je v sázce podstatně více než u tradičních systémů strojového učení. Když tyto systémy přecházejí do produkce, organizace se potýkají s mnohem vyšší mírou nejednoznačnosti a nedeterminismu, protože LLM mají ze své podstaty stochastický charakter. Systémy založené na agentech, které na nich stavějí, přidávají další nejednoznačnost.
Selhání navíc už nejsou binární. Nejde jen o to, zda systém funguje, či nefunguje; řada problémů se projevuje jako částečná selhání nebo nenápadné zhoršování. Systémy mohou v průběhu času reagovat s vyšší latencí, nižší kvalitou nebo nesprávným chováním. V mnoha případech se takové zhoršování odhaluje obtížněji a někdy může být ještě škodlivější než úplný výpadek.
Organizace musí uvažovat o spolehlivosti nejen z hlediska doby nepřetržitého provozu, ale také zhoršování výkonu v čase.
TrueFailover byl uveden na trh během vlny výpadků cloudových služeb a služeb AI, které vzbudily velkou pozornost. Které nedávné události jasně ukázaly, že se spolehlivost AI změnila z vítaného doplňku na základní architektonický požadavek?
Jeden z našich zákazníků ve zdravotnictví zpracovává v reálném čase požadavky pacientů týkající se receptů, u nichž záleží na včasném vyřízení. Postihl ho výpadek způsobený selháním modelu. Jeho pracovní postupy generují tisíce dolarů tržeb za sekundu a výpadek některé z těchto kritických postupů narušil. Byl jedním z prvních zákazníků TrueFailover, takže jsme mu mohli pomoci rychle obnovit provoz a dopad se podařilo omezit.
Takové incidenty vyvolávají důležitou otázku: když je u systémů generativní AI v sázce stále více, proč jsou procesy obnovy provozu nadále převážně manuální? Posílilo to názor, že systémy máme budovat s předpokladem, že selhání nastanou, a navrhovat je tak, aby se automaticky opravovaly. Spolehlivost musí být také zabudována přímo do stacku AI pomocí bran AI, které mohou poskytovat centralizované směrování, pozorovatelnost, ochranné mechanismy a inteligentní přepínání mezi modely různých poskytovatelů.
Mnoho výpadků AI je stále líčeno jako drobné technické zádrhele. Kde podle vás začínají být patrné skutečné ekonomické a lidské náklady, když systémy AI přestanou fungovat?
Podniková AI se vyvinula natolik, že tyto zádrhele už neovlivňují jen interní pracovní postupy. Dnes výpadky a zhoršování kvality působí přímo a okamžitě na vnímání veřejnosti i zisky, protože produkční aplikace nyní přímo slouží zákazníkům. Právě tento přechod od interního testování k veřejně používaným aplikacím, u nichž je hodně v sázce, vysvětluje rostoucí potřebu pozornosti a dohledu vrcholového vedení.
S tím, jak se systémy AI hlouběji zapojují do provozních pracovních postupů, přestávají být výpadky pouhým technickým problémem. Stále častěji mají přímé důsledky pro podnikání, zákazníky a pověst firmy.
Jak rychle se v kriticky důležitých prostředích, jako jsou lékárny, zdravotnický provoz nebo zákaznická podpora, může výpadek AI proměnit v provozní riziko či riziko pro pověst firmy?
V kriticky důležitých prostředích dochází k eskalaci téměř okamžitě, protože tyto systémy podporují pracovní postupy v reálném čase, u nichž je zásadní včasné zpracování. I krátké přerušení může zastavit klíčové procesy, zpozdit poskytování služeb nebo narušit navazující systémy závislé na jejich výstupech, a vyvolat tak řetězové provozní dopady v celé organizaci.
V odvětvích, jako je zdravotnictví, přesahuje dopad provozní narušení a zasahuje i zákaznickou zkušenost a výsledky poskytovaných služeb. Pokud si pacient nemůže včas vyzvednout léky na recept, může to mít skutečné následky. Není to problém jen pro pacienta; může to také poškodit pověst lékárny či poskytovatele zdravotní péče. V kriticky důležitých prostředích, kde záleží na důvěře, je nepřetržitý provoz systémů zásadní. Proto si organizace stále více uvědomují, že systémy AI musí být navrženy s předpokladem, že selhání nastanou, a že se mechanismy obnovy musí spouštět automaticky, aby se minimalizovalo riziko.
Řekl jste, že mnoho týmů navrhuje architekturu s ohledem na schopnosti spíše než na nepřetržitý provoz. Proč měla podle vás odolnost historicky nižší prioritu při navrhování systémů AI?
Do značné míry jde o pobídky uvnitř organizací. Nové schopnosti jsou viditelné a vzbuzují nadšení. Umožňují ukázky, funkce a nové možnosti produktu, které vedení může okamžitě vidět.
Nepřetržitý provoz je ze své podstaty neviditelný, když vše funguje dobře. Systémy odměňování proto obvykle více zvýhodňují vydávání nových funkcí než zajišťování toho, aby se nic nepokazilo. Organizace tak často investují nepoměrně více do rozvoje schopností než do technického zajištění odolnosti.
Jaká nová slabá místa přináší do stacku AI rostoucí závislost podniků na externích modelech a API, jejichž význam vedení možná ještě plně nedoceňuje?
LLM jsou ze své podstaty sdílené zdroje a podniky je nevlastní tak jako tradiční infrastrukturu. Důležité systémy kritické pro podnikání navíc běží na externích systémech, které ještě nejsou plně prověřené časem. Samotné LLM se rychle vyvíjejí, což znamená, že poskytovatele modelu nelze činit odpovědným za věci, jako je latence nebo mírný pokles výkonu modelu, protože ve svém výzkumu velmi rychle postupuje v dalších iteracích.
Protože jsou LLM sdílené zdroje, může latence prudce vzrůst, když jiný jejich uživatel provede konkrétní akci. Samotná podstata LLM přináší mnoho takových bodů selhání a podniky v tomto novém světě jednoduše nemají plnou kontrolu. Bez plné kontroly může podnik nejlépe vytvořit dostatečnou redundanci systému, aby navrhl odolný systém.
Když ponecháme stranou konkrétní produkty, jak by organizace měly přehodnotit architekturu AI, aby počítaly se selháním, místo aby výpadky považovaly za vzácné okrajové případy?
Organizace by se měly vrátit k základním principům návrhu distribuovaných systémů. Softwarové systémy se budovaly s předpokladem, že síťové komponenty a stroje budou selhávat a že celý region může přestat fungovat.
U systémů AI by tomu nemělo být jinak. Měli bychom předpokládat, že poskytovatelé modelů zaznamenají problémy s latencí, zhoršení fungování či výpadky, a zahrnout redundanci, aby aplikace zůstaly odolné v různých scénářích selhání.
Očekáváte, že se odolnost AI stane rozhodujícím faktorem při výběru platformy a dodavatele, podobně jako doba nepřetržitého provozu a redundance ovlivnily rozhodování o cloudové infrastruktuře?
S přechodem dalších systémů AI do produkce se odolnost stane minimálním požadavkem. Pokud dodavatel nedokáže předložit grafy a metriky doby nepřetržitého provozu a celkové odolnosti, nebude se o něm ani uvažovat. Jakmile bude odolnost základním očekáváním od všech dodavatelů, rozhodujícími faktory se stanou uživatelská zkušenost, optimalizace výkonu, pozorovatelnost a vyšší úroveň schopností produktu. Časem se součásti, jako je brána AI a automatické přepínání při selhání, stanou základními stavebními prvky podnikové infrastruktury AI.
Co bude do budoucna skutečně znamenat AI „připravená pro produkci“ ve světě, kde se od ní očekává nepřetržitá dostupnost, nikoli jen občasná užitečnost?
Systémy AI připravené pro produkci by měly být pozorovatelné, řiditelné a obnovitelné. Musí splňovat všechny tři podmínky.
Aby byla produkční AI pozorovatelná, potřebují týmy podrobný vhled do chování modelu, latence, četnosti chyb, využití tokenů, driftu a vzorců selhání. Bez silné pozorovatelnosti je velmi obtížné odhalit zhoršování dříve, než si ho začnou všímat uživatelé.
Řiditelnost systémů zahrnuje řízení provozu, omezování frekvence požadavků, ochranné mechanismy, vynucování zásad a inteligentní směrování mezi modely a poskytovateli. Zde se brána AI stává základním prvkem: funguje jako centralizovaná řídicí vrstva, která vynucuje ochranné mechanismy, zajišťuje jednotnou správu a dohled a umožňuje dynamické přepínání modelů při poklesu výkonu nebo spolehlivosti.
A konečně, aby bylo možné obnovit provoz, měly by se systémy budovat s předpokladem, že komponenty mohou být částečně nebo zcela nefunkční, ať už kvůli výpadkům poskytovatele, zhoršené kvalitě modelu, limitům frekvence požadavků nebo neočekávaným vstupům od škodlivých aktérů. Automatické přepínání při selhání a mechanismy samoobnovy by měly být přirozenou součástí architektury, nikoli manuálními postupy spouštěnými až po vzniku problému.
Tímto směrem v TrueFoundry pracujeme. Dodavatelé, kteří takto definují produkční připravenost a spojují pozorovatelnost, centralizované řízení a automatickou obnovu, získají dlouhodobou důvěru zákazníků a budou moci dál řešit nové problémy, jakmile se objeví.
Děkuji za skvělý rozhovor. Čtenáři, kteří se chtějí dozvědět více, mohou navštívit TrueFoundry.


