
Modely a platformy AI
Nová předem připravená (OTS) data od Appen urychlují nasazení umělé inteligence

 Přidejte Unite.AI mezi své preferované zdroje na Google
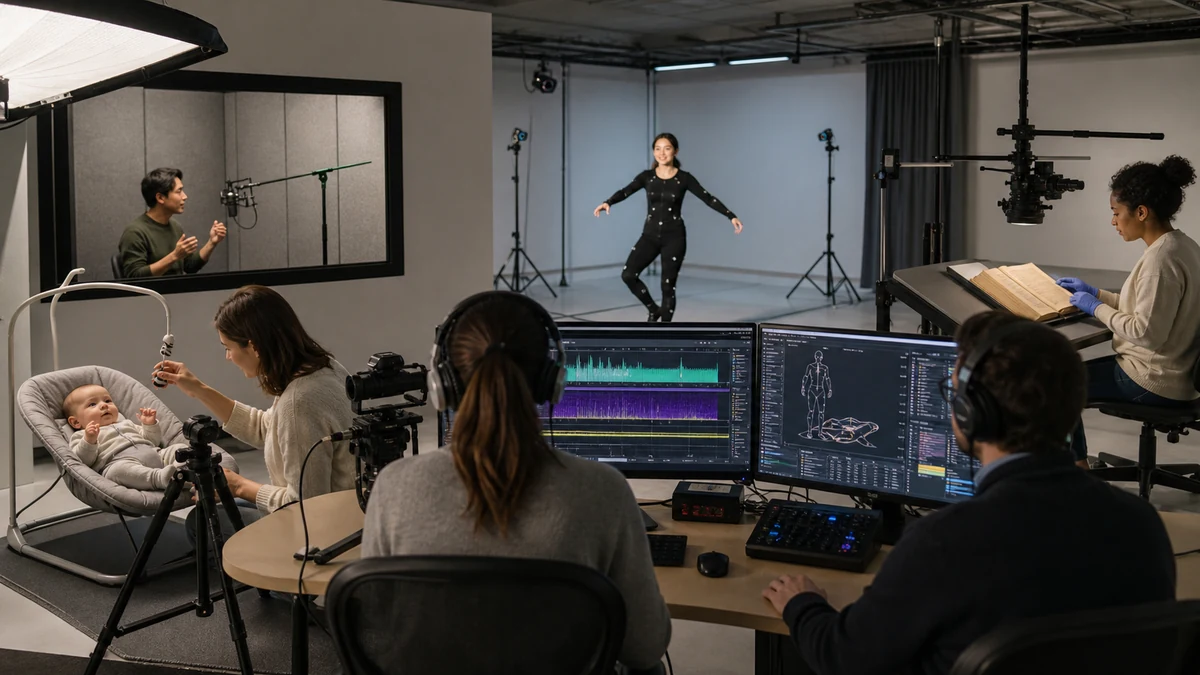
Appen Limited (ASX:APX), přední poskytovatel vysoce kvalitních trénovacích dat pro organizace, které budují efektivní systémy umělé inteligence ve velkém měřítku, dnes oznámil nová předem připravená (OTS) data. Tato data jsou navržena tak, aby usnadnila a urychlila získání vysoce kvalitních trénovacích dat potřebných pro urychlení projektů umělé inteligence (AI) a strojového učení (ML). Nová OTS data zahrnují pohyb lidského těla a inovativní zvuky pláče dětí, stejně jako nahranou řeč a obrázky s textem vhodné pro optické rozpoznávání znaků (OCR) pro vysoce požadované, ale těžko dostupné jazyky, jako je arabština, chorvatština, řečtina, maďarština, thajština a další. S rozšířením dat nabízí Appen více než 250 OTS dat, které zahrnují přes 11 000 hodin audio, přes 25 000 obrázků a přes 8,7 milionu slov ve 80 jazycích a několika dialektech.
OTS data od Appen jsou rychlým a nákladově efektivním nástrojem pro zahájení projektu AI nebo ML s konzistentními vysoce kvalitními trénovacími daty. Týmy, které rozšiřují své schopnosti AI, mohou také využít OTS data k efektivnímu zlepšení přesnosti, vývoji nových dovedností modelů a dalších vylepšení svých modelů AI. OTS datové sady jsou často dodávány do jednoho týdne, například ve srovnání s osmi až dvanácti týdny pro novou sbírku a anotaci dat – nebo ještě déle, v závislosti na složitosti. Všechna data od Appen jsou vyvinuta pomocí plně transparentní, dobrovolné metody, takže specialisté na AI mohou být jistí, že jejich data jsou čistá a souladná, eliminuje se tak potenciální riziko negativní reakce a poškození pověsti.
„Týmy AI po celém světě, které pracují na projektech s těsnými termíny a flexibilními požadavky na data, mohou využít předem připravená data,“ řekl Wilson Pang, technický ředitel Appen. „OTS data zkracují dobu potřebnou k dosažení hodnoty a poskytují přístup k vysoce kvalitním datům za nižší celkové náklady ve srovnání s tradičními metodami. My v Appen podnikáme nezbytné kroky k zajištění toho, aby všechna naše data byla eticky získaná a demograficky vyvážená, což umožňuje společnostem udržovat odpovědnou praxi AI minimalizací biasu ve svých modelech a zajišťováním spravedlivého zacházení s anotátory dat. Vous vždy znáte přesnou kvalitu OTS datové sady, což pomáhá budovat lepší AI, která funguje ve skutečném světě.“
MediaInterface dodává jazykové technologie pro zdravotnické instituce v Německu a dalších částech Evropy již více než 20 let. Když společnost expandovala do Francie, měla plně lokalizovaný software, ale chyběla jí francouzská lexikální data, zejména francouzská jména a místa, která se často odkazují v zdravotních informacích pacientů. Díky OTS datům od Appen získala MediaInterface přibližně 21 000 francouzských jmen a 14 000 místních jmen. „Kritická data z Appen byla začleněna do našeho pozadí lexika, abychom úspěšně spustili na novém trhu, a to nám pomáhá budovat nové slovníky pro naše klienty a posilovat náš přístup pro budoucí spuštění trhu,“ řekl Ines Wendler, produktový manažer ve společnosti MediaInterface.
Nejzkušenější odborníci na AI kombinují OTS data s projekty na vyžádání pro sběr a anotaci dat, aby splnili své komplexní potřeby trénovacích dat pro modely AI. Appen je lídr v poskytování pokračující podpory prostřednictvím řady specifických služeb pro sběr dat, jako je nepřetržitá anotace dat a chytré označení, prostřednictvím nástrojů AI a automatizovaných pracovních postupů, aby se maximalizovala efektivita.
„Interagujeme s AI od okamžiku, kdy se probudíme, až do okamžiku, kdy usneme – prostřednictvím virtuálních asistentů, chatbotů, vyhledávačů, sociálních sítí, zdravotních zařízení, chytrých aut a dalších aplikací,“ řekl Judith Bishop, senior ředitel AI specialistů Appen, který vede tým 100 AI lingvistů a jazykových odborníků. „Jazyk je často primárním rozhraním pro mnoho z těchto přesvědčivých případů použití AI, takže k zajištění skvělé zkušenosti je třeba, aby model byl trénován tak, aby fungoval pro každého. Záväzky Appen k vysoce kvalitním datům a odpovědnému, etickému rozvoji AI umožňují společnostem, které nakupují naše OTS data, urychlit své projekty AI s kompletní důvěrou ve svá data.“
K novým OTS datům Appen, která jsou nyní k dispozici, patří:
- Nahraná řeč pro arabštinu (Egypt), arabštinu (Saúdskou Arábii), arabštinu (Spojené arabské emiráty), centrální khmerštinu (Kambodžu), chorvatštinu, řečtinu, maďarštinu, polštinu, španělštinu (Španělsko) a turečtinu
- OCR obrázků pro tištěný text v jednoduché čínštině, thajštině a finštině – Zahrnuje předem nahrané billboardy, vnější balení, značky, časopisy a menu pro trénování a aktualizaci modelů OCR počítačového vidění
- Pohyb lidského těla (Čína) – Zahrnuje anotované videa lidí v pohybu, sledované na pixelové úrovni, vhodné pro vývoj her, fitness aplikací a další
- Zvuky pláče dětí (Čína) – Zahrnuje předem nahrané a anotované zvuky pláče dětí, které lze použít pro trénování modelů AI k rozpoznání různých zvuků pláče a upozornění rodičů
Pro více informací a vyžádání vzorku OTS dat Appen klikněte sem.


