
Andersonův úhel
Jak by se Stable Diffusion mohl stát spotřebitelským produktem pro širokou veřejnost

 Přidejte Unite.AI mezi své preferované zdroje na Google
Klíčové bodyHlavní aplikace Stable Diffusion musí vyřešit složitou instalaci z příkazové řádky a…
Zobrazit více
- Hlavní aplikace Stable Diffusion musí vyřešit složitou instalaci z příkazové řádky a problémy s závislostmi.
- Komerční vývojáři čelí právním rizikům kvůli generování deepfake obsahu a filtrům NSFW obsahu.
- Pokročilé funkce jako časová konzistence a textuální inverze vyžadují pro spotřebitelské použití cloudové zpracování.
Ironicky, Stable Diffusion, nový rámec syntézy obrazů pomocí umělé inteligence, který zachvátil celý svět, není ani stabilní, ani skutečně „difúzní“ – alespoň zatím ne.
Plný rozsah schopností tohoto systému je rozložen napříč různou směsicí neustále se měnících nabídek od několika vývojářů, kteří si vyměňují nejnovější informace a teorie v různých diskusích na Discordu – a většina instalačních procedur pro balíčky, které vytvářejí nebo upravují, je velmi daleko od „plug and play“.
Spíše vyžadují instalaci přes příkazový řádek nebo soubory BAT prostřednictvím GIT, Conda, Python, Miniconda a dalších špičkových vývojových frameworků – softwarových balíčků, které jsou mezi běžnými spotřebiteli velmi vzácné, takže jejich instalace je často označena antivirovými a anti-malware programy jako důkaz kompromitovaného hostitelského systému.

Pouze malá část etap, které standardní instalace Stable Diffusion v současnosti vyžaduje. Mnoho distribucí také vyžaduje specifické verze Pythonu, které mohou být v konfliktu s již nainstalovanými verzemi na uživatelském počítači – ačkoli to lze obejít pomocí instalačních balíčků založených na Dockeru a do jisté míry pomocí prostředí Conda.
Diskusní vlákna v obou komunitách SFW a NSFW Stable Diffusion je zaplaven tipy a triky souvisejícími s hackováním skriptů Python a standardními instalačními procedurami, aby se umožnilo lepší funkčnost nebo aby se vyřešily časté chyby závislostí a další problémy.
To zanechává průměrného spotřebitele, který se zajímá o vytváření úžasných obrazů z textových podnětů, prakticky na milosti rostoucího počtu komerčních webových rozhraní API, z nichž většina nabízí minimální počet bezplatných generací obrazů před tím, než vyžaduje nákup tokenů.
Kromě toho téměř všechny tyto webové nabídky odmítají generovat NSFW obsah (který může souviset s nepornografickými tématy obecného zájmu, jako je „válka“), který odlišuje Stable Diffusion od cenzurovaných služeb OpenAI DALL-E 2.
‘Photoshop pro Stable Diffusion’
Širší veřejnost, lákaná fantastickými, odvážnými či nadpozemskými obrazy, které denně plní twitterový hashtag #stablediffusion, zřejmě čeká na ‘Photoshop pro Stable Diffusion’ – křížově platformní instalovatelnou aplikaci, která zahrnuje nejlepší a nejmocnější funkčnost architektury Stability.ai, jakož i různé geniální inovace vznikající komunity SD, bez plovoucích oken CLI, nezřetelných a neustále se měnících instalačních a aktualizačních procedur nebo chybějících funkcí.
Co v současnosti máme, je ve většině schopnějších instalací různě elegantní webová stránka s odděleným oknem příkazového řádku a jehož URL je localhost port:

Podobně jako CLI-driven syntéza aplikací, jako je FaceSwap a BAT-centric DeepFaceLab, ‘prepack’ instalace Stable Diffusion ukazuje své kořeny v příkazovém řádku, s rozhraním přístupným prostřednictvím localhost portu (viz horní část obrázku výše), který komunikuje se funkcemi Stable Diffusion založenými na CLI.
Bez pochyby se brzy objeví uhlazenější aplikace. Již existuje několik aplikací založených na Patreonu, které lze stáhnout, jako je GRisk a NMKD (viz obrázek níže) – ale žádná z nich dosud nezahrnuje plný rozsah funkcí, které mohou nabízet některé pokročilejší a méně přístupné implementace Stable Diffusion.

Rané, založené na Patreonu balíčky Stable Diffusion, lehce „app-izované“. NMKD je první, který integruje výstup CLI přímo do GUI.
Zkusme se podívat, jak by mohla vypadat více vyvinutá a integrovaná implementace tohoto úžasného open source zázraku – a jaké výzvy by mohla čelit.
Právní úvahy pro plně financovanou komerční aplikaci Stable Diffusion
Faktor NSFW
Zdrojový kód Stable Diffusion byl vydán pod velmi permisivní licencí, která nezakazuje komerční reimplementace a odvozená díla, která staví na zdrojovém kódu.
Kromě již zmíněných a rostoucího počtu založené na Patreonu verzí Stable Diffusion, jakož i rozsáhlého počtu aplikací pluginů, které se vyvíjejí pro Figma, Krita, Photoshop, GIMP a Blender (mezi jinými), neexistuje praktický důvod, proč by dobře financovaná softwarová společnost nemohla vyvinout daleko více sofistikovanou a schopnou aplikaci Stable Diffusion. Z hlediska trhu existuje každý důvod se domnívat, že několik takových iniciativ je již dobře rozpracováno.
Zde se tyto snahy okamžitě setkávají s dilematem, zda aplikace umožní či neumožní nativnímu NSFW filtru Stable Diffusion (který je fragmentem kódu), být vypnutý.
‘Zakopání’ přepínače NSFW
Ačkoli open source licence Stability.ai pro Stable Diffusion zahrnuje široce interpretabilní seznam aplikací, pro které se nesmí použít (což lze vykládat i jako zákaz pornografického obsahu a deepfakes), jediným způsobem, jak by výrobce mohl účinně zakázat takový použití, by bylo zkompilovat NSFW filtr do neprůhledného spustitelného souboru místo parametru v souboru Python, nebo vynutit srovnání kontrolního součtu na souboru Python nebo DLL, který obsahuje NSFW směrnici, aby se nemohly provádět renderování, pokud uživatelé změní toto nastavení.
To by ponechalo zamýšlenou aplikaci omezenou podobně jako DALL-E 2 v současnosti je, snižuje tak její komerční atraktivitu. Kromě toho by nevyhnutelně vyvinuly dekompilované „upravené“ verze těchto komponent (buď původních prvků běhu Pythonu nebo zkompilovaných souborů DLL, jako jsou nyní používány v řadě Topaz AI nástrojů pro vylepšení obrazu) se objevily v komunitě torrent/hacking, aby zrušily taková omezení, jednoduše nahrazující bránící prvky a negující požadavky na kontrolní součet.
Nakonec by výrobce mohl jednoduše zopakovat varování Stability.ai proti zneužití, které charakterizuje první běh mnoha současných distribucí Stable Diffusion.
Nicméně malé open source vývojáře, kteří v současnosti používají neformální prohlášení, mají málo co ztratit ve srovnání se softwarovou společností, která investovala významné množství času a peněz do vytvoření plně vybavené a přístupné aplikace Stable Diffusion – což si žádá hlubší úvahu.
Odpovědnost za deepfakes
Jak jsme nedávno poznamenali, databáze LAION-aesthetics, která je součástí 4,2 miliard obrazů, na kterých byly vyškoleny modely Stable Diffusion, obsahuje velké množství obrazů celebrit, umožňujících uživatelům efektivně vytvářet deepfakes, včetně deepfake porna s celebritami.

Ze našeho nedávného článku, čtyři fáze Jennifer Connelly za čtyři desetiletí její kariéry, odvozené ze Stable Diffusion.
To je samostatný a více sporný problém než generování (obvykle) legálního „abstraktního“ porna, který nezobrazuje „reálné“ lidi (ačkoli takové obrázky jsou odvozeny z více reálných fotografií ve výcvikových materiálech).
Pokud se rostoucí počet států USA a zemí vyvíjí nebo zavedl zákony proti deepfake pornografii, schopnost Stable Diffusion vytvářet deepfakes s celebritami by mohla znamenat, že komerční aplikace, která není zcela cenzurovaná (tj. která může vytvářet pornografický materiál), by mohla potřebovat určitou schopnost filtrovat vnímané obličeje celebrit.
Jedním ze způsobů, jak toho dosáhnout, by bylo poskytnout vestavěný „černý seznam“ termínů, které nebudou akceptovány v uživatelském podnětu, vztahujících se k jménům celebrit a fiktivním postavám, s nimiž mohou být spojeny. Předpokladem by bylo, aby takové nastavení bylo zavedeno v více jazycích než pouze angličtině, protože původní data obsahují i další jazyky. Další přístup by mohl zahrnovat integraci systémů rozpoznávání celebrit, jako jsou ty, které vyvinula Clarifai.
Možná by bylo nutné, aby výrobci softwaru zahrnuli takové metody, možná zpočátku vypnuté, aby pomohly zabránit plnohodnotné samostatné aplikaci Stable Diffusion generovat obličeje celebrit, dokud nebude vydána nová legislativa, která by mohla učinit takovou funkčnost nezákonnou.
Opětovně, nicméně, taková funkčnost by mohla být nevyhnutelně dekompilována a obrácena zainteresovanými stranami; nicméně by výrobce softwaru mohl v takovém případě tvrdit, že se jedná o neoprávněný vandalismus – pokud by taková reverzní inženýrství nebyla učiněna příliš snadnou.
Funkce, které by mohly být zahrnuty
Jádrové funkcionality v jakékoli distribuci Stable Diffusion by se očekávalo od jakékoli dobře financované komerční aplikace. Tyto zahrnují schopnost používat textové podněty pro generování vhodných obrazů (text-to-image); schopnost používat náčrtky nebo jiné obrázky jako vodítka pro nové generované obrázky (image-to-image); prostředky pro úpravu „imaginativnosti“ systému; způsob, jak vyvážit renderovací čas proti kvalitě; a další „základní“ funkce, jako je volitelné automatické archivování obrazů/podnětů a rutinní volitelné zvýšení rozlišení prostřednictvím RealESRGAN, a alespoň základní „oprava obličeje“ s GFPGAN nebo CodeFormer.
To je poměrně základní instalace. Zkusme se podívat na některé pokročilejší funkce, které jsou v současnosti vyvíjeny nebo rozšiřovány, které by mohly být zahrnuty do plnohodnotné „tradiční“ aplikace Stable Diffusion.
Stochastické zmrazení
I když znovu použijete semeno z předchozí úspěšné renderace, je to strašně obtížné dostat Stable Diffusion, aby přesně opakoval transformaci, pokud jakákoli část podnětu nebo zdrojového obrázku (nebo obojí) je změněna pro následnou renderaci.
To je problém, pokud chcete použít EbSynth, aby vynutil transformace Stable Diffusion na reálném videu způsobem, který je časově soudržný – ačkoli tato technika může být velmi účinná pro jednoduché záběry hlavy a ramen:
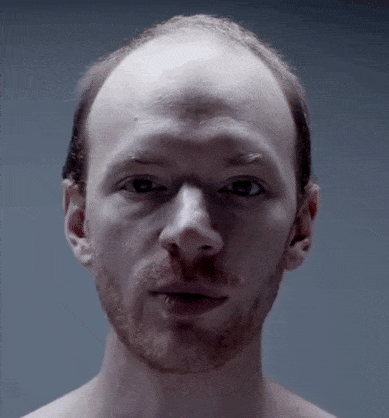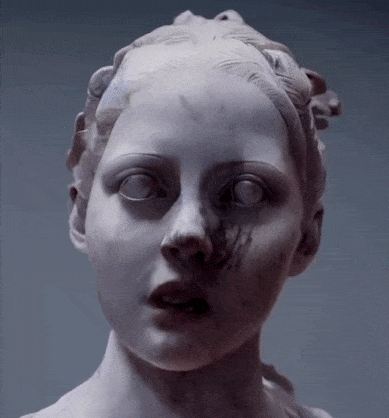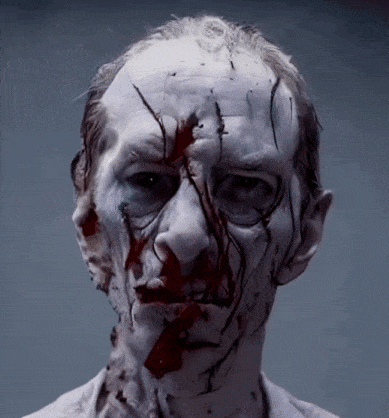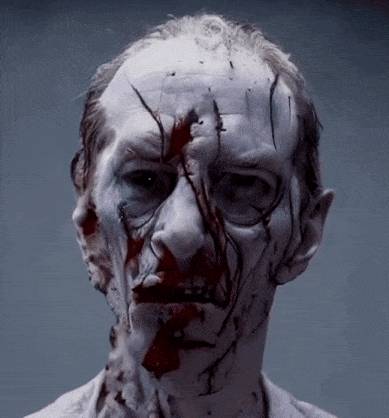
Omezený pohyb může učinit EbSynth účinným prostředkem pro transformaci transformací Stable Diffusion do realistického videa. Zdroj: https://streamable.com/u0pgzd
EbSynth funguje tak, že extrapoluje malou selekci „upravených“ klíčových snímků do videa, které bylo renderováno do série obrázkových souborů (a které lze později znovu sestavit do videa).

V tomto příkladu z webu EbSynth bylo několik snímků z videa namalováno umělecky. EbSynth používá tyto snímky jako vodítka pro úpravu celého videa tak, aby odpovídalo malovanému stylu. Zdroj: https://www.youtube.com/embed/eghGQtQhY38
V následujícím příkladu, který zobrazuje téměř žádný pohyb od skutečné blonďaté instruktorky jógy vlevo, Stable Diffusion stále má potíže s udržením konzistentního obličeje, protože tři transformované snímky jako „klíčové snímky“ nejsou zcela identické, ačkoli všechny sdílejí stejnou číselnou počáteční hodnotu.

Zde, i když je stejný podnět a semeno napříč všemi třemi transformacemi a velmi málo změn mezi zdrojovými snímky, svaly se liší ve velikosti a tvaru, ale důležitější je, že obličej je nekonzistentní, bránící časové konzistenci v potenciálním renderu EbSynth.
Níže uvedené video SD/EbSynth je velmi nápadité: prsty uživatele se mění v kráčející nohy v kalhotách a v kachnu. Proměnlivé kalhoty však ukazují problém Stable Diffusion se zachováním konzistence mezi klíčovými snímky, i když jsou zdrojové snímky podobné a počáteční hodnota stejná.
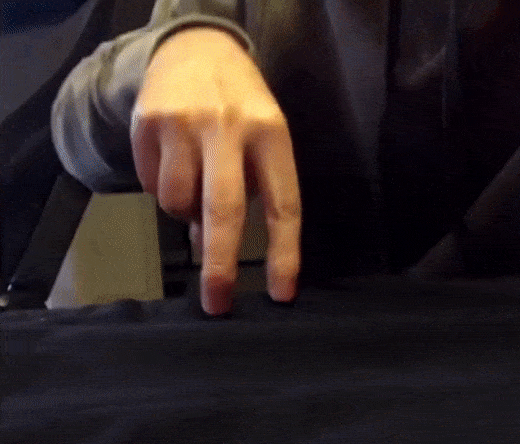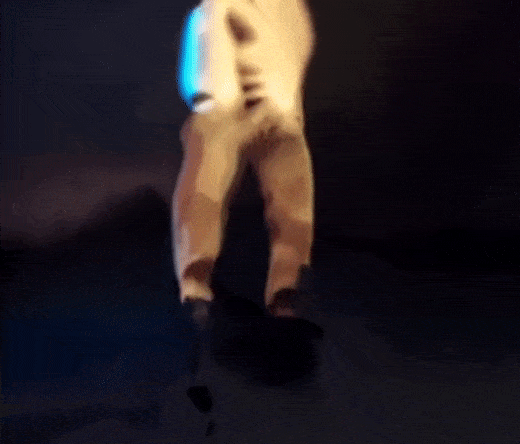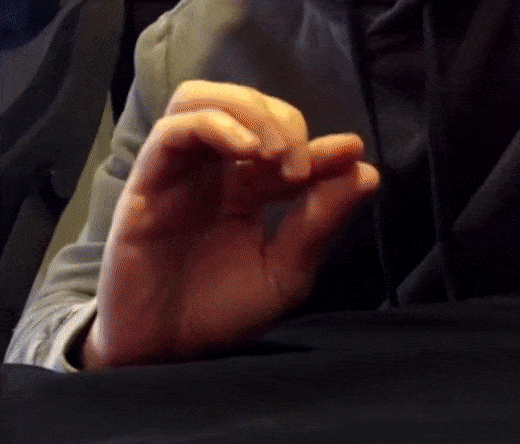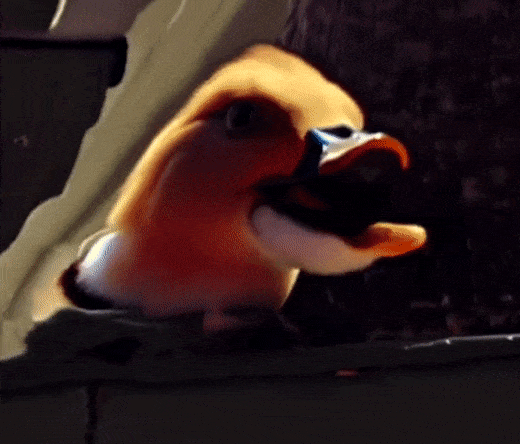
Prsty muže se prostřednictvím Stable Diffusion a EbSynth mění v kráčejícího muže a kachnu. Zdroj: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Uživatel, který video vytvořil, uvedl, že proměna v kachnu, snad úspěšnější, i když méně působivá a originální, vyžadovala jediný upravený klíčový snímek. Kráčející kalhoty naopak potřebovaly 50 obrázků Stable Diffusion a vykazují větší časovou nekonzistenci. Uživatel dodal, že dosažení konzistence každého z 50 klíčových snímků vyžadovalo pět pokusů.
Skutečně komplexní aplikaci by proto velmi prospěla funkce maximálně zachovávající vlastnosti mezi klíčovými snímky.
Jednou možností je dovolit uživateli zmrazit stochastické kódování transformace každého snímku. Dnes to lze jen ruční úpravou zdrojového kódu. Jak ukazuje příklad, pomáhá to časové konzistenci, ale problém zcela neřeší:
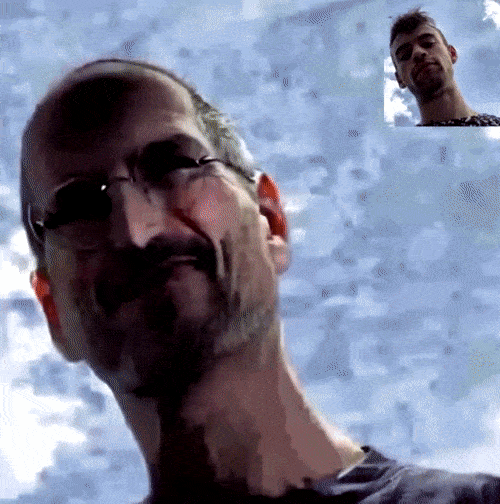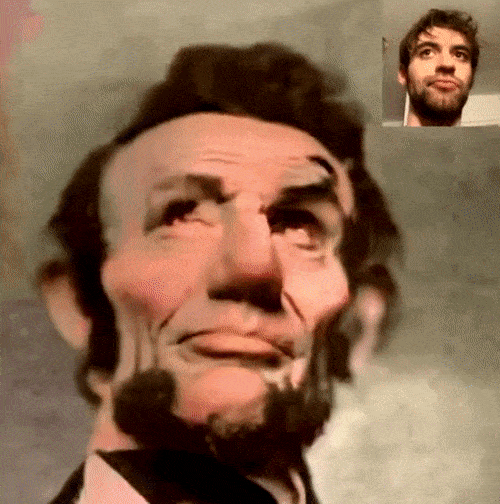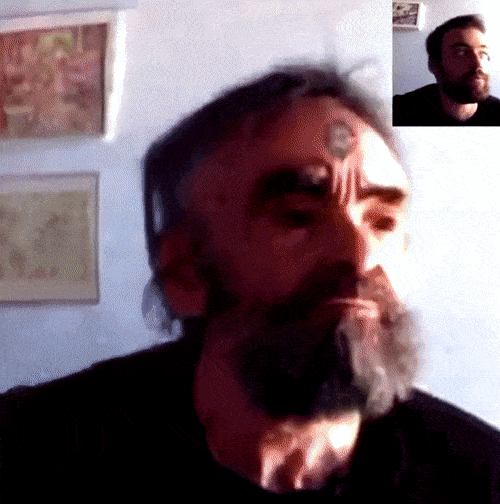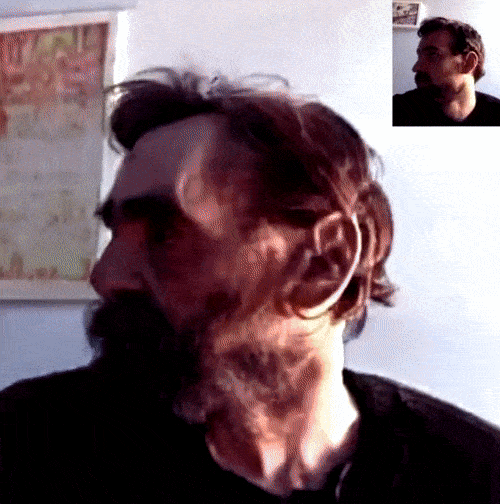
Uživatel Redditu proměnil záběry vlastní webkamery v různé slavné osoby nejen zachováním počáteční hodnoty, což umí každá implementace Stable Diffusion, ale také shodným parametrem stochastic_encode() při každé transformaci. Upravil kód, ale snadno by z toho mohl vzniknout uživatelský přepínač. Zjevně to však neřeší všechny časové potíže. Zdroj: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Textová inverze v cloudu
Lepší cestou k časově konzistentním postavám a objektům je jejich zakotvení do textové inverze — souboru o velikosti 5 KB, který lze během několika hodin natrénovat na pouhých pěti anotovaných obrázcích a vyvolat zvláštním promptem *. Tak lze například zachovat vzhled nových postav v příběhu.

Obrázky s vhodnými značkami lze pomocí textové inverze změnit v samostatné entity a jednoznačně vyvolat ve správném kontextu a stylu zvláštními tokenovými slovy. Zdroj: https://huggingface.co/docs/diffusers/training/text_inversion
Textové inverze jsou přídavné soubory k velmi velkému, plně natrénovanému modelu Stable Diffusion. Vkládají se do procesu vyvolávání a zpracování promptů, aby mohly vstupovat do scén vytvořených modelem a využít jeho rozsáhlé znalosti objektů, stylů, prostředí a interakcí.
Přestože trénink textové inverze netrvá dlouho, vyžaduje mnoho grafické paměti. Současné návody uvádějí 12, 20, a dokonce 40 GB VRAM.
Většina běžných uživatelů tak výkonné GPU nejspíš nemá, takže vznikají cloudové služby pro tuto operaci, včetně verze Hugging Face. Existují sice implementace Google Colab pro tvorbu textových inverzí, ale paměťové a časové nároky mohou být problémem pro bezplatný tarif Colabu.
U potenciální kompletní a dobře financované instalované aplikace Stable Diffusion se přesunutí této náročné úlohy na cloudové servery firmy nabízí jako zřejmá výdělečná strategie. Předpokládá to, že levná či bezplatná aplikace obsahuje podobné placené funkce, což se zdá pravděpodobné u mnoha programů, které mohou z technologie vzniknout během příštích 6–9 měsíců.
Poměrně složité anotování a formátování zaslaných obrázků a textů by mohlo být v integrovaném prostředí automatizováno. Vytváření jedinečných prvků, které prozkoumávají rozsáhlé světy Stable Diffusion a interagují s nimi, může být návykové pro nadšence i mladší uživatele.
Všestranné vážení promptů
Mnoho současných implementací umožňuje zvýraznit část dlouhého textového promptu, ale nástroje se značně liší a často jsou těžkopádné nebo neintuitivní.
Například velmi populární odvozená verze Stable Diffusion od AUTOMATIC1111 snižuje či zvyšuje váhu slova uzavřením do jedněch nebo více kulatých závorek pro snížení důrazu či hranatých závorek pro zesílení.

Hranaté a kulaté závorky dokážou v této verzi vah promptů změnit snídani, ale v obou případech jde o cholesterolovou noční můru.
Jiné verze používají k důrazu vykřičníky. Nejvšestrannější dovolují nastavit váhu každého slova prostřednictvím GUI.
Systém by měl dovolit i záporné váhy promptů — nejen pro fanoušky hororu, protože v latentním prostoru Stable Diffusion mohou být méně znepokojivá a poučnější tajemství, než jaká přivolá naše omezené používání jazyka.
Rozšíření obrazu, outpainting
Krátce po senzačním zveřejnění zdrojového kódu Stable Diffusion se OpenAI pokusilo, většinou marně, získat zpět pozornost pro DALL-E 2 oznámením outpaintingu, který umožňuje rozšířit obraz za hranice se sémantickou logikou a vizuální soudržností.
To už samozřejmě bylo implementováno v různých podobách pro Stable Diffusion i v Kritě a rozhodně by mělo být součástí komplexní aplikace ve stylu Photoshopu.
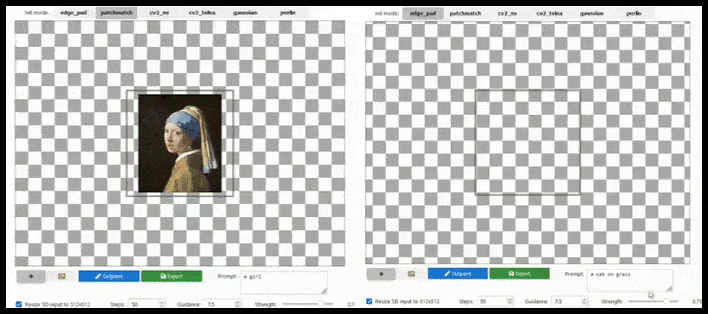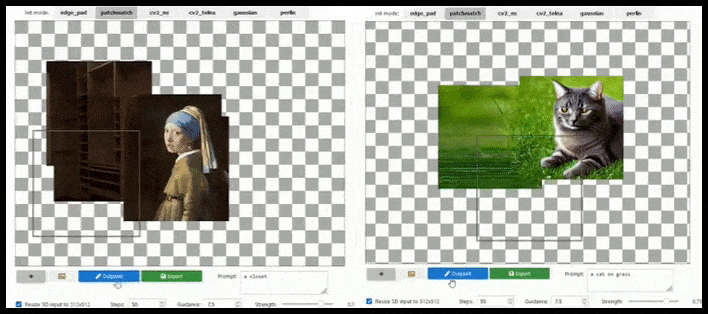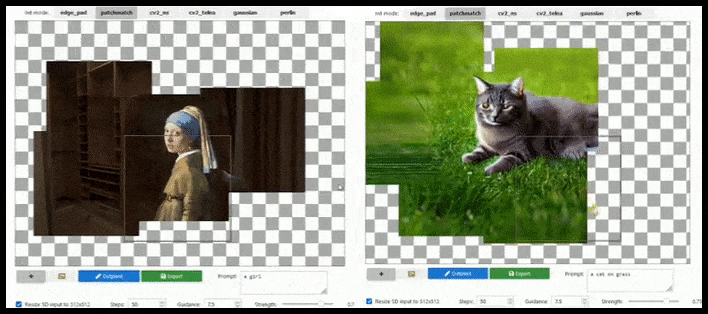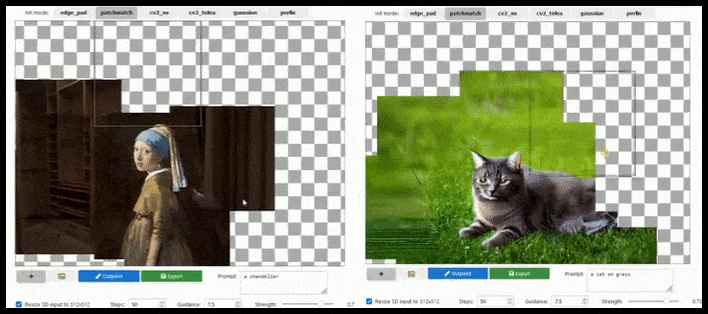
Rozšiřování pomocí dlaždic může standardní obraz 512 × 512 pixelů prodloužit téměř neomezeně, pokud to dovolují prompty, existující obraz a sémantická logika. Zdroj: https://github.com/lkwq007/stablediffusion-infinity
Protože byl Stable Diffusion trénován na obrázcích 512 × 512 pixelů a z dalších důvodů, často lidem uřezává hlavy nebo jiné důležité části těla, i když prompt výslovně zdůrazňuje hlavu.

Typické příklady uřezávání hlav ve Stable Diffusion; outpainting by však mohl vrátit George do obrazu.
Každý outpainting jako v animaci výše by měl nabídnout i opravu jedním kliknutím nebo promptem. Ukázka závisí výhradně na unixových knihovnách, ale měla by být zopakovatelná ve Windows.
Dnes uživatelé rozšiřují plátno obrázků bez hlavy směrem vzhůru, nahrubo doplní oblast hlavy a pomocí img2img dokončí nepovedený výsledek.
Účinné maskování, které rozumí kontextu
Maskování může být velmi nepředvídatelnou záležitostí ve Stable Diffusion, v závislosti na verzi nebo forkování. Často, kde je možné nakreslit koherentní masku, zadaná oblast nakonec skončí s obsahem, který nebere v úvahu celý kontext obrázku.
Jednou jsem maskoval rohovky očí na obrázku obličeje a poskytl podnět ‘modré oči’ jako maska inpaint – pouze abych zjistil, že se dívám skrz dvě vyříznuté lidské oči na vzdálený obrázek podivného vlka. Myslím, že jsem šťastný, že to nebyl Frank Sinatra.
Sémantické úpravy jsou také možné identifikací šumu, který vytvořil obrázek, což umožňuje uživateli adresovat konkrétní strukturální prvky v renderu bez narušení zbytku obrázku:

Změna jednoho prvku v obrázku bez tradičního maskování a bez změny sousedního obsahu, identifikací šumu, který původně vytvořil obrázek a adresováním částí, které přispěly k cílové oblasti. Zdroj: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Tato metoda je založena na vzorkovači K-Diffusion.
Sémantické filtry pro fyziologické chyby
Jak jsme již zmínili, Stable Diffusion může často přidávat nebo odebírat končetiny, převážně kvůli problémům s daty a nedostatkům v anotacích, které doprovázejí obrázky, na kterých byl trénován.

Jako ten neposlušný kluk, který vystrčil jazyk na školní skupinové fotografii, biologické zločiny Stable Diffusion nejsou vždy okamžitě zřejmé, a můžete mít na Instagramu svou poslední mistrovskou práci AI, než si všimnete těch dalších rukou nebo roztavených končetin.
Je tak obtížné opravit tyto druhy chyb, že by bylo užitečné, kdyby plnohodnotná aplikace Stable Diffusion obsahovala nějaký anatomický rozpoznávací systém, který by používal sémantické segmentace k výpočtu, zda příchozí obrázek obsahuje závažné anatomické nedostatky (jako na obrázku výše), a odmítl by ho ve prospěch nové renderace, než by ho představil uživateli.

Samozřejmě, že byste mohli chtít renderovat bohyni Kali, nebo Doktora Oktopuse, nebo dokonce zachránit nedotčenou část končetin postiženého obrázku, takže tato funkce by měla být volitelným přepínačem.
Pokud by uživatelé mohli tolerovat aspekt telemetrie, takové selhání by mohlo být anonymně přeneseno v kolektivním úsilí federativního učení, které by mohlo pomoci budoucím modelům zlepšit jejich pochopení anatomické logiky.
Automatické zlepšování tváří založené na LAION
Jak jsem již poznamenal v předchozí analýze tří věcí, které by Stable Diffusion mohl v budoucnu řešit, neměl by být ponechán pouze na verzi GFPGAN, aby se pokusil „vylepšit“ renderované obličeje v prvním renderingu.
„Vylepšení“ GFPGAN jsou strašně obecná, často podkopávají identitu zobrazené osoby a fungují pouze na obličeji, které obdrželo stejné zpracování času a pozornosti jako jakákoli jiná část obrázku.
Proto by profesionální program pro Stable Diffusion měl být schopen rozpoznat obličej (s standardní a relativně lehkou knihovnou, jako je YOLO), aplikovat plnou váhu dostupné GPU síly pro pře-renderování a buď sloučit vylepšené obličej do původního renderu plného kontextu, nebo uložit jej samostatně pro manuální rekompozici. V současnosti jde o poměrně ruční operaci.
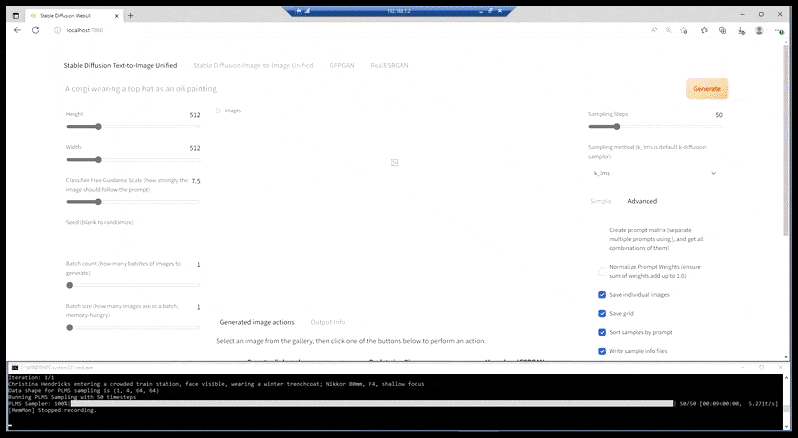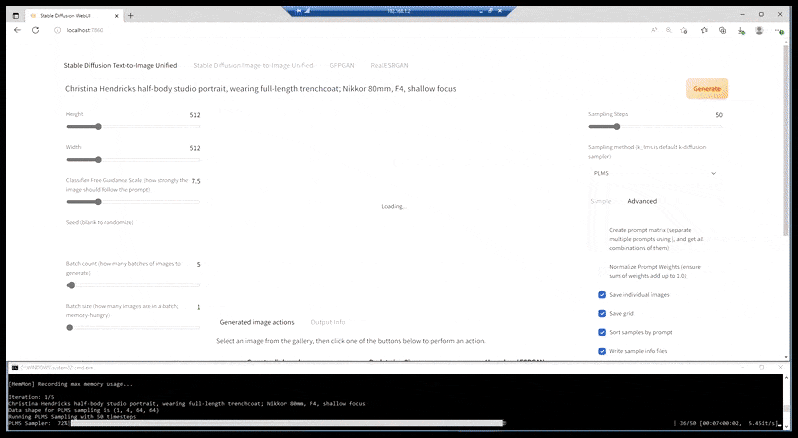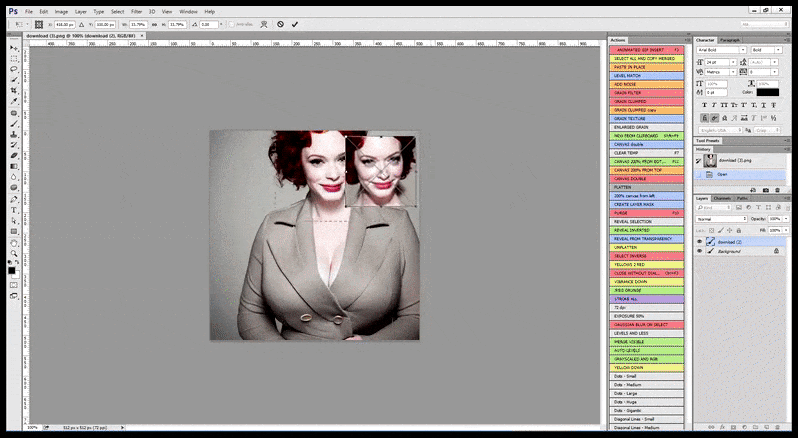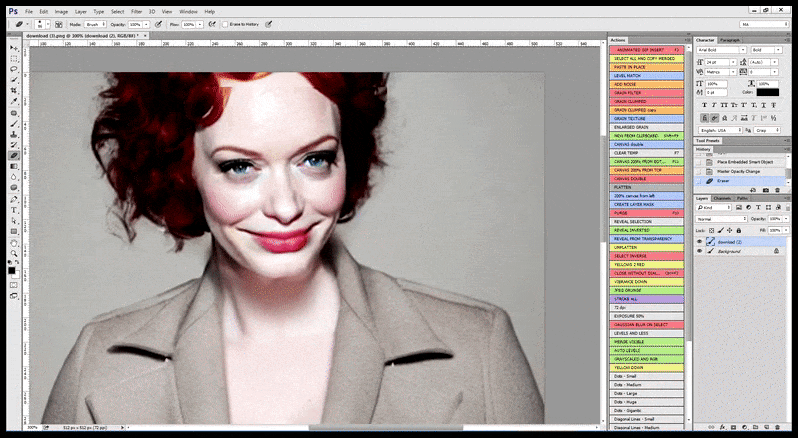
V případech, kdy Stable Diffusion byl trénován na dostatečném počtu obrazů celebrity, je možné zaměřit celou kapacitu GPU na následnou renderaci pouze obličeje renderovaného obrázku, což je obvykle významné zlepšení – a na rozdíl od GFPGAN, čerpá z informací z LAION-trénovaných dat, spíše než jednoduše upravuje renderované pixely.
Vnitřní vyhledávání LAION
Od té doby, co uživatelé začali chápat, že vyhledávání v databázi LAION může být nápomocné pro lepší využití Stable Diffusion, byly vytvořeny online vyhledávače LAION, včetně haveibeentrained.com.

Funkce vyhledávání na haveibeentrained.com umožňuje uživatelům procházet obrázky, které pohánějí Stable Diffusion, a objevit, zda objekty, lidé nebo nápady, které by mohli chtít vyvolat ze systému, pravděpodobně byly součástí trénování. Tyto systémy pomáhají také objevovat příbuzné entity, například seskupení celebrit nebo další nápad navazující na současný. Zdroj: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Ačkoli webové databáze často odhalují některé značky obrázků, proces zobecňování při trénování modelu znamená, že konkrétní obrázek nejspíš nelze vyvolat jeho značkou jako promptem.
Odstranění stopslov a stemming a lematizace při zpracování přirozeného jazyka navíc znamenají, že mnoho zobrazených frází bylo před trénováním Stable Diffusion rozděleno či vynecháno.
Nicméně, způsob, jakým estetické skupiny váží v těchto rozhraních, může naučit koncového uživatele mnoho o logice (nebo „osobnosti“) Stable Diffusion a prokázat pomoc při lepší produkci obrazů.
Závěr
Existuje mnoho dalších funkcí, které bych chtěl vidět v plné nativní desktopové implementaci Stable Diffusion, jako je nativní analýza obrazu založená na CLIP, která obrací standardní proces Stable Diffusion a umožňuje uživateli vyvolat fráze a slova, která systém přirozeně spojuje se zdrojovým obrázkem, nebo renderem.
Kromě toho by skutečné zvyšování rozlišení pomocí dlaždic bylo vítanou funkcí, protože ESRGAN je téměř tak hrubým nástrojem jako GFPGAN. Naštěstí plány na integraci txt2imghd implementace GOBIG jsou rychle činí realitou napříč distribucemi a zdá se to jako zjevná volba pro desktopovou iteraci.
Několik dalších populárních požadavků z komunit Discord mě méně zajímá, jako jsou integrované slovníky podnětů a použitelné seznamy umělců a stylů, ačkoli vnitřní poznámkový blok nebo přizpůsobitelný lexikon frází by se zdál logickým doplňkem.
Podobně, současné omezení lidské animace ve Stable Diffusion, ačkoli byla spuštěna CogVideo a dalšími projekty, zůstává neuvěřitelně zárodečné a závislé na základním výzkumu časové apriorní znalosti autentického lidského pohybu.
Prozatím je video Stable Diffusion přísně psychedelické, ačkoli může mít mnohem jasnější blízkou budoucnost v deepfake loutkářství, prostřednictvím EbSynth a dalších relativně nových text-to-video iniciativ (a je třeba poznamenat, že chybí syntetizované nebo „upravené“ lidé v posledním propagačním videu Runway).
Jedna další cenná funkčnost by byla plynulé předávání obrazů do Photoshopu a zpět, který byl již zaveden v editoru textur Cinema4D, mezi jinými podobnými implementacemi. S touto funkcí můžete snadno přepínat obrázky mezi aplikacemi a používat každou aplikaci pro provedení transformací, které jsou její specialitou.
Nakonec, a možná nejdůležitěji, plnohodnotná desktopová aplikace Stable Diffusion by měla být schopna nejen snadno přepínat mezi kontrolními body (tj. verzemi základního modelu, který pohání systém), ale měla by být také schopna aktualizovat vlastní Textual Inversions, které fungovaly s předchozími oficiálními modelovými vydáními, ale které by mohly být jinak rozbité pozdějšími verzemi modelu (jak naznačili vývojáři na oficiálním Discordu).
Ironií je, že Adobe, které má nejlepší předpoklady vytvořit tak silnou a integrovanou sadu nástrojů pro Stable Diffusion, se natolik spojilo s Content Authenticity Initiative, že by takový krok mohl působit jako zpátečnické PR pochybení. Výjimkou by bylo, kdyby omezilo generativní možnosti Stable Diffusion tak důkladně jako OpenAI u DALL-E 2 a představilo jej jako přirozený vývoj svého rozsáhlého podnikání ve fotobankách.
Poprvé publikováno 15. září 2022.


