
Andersonův úhel
Tři výzvy, které stojí před Stable Diffusion

 Přidejte Unite.AI mezi své preferované zdroje na Google
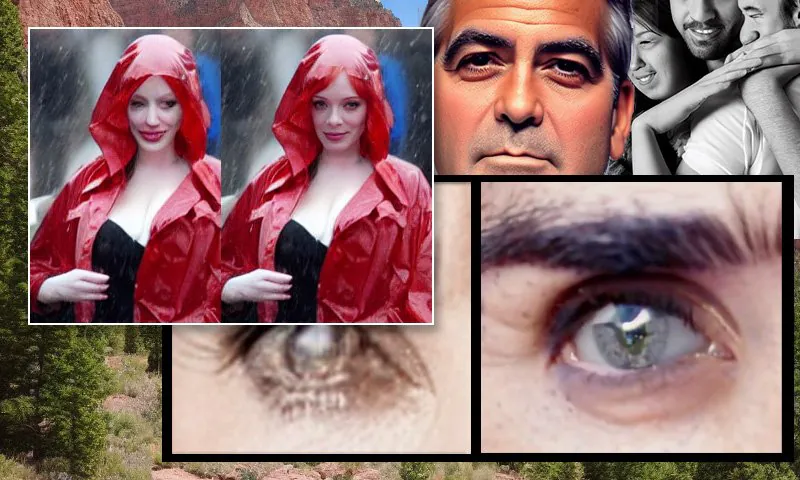
Klíčové bodyStable Diffusion má potíže s lidskými končetinami kvůli nedostatečně podrobným anotacím…
Zobrazit více
- Stable Diffusion má potíže s lidskými končetinami kvůli nedostatečně podrobným anotacím v trénovacích datech.
- Metody zvětšování založené na dlaždicích riskují vytváření nesouvislých obrazů bez širšího kontextuálního povědomí.
- Nativní rozlišení modelu 512x512 omezuje kvalitu výstupu a vyžaduje složité řešení.
Uveřejnění modelu syntézy obrazu Stable Diffusion společnosti stability.ai založeného na latentní difuzi před několika týdny může být jednou z nejvýznamnějších technologických odhalení od DeCSS v roce 1999; je to určitě největší událost v oblasti generování obrazů pomocí umělé inteligence od roku 2017, kdy byl kód deepfakes zkopírován do GitHubu a rozvětven do DeepFaceLab a FaceSwap, jakož i software pro streamování deepfakes v reálném čase DeepFaceLive.
Jedním tahem byla frustrace uživatelů z důvodu omezení obsahu v API syntézy obrazu DALL-E 2 odstraněna, protože se ukázalo, že filtr NSFW ve Stable Diffusion lze zakázat změnou jedné řádky kódu. Rychle vznikly pornografické komunity Stable Diffusion na Redditu a byly stejně rychle odstraněny, zatímco vývojáři a uživatelé se rozdělili na oficiální a NSFW komunity na Discordu a Twitter začal být zaplaven fantastickými tvůrčími díly Stable Diffusion.
V současné době přináší každý den nějaké úžasné inovace od vývojářů, kteří přijali tento systém, s pluginy a doplňky třetích stran, které jsou rychle psány pro Krita, Photoshop, Cinema4D, Blender a mnoho dalších aplikací.
Mezitím se promptcraft – nyní profesionální umění “AI whisperingu”, které může skončit jako jedna z nejkratších kariérních možností od dob „organizátora Filofax“ – již komercializuje, zatímco raná monetizace Stable Diffusion probíhá na úrovni Patreon, s jistotou, že budou následovat sofistikovanější nabídky pro ty, kteří nejsou ochotni navigovat Conda-based instalace zdrojového kódu nebo omezující filtry NSFW webových implementací.
Rychlost vývoje a svobodný pocit objevování uživatelů postupuje takovou závratnou rychlostí, že je obtížné vidět velmi daleko dopředu. V podstatě nevíme přesně, s čím jsme se zde zabýváme, nebo co všechny omezení nebo možnosti mohou být.
Přesto se podívejme na tři z toho, co by mohlo být nejzajímavějšími a nejobtížnějšími překážkami pro rychle vytvořenou a rychle rostoucí komunitu Stable Diffusion, aby čelila a doufala, že je překoná.
1: Optimalizace postupů zpracování založených na dlaždicích
Představen s omezenými hardwarovými zdroji a tvrdými limity na rozlišení trénovacích obrazů, zdá se pravděpodobné, že vývojáři najdou způsoby, jak zlepšit jak kvalitu, tak rozlišení výstupu Stable Diffusion. Mnoho z těchto projektů je nastaveno tak, aby využívalo omezení systému, jako je jeho původní rozlišení pouhých 512×512 pixelů.
Jako je vždy případ u počítačového vidění a iniciativ syntézy obrazu, Stable Diffusion byl trénován na čtvercových obrazech, v tomto případě převzorkovaných na 512×512, aby zdroj obrazů mohl být regularizován a mohl se vejít do omezení GPU, které trénovaly model.
Stable Diffusion “myslí” (pokud myslí vůbec) v 512×512 termínech a určitě v čtvercových termínech. Mnoho uživatelů, kteří nyní zkoumají limity systému, uvádí, že Stable Diffusion produkuje nejvěrnější a nejméně chybné výsledky při tomto poměrně omezeném poměru stran (viz “řešení problémů s končetinami” níže).
Přestože různé implementace funkcí upscaling prostřednictvím RealESRGAN (a mohou opravit špatně renderované tváře prostřednictvím GFPGAN) několik uživatelů nyní vyvíjí metody, jak rozdělit obrázky na 512x512px sekce a šít obrázky dohromady, aby vytvořily větší kompozitní díla.

Tento 1024×576 render, rozlišení běžně nemožné v jednom Stable Diffusion renderu, byl vytvořen kopírováním a vkládáním souboru attention.py z DoggettX fork Stable Diffusion (verze, která implementuje tile-based upscaling) do jiného fork. Zdroj: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Přestože některé iniciativy tohoto druhu používají původní kód nebo jiné knihovny, txt2imghd port GOBIG (režim v ProgRockDiffusion) je nastaven tak, aby poskytl tuto funkčnost hlavní větvi brzy. Zatímco txt2imghd je dedikovaný port GOBIG, jiné úsilí od komunitních vývojářů zahrnuje různé implementace GOBIG.

Abstraktní obraz v původním 512x512px renderu (vlevo a druhý zleva); upscaled pomocí ESGRAN, který je nyní více nebo méně nativní napříč všemi distribucemi Stable Diffusion; a dán ‘zvláštní pozornost’ prostřednictvím implementace GOBIG, produkuje detaily, které, alespoň v rámci hranic obrazové sekce, vypadají lépe upscaled. Zdroj: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Typ abstraktního příkladu uvedeného výše má mnoho “malých království” detailů, které se hodí pro tento solipsistický přístup k upscalingu, ale které mohou vyžadovat více náročné kódové řešení, aby vytvářely neopakující se, soudržné zvětšení, které nebude vypadat, jako by byly sestaveny z mnoha částí. Nejméně, v případě lidských tváří, kde jsme neobvykle citliví na aberace nebo rušivé artefakty. Proto tváře mohou nakonec potřebovat speciální řešení.
Stable Diffusion nyní nemá žádný mechanismus pro zaměřování pozornosti na tvář během renderu stejným způsobem, jakým lidé prioritizují faciální informace. Přestože někteří vývojáři v Discord komunitách zvažují metody, jak implementovat tento typ “vylepšené pozornosti”, je nyní mnohem jednodušší ručně (a nakonec automaticky) vylepšit tvář po počátečním renderu.
Lidská tvář má vnitřní a kompletní semantickou logiku, která nebude nalezena v “dlaždici” spodní části (například) budovy, a proto je nyní možné velmi účinně “zoomovat” a re-renderovat nedotaženou tvář v Stable Diffusion výstupu.

Vlevo, Stable Diffusion’s počáteční pokus s promptem ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’. Vpravo, vylepšená tvář získaná tím, že se rozostřená a nedotažená tvář z prvního renderu vrátila do plné pozornosti Stable Diffusion pomocí Img2Img (viz animované obrázky níže).
Bez specializovaného řešení Textual Inversion (viz níže) to bude fungovat jen u snímků celebrit, které jsou již dobře zastoupeny v podmnožinách dat LAION použitých k trénování Stable Diffusion. Bude to tedy fungovat pro Toma Cruise, Brada Pitta, Jennifer Lawrence a omezený okruh skutečných mediálních hvězd, jejichž snímky jsou ve zdrojových datech ve velkém počtu.
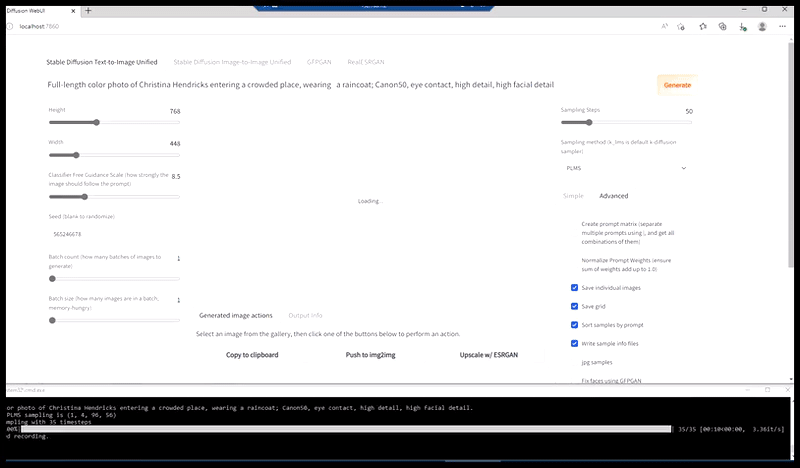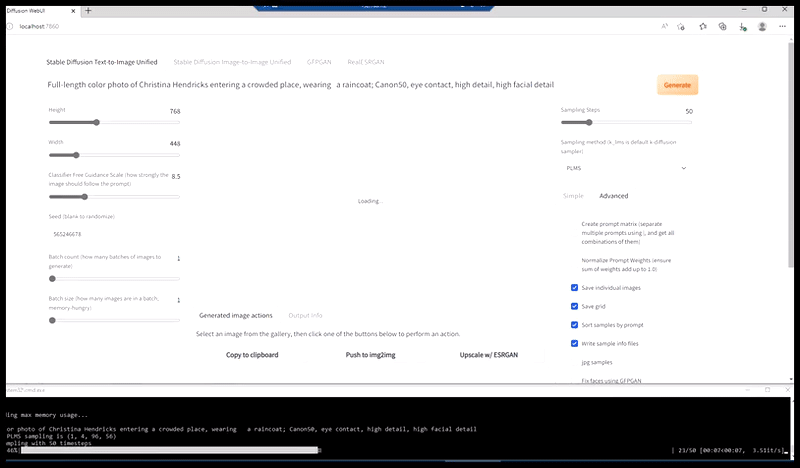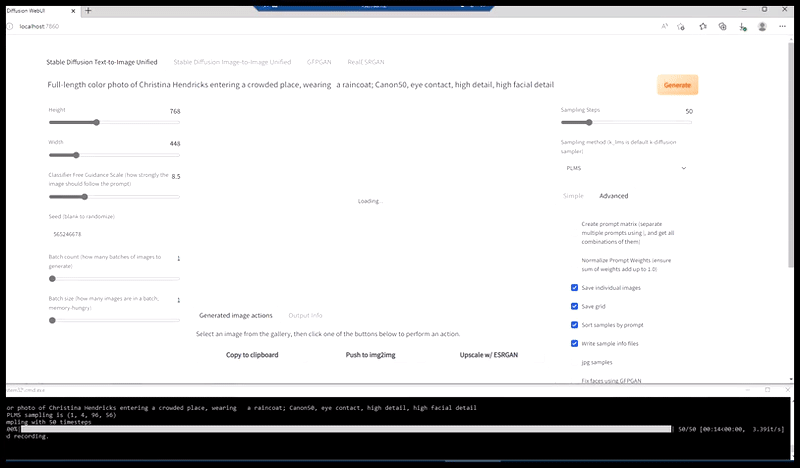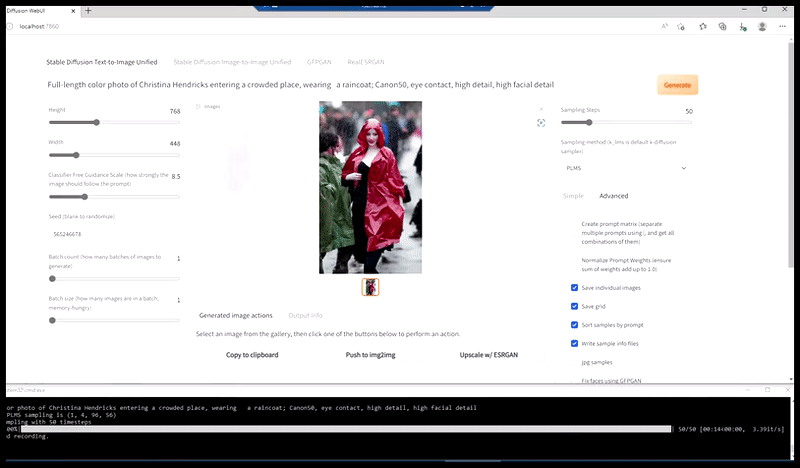
Vytvoření věrohodné tiskové fotografie s promptem ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’.
U celebrit s dlouhou a trvalou kariérou Stable Diffusion obvykle vytvoří snímek v jejich současném, tedy vyšším věku. K získání mladší podoby je nutné přidat k promptu výrazy jako ‘young’ nebo ‘in the year [YEAR]’ pro vytvoření mladšího vzhledu.

Díky výrazné, často fotografované a soustavné kariéře trvající téměř 40 let je herečka Jennifer Connelly jednou z mála celebrit v LAION, které Stable Diffusion umožňují zobrazit mnoho věkových období. Zdroj: hotový místní balíček Stable Diffusion, checkpoint v1.4; prompty související s věkem.
Je to hlavně důsledek rozšíření digitální tiskové fotografie od poloviny prvního desetiletí 21. století namísto nákladné fotografie s fotografickou emulzí a pozdějšího růstu množství obrazů díky vyšší rychlosti širokopásmového připojení.
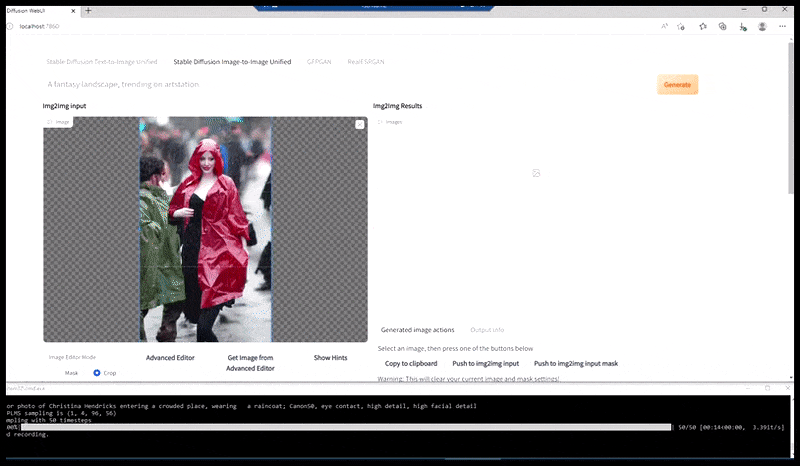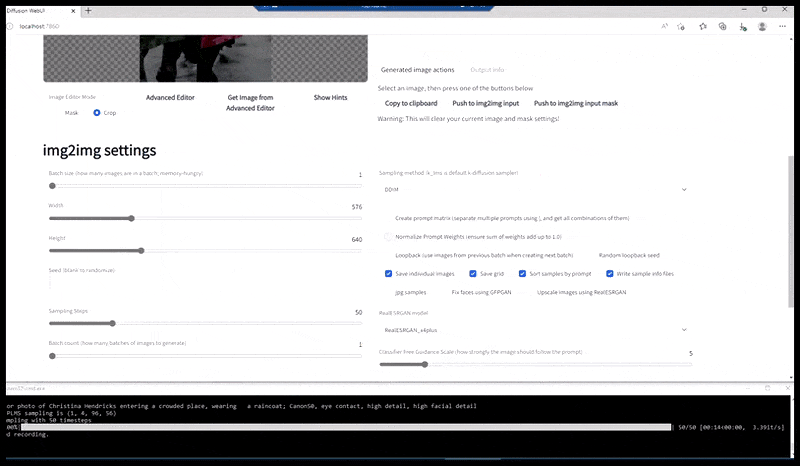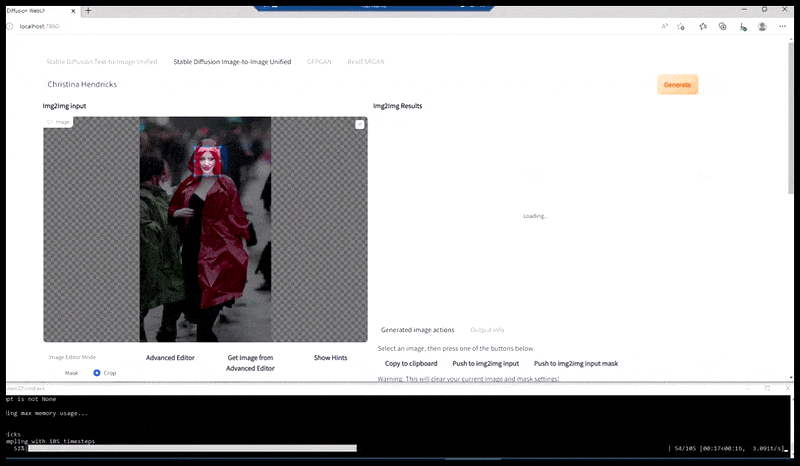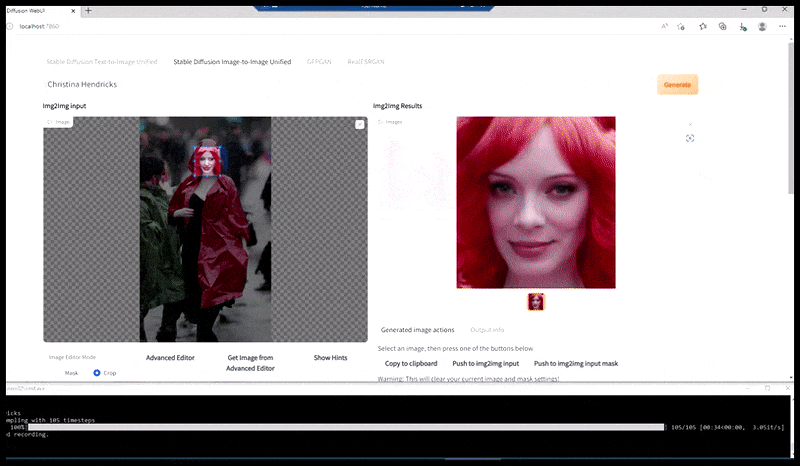
Vyrenderovaný obraz se předá do Img2Img ve Stable Diffusion, kde se vybere oblast zájmu. Pouze tato oblast se znovu vyrenderuje v maximální velikosti, takže Stable Diffusion může soustředit všechny dostupné prostředky na nové vytvoření tváře.
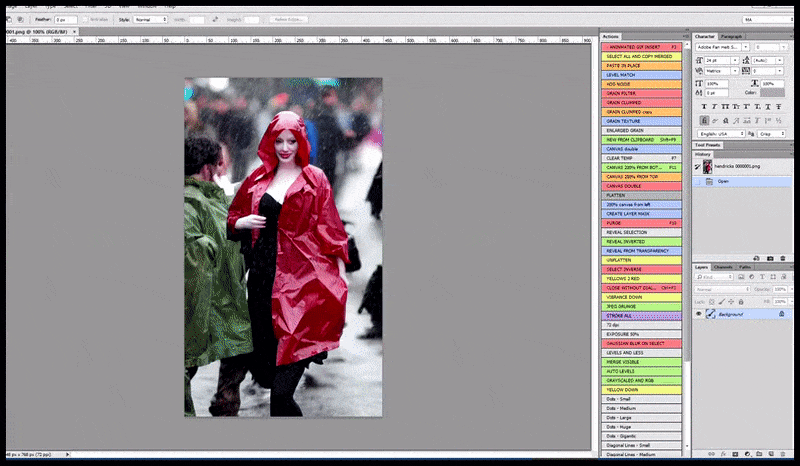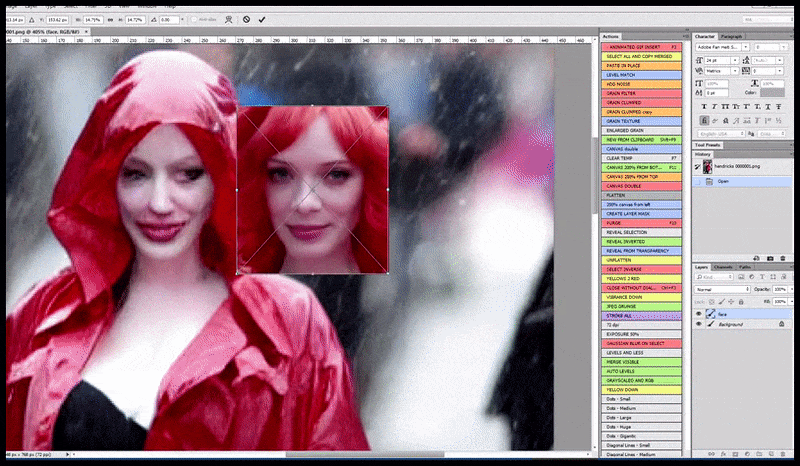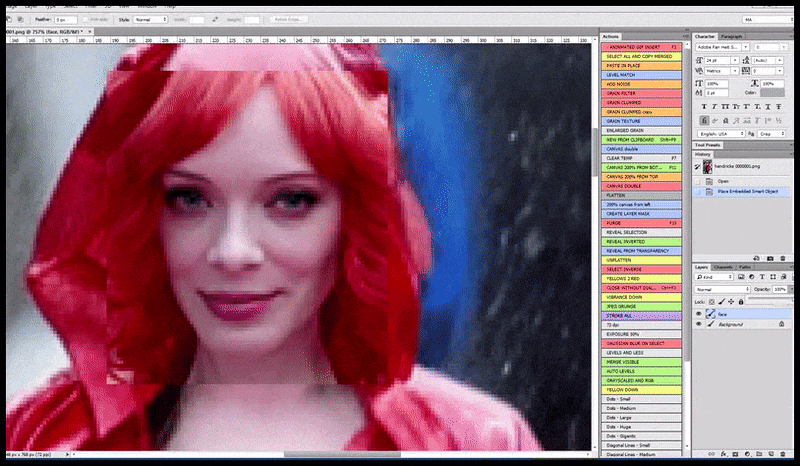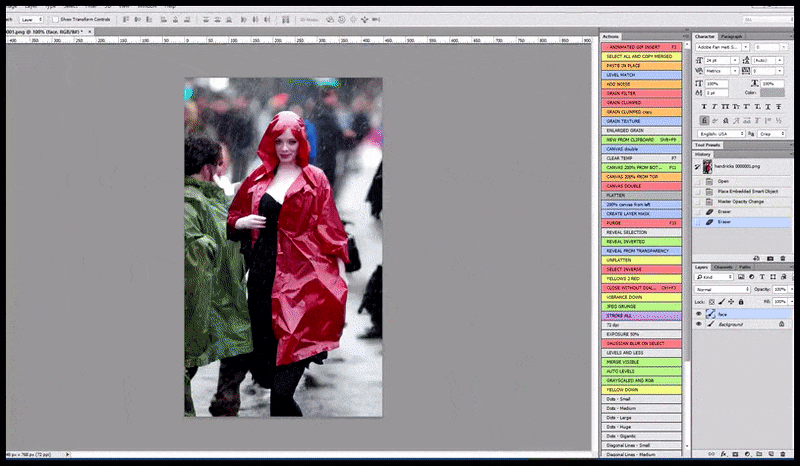
Vložení tváře vytvořené s vysokou pozorností zpět do původního obrazu. Kromě tváří to funguje pouze u objektů, které mohou mít známý, soudržný a ucelený vzhled, například v části původní fotografie s jasným objektem, jako jsou hodinky nebo automobil. Zvětšení části zdi povede k velmi podivně vypadající znovu složené zdi, protože při renderování jednotlivých dlaždic chyběl širší kontext tohoto dílku skládačky.
Některé celebrity jsou v databázi již předem zmrazeny v čase, buď proto, že zemřely mladé, jako Marilyn Monroe, nebo se proslavily jen krátce a v omezeném období vzniklo mnoho snímků. Dotazování Stable Diffusion lze chápat jako určitý současný index popularity nových i starších hvězd. U některých dřívějších i současných celebrit není dost zdrojových obrazů pro velmi dobrou podobnost. Trvalá obliba konkrétních dávno zemřelých či jinak zapomenutých hvězd naopak zajišťuje, že systém dokáže vytvořit přiměřeně věrnou podobu.

Rendery Stable Diffusion rychle ukážou, které slavné tváře jsou dobře zastoupeny v trénovacích datech. Navzdory obrovské popularitě Millie Bobby Brown jako starší teenagerky v době psaní byla mladší a méně známá, když se zdrojové datové sady LAION stahovaly z webu. Vytvořit její vysoce věrnou podobu pomocí Stable Diffusion je proto nyní problematické.
V případě, že data jsou k dispozici, řešení založená na dlaždicích v Stable Diffusion by mohly jít dále než zaměřování se na tvář; mohly by potenciálně umožnit ještě přesnější a detailnější tváře rozložením obličejových rysů a zaměřením celých dostupných zdrojů GPU na jednotlivé rysy, před opětovným sestavením – proces, který je nyní ruční.

To není omezeno na tváře, ale je omezeno na části objektů, které jsou alespoň tak předvídatelně umístěny v širším kontextu hostitelského objektu, a které se shodují s vektorovými reprezentacemi vysoké úrovně, které lze rozumně očekávat v hyperscale datasetu.
Skutečné omezení je množství dostupných referenčních dat v datasetu, protože nakonec hluboce iterované detaily budou zcela “hallucinované” (tj. fiktivní) a méně autentické.
Taková vysoká úroveň granulárních zvětšení funguje v případě Jennifer Connelly, protože je dobře zastoupena v různých věkových obdobích v LAION-aesthetics (primární podmnožina LAION 5B, kterou Stable Diffusion používá); a obecně v LAION; ve mnoha dalších případech by přesnost trpěla nedostatkem dat, vyžadujícím buď jemné ladění (další trénování, viz “Customizace” níže) nebo Textual Inversion (viz níže).
Dlaždice jsou silným a relativně levným způsobem, jak Stable Diffusion může produkovat hi-res výstup, ale algoritmické dlaždicové upscaling tohoto druhu, pokud postrádá nějaký širší, vyšší mechanismus pozornosti, může nedosáhnout očekávaných standardů napříč různými typy obsahu.
2: Řešení problémů s lidskými končetinami
Stable Diffusion nedosahuje svého jména, když zobrazuje složitost lidských končetin. Ruce se mohou náhodně množit, prsty se mohou shlukovat, třetí nohy se mohou objevit bez varování, a existující končetiny mohou zmizet bez stopy. Ve své obraně sdílí Stable Diffusion tento problém s dalšími podobnými modely a zcela jistě s DALL-E 2.

Neditované výsledky z DALL-E 2 a Stable Diffusion (1.4) na konci srpna 2022, oba ukazující problémy s končetinami. Prompt je ‘A woman embracing a man’
Stable Diffusion fanoušci, kteří doufají, že budoucí checkpoint 1.5 (více intenzivně trénovaná verze modelu s vylepšenými parametry) vyřeší problém s končetinami, budou pravděpodobně zklamáni. Nový model, který vyjde asi za dva týdny, je nyní předběžně dostupný na komerčním portálu stability.ai DreamStudio, který používá 1.5 jako výchozí, a kde uživatelé mohou porovnat nový výstup s renderováním z jejich místních nebo jiných 1.4 systémů:

Zdroj: Místní 1.4 prepack a https://beta.dreamstudio.ai/

Zdroj: Místní 1.4 prepack a https://beta.dreamstudio.ai/

Zdroj: Místní 1.4 prepack a https://beta.dreamstudio.ai/
Jako je často případ, kvalita dat by mohla být primárním přispívajícím faktorem.
Otevřené zdrojové databáze, které pohánějí systémy syntézy obrazu, jako je Stable Diffusion a DALL-E 2, jsou schopny poskytnout mnoho štítků pro jednotlivé lidi a interakce mezi lidmi. Tyto štítky se trénují symbioticky s jejich přidruženými obrázky nebo segmenty obrázků.

Uživatelé Stable Diffusion mohou prozkoumat koncepty trénované do modelu dotazováním datasetu LAION-aesthetics, podmnožiny většího datasetu LAION 5B, který pohání systém. Obrázky jsou seřazeny ne podle abecedních štítků, ale podle ‘aesthetického skóre’. Zdroj: https://rom1504.github.io/clip-retrieval/
dobrá hierarchie individuálních štítků a tříd, které přispívají k zobrazení lidské paže, by mohla být něco jako tělo>paže>ruka>prsty>[podrobnosti prstů + palec]>[segmenty prstů]>Nehty.

Granulární semantická segmentace částí ruky. I tato neobvykle detailní dekonstrukce ponechává každý ‘prst’ jako samostatnou entitu, aniž by zohledňovala tři sekce prstu a dvě sekce palce. Zdroj: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
Ve skutečnosti jsou zdrojové obrázky nejspíš nebudou takto konzistentně anotovány napříč celým datasetem, a nesupervizované algoritmy štítkování pravděpodobně zastaví na vyšší úrovni – například – ‘ruka’, a ponechají vnitřní pixely (které technicky obsahují ‘prst’ informace) jako neoznačenou masu pixelů, ze kterých budou rysy svévolně odvozovány, a které se mohou projevit v pozdějších renderováních jako rušivý prvek.

Jak by to mělo být (horní pravá, pokud nejde o zvedák), a jak tomu obvykle bývá (dolní pravá), kvůli omezeným zdrojům pro štítkování, nebo architektonickému využití takových štítků, pokud existují v datasetu.
Protože, pokud latentní difuzní model dosáhne renderování paže, je téměř jistě bude mít alespoň pokus o renderování ruky na konci té paže, protože paže>ruka je minimální požadovaná hierarchie, poměrně vysoko v tom, co architektura ví o ‘lidské anatomii’.
Po tom, ‘prsty’ mohou být nejmenší seskupení, i když existují 14 dalších podčástí prstů a palce, které je třeba zohlednit při zobrazování lidských rukou.
Pokud tato teorie platí, neexistuje žádný skutečný lék, kvůli široce rozšířenému nedostatku rozpočtu na manuální anotaci, a nedostatku dostatečně účinných algoritmů, které by mohly automatizovat štítkování, zatímco produkují nízké chybové sazby. Ve skutečnosti se model může nyní spoléhat na lidskou anatomickou konzistenci, aby zakryl nedostatky datasetu, na kterém byl trénován.
Jedním z možných důvodů, proč nelze spoléhat se na to, nedávno navržen na Stable Diffusion Discord, je, že model by se mohl stát zmateným ohledně správného počtu prstů, které by měl mít (realistická) lidská ruka, protože LAION-derived databáze, která pohání, obsahuje kreslené postavy, které mohou mít méně prstů (což je samo o sobě zkratka šetřící práci).

Dva z potenciálních viníků v ‘chybějícího prstu’ syndromu v Stable Diffusion a podobných modelech. Dole, příklady kreslených rukou z datasetu LAION-aesthetics, který pohání Stable Diffusion. Zdroj: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Pokud je to pravda, pak jediným zjevným řešením je re-trénovat model, vyloučením nerealistického lidského obsahu, zajišťujícím, že skutečné případy omezení (tj. amputace) jsou vhodně označeny jako výjimky. Z hlediska kurace dat by to byla značná výzva, zejména pro komunitní úsilí s omezenými zdroji.
Druhým přístupem by bylo aplikovat filtry, které vylučují takový obsah (tj. ‘ruka se třemi/pěti prsty’) z manifestace v době renderování, podobně jako OpenAI do jisté míry filtroval GPT-3 a DALL-E 2, aby jejich výstup mohl být regulován, aniž by bylo nutné re-trénovat zdrojové modely.

Pro Stable Diffusion, semantická distinkce mezi prsty a dokonce končetinami se může stát strašně rozostřenou, připomínající proud tělesného hororu v hororových filmech 80. let od tvůrců, jako je David Cronenberg. Zdroj: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Opět by však byly zapotřebí štítky, které možná neexistují u všech zasažených obrazů, takže zůstává stejná logistická a rozpočtová výzva.
Mohlo by se argumentovat, že existují dvě zbývající cesty vpřed: házení více dat na problém a aplikování třetích stran interpretativních systémů, které mohou zasáhnout, když jsou fyzické chyby tohoto druhu prezentovány koncovému uživateli (alespoň by to dalo OpenAI metodu pro poskytování refundací za ‘body horror’ renderování, pokud by společnost byla motivována k tomu).
3: Customizace
Jednou z nejzajímavějších možností pro budoucnost Stable Diffusion je perspektiva uživatelů nebo organizací, které vyvíjejí revidované systémy; modifikace, které umožňují integrovat obsah mimo předtrénovaný LAION sféru do systému – ideálně bez nekontrolovatelných nákladů na trénování celého modelu znovu, nebo rizika spojeného s trénováním velkého množství nových obrazů do existujícího, zralého a schopného modelu.
Podobně: pokud se dva méně nadaní studenti připojí k pokročilé třídě třiceti studentů, buď se přizpůsobí a dorovnají, nebo selžou jako outsidéři; v každém případě se pravděpodobně nebude měnit průměrný výkon třídy. Pokud se však patnáct méně nadaných studentů připojí, je pravděpodobné, že se křivka hodnocení pro celou třídu zhorší.
Podobně, synergická a poměrně jemná síť vztahů, která se vyvíjí během trénování modelu, může být kompromitována, v některých případech efektivně zničena, nadměrnými novými daty, snižujícími kvalitu výstupu modelu ve všech oblastech.
Případ pro to je primárně tehdy, když váš zájem spočívá v kompletním převzetí konceptuálního pochopení modelu vztahů a věcí a jeho přizpůsobení pro exkluzivní produkci obsahu, který je podobný dodatečnému materiálu, který jste přidali.
Takže trénování 500 000 snímků Simpsonů do existujícího Stable Diffusion checkpointu by mohlo nakonec získat lepší Simpsonův simulátor, než by původní sestavení mohlo nabídnout, předpokládajíc, že dostatečně široké semantické vztahy přežijí proces (tj. Homer Simpson jí hot dog, který může vyžadovat materiál o hot dogech, který nebyl ve vašem dodatečném materiálu, ale již existoval v checkpointu), a předpokládajíc, že nechcete náhle přejít z Simpsonů obsahu na vytváření úžasného krajinného snímku od Grega Rutkowského – protože váš post-trénovaný model měl svou pozornost masivně odvedenou, a nebude tak dobrý v tom, co dělal dříve.
Jedním z nejvýznamnějších příkladů je waifu-diffusion, který úspěšně post-trénoval 56 000 anime obrazů do dokončeného a trénovaného Stable Diffusion checkpointu. Je to těžká perspektiva pro hobbyistu, protože model vyžaduje ohromující minimum 30 GB VRAM, daleko za tím, co je pravděpodobně k dispozici na spotřebitelské úrovni v budoucích 40XX sériích NVIDIA.

Trénování vlastního obsahu do Stable Diffusion prostřednictvím waifu-diffusion: model trval dva týdny post-trénování, aby dosáhl této úrovně ilustrace. Šest obrazů vlevo ukazuje pokrok modelu, jak postupovalo trénování, v vytváření subjekt-coherentního výstupu na základě nových trénovacích dat. Zdroj: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Veliké úsilí by mohlo být vynaloženo na takové ‘forky’ Stable Diffusion checkpointů, pouze aby byly zmařeny technickým dluhem. Vývojáři na oficiálním Discordu již uvedli, že pozdější checkpointy nemusí být nutně zpětně kompatibilní, ani s prompt logikou, která fungovala s předchozí verzí, protože jejich primárním zájmem je získat nejlepší model možný, spíše než podporovat legacy aplikace a procesy.
Proto společnost nebo jedinec, který se rozhodne odvětvit checkpoint do komerčního produktu, efektivní nemá žádnou cestu zpět; jejich verze modelu je v tomto okamžiku ‘hard fork’, a nebude moci čerpat výhody z pozdějších vydání stability.ai – což je značný závazek.
Současnou a větší nadějí pro customizaci Stable Diffusion je Textual Inversion, kde uživatel trénuje malé množství CLIP sladěných obrazů.

Spolupráce mezi Tel Aviv University a NVIDIA, textual inversion umožňuje trénovat diskrétní a nové entity, bez ničení schopností zdrojového modelu. Zdroj: https://textual-inversion.github.io/
Primární zjevné omezení textual inversion je, že je doporučeno velmi nízké množství obrazů – třeba pouhých pět. To v podstatě vytváří omezenou entitu, která může být více užitečná pro úkoly stylu přenosu než pro vkládání fotorealistických objektů.
Přestože experimenty nyní probíhají v rámci různých Stable Diffusion Discord, které používají mnohem více trénovacích obrazů, zůstává být vidět, jak produktivní tato metoda může být. Opět, technika vyžaduje mnoho VRAM, času a trpělivosti.
Z důvodu těchto limitujících faktorů můžeme čekat, až uvidíme některé z více sofistikovaných textual inversion experimentů od Stable Diffusion nadšenců – a zda nebo ne tento přístup může ‘vložit vás do obrazu’ způsobem, který vypadá lépe než Photoshop cut-and-paste, zatímco zachovává úžasné funkčnosti oficiálních checkpointů.
Poprvé zveřejněno 6. září 2022.


