
Prompt engineering
ChatGPT a pokročilé inženýrství promptů: Pohání evoluci AI

 Přidejte Unite.AI mezi své preferované zdroje na Google

OpenAI sehrál klíčovou roli ve vývoji revolučních nástrojů, jako je OpenAI Gym, který je navržen pro školení algoritmů učení se posilováním, a modelů GPT-n. Pozornost je také upřena na DALL-E, model AI, který vytváří obrázky z textových vstupů. Jedním z takových modelů, které získaly značnou pozornost, je ChatGPT od OpenAI, který je výborným příkladem v oblasti velkých jazykových modelů.
GPT-4: Inženýrství promptů
ChatGPT změnil krajinu chatbotů, nabízející lidsky podobné odpovědi na vstupy uživatelů a rozšiřuje své aplikace napříč doménami – od vývoje a testování softwaru až po obchodní komunikaci a dokonce i tvorbu poezie.
V rukou firem a jednotlivců by GPT-4, například, mohl sloužit jako nevyčerpatelný rezervoár znalostí, zdatný v předmětech sahajících od matematiky a biologie po právní studia. Takto sofistikované a dostupné modely AI jsou připraveny předefinovat budoucnost práce, učení a tvořivosti.

Generativní modely, jako je GPT-4, mohou produkovat nová data na základě existujících vstupů. Tato odlišující vlastnost umožňuje jim provádět různé úkoly, včetně generování textu, obrázků, hudby a videa.
V kontextu ChatGPT a modelů OpenAI je prompt vstup, který uživatelé poskytují modelům, obvykle ve formě textu. Prompty slouží jako primární prostředek pro kontrolu výstupu generovaného těmito modely, což je zásadní pro úspěšné a relevantní konverzace.
Dopad kvality promptů
Používání dobře definovaných promptů je klíčem k zapojení do užitečných a smysluplných konverzací s systémy AI. Špatně definované prompty mohou vést k výstupu, který není užitečný pro uživatele a může dokonce vést k zavádějícím informacím.
Pro demonstraci dopadu kvality promptů srovnejme dvě různé prompty poskytnuté ChatGPT. První prompt, špatně definovaný a předpokládající předchozí znalosti, generuje potenciálně neužitečnou odpověď pro uživatele. Na druhé straně druhý prompt poskytuje více kontextu a příkladů, zajišťující relevantnější a srozumitelnější odpověď.
Prompt 1: “Řekněte mi o Konvolučních neuronových sítích.”
Odpověď 1: “Konvoluční neuronové sítě (CNN) jsou multi-layer perceptron sítě, které se skládají z plně propojených vrstev a pooling vrstev. Používají se běžně pro úkoly rozpoznávání obrazů. Proces zahrnuje aplikaci filtrů na vstupní obrazy a downscaling pomocí pooling vrstev.”
Prompt 2: “Chci se naučit o Konvolučních neuronových sítích, ale nemám žádné předchozí znalosti o umělých neuronových sítích. Můžete mi prosím poskytnout začátečník-friendly vysvětlení a příklad toho, jak CNN pracují v rozpoznávání obrazů?”
Odpověď 2: “Konvoluční neuronové sítě (CNN) jsou typ neuronové sítě primárně používané pro úkoly rozpoznávání obrazů. Na rozdíl od ostatních neuronových sítí využívají konvoluční vrstvy a pooling vrstvy pro zpracování obrazů. Představte si, že máte obraz kočky. CNN mohou identifikovat různé rysy v obraze, jako jsou vousy, uši a ocas, aplikací filtrů a downscaling pomocí pooling vrstev. Tento proces činí CNN vysoce efektivní pro rozpoznávání objektů v obrazech.”
Porovnáním obou odpovědí je zřejmé, že dobře definovaný prompt vede k relevantnější a uživatelsky přívětivější odpovědi. Návrh a inženýrství promptů jsou rostoucí disciplíny, které cílí na optimalizaci kvality výstupu modelů AI, jako je ChatGPT.
_v další části tohoto článku se budeme zabývat pokročilými metodami zaměřenými na rafinování velkých jazykových modelů (LLM), jako jsou techniky inženýrství promptů a taktiky. Tyto zahrnují few-shot učení, ReAct, chain-of-thought, RAG a další.
Pokročilé inženýrství techniky
Než budeme pokračovat, je důležité pochopit jeden zásadní problém s LLM, označovaný jako “halucinace”. V kontextu LLM označuje “halucinace” tendenci těchto modelů generovat výstupy, které mohou vypadat rozumně, ale nejsou zakořeněny ve faktické realitě nebo daném kontextu vstupu.
Tento problém byl dramaticky zdůrazněn v nedávném soudním případu, kde obhájce použil ChatGPT pro právní výzkum. AI nástroj, selhávající kvůli svému problému s halucinacemi, citoval neexistující právní případy. Tento krok měl významné důsledky, způsobující zmatek a podkopávající důvěryhodnost během řízení. Tento incident slouží jako ostré připomenutí naléhavé potřeby řešit problém “halucinace” v systémech AI.
Naše prozkoumání technik inženýrství promptů cílí na zlepšení těchto aspektů LLM. Zlepšením jejich efektivity a bezpečnosti otevíráme cestu k inovativním aplikacím, jako je extrakce informací. Kromě toho to umožňuje bezproblémovou integraci LLM s externími nástroji a zdroji dat, rozšiřující rozsah jejich potenciálních použití.
Nulové a few-shot učení: Optimalizace pomocí příkladů
Generativní Pretrained Transformery (GPT-3) označily důležitý obrat ve vývoji generativních modelů AI, neboť zavedly koncept “few-shot učení“. Tato metoda byla hrou měnící pravidla díky své schopnosti fungovat efektivně bez potřeby komplexního fine-tuningu. Rámec GPT-3 je diskutován v článku “Language Models are Few Shot Learners“, kde autoři demonstrují, jak model vyniká napříč různými případy použití bez nutnosti vlastních datových sad nebo kódu.
Na rozdíl od fine-tuningu, který vyžaduje neustálé úsilí pro řešení různých případů použití, few-shot modely prokazují snadnější adaptabilitu na širší škálu aplikací. Zatímco fine-tuning může poskytnout robustní řešení v některých případech, může být nákladný v měřítku, což činí použití few-shot modelů praktičtějším přístupem, zejména když je integrováno s inženýrstvím promptů.
Představte si, že se snažíte přeložit angličtinu do francouzštiny. Při few-shot učení byste poskytli GPT-3 s několika překladovými příklady, jako je “sea otter -> loutre de mer”. GPT-3, being pokročilý model, je poté schopen pokračovat v poskytování přesných překladů. V nulovém shot učení byste neposkytovali žádné příklady, a GPT-3 by stále mohl přeložit angličtinu do francouzštiny efektivně.
Pojem “few-shot učení” pochází z myšlenky, že model je dán omezeným počtem příkladů, ze kterých se “učí”. Je důležité poznamenat, že “učení” v tomto kontextu nezahrnuje aktualizaci parametrů nebo váh modelu, ale spíše ovlivňuje výkon modelu.

Few Shot Learning jako demonstrováno v GPT-3 Paper
Nulové shot učení jde o krok dále. V nulovém shot učení nejsou poskytovány žádné příklady úkolu dokončení v modelu. Model se očekává, že bude fungovat dobře na základě svého počátečního školení, což z něj činí ideální metodologii pro scénáře otevřené domény, jako je ChatGPT.
V mnoha případech může model zdatný v nulovém shot učení fungovat dobře, když je poskytnut s few-shot nebo dokonce single-shot příklady. Tato schopnost přepínat mezi nulovým, single-shot a few-shot učeními scénáři podtrhuje adaptabilitu velkých modelů, zvyšující jejich potenciální aplikace napříč různými doménami.
Nulové shot učení metody se stávají stále více populárními. Tyto metody jsou charakterizovány svou schopností rozpoznávat objekty, které nebyly vidět během školení. Zde je praktický příklad Few-Shot Promptu:
"Přeložte následující anglické fráze do francouzštiny:
'sea otter' translates to 'loutre de mer'
'sky' translates to 'ciel'
'What does 'cloud' translate to in French?'"
Poskytováním modelu s několika příklady a poté položením otázky můžeme efektivně vést model k generování požadovaného výstupu. V tomto případě by GPT-3 pravděpodobně správně přeložil ‘cloud’ do ‘nuage’ ve francouzštině.
Budeme se dále zabývat různými nuancemi technik inženýrství promptů a jejich zásadním rolí v optimalizaci výkonu modelu během inferencí. Také se podíváme, jak lze efektivně použít k vytvoření nákladově efektivní a škálovatelných řešení napříč širokou škálou případů použití.
Jako jsme dále prozkoumali složitost technik inženýrství promptů v modelech GPT, je důležité zdůraznit náš poslední příspěvek ‘Základní průvodce inženýrstvím promptů v ChatGPT‘. Tento průvodce poskytuje přehled strategií pro efektivní instruování modelů AI napříč širokou škálou případů použití.
V našich předchozích diskuzích jsme se zabývali základními metodami promptů pro velké jazykové modely (LLM), jako je nulové a few-shot učení, stejně jako instrukční prompting. Zvládnutí těchto technik je zásadní pro řešení složitějších výzev inženýrství promptů, které budeme prozkoumávat zde.
Few-shot učení může být omezeno kvůli omezenému kontextovému oknu většiny LLM. Kromě toho, bez odpovídajících bezpečnostních opatření, LLM mohou být zmátény a poskytovat potenciálně škodlivé výstupy. Navíc, mnoho modelů zápasí s úkoly rozumu nebo následováním více-krokových instrukcí.
Dána tato omezení, výzva spočívá v využití LLM pro řešení složitých úkolů. Zjevným řešením by mohlo být vývoj pokročilejších LLM nebo rafinace existujících, ale to by mohlo vyžadovat podstatné úsilí. Takže, otázka vyvstává: jak můžeme optimalizovat současné modely pro zlepšení řešení problémů?
Rovněž fascinující je prozkoumání toho, jak tato technika rozhraní s kreativními aplikacemi v Unite AI’s ‘Mastering AI Art: A Concise Guide to Midjourney and Prompt Engineering‘, který popisuje, jak fúze umění a AI může vést k úžasným uměleckým dílům.
Chain-of-thought Prompting
Chain-of-thought prompting využívá inherenetní auto-regresivní vlastnosti velkých jazykových modelů (LLM), které vynikají v předpovídání následujícího slova v dané sekvenci. Promptováním modelu, aby vysvětlil svůj myšlenkový proces, indukuje se více důkladný, metodický generování nápadů, které tenduje k tomu, aby se shodovalo s přesnými informacemi. Tento soulad pochází z modelovy tendence zpracovávat a poskytovat informace způsobem, který je podobný lidskému odborníkovi, který vede posluchače skrz složitý koncept. Jednoduché prohlášení, jako je “projděte mě krok za krokem, jak…”, je často dostatečné k vyvolání tohoto více verbose, podrobného výstupu.
Nulový chain-of-thought Prompting
Zatímco konvenční CoT prompting vyžaduje pre-trénování s demonstracemi, vznikající oblastí je nulový CoT prompting. Tento přístup, představený Kojimou et al. (2022), inovativně přidává frázi “Let’s think step by step” k původnímu promptu.
Vytvoříme pokročilý prompt, kde ChatGPT je úkolován k souhrnu hlavních závěrů z AI a NLP výzkumných prací.
V této demonstraci budeme používat schopnost modelu pochopit a souhrnout komplexní informace z akademických textů. Použijeme few-shot learning přístup, abychom naučili ChatGPT souhrnout hlavní závěry z AI a NLP výzkumných prací:
1. Název článku: "Attention Is All You Need"
Hlavní závěr: Představen transformer model, zdůrazňující důležitost mechanismů pozornosti nad rekurentními vrstvami pro úkoly sekvenční transdukce.
2. Název článku: "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding"
Hlavní závěr: Představen BERT, demonstrující účinnost pre-trénování hlubokých bidirekčních modelů, dosahující state-of-the-art výsledků na různých NLP úkolech.
Nyní, s kontextem těchto příkladů, souhrneme hlavní závěry z následujícího článku:
Název článku: "Prompt Engineering in Large Language Models: An Examination"
Tento prompt nejen udržuje jasný chain-of-thought, ale také využívá few-shot learning přístup k vedení modelu. Váže se k našim klíčovým slovům, zaměřujícím se na AI a NLP domény, konkrétně úkolujícím ChatGPT provést složitý úkol, který je spojen s inženýrstvím promptů: souhrn výzkumných prací.
ReAct Prompt
ReAct, nebo “Reason and Act”, byl představen Googlem v článku “ReAct: Synergizing Reasoning and Acting in Language Models“, a revolucionalizoval, jak jazykové modely interagují s úkolem, promptujícím model, aby dynamicky generoval jak verbální reasoning stopy, tak úkol-specifické akce.
Představte si lidského šéfkuchaře v kuchyni: on nejen provádí řadu akcí (krájení zeleniny, vaření vody, míchání ingrediencí), ale také se angažuje v verbálním rozumu nebo vnitřním projevu (“nyní, když je zelenina nakrájena, měl bych dát hrnec na sporák”). Tento neustálý mentální dialog pomáhá ve strategizování procesu, adaptaci na náhlé změny (“jsem bez olivového oleje, použiji máslo místo něj”), a pamatování sekvenci úkolů. ReAct napodobuje tuto lidskou schopnost, umožňující modelu rychle se učit nové úkoly a dělat robustní rozhodnutí, stejně jako lidský by v nových nebo nejistých situacích.
ReAct může řešit halucinaci, běžný problém s Chain-of-Thought (CoT) systémy. CoT, ačkoli efektivní technika, postrádá kapacitu interagovat s vnějším světem, což by mohlo potenciálně vést k faktické halucinaci a chybové propagaci. ReAct, nicméně, kompenzuje to interagujícím s vnějšími zdroji informací. Tato interakce umožňuje systému nejen ověřit svůj rozum, ale také aktualizovat své znalosti na základě nejnovějších informací z vnějšího světa.
Základní fungování ReAct lze vysvětlit prostřednictvím instance z HotpotQA, úkolu vyžadujícího vyšší řád rozumu. Při obdržení otázky ReAct model rozloží otázku na zpracovatelné části a vytvoří plán akce. Model generuje reasoning stopu (myšlenku) a identifikuje relevantní akci. Může se rozhodnout vyhledat informace o Apple (AAPL ) Remote na vnějším zdroji, jako je Wikipedia (akce), a aktualizuje své porozumění na základě získaných informací (pozorování). Prostřednictvím více myšlenkových-akčních-pozorovacích kroků může ReAct získat informace pro podporu svého rozumu, zatímco rafinuje, co potřebuje získat další.
Poznámka:
HotpotQA je datová sada, odvozená z Wikipedie, složená z 113k otázek-odpovědí párů navržených pro trénování AI systémů v komplexním rozumu, protože otázky vyžadují rozumnění nad několika dokumenty, aby odpověděly. Na druhé straně CommonsenseQA 2.0, postavený prostřednictvím gamifikace, zahrnuje 14,343 ano/ne otázky a je navržen pro výzvu AI porozumění běžnému rozumu, protože otázky jsou úmyslně vytvořeny, aby zmátly AI modely.
Proces by mohl vypadat takto:
- Myšlenka: “Potřebuji hledat Apple Remote a jeho kompatibilní zařízení.”
- Akce: Hledá “Apple Remote kompatibilní zařízení” na vnějším zdroji.
- Pozorování: Získává seznam zařízení kompatibilních s Apple Remote z výsledků hledání.
- Myšlenka: “Na základě výsledků hledání, několik zařízení, kromě Apple Remote, může ovládat program, pro který byl původně navržen.”
Výsledek je dynamický, založený na rozumu proces, který se může vyvíjet na základě informací, se kterými interaguje, vedoucí k více přesným a spolehlivým odpovědím.

Komparativní vizualizace čtyř prompting metod – Standard, Chain-of-Thought, Act-Only, a ReAct, při řešení HotpotQA a AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
Navrhování ReAct agentů je specializovaný úkol, daný jejich schopností dosáhnout složitých cílů. Například, konverzační agent, postavený na základním ReAct modelu, zahrnuje konverzační paměť pro bohatší interakce. Nicméně, složitost tohoto úkolu je zjednodušena nástroji, jako je Langchain, které se staly standardem pro navrhování těchto agentů.
Context-faithful Prompting
Článek ‘Context-faithful Prompting for Large Language Models‘ zdůrazňuje, že zatímco LLM prokázaly podstatný úspěch v znalostních NLP úkolech, jejich nadměrná závislost na parametrizovaných znalostech může vést je stranou v kontextově citlivých úkolech. Například, když je jazykový model trénován na zastaralých faktech, může produkovat nesprávné odpovědi, pokud přehlíží kontextové nápovědy.
Tento problém je zjevný v případech znalostního konfliktu, kde kontext obsahuje fakta, která se liší od LLM předchozích znalostí. Představte si případ, kdy LLM, naprogramovaný s daty před Mistrovstvím světa 2022, je dán kontext, který naznačuje, že Francie vyhrála turnaj. LLM, spoléhající se na své předchozí znalosti, pokračuje v tvrzení, že předchozí vítěz, tj. tým, který vyhrál v roce 2018, je stále vládnoucím šampionem. To demonstruje klasický případ “znalostního konfliktu”.
Podstatou je, že znalostní konflikt v LLM vyvstává, když nová informace poskytnutá v kontextu rozporuje předchozí znalosti, na kterých byl model trénován. Tendence modelu spoléhat se na své předchozí tréninkové data, spíše než na nově poskytnutý kontext, může vést k nesprávným výstupům. Na druhé straně, halucinace v LLM je generování odpovědí, které mohou vypadat rozumně, ale nejsou zakořeněny v modelových tréninkových datech nebo poskytnutém kontextu.
Jiný problém vyvstává, když poskytnutý kontext neobsahuje dostatek informací pro správnou odpověď, situace známá jako předpověď s zdržení se. Například, pokud je LLM požádán o zakladatele Microsoftu na základě kontextu, který tuto informaci neposkytuje, měl by ideálně zdržet se odhadování.
(GOOGL )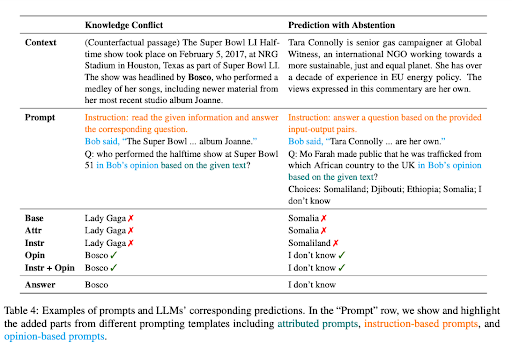
Více znalostního konfliktu a síla zdržení se příklady
Pro zlepšení kontextové věrnosti LLM v těchto scénářích, výzkumníci navrhli řadu prompting strategií. Tyto strategie cílí na to, aby odpovědi LLM byly více v souladu s kontextem, než aby se spoléhaly na jejich zakódované znalosti.
Jedna taková strategie je formulovat prompty jako názorové otázky, kde kontext je interpretován jako prohlášení vyprávěče, a otázka se týká tohoto vyprávěče názoru. Tento přístup refokusuje pozornost LLM na prezentovaný kontext, spíše než na jeho předchozí znalosti.
Přidání kontrafaktických demonstrací do promptů bylo také identifikováno jako efektivní způsob, jak zvýšit věrnost v případech znalostního konfliktu. Tyto demonstrace představují scénáře s falešnými fakty, které vedou model k tomu, aby věnoval větší pozornost kontextu pro poskytnutí přesných odpovědí.
Instruction fine-tuning
Instruction fine-tuning je fáze supervizovaného učení, která využívá poskytování modelu s konkrétními instrukcemi, například “Explikujte rozdíl mezi východem a západem slunce.” Instrukce je spárována s odpovídající odpovědí, něco jako “Východ slunce se týká okamžiku, kdy slunce vyčnívá nad obzor ráno, zatímco západ slunce označuje bod, kdy slunce mizí pod obzor večer.” Prostřednictvím této metody model zásadně učí, jak dodržovat a vykonávat instrukce.
Tento přístup podstatně ovlivňuje proces prompting LLM, vedoucí k radikální změně v prompting stylu. Instruction fine-tuned LLM umožňuje okamžitou realizaci nulových shot úkolů, poskytujících bezproblémový úkolový výkon. Pokud LLM ještě nebyl fine-tuned, few-shot learning přístup může být vyžadován, zahrnující einige příklady do vašeho promptu, aby vedl model k požadované odpovědi.
“Instruction Tuning with GPT-4′ diskutuje pokus použít GPT-4 pro generování instruction-following dat pro fine-tuning LLM. Použili bohatou datovou sadu, skládající se z 52,000 jedinečných instruction-following položek v angličtině a čínštině.
Datová sada hraje zásadní roli v instruction tuning LLaMA modelů, otevřené série LLM, vedoucí k vylepšenému nulovému shot výkonu na nových úkolech. Pozoruhodné projekty, jako je Stanford Alpaca, úspěšně využily Self-Instruct tuning, efektivní metodu pro zarovnání LLM s lidským záměrem, využívající data generovaná pokročilými instruction-tuned teacher modely.

Primárním cílem instruction tuning výzkumu je posílit nulové a few-shot generalizační schopnosti LLM. Další datová a modelová škálovatelnost může poskytnout cenné přehledy. S aktuální velikostí GPT-4 dat na 52K a základní LLaMA model velikosti na 7 miliard parametrů, je zde enormní potenciál pro sběr více GPT-4 instruction-following dat a kombinaci s jinými datovými sadami pro trénování větších LLaMA modelů pro lepší výkon.
STaR: Bootstrapping Reasoning With Reasoning
Potenciál LLM je zvláště viditelný v komplexních úkolech rozumu, jako je matematika nebo otázka-odpověď zdravého rozumu. Nicméně, proces indukce jazykového modelu k generování rationálů – série krok za krokem ospravedlnění nebo “chain-of-thought” – má své vlastní výzvy. Často vyžaduje konstrukci velkých rationálních datových sad nebo obětování přesnosti kvůli závislosti pouze na few-shot inferenci.
“Self-Taught Reasoner” (STaR) nabízí inovativní řešení těchto výzev. Utilizuje jednoduchou smyčku pro kontinuální zlepšování modelové schopnosti rozumu. Tento iterativní proces začíná generováním rationálů pro odpovědi na několik otázek pomocí několika racionálních příkladů. Pokud jsou vygenerované odpovědi nesprávné, model se pokusí znovu vygenerovat rationál, tentokrát poskytující správnou odpověď. Model je poté fine-tuned na všech rationálech, které vedly k správným odpovědím, a proces se opakuje.

STaR metodologie, demonstrující její fine-tuning smyčku a vzorek rationálu generace na CommonsenseQA datová sada (https://arxiv.org/pdf/2203.14465.pdf)
Pro ilustraci toho, vezměme praktický příklad: otázka “Co lze použít pro přenos malého psa?” s odpověďmi sahajícími od bazénu po košík. STaR model generuje rationál, identifikující, že odpověď musí být něco, co může nést malého psa, a dochází k závěru, že košík, navržen pro držení věcí, je správná odpověď.
STaR přístup je jedinečný v tom, že využívá modelovu předchozí schopnost rozumu. Zaměřuje se na proces self-generace a rafinace rationálů, iterativně bootstrapující modelovu schopnost rozumu. Nicméně, STaR smyčka má své omezení. Model může selhat při řešení nových problémů v trénovací sadě, protože nedostává žádný přímý tréninkový signál pro problémy, které nedokáže vyřešit. Pro řešení tohoto problému, STaR zavedl rationalizaci. Pro každý problém, který model nedokáže vyřešit, generuje nový rationál, poskytujícím modelu správnou odpověď, což umožňuje modelu rozumnět zpětně.
STaR, proto, stojí jako škálovatelná bootstrap metoda, která umožňuje modelům naučit se generovat své vlastní rationály, zatímco se učí řešit stále složitější problémy. Aplikace STaR prokázala slibné výsledky v úkolech, zahrnujících aritmetiku, matematické slovní úkoly a otázku-odpověď zdravého rozumu. Na CommonsenseQA, STaR vylepšil jak few-shot baseline, tak baseline fine-tuned pro přímou predikci odpovědí a provedl srovnatelně s modelem, který je 30× větší.
Tagged Context Prompts
Koncept “Tagged Context Prompts” se točí kolem poskytování AI modelu s dodatečnou vrstvou kontextu, označujícím určitou informaci ve vstupu. Tyto značky fungují jako ukazatele pro AI, řídící, jak interpretovat kontext přesně a generovat odpověď, která je relevantní a faktická.
Představte si, že máte konverzaci s přítelem o určitém tématu, řekněme “šachy”. Učiníte prohlášení a poté označte ho referencí, jako je “(zdroj: Wikipedia)”. Nyní, váš přítel, který v tomto případě je AI model, ví přesně, odkud vaše informace pocházejí. Tento přístup cílí na to, aby odpovědi AI byly více spolehlivé, snižujíc riziko halucinací, nebo generování falešných faktů.
Jedinečná vlastnost označených kontextových promptů je jejich potenciál pro zlepšení “kontextové inteligence” AI modelů. Například, článek demonstruje to pomocí různých sad otázek extrahovaných z více zdrojů, jako jsou shrnuté články z Wikipedie na různých tématech a sekce z nedávné knihy. Otázky jsou označeny, poskytujíc AI modelu s dodatečným kontextem o zdroji informací.
Tato dodatečná vrstva kontextu může být nesmírně prospěšná při generování odpovědí, které jsou nejen přesné, ale také dodržují poskytnutý kontext, činící výstup AI více spolehlivým a důvěryhodným. (MSFT )
Závěr: Pohled do slibných technik a budoucích směrů
OpenAI ChatGPT demonstruje nevyzkoušený potenciál velkých jazykových modelů (LLM) při řešení složitých úkolů s pozoruhodnou efektivitou. Pokročilé techniky, jako few-shot učení, ReAct prompting, chain-of-thought a STaR, umožňují nám využít tento potenciál napříč širokou škálou aplikací. Jak jsme prozkoumali nuance těchto metodologií, objevil se, jak formují krajinu AI, nabízející bohatší a bezpečnější interakce mezi lidmi a stroji.
<p Navzdory výzvám, jako je znalostní konflikt, nadměrná závislost na parametrizovaných znalostech a potenciál pro halucinaci, tyto AI modely, s richtig prompt inženýrstvím, prokázaly být transformačními nástroji. Instruction fine-tuning, context-faithful prompting a integrace s externími datovými zdroji dále zvyšují jejich schopnost rozumu, učení a adaptace.


