
Погляд Anderson
Видалення об’єктів з відео більш ефективно за допомогою машинного навчання

 Додайте Unite.AI до бажаних джерел у Google
Ключові моментиE2FGVI об'єднує три етапи відеоінпейнтингу в одну наскрізну систему для значного…
Показати більше
- E2FGVI об'єднує три етапи відеоінпейнтингу в одну наскрізну систему для значного підвищення ефективності.
- Система працює в п'ятнадцять разів швидше за попередні методи оптичного потоку, досягаючи при цьому найкращих результатів.
- Новий темпоральний фокальний трансформатор розширює увагу з 2D на 3D для узгодженої генерації вмісту між кадрами.
Нові дослідження з Китаю повідомляють про результати на рівні сучасних досягнень – а також про вражаюче поліпшення ефективності – для нової системи відеоінпейнтінгу, яка може вміло видаляти об’єкти з відеозаписів.
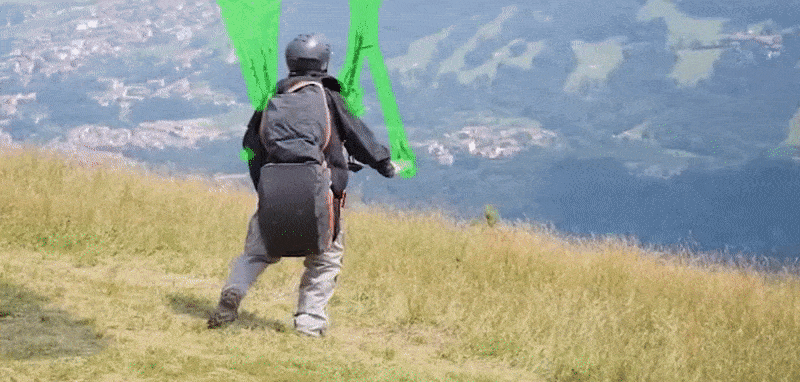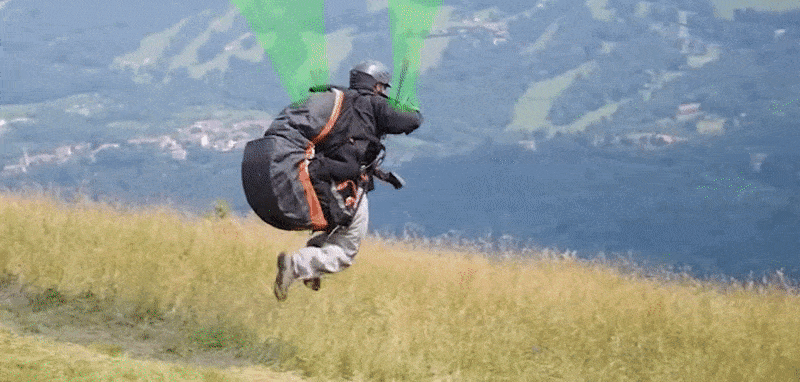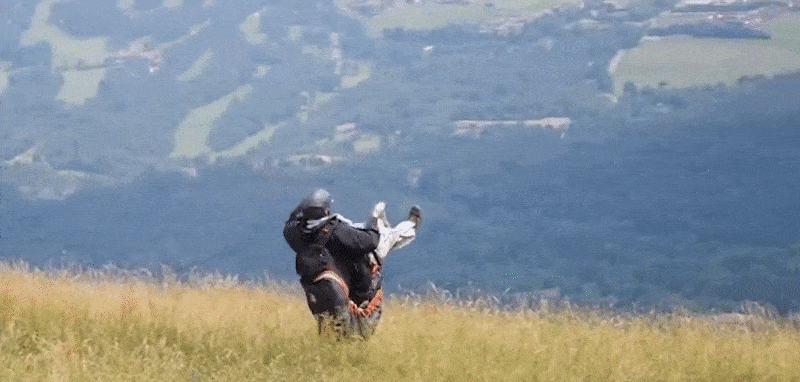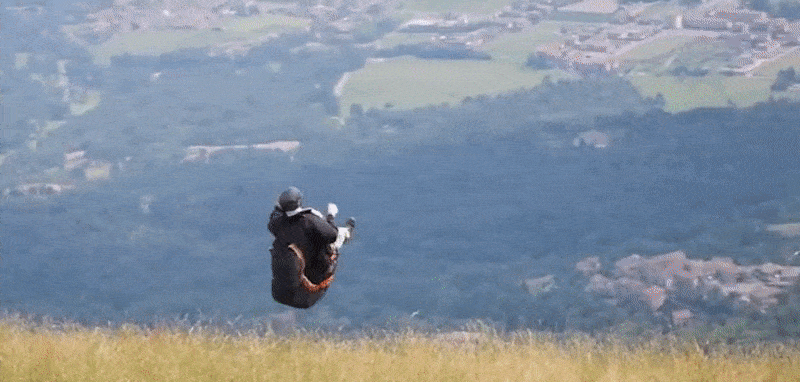
Підвісна система дельтапланериста видаляється з кадру новою процедурою. Дивіться джерельне відео для кращої роздільності та більше прикладів. Джерело: https://www.youtube.com/watch?v=N–qC3T2wc4
Ця техніка, яку називають рамкою End-to-End для Flow-Guided відеоінпейнтінгу (E2FGVI), також здатна видаляти водяні знаки та інші види перекриття з відеоконтенту.
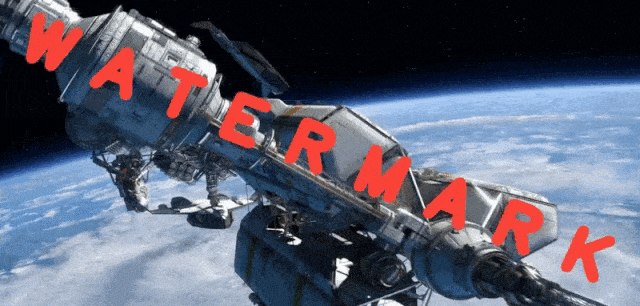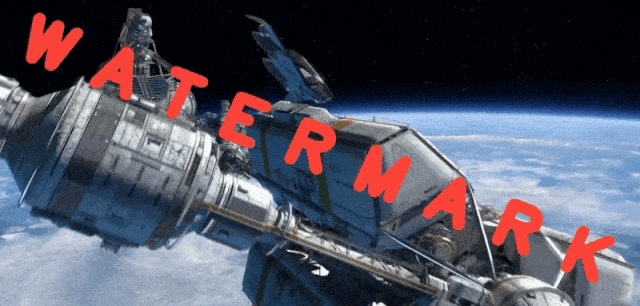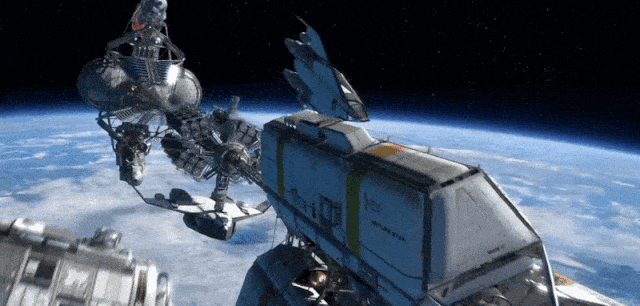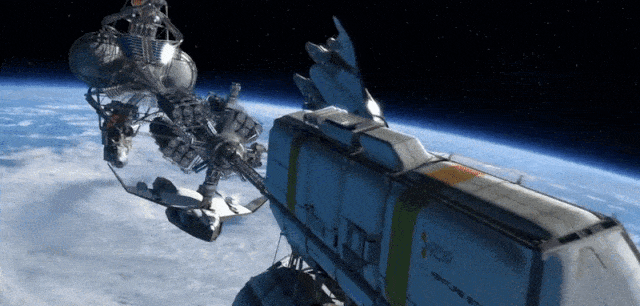
E2FGVI обчислює передбачення для вмісту, який лежить за перекриттями, що дозволяє видаляти навіть помітні та важко доступні водяні знаки. Джерело: https://github.com/MCG-NKU/E2FGVI
(Для перегляду більше прикладів у вищій роздільності дивіться відео)
Хоча модель, представлена у опублікованій статті, була навчена на відео з розміром 432px x 240px (зазвичай низькі розміри входу, обмежені доступним простором GPU проти оптимальних розмірів пакетів та інших факторів), автори вже випустили E2FGVI-HQ, який може обробляти відео довільної роздільності.
Код для поточної версії доступний на GitHub, тоді як версія HQ, випущена минулої неділі, доступна для завантаження з Google Drive та Baidu Disk.

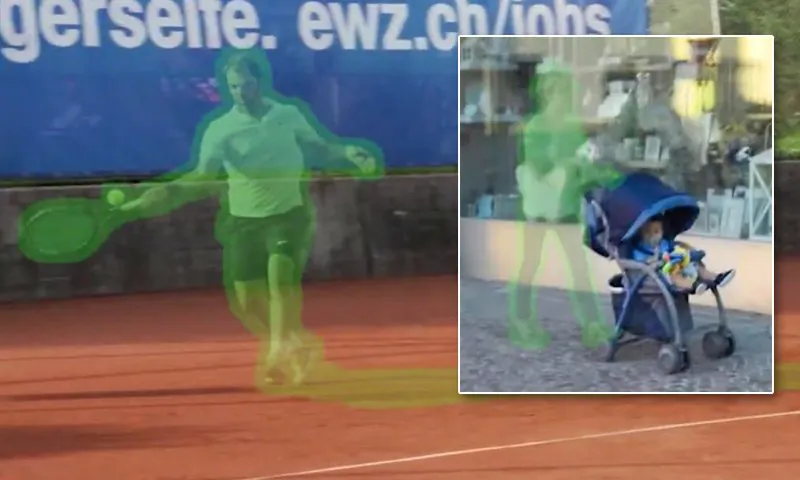
Дитина залишається на картині.
E2FGVI може обробляти відео 432×240 за 0,12 секунди на кадр на GPU Titan XP (12GB VRAM), і автори повідомляють, що система працює в п’ятнадцять разів швидше, ніж попередні найсучасніші методи на основі оптичного потоку.
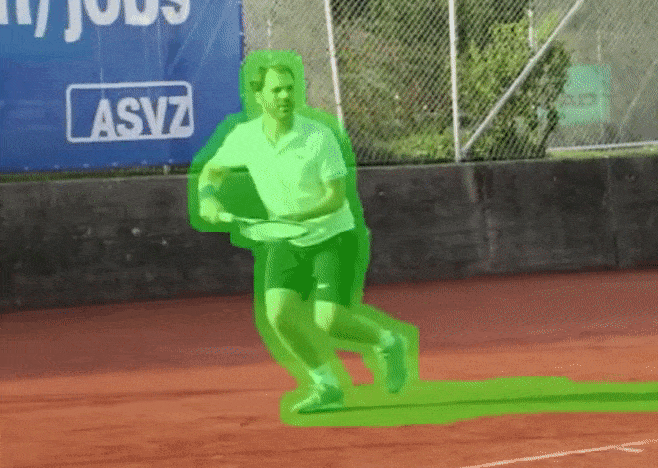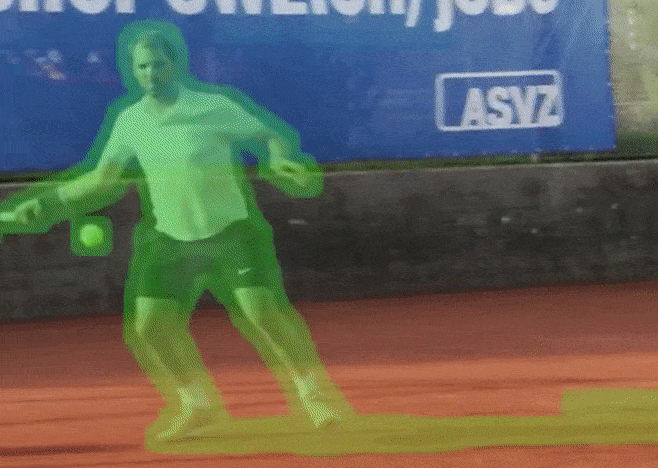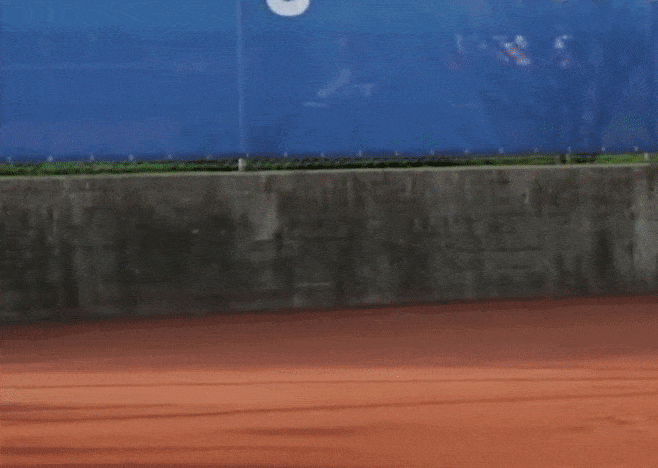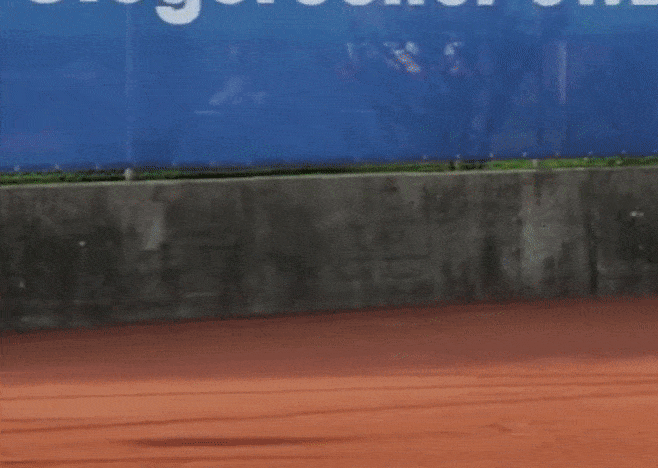
Тенісист несподівано виходить.
Тестований на стандартних наборах даних для цього підсектору досліджень синтезу зображень, новий метод зміг перевершити своїх суперників як у якісних, так і у кількісних раундах оцінювання.

Тести проти попередніх підходів. Джерело: https://arxiv.org/pdf/2204.02663.pdf
Стаття називається Towards An End-to-End Framework for Flow-Guided Video Inpainting і є співпрацею між чотирма дослідниками з Нанкайського університету та дослідником з Hisilicon Technologies.
Що відсутнє в цьому зображенні
Окрім очевидних застосувань для візуальних ефектів, високоякісний відеоінпейнтінг має стати основною визначальною рисою нових технологій синтезу зображень та зміни зображень на основі штучного інтелекту.
Це особливо стосується застосунків для зміни тіла в моді, та інших рамок, які спробують “зробити тоншим” або інакше змінити сцени в зображеннях та відео. У таких випадках необхідно переконливо “заповнити” додатковий фон, який відкривається синтезом.

З недавньої статті, алгоритму зміни форми тіла доручено доповнити щойно відкритий фон, коли суб’єкт змінює розмір. Тут ця нестача представлена червоним контуром, який раніше займала реальна людина повнішої статури (див. зображення ліворуч). Джерело: https://arxiv.org/pdf/2203.10496.pdf
Когерентний оптичний потік
Оптичний потік (OF) став основною технологією у розвитку видалення об’єктів з відео. Як атлас, OF надає одноразову карту часової послідовності. Часто використовується для вимірювання швидкості у ініціативах комп’ютерного зору, OF також може дозволити узгоджений у часі інпейнтінг, де завдання в цілому може бути розглянута в одному проході, а не в стилі Disney “кадр за кадром”, який неминуче призводить до часової непослідовності.
Методи відеоінпейнтінгу на даний момент сконцентровані на триступеневому процесі: довершення потоку, де відео фактично відображається у дискретну та досліджувану сутність; пропагація пікселів, де дірки в “пошкоджених” відео заповнюються двонаправленою пропагацією пікселів; і галюцинація вмісту (винахід пікселів, який знайомий нам з deepfakes та текст-до-зображення рамок, таких як серія DALL-E), де передбачуваний “відсутній” вміст винайдений та вставляється у відео.
Центральною інновацією E2FGVI є об’єднання цих трьох стадій в наскрізну систему, що усуває необхідність ручних операцій з вмістом або процесом.

У статті зазначається, що необхідність ручного втручання вимагає, щоб старіші процеси не використовували GPU, що робить їх досить тривалими. З статті*:
‘Взявши DFVI як приклад, завершення одного відео з розміром 432 × 240 з DAVIS, яке містить близько 70 кадрів, потрібно близько 4 хвилин, що є неприйнятним у більшості реальних застосувань. Окрім вищезазначених недоліків, використання лише попередньо навченої мережі інпейнтінгу зображень на стадії галюцинації вмісту ігнорує відносини між вмістом між сусідніми в часі кадрами, що призводить до неконсистентного згенерованого вмісту у відео.’
Об’єднавши три стадії відеоінпейнтінгу, E2FGVI може замінити другу стадію, пропагацію пікселів, на поширення ознак. У більш фрагментованих процесах попередніх робіт ознаки не так широко доступні, оскільки кожна стадія відносно герметична, а робочий процес лише напівавтоматичний.
Крім того, дослідники розробили часовий фокус-трансформер для стадії галюцинації вмісту, який розглядає не тільки прямих сусідів пікселів у поточному кадрі (тобто те, що відбувається в цій частині кадру в попередньому або наступному зображенні), але також віддалених сусідів, які перебувають далеко в кадрах, і все ж таки впливають на когерентний ефект будь-яких операцій, виконаних над відео в цілому.

Архітектура E2FGVI.
Нова центральна частина робочого процесу, заснована на ознаках, може використовувати більше процесів на рівні ознак і навчувані зміщення вибірки, тоді як новий фокус-трансформер проекту, згідно з авторами, розширює розмір фокус-вікон “з 2D до 3D”.
Тести та дані
Для тестування E2FGVI дослідники оцінили систему проти двох популярних наборів даних для відеооб’єктної сегментації: YouTube-VOS та DAVIS. YouTube-VOS містить 3741 навчальний відеокліп, 474 валідаційних кліпи та 508 тестових кліпів, тоді як DAVIS містить 60 навчальних відеокліпів та 90 тестових кліпів.
E2FGVI був навчений на YouTube-VOS та оцінений на обидвох наборах даних. Під час навчання об’єктні маски (зелені області на зображеннях вище, та супровідне відео на YouTube) були згенеровані для моделювання відеозавершення.
Для метрик дослідники прийняли пікове співвідношення сигналу до шуму (PSNR), структурну подібність (SSIM), відео-відповідну відстань Fréchet-Інсепшн (VFID) та помилку деформації за оптичним потоком – останню для вимірювання тимчасової стійкості у відео.
Архітектури, проти яких була протестована система, були VINet, DFVI, LGTSM, CAP, FGVC, STTN та FuseFormer.

З кількісної частини статті. Вгору та вниз стрілки вказують, що вищі або нижчі числа кращі, відповідно. E2FGVI досягає найкращих результатів у всіх категоріях. Методи оцінюються згідно з FuseFormer, хоча DFVI, VINet та FGVC не є наскрізними системами, що робить неможливим оцінити їх FLOPs.
Крім досягнення найкращих результатів проти всіх конкуруючих систем, дослідники провели якісне користувацьке дослідження, у якому відео, трансформовані п’ятьма представницькими методами, були показані окремо двадцяти добровольцям, яких просили оцінити їх за візуальною якістю.

Вертикальна вісь представляє відсоток учасників, які віддали перевагу виходу E2FGVI за візуальною якістю.
Автори зазначають, що незважаючи на одностайну перевагу їхнього методу, один з результатів, FGVC, не відображає кількісні результати, і вони припускають, що це вказує на те, що E2FGVI може, оманливим чином, генерувати “більш візуально приємні результати”.
За ефективністю автори зазначають, що їхня система суттєво знижує кількість операцій із плаваючою комою в секунду (FLOPs) та час висновку на одному GPU Titan на наборі даних DAVIS, і спостерігають, що результати показують, що E2FGVI працює в п’ятнадцять разів швидше, ніж потокові методи.
Вони коментують:
‘[E2FGVI] володіє найнижчими FLOPs у порівнянні з усіма іншими методами. Це вказує на те, що запропонований метод є високоефективним для відеоінпейнтінгу.’
*Моє перетворення бібліографічних посилань у тексті авторів у гіперпосилання.
Перша публікація 19 травня 2022 року.
Змінено вівторок 28 жовтня 2025 року, щоб видалити пошкоджене відео та змінити посилання на відео у тілі статті.


