Yapay zeka temelleri
Denetimli ve Denetimsiz Öğrenme

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Denetimli öğrenme hedef cevaplarla eşleştirilmiş örneklerden öğrenir. Denetimsiz öğrenme ise hedef etiketleri olmadan verideki yapıyı arar. Fark, hangi yaklaşımın daha akıllı ya da doğru olduğunda değil; mevcut öğrenme sinyali türünde ve sistemin yanıtlaması amaçlanan soruda yatar.
Bunlar makine öğrenmesi içindeki iki ana paradigma olup, modern sistemler aynı zamanda yarı‑denetimli, kendi‑denetimli ve pekiştirmeli öğrenmeyi de kullanır.
Temel Çıkarımlar
- Denetimli öğrenme bilinen bir hedefi tahmin eder; denetimsiz öğrenme desenler veya temsiller keşfeder.
- Sınıflandırma ve regresyon denetimli görevlerdir; kümeleme, yoğunluk tahmini ve birçok boyut indirgeme yöntemi denetimsizdir.
- Denetimsiz çıktılar otomatik olarak gerçek dünya sınıfları olmayabilir ve değerlendirmesi daha zor olabilir.
- Hesaplama maliyeti ve doğruluk algoritma, veri, görev ve değerlendirmeye bağlıdır; sadece paradigma tek başına belirleyici değildir.
Denetimli öğrenme nasıl çalışır
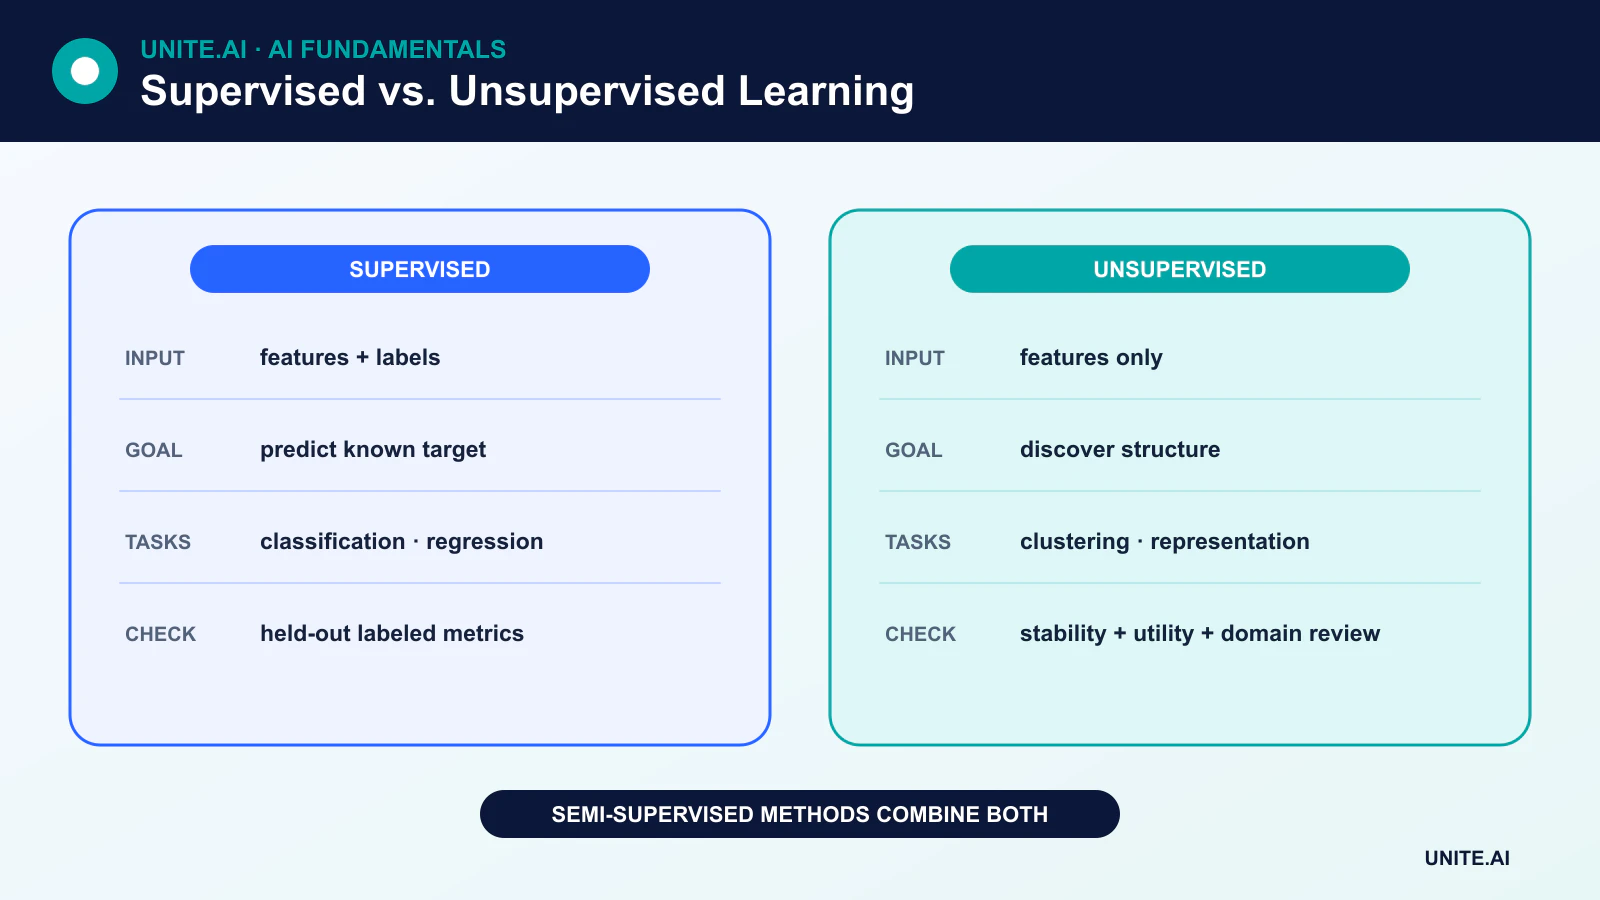
Denetimli bir veri kümesi, X özelliklerini ve y hedefini içerir. Eğitim, modelin tahminlerini hedeflere yaklaştıracak şekilde ayarlar. Değerlendirme, tutturulmuş etiketli örnekleri kullanarak modelin genelleme başarısını tahmin eder.
Sınıflandırma
Sınıflandırma, bir kategori tahmin eder: istenmeyen e-posta mı, değil mi, birden fazla konu arasından bir belge konusu ya da bir görüntüde bir veya daha fazla nesne. İlgili ölçütler arasında kesinlik, geri çağırma, F1, kalibrasyon ve maliyet‑duyarlı ölçümler bulunur. Doğruluk, bir sınıf nadir olduğunda yanıltıcı olabilir; bir karışıklık matrisi hangi sınıfların karıştırıldığını gösterir.
Regresyon
Regresyon, talep, süre ya da sıcaklık gibi sürekli bir değer tahmin eder. Doğrusal regresyon bir veya çok sayıda özellik kullanabilir; iki değişken arasındaki ilişkiyle sınırlı değildir. Regresyon ölçütleri ortalama mutlak hata, kök ortalama kare hatası ve göreve özgü maliyetleri içerir.
Yaygın denetimli algoritmalar
Denetimli yöntemler arasında lineer ve lojistik modeller, karar ağaçları, rastgele ormanlar, gradyan artırma, destek vektör makineleri, K-en yakın komşu ve sinir ağları bulunur.
Lojistik regresyon, seçilen bir eşik kullanılarak sınıfa dönüştürülebilen bir skor ya da olasılık üretir. Bir karar ağacı yaprağı, özellik uzayının bir bölgesine dayalı bir tahmin içerir; bu mutlaka tek bir eğitim gözlemi olmak zorunda değildir. KNN, yakınlardaki etiketli eğitim örneklerinden tahmin yapar ve hâlâ sağlam bir eğitim/validasyon/test tasarımı gerektirir.
Denetimsiz öğrenme nasıl çalışır
Denetimsiz öğrenme, hedef sütunu olmadan özellikler alır. Amacı dolaylı olarak tanımlanır; örneğin, kümeler içindeki mesafeyi minimize etmek, bir girdiyi yeniden oluşturmak, veri yoğunluğunu tahmin etmek ya da daha az boyutta mümkün olduğunca fazla varyansı korumak.
Kümeleme
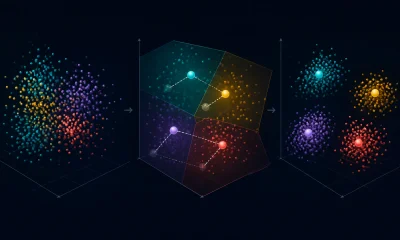
K-means, noktaları seçilen sayıdaki kümelere atar ve küme merkezlerini, küme içi kare mesafeyi azaltacak şekilde günceller. Algoritma, belirli bir mesafe ve özellik temsiline göre geometrik gruplamalar keşfeder. Bu gruplar otomatik olarak anlamlı müşteri tipleri, tanılar ya da diğer alan etiketleriyle eşleşmez.
Boyut indirgeme
Boyut indirgeme, veriyi daha az değişkenle temsil eder. Temel bileşen analizi, doğrusal bir projeksiyon altında mümkün olduğunca fazla varyansı koruyan dik yönler bulur. Diğer yöntemler farklı yapı kavramlarını korur ve çok farklı görselleştirmeler üretebilir.
Anomali ve yoğunluk tahmini
Denetimsiz yöntemler, verinin yoğun olduğu bölgeleri tahmin edebilir ve olağandışı gözlemleri işaretleyebilir. Anomali skoru, dolandırıcılık, arıza ya da kötü niyetli davranışı kanıtlamaz; seçilen temsil ve model altında bir sapmayı gösterir.
Denetimsiz öğrenme nasıl değerlendirilir
Denetimsiz “doğruluk” için evrensel bir kavram yoktur. Uygulayıcı, silüet skoru gibi iç ölçütleri kullanabilir, örnekler arasındaki istikrarı karşılaştırabilir, alt görevdeki faydasını test edebilir ya da alan uzmanlarına keşfedilen yapının anlamlı olup olmadığını sorabilir. Değerlendirme için gerçek etiketler mevcutsa, dış kümeleme ölçütleri eğitim sürecini denetimli öğrenmeye dönüştürmeden kullanılabilir.
İki yönlü karşılaştırmanın ötesinde
Yarı‑denetimli öğrenme
Yarı‑denetimli öğrenme, daha küçük bir etiketli küme ile daha büyük bir etiketlenmemiş küme birleştirir. Pseudo‑etiketleme, tutarlılık düzenlemesi ve grafik tabanlı yöntemler örneklerdir. Etiketlenmemiş veri, hedef dağılıma yeterince benzemeli ki faydalı olabilsin.
Kendi‑denetimli öğrenme
Kendi‑denetimli öğrenme, girdiden kendine hedefler türetir; örneğin maskelenmiş tokenları tahmin etmek ya da dönüştürülmüş görünümleri eşleştirmek. Bu, modern dil, görsel ve çok modlu modellerin temeli olup, transformerları da içerir.
Pekiştirmeli öğrenme
Pekiştirmeli öğrenme, etkileşimle üretilen ödüller aracılığıyla kararları optimize eder. Hem etiketli tahmin hem de statik desen keşfinden farklıdır.
Doğru yaklaşımı seçmek
İlk olarak sistemin üretmesi gereken karar ya da içgörüye odaklanın. Güvenilir hedefler mevcut ve amaç tahminse, denetimli öğrenme doğal bir seçimdir. Amaç keşif, temsil ya da gruplama ise denetimsiz bir yöntem uygun olabilir. Etiketler az olduğunda, kendi‑denetimli ya da yarı‑denetimli ön‑eğitim ardından denetimli değerlendirme daha etkili olabilir.
Her durumda, veri sızıntısı, yanlı örnekleme, zayıf vekiller ve dağılım kayması algoritma seçiminde belirleyici olabilir. Yanlış hedef üzerinde eğitilmiş teknik olarak doğru bir model bile başarısız olabilir.
Öğrenme sinyalleri, hedefler ve temsilci yöntemler
Denetimli öğrenme, hedef etiketleri ya da değerleriyle eşleştirilmiş örnekler kullanır ve tahmin hatasını minimize eder. Sınıflandırma, regresyon, sıralama ve yapılandırılmış tahmin, çıktı ve kayıp açısından farklılık gösterir. Denetimsiz öğrenme, kümeleme, yoğunluk tahmini, boyut indirgeme, temsil öğrenimi ya da üretken modelleme yoluyla hedef etiket olmadan yapı arar. Kendi‑denetimli öğrenme, veriden kendine tahmin hedefleri oluşturur; yarı‑denetimli öğrenme ise küçük bir etiketli küme ile daha büyük etiketlenmemiş veriyi birleştirir. Bu kategoriler öğrenme sinyalini tanımlar; aynı sinir ağı mimarisi birden çok paradigma altında eğitilebilir.
Etiketler, bir hedefi açıklar ancak etiketleme maliyeti, gürültü, politika varsayımları ve zaman gecikmesi getirir. Etiketlenmemiş veri toplaması daha kolaydır ancak algoritmaya keşfedilen yapının faydalı olup olmadığını söylemez. Bir küme, anlamlı bir kategori yerine aydınlatma, belge uzunluğu ya da elde etme kaynağını yansıtabilir. Değerlendirmeyi bağımsız tanımlayın: denetimli modeller tutturulmuş etiketli sonuçları kullanırken, denetimsiz modeller istikrar, yeniden yapılandırma, olasılık, geri getirme, alt görev faydası ya da uzman doğrulaması gerektirir. Görsel ayrım tek başına geçerli bir yapının kanıtı değildir.
Bir paradigma seçmek ve yaygın hataları önlemek
Kararlı bir hedef ve temsilci etiketler mevcut olduğunda denetimli öğrenme kullanın. Özetleme, yenilik tespiti, sıkıştırma ya da hipotez üretimi için denetimsiz keşfe başvurun, ancak çıktıları geçici olarak değerlendirin. Ham veri bol olduğunda ve alt görevler temsilleri paylaştığında kendi‑denetimli ön‑eğitim değerlidir. Yarı‑denetimli yöntemler, etiketlenmemiş veri ve sınıf yapısı hakkındaki varsayımlar doğru olduğunda yardımcı olur. Basit temel modellerle karşılaştırın ve toplama, etiketleme, inceleme, hesaplama ve hata maliyetlerini göz önünde bulundurun; etiketlenmemişin otomatik olarak ucuz olduğunu varsaymayın.
Etiket, artırma ya da pseudo‑etiketler türetilmeden önce ilgili varlıkları ayırarak sızıntıyı önleyin. Sınıf dengesini, etiketleme anlaşmasını, küme istikrarını, çöküşü ve kaymayı izleyin. Pseudo‑etiketler erken hataları pekiştirebilir; kümeleme hassas özellikleri kodlayabilir; önceden eğitilmiş bir temsil kaynak önyargısını aktarabilir. İnsan incelemesi sınır durumları ve sonuçlara odaklanmalıdır. Üretimde, öğrenme sinyalinin nasıl oluşturulduğunu ve ne zaman geçersiz hale geldiğini belgeleyin. Paradigma, denetimin sisteme nerede girdiğini belirler; insan seçimleri ve değerlerinin varlığını değil.
Uygulamalı örnek: destek konularını keşfetmek ve etiketlemek
Bir şirket, öncelikle anonimleştirilmiş destek mesajlarındaki temaları keşfetmek için denetimsiz gömme ve kümeleme yöntemlerini kullanır. Analistler temsilci ve sınır örneklerini inceler ve bazı kümelerin sorunlardan ziyade mesaj uzunluğu ve kanalını yansıttığını fark eder. Bilinmeyen bir sınıf, etiketleme rehberi ve ölçülmüş anlaşma içeren denetimli bir taksonomi geliştirirler. Daha sonra bir sınıflandırıcı, sonraki zaman dilimlerinde, dillerde ve ürünlerde, anahtar kelime ve en yakın komşu temel modellerine karşı değerlendirilir.
Etiketlenmemiş yeni mesajlar, kayma keşfini destekler ancak sınıflandırıcıyı otomatik olarak yeniden eğitmez. İnceleyiciler, aktif öğrenme yoluyla seçilen belirsiz ve yeni durumları etiketler; kalite kontrolleri ve kapalı bir değerlendirme seti bulunur. İzleme, konu yaygınlığını, güveni, anlaşmazlığı ve yönlendirme sonuçlarını takip eder. Yeni bir ürün piyasaya çıktığında, taksonomi ve alt ekiplerin kapasitesi birlikte güncellenir. İş akışı, hipotez üretimi için denetimsiz yöntemleri ve operasyonel yönlendirme için denetimli kanıtları kullanır.
Uygulama kanıtları ve operasyonel hazırlık
Bir üretim kararı, sadece başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, çalışma ortamını, girişleri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, yanlış kullanımı ve hizmet dışı kalma ihtimali yüksek grup ya da ortamları test edin. Görev kalitesini kalibrasyon ya da belirsizlik, gecikme, verim, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlikle birlikte ölçün. Bağımsız bir inceleyicinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşüm ve eşik kaydedilsin.
Yayın öncesinde, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve bilinçli olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve onaylanmış sonuçları, gereksiz hassas veri toplamadan ortaya koymalıdır. Uyarı eşikleri ve bir yanıt sorumlusu tanımlayın, ardından dağıtımdan sonra gerçek dünya kanıtlarını gözden geçirin; çevrim dışı performansın devam edeceğini varsaymayın. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım ya da hedefler değiştiğinde yeniden değerlendirin. Bakımı yapılan bir sistemin, belgelenmiş bir kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktası olmalıdır.
Temel referanslar