
Yapay zeka temelleri
Destek Vektör Makineleri Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
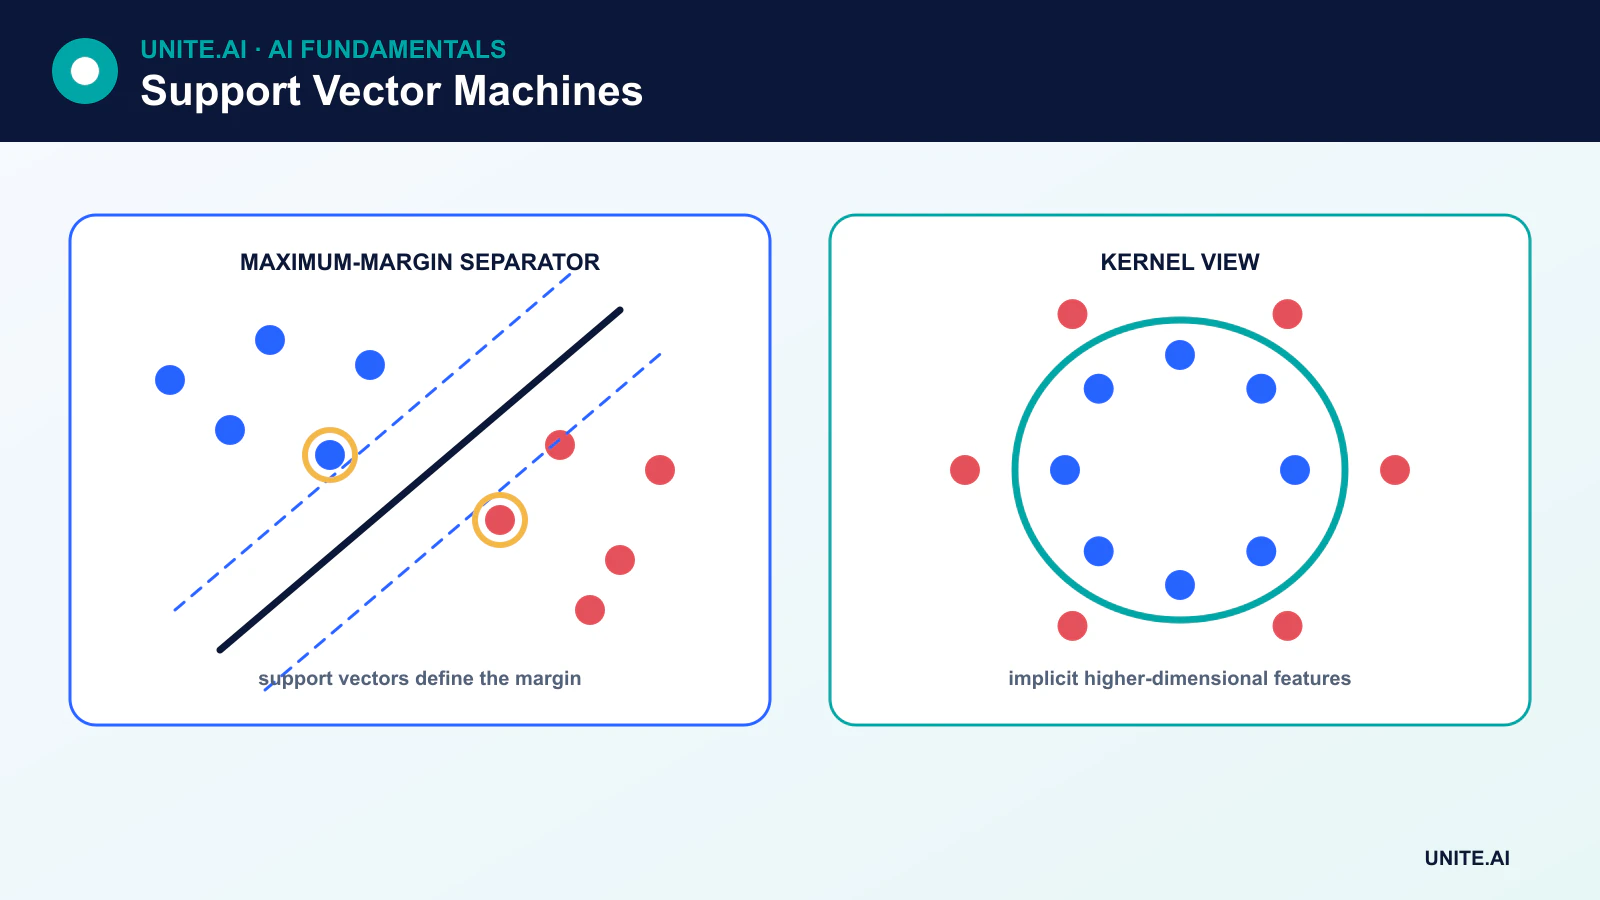
Bir destek vektör makinesi (SVM), sınıflar arasındaki mümkün olan en geniş marjı sağlayan bir karar sınırı bulan denetimli öğrenme yöntemidir. Bu sınırı belirleyen eğitim örnekleri destek vektörleridir.
SVM’ler lineer ya da doğrusal olmayan sınıflandırma, regresyon ve yenilik tespiti yapabilir. Özellikle yüksek boyutlu seyrek veriler de dahil olmak üzere bilgilendirici özelliklere sahip küçük‑orta ölçekli veri setleri için faydalıdır, ancak çok büyük veri setlerinde eğitim maliyeti pratik olmayabilir.
Temel Çıkarımlar
- Bir SVM, karar sınırı ile en yakın eğitim noktaları arasındaki minimum marjı maksimize eder.
- Destek vektörleri ek hiperplanlar değil, veri noktalarıdır.
- C parametresi, marj genişliğini ihlal cezalarına karşı dengeleyerek ayarlar.
- Kerneller, her dönüştürülmüş özelliği açıkça oluşturmak zorunda kalmadan örtük bir özellik uzayında benzerliği hesaplar.
Maksimum Marj Fikri
Doğrusal ikili sınıflandırıcı için karar sınırı bir hiperplandır:
w · x + b = 0
w vektörü yönü, b ise kaydırmayı belirler. Eğitim sınıflarını ayırabilecek birçok hiperplan vardır. SVM, her iki tarafın en yakın örneklerine olan mesafeyi maksimize eden hiperplanı seçer. Bu en yakın örnekler destek vektörleridir ve uyarlanmış sınır üzerinde en büyük etkiye sahiptir.
Amaç, sınır ile her bir noktayı bağımsız olarak arasındaki mesafeyi maksimize etmek değildir. Sınıf kısıtlamalarını karşılayarak ya da cezalandırarak minimum marjı maksimize eder.
Sert ve Yumuşak Marjlar
Sert marjlı bir SVM, mükemmel doğrusal ayrım gerektirir ve aykırı değerlere duyarlıdır. Gerçek veri setleri genellikle yumuşak marj gerektirir; bu, marjin içinde ya da sınırın yanlış tarafında bulunan gözlemler için gevşek değişkenler ekler.
Hiparparametre C, bu ihlaller için cezayı kontrol eder:
- Daha büyük bir C, ihlalleri daha güçlü cezalandırır ve genellikle eğitim örneklerini daha yakından takip eden daha dar bir marj üretir.
- Daha küçük bir C, daha geniş ve daha düzenlenmiş bir marj karşılığında daha fazla ihlale izin verir.
Destek vektörlerinin sayısı veri ve çözümün bir sonucudur; C‘yi artırmak belirli bir destek vektörü sayısını garantilemez.
Kernelleme Hilesi
Bazı sınıflar, orijinal özellik uzayında düz bir hiperplanla ayrılamaz. Bir kernel, başka bir özellik uzayına karşılık gelen bir iç çarpımı değerlendirir. Bu sayede SVM, her dönüştürülmüş koordinatı açıkça hesaplamadan doğrusal olmayan bir sınır çizebilir.
Yaygın kullanılan kerneller şunlardır:
- Linear: metin gibi yüksek boyutlu seyrek özellikler için etkilidir.
- Polynomial: seçilen bir dereceye kadar etkileşimleri modeller.
- Radial basis function (RBF): mesafeye dayalı esnek yerel sınırlar oluşturur.
- Sigmoid: sinirsel bir aktivasyona benzer ancak varsayılan seçim olarak daha az yaygındır.
RBF SVM için gamma, her bir eğitim örneğinin sınır üzerindeki yerel etkisini kontrol eder. Büyük gamma, çok ayrıntılı bölgeler oluşturabilir ve aşırı öğrenmeye yol açabilir; küçük gamma daha yumuşak bir etki üretir.
Çoklu Sınıf Sınıflandırması
Klasik SVM hedefi ikilidir. Kütüphaneler, sınıf başına bir sınıflandırıcı eğiten one-vs-rest (birine karşı tümü) gibi stratejiler veya sınıf çiftleri için sınıflandırıcılar eğiten ve kararlarını birleştiren one-vs-one (birine karşı bir) gibi stratejilerle bunu genişletir. Çoklu sınıf SVM’ler, sınıf sayısından bir eksik çizgi çizmeyle sınırlı değildir.
Destek Vektör Regresyonu ve Tek Sınıf SVM
Destek vektör regresyonu (SVR), epsilon genişliğinde bir tüp içinde hataları görmezden gelerek ve daha büyük sapmaları cezalandırarak bir fonksiyon uyarır. Tek sınıf SVM, tipik verilerin etrafında bir sınır tahmin eder ve yenilik tespiti yapabilir. Olağandışı bir nokta otomatik olarak sahtekarlık ya da hata anlamına gelmez; uyarlanmış temsilde yalnızca alışılmadık bir durumdur.
Pratik Gereksinimler
SVM’ler mesafeler ve iç çarpımlara dayanır; bu nedenle sayısal özelliklerin genellikle ölçeklendirilmesi gerekir. C, kernel, gamma ve sınıf ağırlıkları doğrulama yoluyla seçilmelidir. Olasılık tahminleri marjın doğal bir parçası değildir ve genellikle kalibrasyon gerektirir; bu ek maliyet getirir ve ayrı olarak değerlendirilmelidir.
Kernel SVM eğitimi, veri ve uygulamaya bağlı olarak örnek sayısına göre ikinci dereceden (quadratic) ila kübik (cubic) zamana kadar ölçeklenebilir. Doğrusal SVM varyantları ya da stokastik doğrusal modeller çok büyük veri setleri için daha uygundur. Ham görüntüler, ses ya da dil için derin öğrenme tarafından öğrenilen temsiller daha etkili olabilir; yine de bir SVM sabit bir gömme (embedding) sınıflandırabilir.
SVM’nin Güçlü Yönleri ve Sınırlamaları
SVM’ler çok sayıda özellikle iyi çalışabilir, net bir düzenlenmiş hedef sunar ve tahmin aşamasında esas olarak destek vektörlerine dayanır. Sınırlamalar arasında ölçeklendirme ve hiparparametrelere duyarlılık, potansiyel olarak pahalı eğitim, doğrusal olmayan kernellerde yorumlanabilirliğin azalması ve olasılık kalibrasyonu gereksinimleri bulunur.
Marjlar, Kerneller ve Optimizasyon Hedefi
Bir destek vektör makinesi, sınıflar arasındaki büyük bir marjla ayırıcı bir hiperplan arar. Sadece marjın üzerinde ya da içinde bulunan destek vektörleri sınırı belirler. Yumuşak marjlı SVM’ler, çakışma ve yanlış etiketli noktalar için gevşeklik ekler; C parametresi, daha geniş bir marjı eğitim ihlallerine karşı takas eder. Girdiler genellikle ölçeklendirilmelidir çünkü mesafe ve nokta çarpımları çözümü yönlendirir. Sınıf ağırlıkları ya da yeniden örnekleme, hata maliyetleri ve yaygınlık eşit olmadığında yardımcı olur, ancak eşikler ve olasılıklar hâlâ bağımsız doğrulama gerektirir.
Kernelleme hilesi, girdilerin daha yüksek boyutlu bir özellik uzayına haritalandığını varsayarak benzerliği değerlendirir. Doğrusal, polinomsal, radyal tabanlı ve özel kerneller farklı varsayımları kodlar. RBF kernelinde, gamma her bir noktanın sınır üzerindeki yerel etkisini kontrol eder: yüksek gamma karmaşık bölgeler oluşturabilir ve aşırı öğrenmeye yol açabilir, düşük gamma ise yetersiz öğrenmeye neden olur. Kernel matrisleri örnek sayısıyla birlikte ikinci dereceden büyür, bu da büyük veri setlerinde doğrusal olmayan SVM’leri pahalı kılar. Doğrusal çözücüler ya da yaklaşık özellik haritaları ölçekli ortamlarda genellikle tercih edilir.
Çoklu Sınıf Kullanımı, Kalibrasyon ve Operasyonel Sınırlamalar
İkili SVM’ler, one-vs-rest, one-vs-one veya yapılandırılmış formülasyonlar aracılığıyla çoklu sınıfa genişletilir. Hiparparametreler, gerektiğinde gruplanmış ya da zamansal bölünmelerle çapraz doğrulama içinde ayarlanmalıdır. Sınıfa özgü kesinlik ve geri çağırma, marj dağılımları, kalibrasyon ve kayma altındaki performans değerlendirilmelidir. Ham karar skorları olasılık değildir; Platt ölçeklendirme veya izotonik kalibrasyon ayrı veri kullanır ve yaygınlık değişirse performans düşebilir. Ön işleme ve ayarlama çabası eşit olduğunda lojistik regresyon, ağaçlar ve modern temsile dayalı yöntemlerle karşılaştırın.
Servis, tam ölçeklendirici, özellik sırası, kernel parametreleri, destek vektörleri ve sınıf eşlemesini gerektirir. Kernel SVM için tahmin maliyeti destek vektörleriyle artar; bu yüzden gerçekçi toplularda gecikme ve bellek ölçülmelidir. Eğitim desteğinden uzak girdiler hâlâ güvenilir etiket alabilir; uygun olduğunda dağıtım dışı kontrolleri veya bir çekilme politikasını ekleyin. Hataları hassas vekiller ve veri seti artefaktları açısından inceleyin. SVM’ler orta ölçekli, yüksek boyutlu problemler için hâlâ güçlüdür, ancak maksimum geometrik marj nedensel yapı ya da güvenliğin kanıtı değildir.
Uygulamalı Örnek: Nadir Belge Yönlendirmesi için bir SVM
Bir hukuk operasyonları ekibi, TF–IDF özelliklerini ve doğrusal bir SVM’yi kullanarak kısa dosyaları yönlendirme kategorilerine sınıflandırır. Şablon sızıntısını önlemek için konu ve zamana göre bölme yapar, gözden geçirilmiş hata maliyetine göre sınıf ağırlıklarını ölçeklendirir ve iç içe doğrulama içinde C’yi ayarlar. Doğrusal model, lojistik regresyon ve bir transformer ile karşılaştırılır. Sınıf başına kesinlik, geri çağırma, kalibrasyon ve denetçi iş yükü, genel doğruluktan daha önemlidir.
Karar skorları ayrı bir veri setinde kalibre edilir ve düşük marjlı ya da desteklenmeyen dildeki belgeler manuel kabul sürecine yönlendirilir. Servis artefaktı, tokenlaştırıcı, kelime hazinesi, ağırlıklandırma, model, kalibrasyon ve etiket haritasını içerir. İzleme, yeni terimleri, kategori yaygınlığını, marjları ve düzeltilen rotaları takip eder. Belgeler ve destek vektörleri korunur çünkü metin özellikleri gizli bilgileri ortaya çıkarabilir. Küçük kalite artışı gecikme, bellek ve yorumlanabilirlik maliyetini haklı çıkaramadığında doğrusal olmayan bir kernel reddedilir.
Uygulama Kanıtı ve Operasyonel Hazırlık
Bir üretim kararı, başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, çalışma ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, bozuk ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötü kullanımı ve hizmet dışı kalma ihtimali yüksek grup ya da ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, verim, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlik ile birlikte ölçün. Bağımsız bir denetçinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve onaylanmış sonuçları ortaya koymalıdır. Uyarı eşikleri ve bir yanıt sorumlusu tanımlayın, ardından çevrim dışı performansın devam edeceğini varsaymak yerine dağıtımdan sonra gerçek dünya kanıtlarını gözden geçirin. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım ya da hedefler değiştiğinde yeniden değerlendirin. Sürekli bir sistem, belgelenmiş kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir nokta da gerektirir.
Sıkça Sorulan Sorular
SVM’ler sadece sınıflandırma yapar mı?
Hayır. Destek vektör regresyonu sürekli hedefleri tahmin eder, tek sınıf SVM ise bir yenilik sınırı tahmin edebilir. Her varyant farklı bir hedefe ve hiparparametre setine sahiptir.
Doğrusal bir SVM ne zaman güçlü bir tercih olur?
Doğrusal SVM’ler, geleneksel metin temsilleri de dahil olmak üzere yüksek boyutlu seyrek özellikler için genellikle etkilidir; esnek bir kernel, net bir fayda sağlamadan maliyet ekler.
Temel Referanslar












