Yapay zeka temelleri
Ansambl Öğrenmesi Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
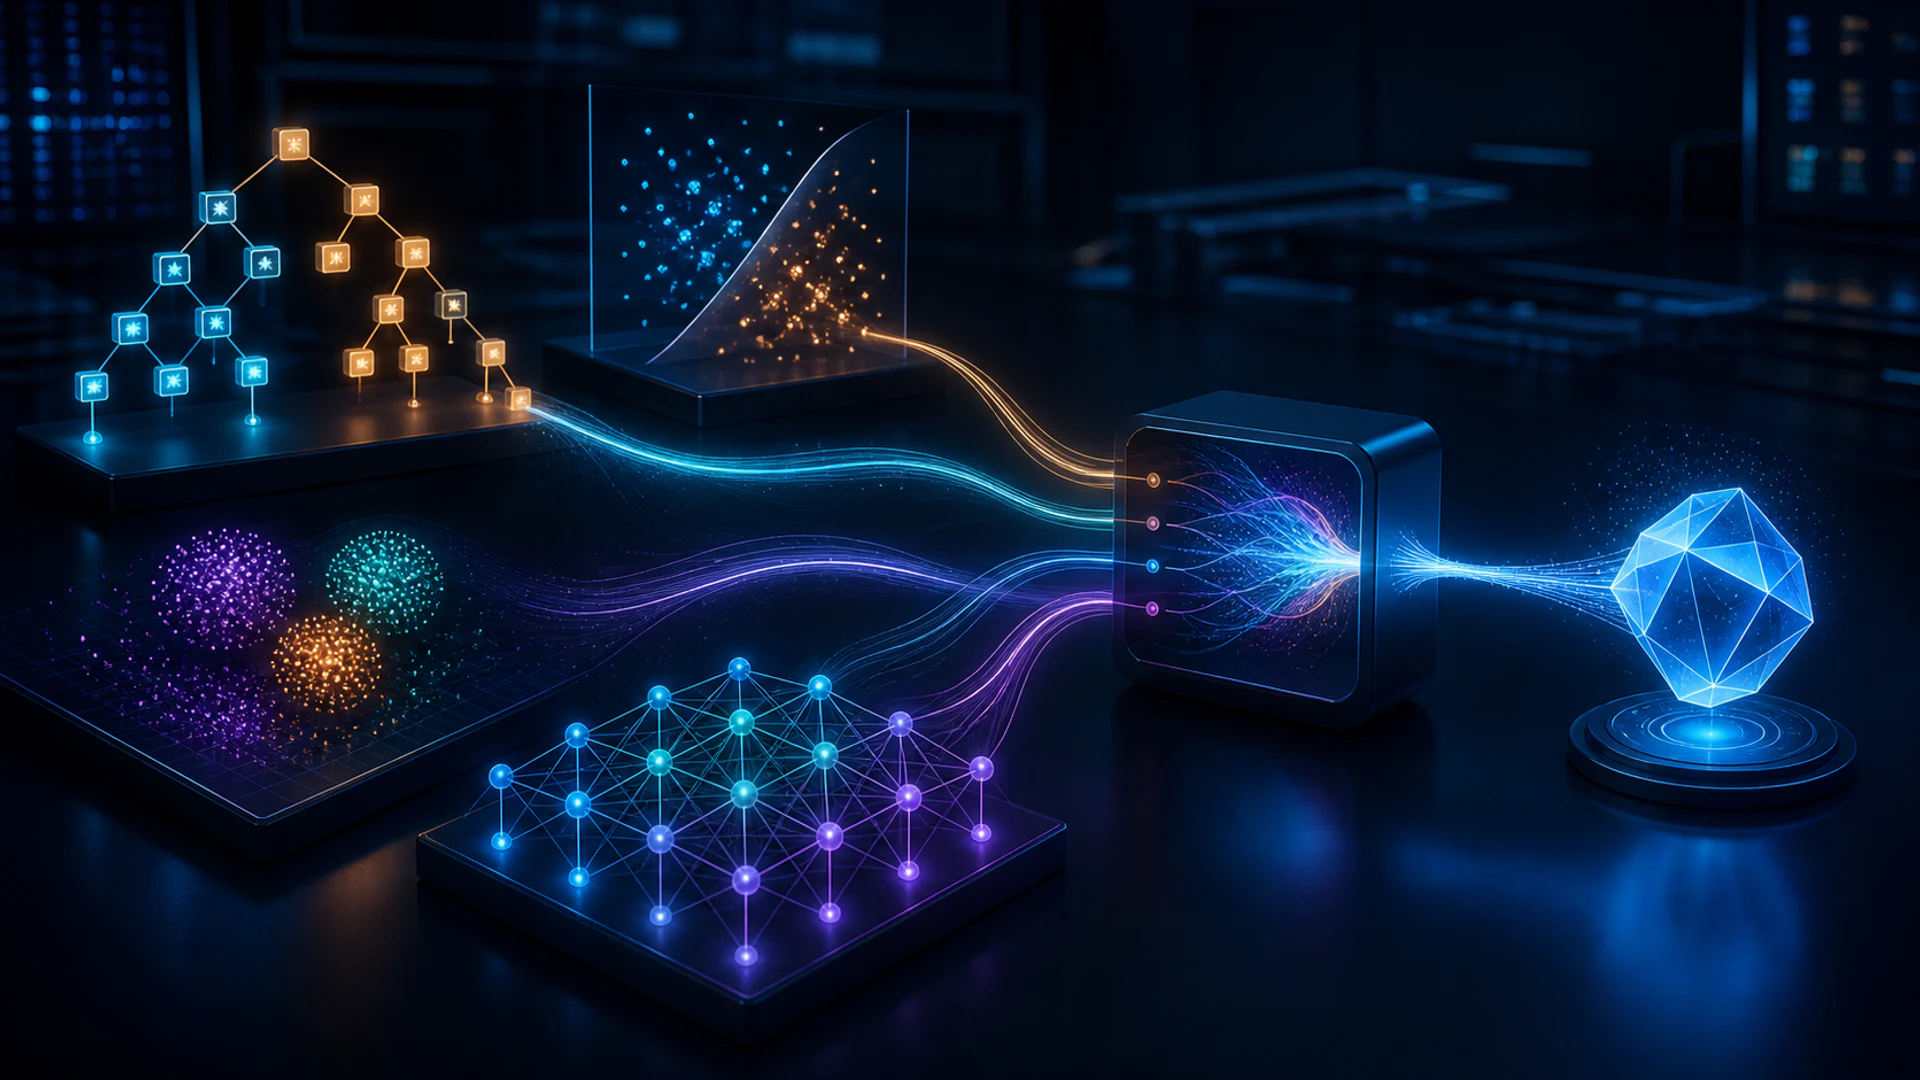
Ansambl öğrenmesi birden fazla modelin tahminlerini birleştirir. Temel fikir, farklı hatalara sahip modellerin çıktıları ortalandığında, oylandığında veya bir meta‑öğreniciye iletildiğinde daha doğru ya da daha istikrarlı bir sonuç üretebilmesidir.
Model eklemek tek başına yeterli değildir. Eğer her üye aynı kısayolu öğrenirse, hataları birbirine bağlı olur ve ansambl sadece aynı hatada daha emin hale gelebilir.
Temel Çıkarımlar
- Ansambllar, üye modeller bireysel olarak faydalı olduğunda ve anlamlı şekilde farklı hatalar yaptığında en iyi performansı gösterir.
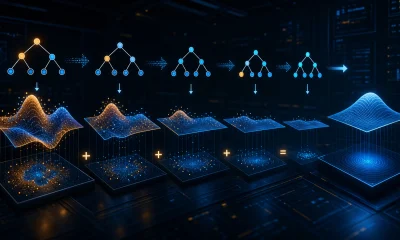
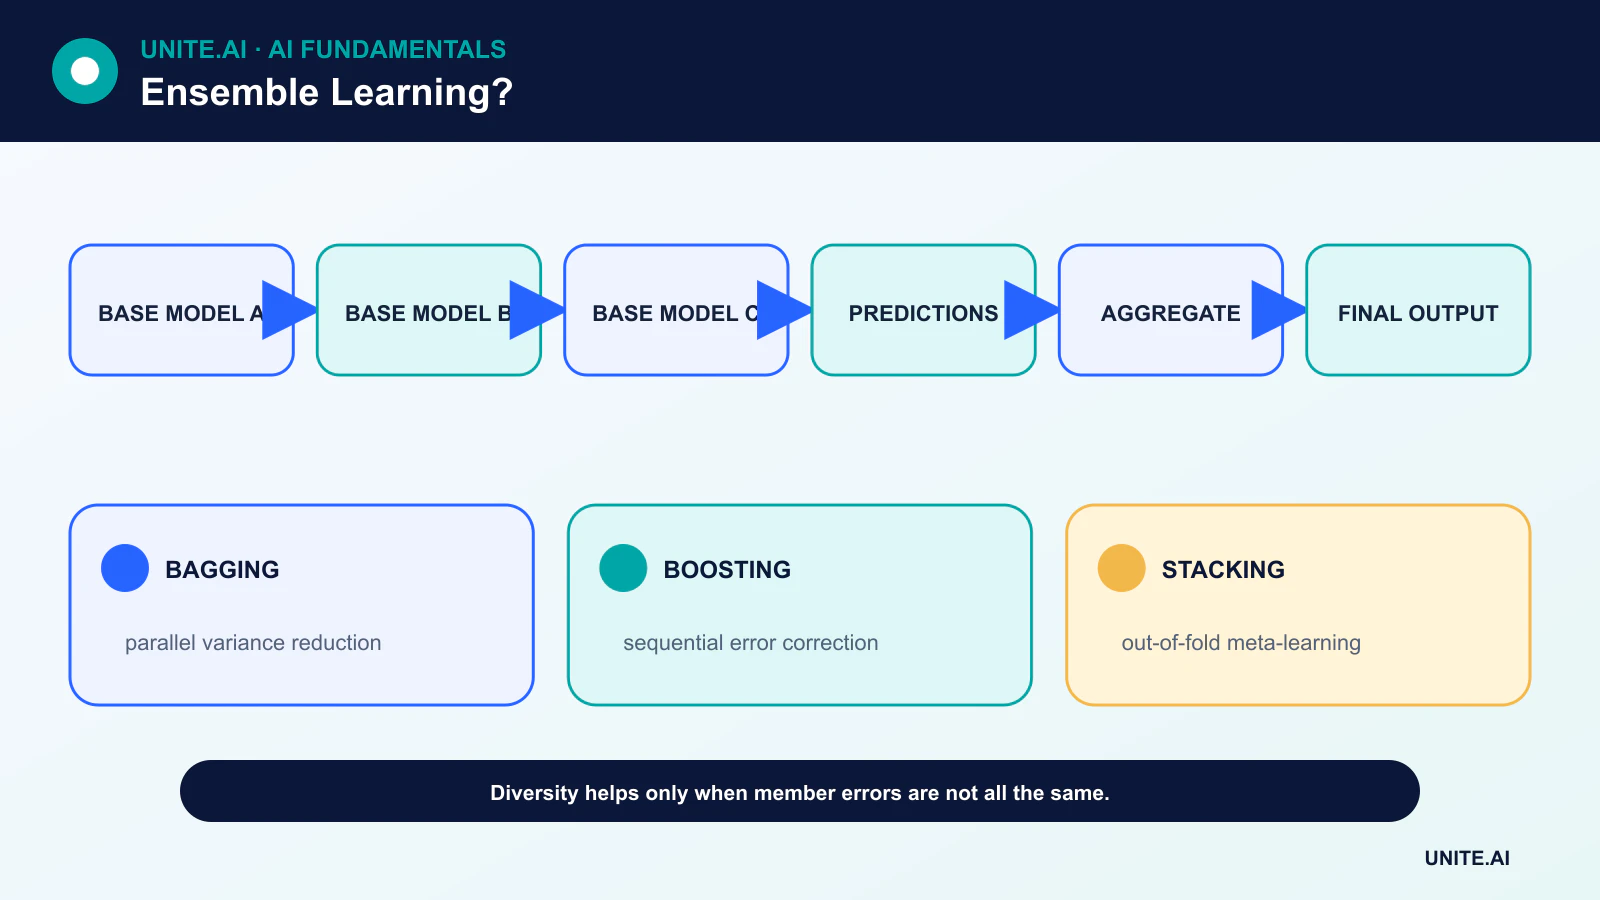
- Bagging, üyeleri paralel olarak yeniden örneklenmiş veriler üzerinde eğitir; boosting ise hataları düzeltmek için öğrenicileri ardışık olarak eğitir.
- Stacking, meta‑modeli örnek içi tahminler yerine dış katlamalı (out-of-fold) tahminler üzerinde eğitir.
- Doğruluk artışı, gecikme, kalibrasyon, yorumlanabilirlik ve bakım maliyetiyle dengelenmelidir.
Oylama ve Ortalama
Sert oylama, en çok oyu alan sınıfı seçer. Yumuşak oylama ise sınıf olasılıklarını ortalar, genellikle kalibrasyondan sonra. Regresyon ansamblları çoğunlukla sayısal tahminleri ortalar. Ağırlıklı versiyonlar daha güçlü üyelere daha fazla etki verir.
Hatalar tam olarak korele olmadığında ortalama varyansı azaltabilir. Ancak ortak bir veri kusurunu, etiket hatasını ya da eksik bir alt grubu onaramaz. Çeşitlilik, farklı model adlarından varsayılmamalı; anlaşmazlık ve hata örtüşmesiyle ölçülmelidir.
Bagging ve Rastgele Ormanlar
Bootstrap toplama (bagging), modelleri yeniden örneklenmiş veri setleri üzerinde eğitir ve bunları ortalar. Bir karar ağacı yüksek varyansa sahiptir ve bu da onu bagging için doğal bir aday yapar.
Rastgele ormanlar, dallanmalarda rastgele özellik seçimi ekleyerek ağaçlar arasındaki korelasyonu azaltır. Out-of-bag örnekleri performansı tahmin edebilir, ancak model seçimi ve dağıtım iddiaları için hâlâ dokunulmamış bir son test seti değerlidir.
Boosting
Boosting, aşamalı olarak eklemeli bir model oluşturur. Sonraki öğreniciler, mevcut ansamblün zayıf olduğu örnekler ya da artık (residual) desenlere odaklanır. AdaBoost, örnek ağırlıklarını değiştirir; gradient boosting ise seçilen kayıp fonksiyonunun negatif gradyanlarına öğrenicileri uyarlar.
Boosted ağaçlar karmaşık tablo ilişkilerini modelleyebilir, ancak derin ağaçlar, aşırı tur sayısı ve veri sızıntısı hâlâ aşırı öğrenmeye yol açabilir. Öğrenme hızı, ağaç derinliği, alt örnekleme ve erken durdurma temel kontrol noktalarıdır.
Stacking ve Blending
Stacking, temel tahminleri birleştirmeyi öğrenen ikinci seviyeli bir model oluşturur. Sızıntıyı önlemek için meta‑modelin her eğitim satırı, o satırda eğitilmemiş bir temel modelden gelmelidir. Çapraz doğrulama bu out-of-fold tahminleri üretir.
Blending, meta‑model için ayrı bir tutma (holdout) seti kullanır; bu daha basittir ancak eğitim için kullanılabilir veri miktarını azaltır. Her iki yaklaşım da çıkarım aşamasında aynı ön işleme ve sürüm kontrolünü gerektirir.
Operasyonel Tavizler
Bir ansambl, bellek, işlem gücü ve hata modlarını katlayabilir. Açıklaması, kalibrasyonu ve tutarlı güncellenmesi daha zor olabilir. Distilasyon, ansamblı daha küçük bir modele sıkıştırabilir, ancak öğrenci modelinin bağımsız olarak değerlendirilmesi gerekir.
Pratik bir seçim, performans, kuyruk gecikmesi, kalibrasyon, kaynak kullanımı ve hata maliyetini karşılaştırır. Bazen, kırılgan bir yığından elde edilen küçük doğruluk artışından çok, iyi düzenlenmiş tek bir model tercih edilir.
Ansambl Neden Çalışır
Ansambl öğrenmesi, birden fazla modeli birleştirerek hatalarının kısmen birbirini yok etmesini veya güçlü yönlerinin farklı bölgeleri kapsamasını sağlar. Bagging, modelleri yeniden örneklenmiş veriler üzerinde eğitir ve tahminleri ortalar, böylece varyansı azaltır; rastgele ormanlar, ağaçlar arasındaki korelasyonu kırmak için rastgele özellik seçimi ekler. Boosting, öğrenicileri ardışık olarak eğiterek artık hatalara odaklanır; bu genellikle yanlılığı azaltır ancak gürültüye ve ayarlamaya duyarlılığı artırır. Stacking, meta‑modeli temel model tahminleri üzerinde eğitir. Çeşitlilik faydalı olmalıdır: aynı modelleri ortalamak, hata azaltımı sağlamadan maliyet ekler.
Hatalar arasındaki korelasyon faydayı belirler. Çeşitlilik, veri örnekleri, özellikler, algoritmalar, hiperparametreler, rastgele başlatma ya da zaman pencerelerinden kaynaklanabilir. Sert oylama güveni yok sayar; yumuşak oylama olasılıkları ortalar ancak uyumlu bir kalibrasyon gerektirir. Regresyonda ortalama veya dayanıklı toplama kullanılabilir. Stacking’de, out-of-fold tahminleri şarttır—meta‑modeli aynı eğitilmiş veriden alınan temel tahminlerle eğitmek sızıntıya yol açar. Karmaşık bir birleştirici kullanmadan önce basit bir ortalama temelini koruyun.
Değerlendirme, Kalibrasyon ve Belirsizlik
Her bir üye ve ansamblı, aynı ön işleme sahip bir tutma setinde karşılaştırın. Görev ölçütlerini, kalibrasyonu, alt grup hatalarını, katlamalar ya da tohumlar arasındaki varyansı ve kaynak maliyetini raporlayın. Ansambl, ortak veri ya da etiketlerden kaynaklanan ortak kör noktayı gizlerken ortalama kaliteyi artırabilir. Anlaşmazlığı inceleyin: bu belirsizliği ortaya çıkarabilir, ancak güvenle yanlış modeller birbirleriyle uyumlu olabilir. Son ansamblı, sadece üyeleri değil, kalibre edin ve reddetme eşiklerini inceleme kapasitesi ve sonuçlarıyla doğrulayın.
Out-of-bag tahminleri bagged modeller için faydalıdır ancak son dağıtım temsili bir testi yerine geçmez. Zaman serisi verilerinde sıralamayı bozan yeniden örneklemeden kaçının. Güvenlik odaklı kullanımda, üye arızalarını, eski modelleri ve adversarial girdileri test edin. Ağırlıklı ansambllar, çok sayıda aday denendiğinde doğrulama verisine aşırı uyum sağlayabilir. Aday seçimlerini kaydedin ve ayarlamanın yoğun olduğu durumlarda iç içe doğrulama kullanın.
Sunum ve Bakım
Ansambllar bellek, gecikme, enerji ve operasyonel bağımlılıkları katlar. Distilasyon, birleşik davranışı tek bir modele sıkıştırabilir; bu da yeni bir doğrulama gerektirir. Üyeleri, ön işleme, ağırlıkları ve yönlendirmeyi tek bir varlık olarak sürümleyin; bir üye zaman aşımına uğradığında ya da geçersiz sonuç ürettiğinde davranışı tanımlayın. Üye tahminlerini ve anlaşmazlığı izleyerek sessiz hataların görünür olmasını sağlayın. Gereksiz üyeleri emekliye ayırın ve kasıtlı olarak yeniden eğitin. Ansambllar, hata çeşitliliği gerçek olduğunda tahmini iyileştirir, ancak önyargılı eğitim verisini ya da geçersiz bir hedefi güvenilir kanıta dönüştürmez.
Uygulamalı Örnek: Şiddetli Hava Uyarıları İçin Bir Ansambl
Bir tahmin ekibi, fiziksel model özellik seti, gradient‑boosted ağaç, sinirsel dizi modeli ve kalibre edilmiş istatistiksel temel modeli birleştirir. Out-of-fold tahminler basit bir meta‑modeli eğitir ve değerlendirme, üye eğitiminden tamamen dışarıda tutulan gelecekteki fırtınaları kullanır. Ölçütler arasında olay hatırlama, yanlış alarmlar, uyarı süresi, kalibrasyon, coğrafi performans ve nadir aşırı koşullardaki güvenilirlik bulunur. Üye hata korelasyonu incelenir çünkü ortak giriş verisi ortak kör noktalar yaratabilir.
Sunum, her tahmini ve birleşik sonucu saklar. Bir üye kullanılamazsa, sistem sessizce yeniden ölçeklendirmek yerine önceden doğrulanmış bir bozulmuş yapılandırma kullanır. Anlaşmazlık ek inceleme gerektirir ancak her durumda belirsizlik olarak değerlendirilmez. İzleme, üye kaymasını, gecikmeyi ve fırtına sonuçlarını takip eder; ağırlıklar yalnızca kontrollü doğrulama yoluyla güncellenir. Kamu uyarıları yetkili meteorolojik karar süreçleri altında kalır; ansambl kanıtı artırır ancak uyarı politikasını kendi kendine yeniden tanımlamaz.
Uygulama Kanıtları ve Operasyonel Hazırlık
Üretim kararı, başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, çalışma ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötü kullanımı ve hizmet dışı kalma ihtimali yüksek grup ya da ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, işlem hacmi, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlik ile birlikte ölçün. Bağımsız bir inceleyicinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlatmadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve doğrulanmış sonuçları ortaya koymalıdır. Uyarı eşiklerini ve bir yanıt sorumlusunu tanımlayın, ardından dağıtımdan sonra gerçek dünya kanıtlarını gözden geçirin; çevrim dışı performansın devam edeceğini varsaymayın. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım ya da hedefler değiştiğinde yeniden değerlendirin. Bakımı yapılan bir sistem, belgelenmiş kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
Rastgele Orman bir ansambl midir?
Evet. Genellikle oylama ya da ortalama yoluyla birçok rastgele karar ağacını birleştirir.
Aynı modeller faydalı bir ansambl oluşturabilir mi?
Eğitim verileri, başlatma ya da örnekleme yeterince farklı hatalar üretirse oluşturabilirler, ancak sadece kopyalamak hiçbir fayda sağlamaz.
Temel Referanslar