
Yapay zeka temelleri
KNN (K-En Yakın Komşular) Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
K-en yakın komşular (KNN) bir sorgu noktasına en yakın etiketli eğitim örneklerinden bir sonuç tahmin eder. Sınıflandırma için komşular sınıfa oy verir. Regresyon için ise hedef değerleri ortalanır veya başka bir şekilde birleştirilir.
KNN, örnek‑tabanlı, genelleştirmeyen bir yöntem: modelleme çoğunlukla eğitim örneklerini ve isteğe bağlı bir arama indeksini depolar. Bu, eğitim, doğrulama ve test bölümlerine olan ihtiyacı ortadan kaldırmaz. Ayrı tutulan veriler üzerinde değerlendirme, k, mesafe ölçütü, özellik işleme ve oy kuralını seçmek için gereklidir.
Temel Çıkarımlar
- KNN yerel olarak tahmin yapar; veri kümesini önceden kümelere bölmez.
- Özellik ölçeklendirme kritiktir çünkü mesafe, hangi örneklerin komşu sayılacağını belirler.
- Küçük k gürültülü olabilir, büyük k ise yerel yapıyı düzleştirebilir.
- Yüksek boyutlar, alakasız özellikler, sınıf dengesizliği ve yavaş arama performansı sınırlayabilir.
KNN sınıflandırması nasıl çalışır
- Sorgu ve eğitim örneklerini aynı özellik uzayında temsil edin.
- Sorgudan eğitim örneklerine olan mesafeyi hesaplayın.
- En yakın k örneği seçin.
- Çoğunluk sınıfını tahmin edin veya mesafe‑ağırlıklı oylamayı kullanın.
Ağırlıklı oylama, daha yakın komşulara daha fazla etki verir. Eşitlik durumunda belgelenmiş bir kural gerekir ve farklı etiketlere sahip eşit mesafeli komşular, sonuçların sıralamaya veya uygulama detaylarına bağlı olmasına yol açabilir.
KNN regresyonu
Regresyonda tahmin genellikle komşu hedeflerin ortalamasıdır. Mesafe ağırlığı, daha uzak gözlemlerin etkisini azaltabilir. Yerel hedeflerde aykırı değerler bulunduğunda medyan veya sağlam bir toplama yöntemi faydalı olabilir.
Mesafe ölçütleri
Özellikleri sürekli olduğunda yaygın olarak Öklidyen mesafe kullanılır, Manhattan mesafesi mutlak farkların toplamını verir ve kosinüs mesafesi büyüklük yerine yönü ön plana alır. Diğer ölçütler ikili, kategorik, coğrafi, dizi ya da öğrenilmiş gömme veriler için uygulanabilir.
KNN’yi “parametrik olmayan” olarak adlandırmak, karar sınırı için sabit ve sonlu boyutlu bir fonksiyonel form varsaymadığı anlamına gelir. Yine de seçilen temsil ve ölçütün, yakın noktaları birbirine ilgili kıldığı varsayılır.
Ölçeklendirmenin önemi
Bir özellik 0‑1 aralığında, diğeri 0‑100.000 aralığında ise, geleneksel Öklidyen mesafe ikinci özellik tarafından domine edilir. Standartlaştırma, normalleştirme veya alana özgü dönüşümler eğitim bölümü üzerinde öğrenilmeli ve doğrulama, test ve üretim verilerine uygulanmalıdır.
Alakasız özellikler de komşulukları bozar. Özellik seçimi, boyut indirgeme veya öğrenilmiş temsiller yardımcı olabilir, ancak her seçim veri sızıntısı olmadan doğrulanmalıdır.
k seçimi
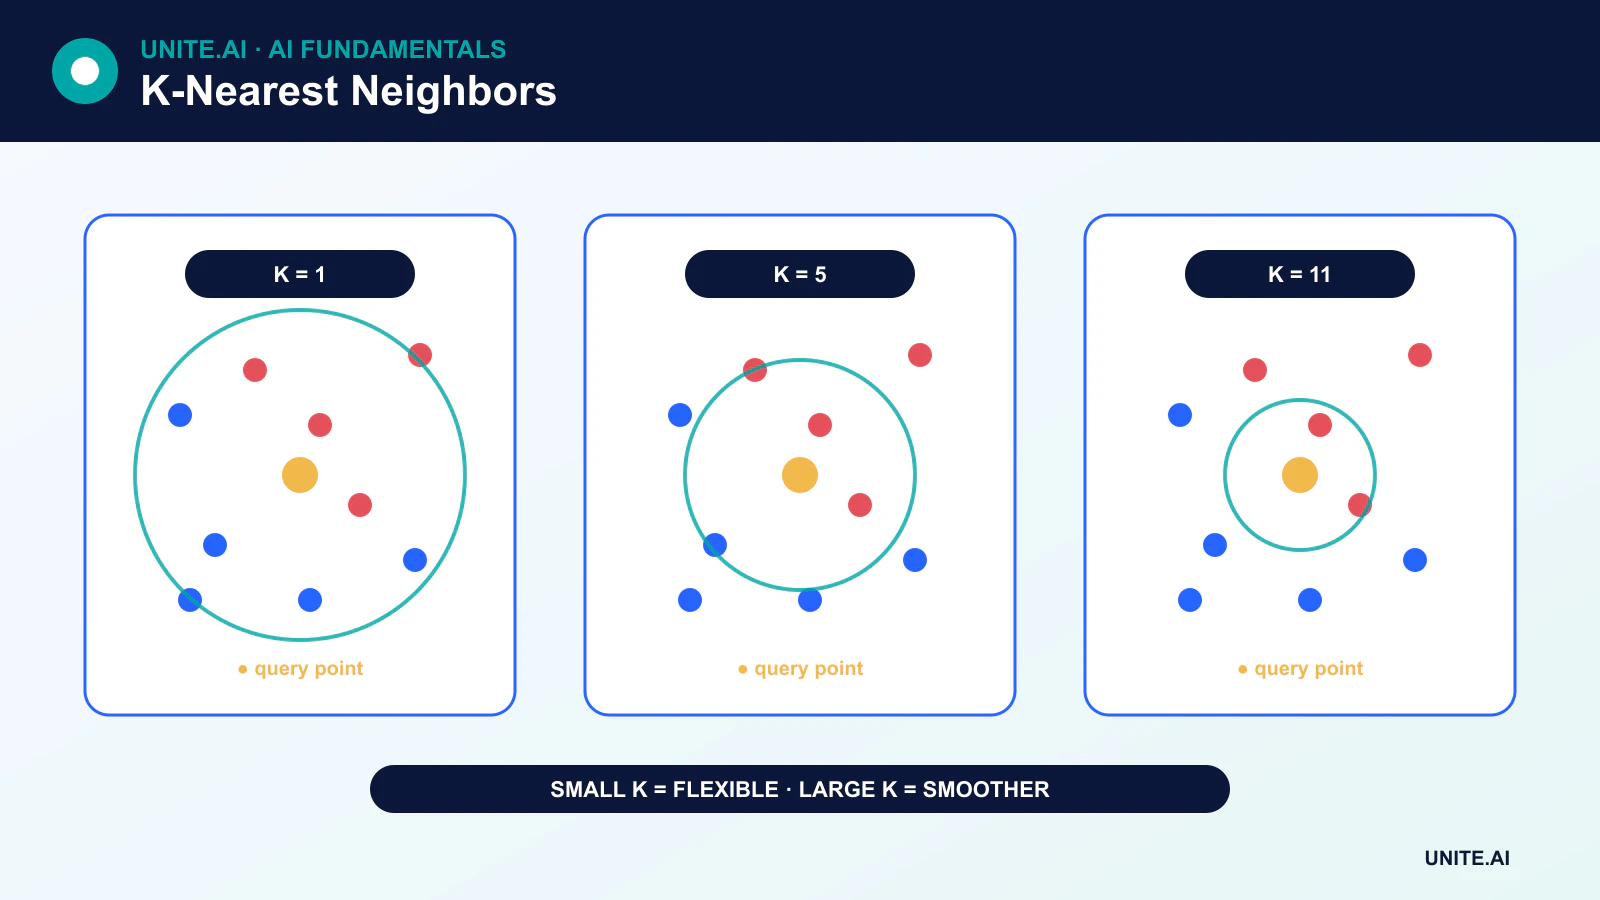
k = 1 olduğunda model gürültüye ve hatalı etiketli örneklere uyum sağlayabilir. k arttıkça tahminler daha yumuşak ve tek bir noktaya karşı daha az duyarlı olur. k çok büyük olursa, uzak sınıflar veya bölgeler baskın hâle gelir ve model yetersiz öğrenir.
k değerini eğitim verileri üzerinde çapraz doğrulama ile seçin. İkili sınıflandırmada tek sayıdaki k eşitlikleri azaltır ancak tamamen ortadan kaldırmaz. Sınıf ağırlıkları, katmanlı bölünmeler, eşik seçimi ve uygun ölçütler sınıflar dengesiz olduğunda önem taşır.
Boyutsallık laneti
Yüksek boyutlu uzaylarda, örnekler seyrek olduğu ve en yakın ile en uzak mesafeler birbirine yakınlaştığı için mesafeler daha az bilgi verici olur. KNN, anlamlı yerel komşulukları korumak için muazzam miktarda veri gerektirebilir. Bu, boyutsallık laneti olarak adlandırılır.
Boyut indirgeme veya görev‑özel gömmeler yardımcı olabilir, ancak gömme geometrisi hedeflenen benzerlik kavramı için doğrulanmalıdır.
Arama performansı
Kaba kuvvet sorgusu, yeni noktayı depolanan tüm örneklerle karşılaştırır. KD ağaçları ve top ağaçları bazı kesin aramaları hızlandırır, ancak yüksek boyutlarda faydaları azalır. Yaklaşık en yakın komşu indeksleri, çok az bir geri çağırma kaybı karşılığında büyük hız ve bellek kazançları sağlar. Bu fikir aynı zamanda vektör benzerlik aramasının temelini oluşturur.
Güçlü yönler ve sınırlamalar
KNN basittir, düzensiz karar sınırlarını destekler ve sezgisel bir örnek‑tabanlı açıklama sunar. Aynı zamanda büyük bellek gerektirebilir, hassas eğitim örneklerini ortaya çıkarabilir, yavaş tahmin yapar ve mesafe anlamlı olmadığında kötü performans sergileyebilir. Çoğu problemde varsayılan olarak yüksek doğruluk sağlamaz; faydalı bir temel çizgidir.
Mesafe, komşuluklar ve hiperparametre davranışı
K-en yakın komşular, eğitim örneklerini depolar ve seçilen bir mesafe altında en yakın k örnekten tahmin yapar. Sınıflandırma çoğunluk ya da mesafe‑ağırlıklı oylama kullanır; regresyon komşu hedeflerin ortalamasını alır. Ölçeklendirme, yüksek aralıklı bir özelliğin Öklidyen mesafeyi domine etmemesi için esastır. Kategorik, seyrek, dizi ya da coğrafi veriler Hamming, kosinüs, düzenleme, büyük‑çember ya da öğrenilmiş mesafeler gerektirebilir. Ölçüt, benzerlik hakkında bir modelleme varsayımıdır ve yakın vakaların gerçek anlamına göre doğrulanmalıdır.
Küçük k, esnek, yüksek varyanslı sınırlar ve gürültüye duyarlılık yaratır; büyük k tahminleri yumuşatır ve azınlık yapısını silebilir. Tek sayıdaki k sadece bazı ikili eşitlikleri önler ve genel bir kural değildir. k, mesafe, ağırlıklandırma, özellik kümesi ve ön işleme adımlarını çapraz doğrulama içinde seçin. Sınıf dengesizliği, yerel çoğunluk oylamasının nadir sonuçları göz ardı etmesine yol açabilir; bu yüzden sınıf bazlı geri çağırma ve komşuluk bileşimini inceleyin. Yüksek boyutlu mesafeler yoğunlaşma eğilimindedir ve alakasız özellikler komşulukları bozar; seçim, boyut indirgeme veya öğrenilmiş gömmeler yardımcı olabilir.
İndeksleme, belirsizlik ve üretim operasyonu
Naif çıkarım, bir sorguyu tüm eğitim noktalarıyla karşılaştırır. KD ağaçları ve top ağaçları uygun düşük boyutlarda yardımcı olur; yaklaşık en yakın komşu indeksleri kesinliği hız ve ölçek için ödün verir. Komşu aramanın geri çağırma oranını tahmin kalitesinden ayrı ölçün. Bellek, depolanan özellikler, etiketler ve indeks yapıları içerir. Güncellemeler kavramsal olarak basittir ancak indeks yeniden oluşturma, sürüm tutarlılığı ve silme yayılımı gerektirebilir. Komşuları veya mesafeleri döndürmek kayıtları ifşa edebileceği için hassas eğitim örneklerini koruyun.
KNN, tahmini anlaşılır kılan örnekleri ortaya çıkarabilir, ancak yakınlık nedensellik ya da adalet anlamına gelmez. Komşuluklar seyrek veya çelişkili olduğunda mesafe, oy farkı ve bir çekilme kuralı sağlayın. Sorgu mesafesini, komşu etiketleri, özellik kaymasını, gecikmeyi ve doğrulanmış sonuçları izleyin. Ön işleme ve indeks sürümlerini senkronize tutun ve değişikliklerden sonra kesin ve yaklaşık sonuçları test edin. Mesafe anlamlı olduğunda KNN etkili bir yerel temel ve geri getirme yöntemidir; benzerlik mevcut özelliklerle temsil edilemediğinde zorlanır.
Uygulamalı örnek: Ürün ikamesi için KNN
Bir perakendeci, ürünleri standart sayısal özellikler, kategorik uyumluluk ve öğrenilmiş metin gömme ile temsil eder, ardından merchandiser’lar tarafından incelenen ağırlıklı bir mesafe tanımlar. K ve ağırlıklar, rastgele ürün satırları yerine sonraki ürün lansmanlarıyla seçilir. Değerlendirme, ilgili ikame geri çağırma, uyumsuz öneriler, mesafe, kategori kapsama ve nadir ürünler için sonuçları kontrol eder. Popülerlik temeli, yerel benzerliğin değer katıp katmadığını gösterir.
Yaklaşık bir indeks, geri çağırma ve gecikme açısından kesin komşulara karşı benchmark yapılır. Yakın uyumlu bir öğe bulunmadığında sorgular öneri döndürmez, zorunlu bir komşu yerine. Ürün silmeleri ve özellik düzeltmeleri, sürümlü güncellemelerle indekse yayılır. İzleme, mesafe dağılımları, boş sonuçlar, geçersiz kılmalar ve ticari sonuçları satışları gerçek uyumlulukla karıştırmadan takip eder. Hassas tedarikçi koşulları açıklamalardan çıkarılır ve döndürülen örnekler benzerliğin kanıtı olarak kalır; ürünlerin eşdeğer olduğu iddiası değildir.
Uygulama kanıtları ve operasyonel hazırlık
Bir üretim kararı, başarılı bir gösterinin ötesine ihtiyaç duyar. Hedef kullanıcıları, çalışma ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce tekrarlanabilir bir temel çizgi ve sürümlü bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötü kullanımı ve hizmet dışı kalma ihtimali yüksek grup ya da ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, işlem hacmi, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlik ile birlikte ölçün. Bağımsız bir denetçinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik yetkisini atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıktı davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve doğrulanmış sonuçları ortaya koymalıdır. Uyarı eşiklerini ve bir yanıt sorumlusunu tanımlayın, ardından çevrim dışı performansın devam edeceğini varsaymak yerine dağıtımdan sonra gerçek dünya kanıtlarını inceleyin. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım veya hedefler değiştiğinde yeniden değerlendirin. Bakımı yapılan bir sistem, belgelenmiş bir kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
KNN bir eğitim aşamasına sahip mi?
Az miktarda parametre ayarı vardır, ancak yine de bir geliştirme süreci bulunur: ön işleme eğitim verilerinden öğrenilir, bir indeks oluşturulabilir ve k, ölçüt, ağırlıklar ve özellikler doğrulama ile seçilir.
KNN, K-means ile aynı mı?
Hayır. KNN öncelikle denetimli bir yerel tahmin yöntemidir. K-means, K değerinin küme merkez sayısı olduğu denetimsiz bir kümeleme algoritmasıdır.
Temel referanslar












