
Grunderna i AI
Vad är bild- och språkmodeller (VLM)? Så kopplar AI samman bilder och ord
Syn- och språkmodeller kopplar visuella egenskaper till språk så att ett system kan beskriva, jämföra, hämta information om eller resonera kring bilder med hjälp av ord. Den här guiden förklarar mekanismen, avvägningarna, utvärderingen och kontrollerna som är viktiga i praktiken.

 Lägg till Unite.AI bland dina föredragna källor på Google
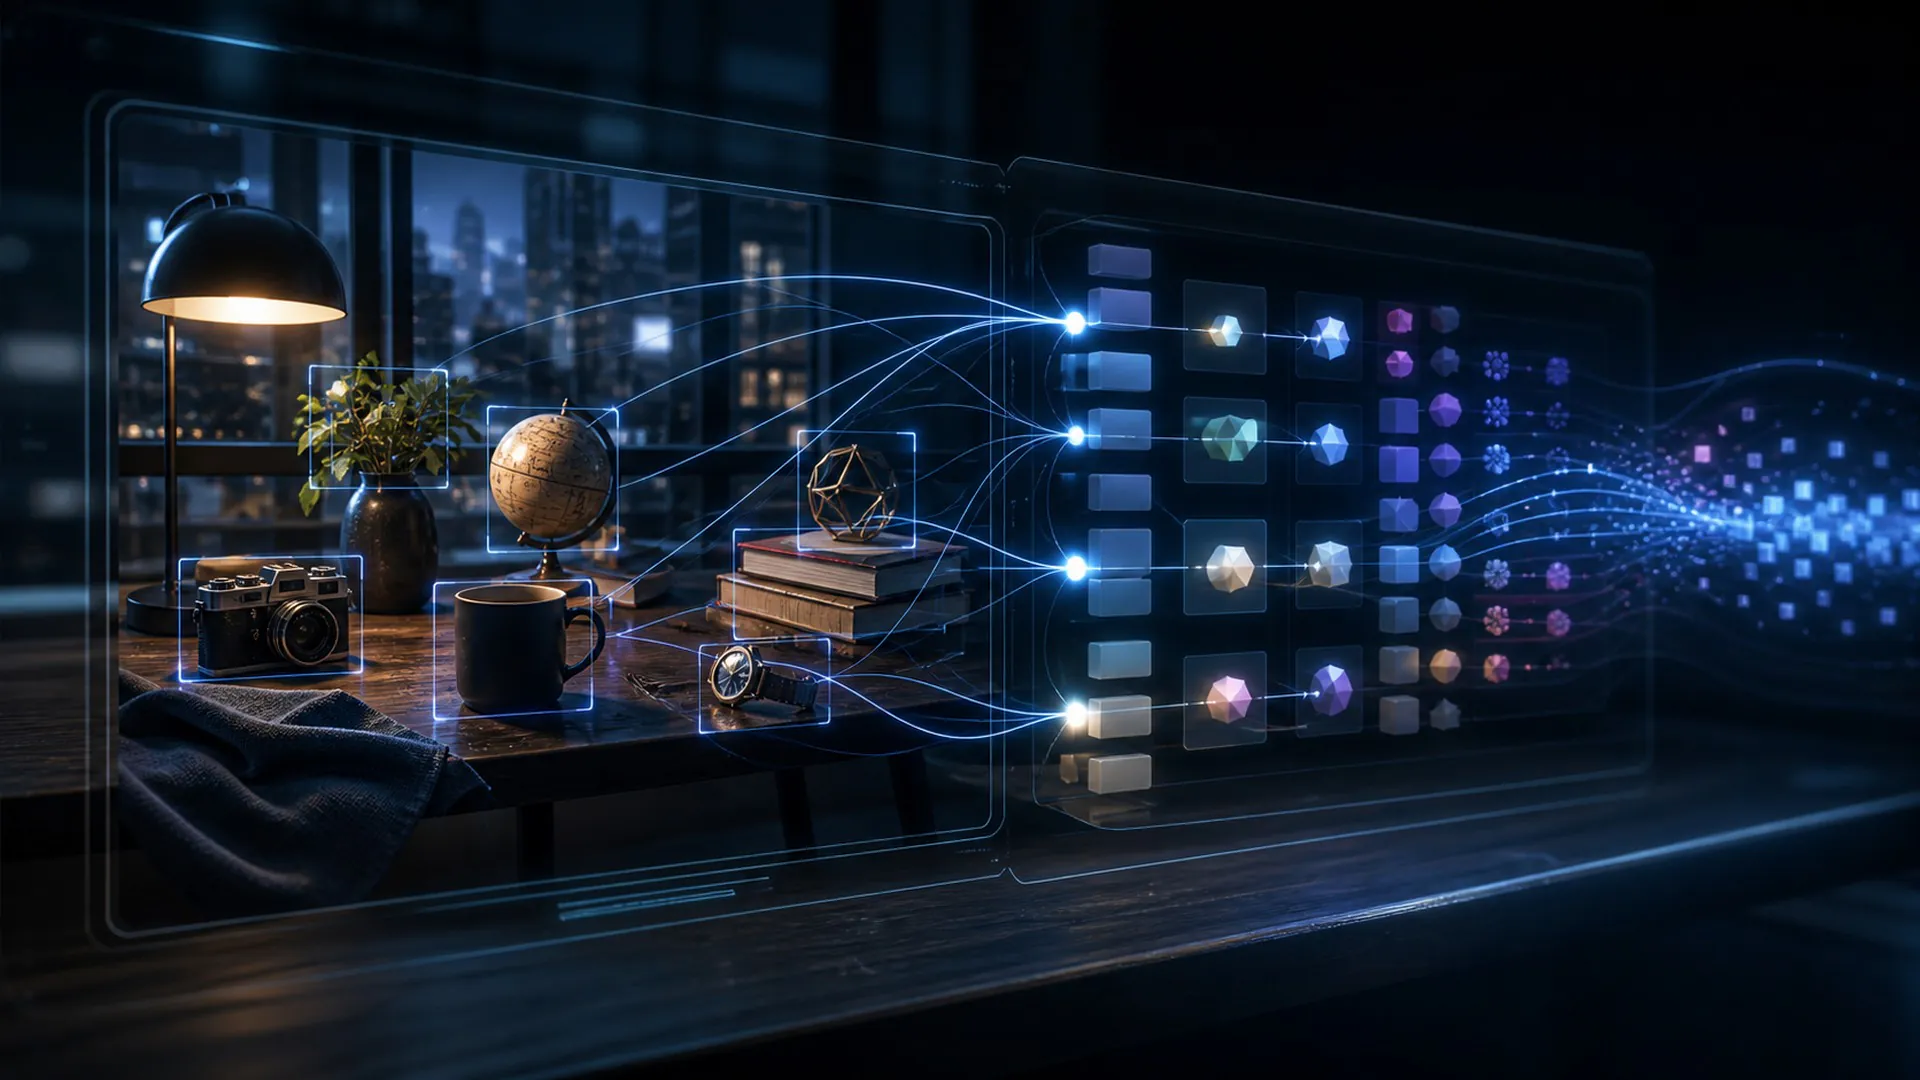
Bild- och språkmodeller kopplar samman visuella egenskaper med språk, så att ett system kan beskriva, jämföra och hämta bilder eller resonera om dem med hjälp av ord.
Begreppet bild- och språkmodeller förtjänar en precis förklaring, eftersom namnet syftar på ett visst informationsflöde, ett visst val av träningsmetod, en mekanism som används vid körning eller en gräns för styrning och kontroll. Om man behandlar det som en synonym till ”avancerad AI” blir påståenden omöjliga att pröva. Den här guiden följer begreppet från dess indata och antaganden till det observerbara resultatet och prövar sedan den närliggande företeelse som lättast förväxlas med det.
Bild- och språkmodeller: definition, avgränsning och syfte
Bild- och språkmodeller kopplar samman visuella egenskaper med språk, så att ett system kan beskriva, jämföra och hämta bilder eller resonera om dem med hjälp av ord. Definitionen innefattar tre praktiska åtaganden: det finns en identifierbar indata, en omvandling eller ett beslut som kännetecknar bild- och språkmodeller, och ett resultat som kan utvärderas mot ett angivet mål. Om någon av dessa delar saknas kan beteckningen beskriva en ambition snarare än en mekanism som faktiskt har införts.
Multimodala system måste samordna signaler med olika upplösning, tidsförlopp, brus och tvetydighet. Ett ord kan syfta på ett litet område i en bild, och en ljudhändelse kan inträffa före den videobildruta som förklarar den. För bild- och språkmodeller är det viktigt att se till hela systemet, eftersom prestandan kan avgöras av omgivande data, gränssnitt, maskinvara, behörigheter och människor, även när själva modellen är oförändrad. En användbar förklaring skiljer därför modellens inlärda beteende från produkten som avgör när, var och med vilka befogenheter beteendet används.
Den närmaste missvisande förenklingen är datorseende som förutsäger en fast etikett utan öppet språk. Det kan ha en synlig egenskap gemensam med bild- och språkmodeller, men den kausala förklaringen blir en annan: andra belägg skulle visa att systemet lyckas, andra resurser skulle stå för den största kostnaden och andra kontroller skulle behövas för att förebygga skada. Gränsen är därför operativ, inte terminologisk.
En arbetsmodell för bild- och språkmodeller i fem steg
Diagrammet är en kompakt kausal modell för bild- och språkmodeller, inte ett påstående om att varje implementation använder fem programvarukomponenter. Vissa system kombinerar steg, medan andra upprepar dem i en loop. Modellen är ändå användbar eftersom den kräver att varje förändring av information eller befogenheter har en ansvarig aktör, en indata, en utdata och ett test.
1. Dela upp eller koda bilden till visuella token: indata och antaganden i bild- och språkmodeller
I det här steget i bild- och språkmodeller måste systemet dela upp eller koda bilden till visuella token. Den viktiga frågan är inte bara om operationen utförs, utan också vilken information den använder, vilket tillstånd den förändrar och vilka belägg som visar att förändringen var giltig. En granskare ska kunna skilja operationen från datorseende som förutsäger en fast etikett utan öppet språk och återskapa resultatet under samma angivna förhållanden.
Överlämningen till det här steget i bild- och språkmodeller börjar med det angivna målet och bör avslutas med ett resultat som kan ligga till grund för kodning av den tillhörande texten. Dokumentera osäkerhet, alternativ som har avvisats, resursanvändning och eventuella mänskliga eller programvarubaserade kontroller vid gränsen. Med hjälp av den spårbarheten kan team upptäcka om flytande beskrivningar kan nämna objekt eller relationer som faktiskt inte syns, innan samma svaghet påverkar ett resultat med betydande konsekvenser.
2. Koda den tillhörande texten: representation eller beslut i bild- och språkmodeller
I det här steget i bild- och språkmodeller måste systemet koda den tillhörande texten. Den viktiga frågan är inte bara om operationen utförs, utan också vilken information den använder, vilket tillstånd den förändrar och vilka belägg som visar att förändringen var giltig. En granskare ska kunna skilja operationen från datorseende som förutsäger en fast etikett utan öppet språk och återskapa resultatet under samma angivna förhållanden.
Överlämningen till detta steg i visionsspråkmodeller börjar med att dela upp eller koda bilden till visuella token och bör avslutas med ett resultat som kan bidra till att sammanföra båda representationerna. Dokumentera osäkerhet, alternativ som förkastats, resursanvändning och eventuell mänsklig eller programvarubaserad kontroll vid överlämningen. Den spårbarheten gör det möjligt för team att upptäcka om flytande beskrivningar kan ange objekt eller relationer som faktiskt inte syns, innan samma svaghet påverkar ett resultat med betydande konsekvenser.
3. Sammanför båda representationerna: den särskiljande omvandlingen i visionsspråkmodeller
I det här steget i visionsspråkmodeller måste systemet sammanföra båda representationerna. Den relevanta frågan är inte bara om operationen utförs, utan vilken information den använder, vilket tillstånd den ändrar och vilka belägg som visar att ändringen var giltig. En granskare bör kunna skilja operationen från datorseende som förutsäger en fast etikett utan öppet språk och återskapa resultatet under samma angivna förhållanden.
Överlämningen till detta steg i visionsspråkmodeller börjar med att koda den tillhörande texten och bör avslutas med ett resultat som kan bidra till att rikta uppmärksamheten mot olika regioner och fraser. Dokumentera osäkerhet, alternativ som förkastats, resursanvändning och eventuell mänsklig eller programvarubaserad kontroll vid överlämningen. Den spårbarheten gör det möjligt för team att upptäcka om flytande beskrivningar kan ange objekt eller relationer som faktiskt inte syns, innan samma svaghet påverkar ett resultat med betydande konsekvenser.
4. Rikta uppmärksamheten mot olika regioner och fraser: begränsnings- och verifieringsgränsen i visionsspråkmodeller
I det här steget i visionsspråkmodeller måste systemet rikta uppmärksamheten mot olika regioner och fraser. Den relevanta frågan är inte bara om operationen utförs, utan vilken information den använder, vilket tillstånd den ändrar och vilka belägg som visar att ändringen var giltig. En granskare bör kunna skilja operationen från datorseende som förutsäger en fast etikett utan öppet språk och återskapa resultatet under samma angivna förhållanden.
Överlämningen till detta steg i visionsspråkmodeller börjar med att sammanföra båda representationerna och bör avslutas med ett resultat som kan bidra till att avkoda ett svar eller en handling som är förankrad i underlaget. Dokumentera osäkerhet, alternativ som förkastats, resursanvändning och eventuell mänsklig eller programvarubaserad kontroll vid överlämningen. Den spårbarheten gör det möjligt för team att upptäcka om flytande beskrivningar kan ange objekt eller relationer som faktiskt inte syns, innan samma svaghet påverkar ett resultat med betydande konsekvenser.
5. Avkoda ett svar eller en handling som är förankrad i underlaget: utdata, återkoppling och stoppregel i visionsspråkmodeller
I det här steget i visionsspråkmodeller måste systemet avkoda ett svar eller en handling som är förankrad i underlaget. Den relevanta frågan är inte bara om operationen utförs, utan vilken information den använder, vilket tillstånd den ändrar och vilka belägg som visar att ändringen var giltig. En granskare bör kunna skilja operationen från datorseende som förutsäger en fast etikett utan öppet språk och återskapa resultatet under samma angivna förhållanden.
Överlämningen till detta steg i visionsspråkmodeller börjar med att rikta uppmärksamheten mot olika regioner och fraser och bör avslutas med ett resultat som kan bidra till övervakning eller ett slutligt beslut. Dokumentera osäkerhet, alternativ som förkastats, resursanvändning och eventuell mänsklig eller programvarubaserad kontroll vid överlämningen. Den spårbarheten gör det möjligt för team att upptäcka om flytande beskrivningar kan ange objekt eller relationer som faktiskt inte syns, innan samma svaghet påverkar ett resultat med betydande konsekvenser.
Läs kartan över visionsspråkmodeller framåt för att förstå produktionen och bakåt för att diagnostisera fel. Framåtriktad analys undersöker hur ett steg förser nästa steg med underlag. Bakåtriktad analys utgår från ett felaktigt, långsamt, dyrt eller osäkert resultat och spårar vilken tidigare förutsättning som gjorde det möjligt. Det är ofta genom att följa den omvända vägen som ett team upptäcker att det avgörande felet inträffade innan modellen producerade något alls.
Ett genomarbetat exempel på visionsspråkmodeller
En VLM kan granska en skärmbild av en instrumentpanel och förklara vilket diagram som stöder ett skriftligt påstående.
Det här exemplet är informativt eftersom visionsspråkmodeller kan knytas till observerbara indata, mellanliggande tillstånd och ett resultat, i stället för att bedömas utifrån en polerad demonstration. Ett rigoröst test skulle omfatta vanliga, svåra och avsiktligt vilseledande fall baserade på scenariot, bevara en baslinje utan tekniken och dokumentera både genomsnittliga resultat och hur allvarliga enskilda fel är.
Ändra en förutsättning i exemplet med visionsspråkmodeller och upprepa analysen. Ta bort en nödvändig indata, introducera en motstridig signal, begränsa beräkningsresurserna, ändra användargruppen eller tvinga systemet att avstå från att svara. En mekanism som bara lyckas i en enda noggrant arrangerad demonstration har inte visat att den generaliserar till den miljö där den ska användas.
Visionsspråkmodeller jämfört med den vanligaste genvägen
Visionsspråkmodeller reduceras ofta till datorseende som förutsäger en fast etikett utan öppet språk. Den förenklingen suddar ut just den gräns som definierar begreppet. Det kan leda till att köpare jämför produkter som inte är jämförbara, att forskare överdriver vad ett experiment visar och att operatörer övervakar fel signal efter driftsättning.
| Perspektiv | Praktiskt svar |
|---|---|
| Definition | Visionsspråkmodeller kopplar samman visuella egenskaper med språk, så att ett system kan beskriva, jämföra och hämta bilder eller resonera om dem med ord. |
| Missuppfattning | datorseende som förutsäger en fast etikett utan öppet språk. |
| Risk | flytande beskrivningar kan nämna objekt eller samband som faktiskt inte syns. |
Jämförelsen bör också ange analysenheten. En artikel om visionsspråkmodeller kan avgränsa en modell eller algoritm, medan en driftsatt tjänst även omfattar hämtning, dirigering, cachning, policy, identitet, användargränssnitt och övervakning. Två produkter kan använda samma övergripande term men implementera olika delar av den här stacken. Fråga vilken komponent som utför den definierande omvandlingen och vilka andra komponenter som krävs för det rapporterade resultatet.
Varför visionsspråkmodeller är viktiga i dagens AI-system
Visionsspråkmodeller är viktiga nu eftersom AI-system får större kontexter, fler modaliteter, mer beräkningskraft under körning, bredare åtkomst till verktyg och djupare kopplingar till organisatoriska beslut. Under sådana förhållanden kan det som tidigare verkade vara en detalj i forskningen avgöra latens, säkerhet, tillgänglighet, miljökostnad, produktkvalitet eller rättsligt ansvar.
Det relevanta måttet är inte om visionsspråkmodeller kan leverera ett enda imponerande resultat. Frågan är om tekniken förbättrar ett viktigt utfall under representativa förhållanden och gör det mer effektivt än en enklare baslinje. Redovisa fördelningar, felkategorier, svanslatens, resursåtgång och berörda undergrupper i stället för att sammanfatta alla resultat i ett enda genomsnitt.
Utvärderingen bör isolera varje modalitet, testa motstridiga indata och verifiera tidsmässig eller rumslig förankring. Ett flytande svar som kombinerar flera modaliteter är inget bevis för att modellen uppmärksammade rätt signal. När den här disciplinen tillämpas specifikt på visionsspråkmodeller blir evidensen överförbar: ett annat team kan bedöma om den påstådda förbättringen sannolikt håller även med en annan modell, ett annat språk, en annan hårdvaruplattform, en annan datamängd, en annan användargrupp eller en annan risktolerans.
Fördelar som visionsspråkmodeller kan ge
Det främsta skälet att använda visionsspråkmodeller är att tekniken kan åtgärda den avsedda flaskhalsen direkt. Beroende på implementeringen kan fördelen visa sig som bättre förankring, en mer verklighetstrogen representation, förbättrad generalisering, lägre latens, mindre dataförflyttning i minnet, tydligare ansvarsfördelning eller en säkrare gräns mellan ett modellförslag och en verklig åtgärd.
Fördelar bör uttryckas i form av beslut och mätvärden. ”Mer intelligent” är inget acceptanskriterium för visionsspråkmodeller. Ett användbart mål kan till exempel ange felfrekvensen i svåra fall, återhämtning efter motstridiga belägg, kostnad vid en viss trafikpercentil, tiden för mänsklig granskning, kalibrering eller andelen åtgärder som hålls inom en fastställd befogenhetsgräns.
Feltypen som definierar visionsspråkmodeller
Den centrala begränsningen är att flytande beskrivningar kan nämna objekt eller samband som faktiskt inte syns. Det här felet är inte något man kan lägga till som en eftertanke när utvecklingen är klar. Det bör påverka datainsamling, arkitektur, behörigheter, utvärdering, beslutspunkter inför lansering och övervakning av visionsspråkmodeller från början.
En kontroll för syn- och språkmodeller är bara användbar om den ingriper innan en kostsam eller oåterkallelig konsekvens uppstår. Identifiera det tidigaste observerbara tecknet på ett fel, sätt en tröskel eller regel, utse en ansvarig och testa återhämtningen. Beroende på användningsfallet kan återhämtning innebära att avstå från att svara, gå tillbaka till ett enklare system, begära mer underlag, eskalera ärendet till en person, återställa en modell eller avbryta en åtgärd helt.
En utvärderingsplan för syn- och språkmodeller
Börja utvärdera syn- och språkmodeller genom att formulera vilket beslut underlaget ska stödja. Definiera målgruppen i drift, konsekvenserna av ett felaktigt resultat, vilken information som faktiskt finns tillgänglig när beslutet fattas och det enklaste trovärdiga alternativet. På så sätt blir ett benchmark inte målet enbart för att det är lätt att genomföra.
Använd en orörd testmängd för kontrollerade jämförelser och validera sedan syn- och språkmodeller i en stegvis driftsmiljö. Offlineutvärdering gör varianterna jämförbara; skuggläge, canary-tester, hastighetsbegränsningar eller godkännandesteg visar hur verklig trafik, återkopplingsslingor och människor förändrar beteendet. Driftsättningsfasen bör ha ett uttryckligt stoppvillkor, i stället för att utgå från att varje förbättring förtjänar en fullständig utrullning.
Versionshantera de indata som behövs för att återskapa syn- och språkmodeller: källdata, förbehandling, tokeniserare eller kodare, modellvikter, konfiguration, prompt eller policy, index för informationshämtning, utvärderingsmängd, maskinvaruantaganden och serveringskod, där det är tillämpligt. Utan spårbarhet kan ett team inte avgöra om ett förändrat resultat beror på metoden, miljön eller en oupptäckt ändring i datapipelinen.
Fråga slutligen vilket resultat som skulle motbevisa påståendet att syn- och språkmodeller är till hjälp. Om inget resultat skulle kunna ändra beslutet om införande är utvärderingen marknadsföring. Förutbestämda godkännandetrösklar och en bevarad bekräftelsemängd gör övningen till en evidensbaserad utvärdering.
Frågor att ställa innan syn- och språkmodeller införs
- Mål: Vilken mätbar flaskhals är syn- och språkmodeller tänkta att lösa?
- Mekanism: I vilket av de fem stegen sker den särskiljande omvandlingen?
- Jämförelse: Hur står sig modellen jämfört med datorseende som förutsäger en fast etikett utan öppet språk, eller med ett annat enklare alternativ?
- Underlag: Vilka vanliga, svåra och adversariella fall samt fall i olika undergrupper testades?
- Drift: Vilka kostnader för svarstid, minne, beräkningskraft, energi, underhåll och granskning uppstår i stor skala?
- Risk: Hur ska teamet upptäcka att välformulerade beskrivningar kan nämna objekt eller samband som faktiskt inte syns?
- Återhämtning: Kan systemet avstå från att svara, gå tillbaka till ett enklare alternativ, återställa en tidigare version eller eskalera ärendet innan skada uppstår?
Primärkällor för studier av syn- och språkmodeller
Auktoritativa utgångspunkter för den del av AI-stacken som omger syn- och språkmodeller är bland annat forskningsartikeln om CLIP och PaLM-E, en förkroppsligad multimodal modell. Läs dem tillsammans med dokumentationen för den specifika modell, datamängd, maskinvara och jurisdiktion som är aktuell. En allmän källa kan beskriva mekanismen, men bara evidens från den specifika driftsmiljön kan fastställa om en viss implementering är lämplig.
Det viktigaste att komma ihåg om syn- och språkmodeller
Syn- och språkmodeller är en avgränsad mekanism i ett större sociotekniskt system. Värdet ligger i att förbättra ett specifikt utfall under uttryckliga villkor, inte i själva beteckningen. Kartan över de fem stegen synliggör informationsflödet, jämförelsen visar vad modellen inte är och kontrollvägen visar var en ansvarstagande operatör kan ingripa.
Den praktiska tumregeln för syn- och språkmodeller är att definiera målet, jämföra med ett trovärdigt grundalternativ, testa det viktigaste felscenariot och bevara det underlag som behövs för att följa förändringar. Med dessa delar på plats blir konceptet ett tekniskt och styrningsmässigt val som går att utvärdera. Utan dem förblir det ett lovande namn kopplat till en okänd driftsrisk.


