
Grunderna i AI
Vad är AI-säkerhetsgrindar? Hur produktionssystem kontrollerar modellbeteende
AI‑skyddsräcken är lager av tekniska och procedurmässiga kontroller som begränsar indata, handlingar, utdata och eskalering kring en modell eller agent. Denna guide förklarar mekanismen, avvägningarna, utvärderingen och de kontroller som är relevanta i praktiken.

 Lägg till Unite.AI bland dina föredragna källor på Google
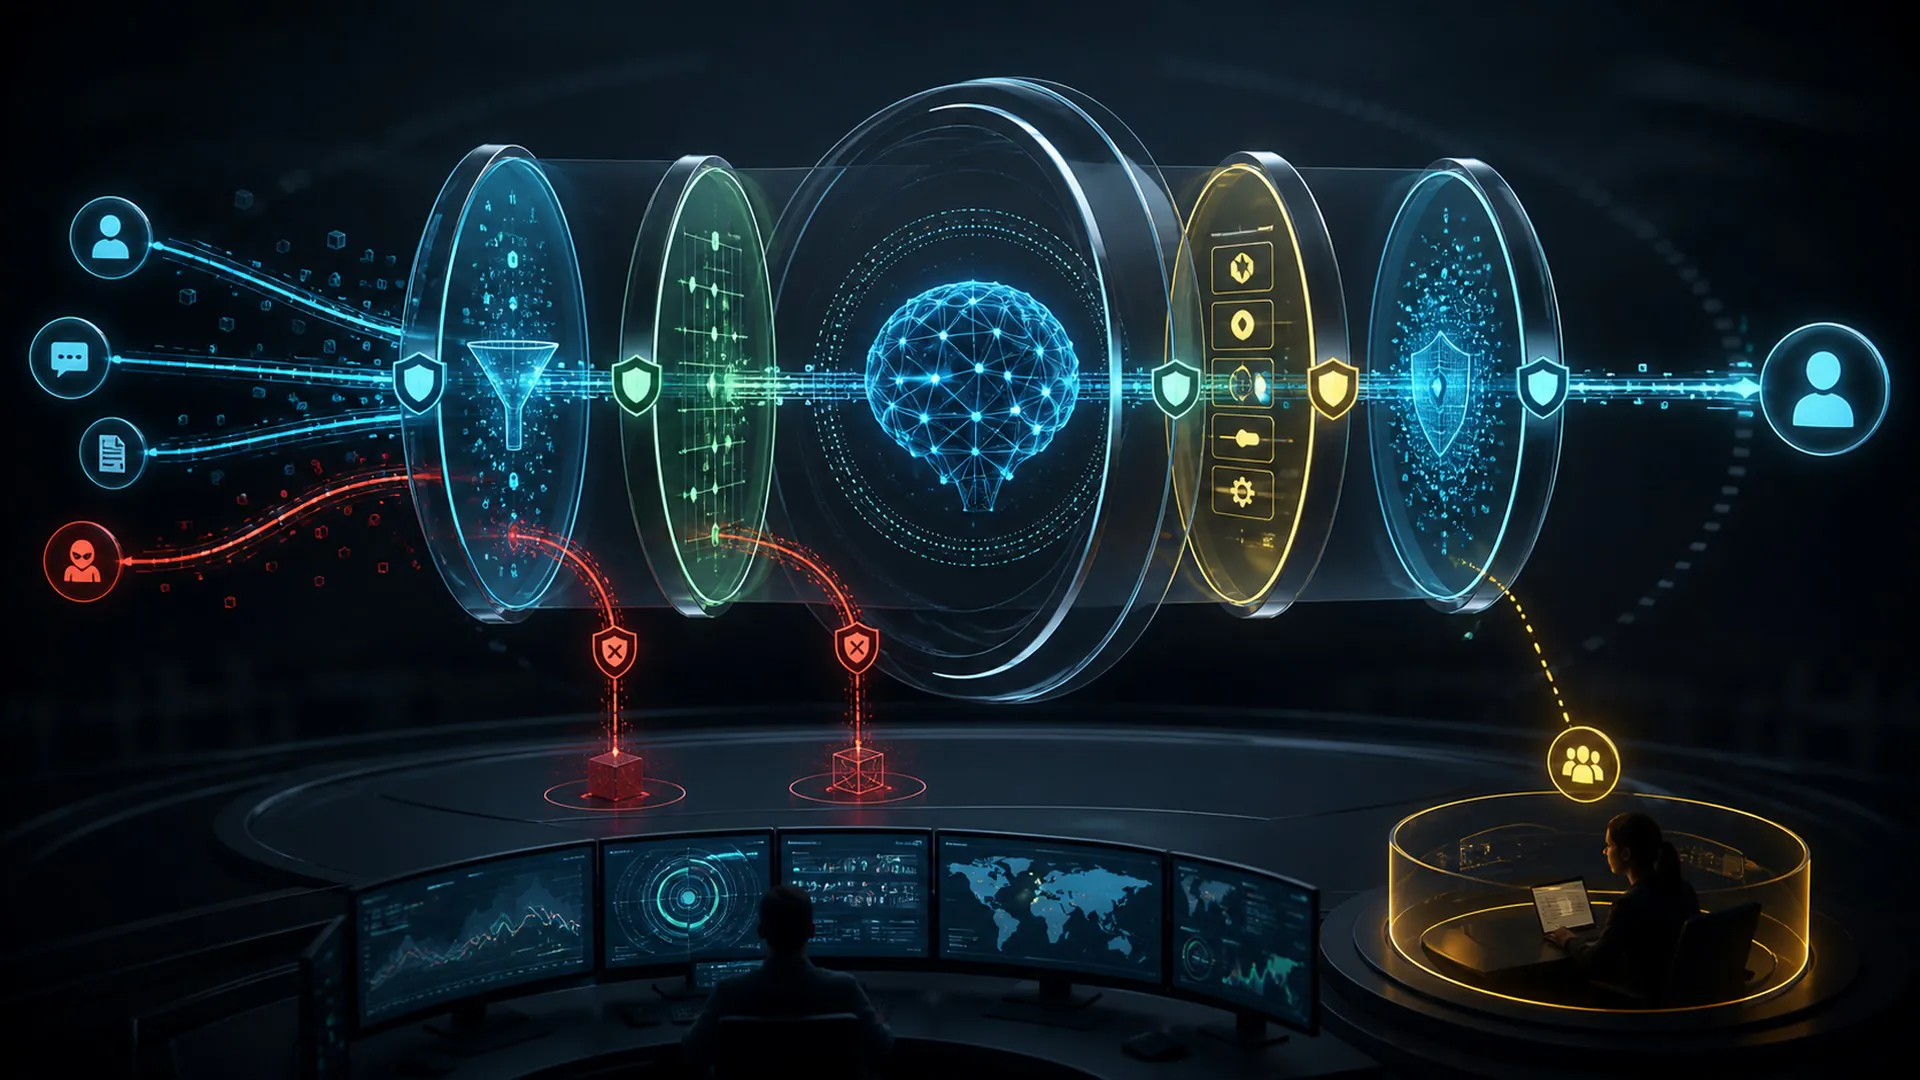
AI-säkerhetsgrindar är lager av tekniska och procedurmässiga kontroller som begränsar indata, åtgärder, utdata och eskalering kring en modell eller agent.
AI-säkerhetsgrindar förtjänar en exakt förklaring eftersom deras namn identifierar ett specifikt informationsflöde, träningsval, körningsmekanism eller styrningsgräns. Att behandla dem som en synonym för “avancerad AI” gör påståenden omöjliga att testa. Denna guide följer konceptet från dess indata och antaganden till dess observerbara resultat, och testar sedan den genväg som mest sannolikt förväxlas med det.
AI-säkerhetsgrindar: Definition, gräns och syfte
AI-säkerhetsgrindar är lager av tekniska och procedurmässiga kontroller som begränsar indata, åtgärder, utdata och eskalering kring en modell eller agent. Definitionen innehåller tre praktiska åtaganden: det finns en identifierbar indata, en transformation eller beslut som är karakteristiskt för AI-säkerhetsgrindar, och ett resultat som kan utvärderas mot ett angivet mål. Om någon av dessa element saknas kan benämningen beskriva en aspiration snarare än en implementerad mekanism.
Tillförlitlig AI kräver bevis genom hela livscykeln. En kontroll är meningsfull endast när dess ägare, omfattning, trigger, förväntade beteende och verifieringsmetod är tydliga. För AI-säkerhetsgrindar är detta systemperspektiv viktigt eftersom prestanda kan bestämmas av omgivande data, gränssnitt, hårdvara, behörigheter och människor även när den underliggande modellen är oförändrad. En användbar förklaring separerar därför modellens inlärda beteende från den produkt som beslutar när, var och med vilken befogenhet det beteendet används.
Den närmaste missvisande genvägen är en enskild systemprompt som förväntas upprätthålla varje gräns. Den kan dela en synlig funktion med AI-säkerhetsgrindar, men den förändrar den kausala berättelsen: annan evidens skulle bevisa framgång, andra resurser skulle dominera kostnaden och andra kontroller skulle förhindra skada. Gränsen är därför operativ snarare än terminologisk.
En femstegs driftkarta för AI-säkerhetsgrindar
Diagrammet är en kompakt kausal karta för AI-säkerhetsgrindar, inte ett påstående om att varje implementation använder fem mjukvarukomponenter. Vissa system kombinerar steg och andra upprepar dem i en slinga. Kartan förblir användbar eftersom den tvingar varje förändring i information eller auktoritet att ha en ägare, en indata, en utdata och ett test.
1. Klassificera begäran och tillämplig policy: Indata och antaganden i AI-säkerhetsgrindar
I detta steg av AI-säkerhetsgrindar måste systemet klassificera begäran och tillämplig policy. Den relevanta frågan är inte bara om den operationen sker, utan vilken information den konsumerar, vilket tillstånd den förändrar och vilken evidens som bevisar att förändringen var giltig. En granskare bör kunna särskilja operationen från en enskild systemprompt som förväntas upprätthålla varje gräns och reproducera dess resultat under samma angivna förhållanden.
Övergången till detta AI-säkerhetsgrindar-steg börjar med det angivna målet och bör avslutas med ett resultat som kan stödja begränsning av kontext, verktyg och dataåtkomst. Registrera osäkerhet, avvisade alternativ, resursanvändning och eventuell mänsklig eller mjukvarukontroll som tillämpas vid gränsen. Den spårningen är där team kan upptäcka om grindarna kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet innan samma svaghet når en betydande utdata.
2. Begränsa kontext, verktyg och dataåtkomst: Representation eller beslut i AI-säkerhetsgrindar
I detta steg av AI-säkerhetsgrindar måste systemet begränsa kontext, verktyg och dataåtkomst. Den relevanta frågan är inte bara om den operationen sker, utan vilken information den konsumerar, vilket tillstånd den förändrar och vilken evidens som bevisar att förändringen var giltig. En granskare bör kunna särskilja operationen från en enskild systemprompt som förväntas upprätthålla varje gräns och reproducera dess resultat under samma angivna förhållanden.
Övergången till detta AI-säkerhetsgrindar-steg börjar med att klassificera begäran och tillämplig policy och bör avslutas med ett resultat som kan stödja validering av föreslagna åtgärder innan verkställning. Registrera osäkerhet, avvisade alternativ, resursanvändning och eventuell mänsklig eller mjukvarukontroll som tillämpas vid gränsen. Den spårningen är där team kan upptäcka om grindarna kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet innan samma svaghet når en betydande utdata.
3. Validera föreslagna åtgärder innan utförande: Distinkt transformation i AI-säkerhetsåtgärder
I detta skede av AI-säkerhetsåtgärder måste systemet validera föreslagna åtgärder innan utförandet. Den relevanta frågan är inte bara om den operationen sker, utan vilken information den konsumerar, vilket tillstånd den förändrar och vilket bevis som visar att förändringen var giltig. En granskare bör kunna skilja operationen från ett enskilt systemprompt som förväntas upprätthålla varje gräns och reproducera dess resultat under samma angivna förhållanden.
Övergången till detta skede av AI-säkerhetsåtgärder börjar med att begränsa kontext, verktyg och datatillgång och bör avslutas med ett resultat som kan stödja inspektion av utdata och förändrat tillstånd. Registrera osäkerhet, avvisade alternativ, resursanvändning och eventuell mänsklig eller mjukvarukontroll som tillämpas vid gränsen. Den spårningen är där team kan upptäcka om säkerhetsåtgärder kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet innan samma svaghet når ett avgörande resultat.
4. Inspektera utdata och förändrat tillstånd: Begränsnings- och verifieringsgräns i AI-säkerhetsåtgärder
I detta skede av AI-säkerhetsåtgärder måste systemet inspektera utdata och förändrat tillstånd. Den relevanta frågan är inte bara om den operationen sker, utan vilken information den konsumerar, vilket tillstånd den förändrar och vilket bevis som visar att förändringen var giltig. En granskare bör kunna skilja operationen från ett enskilt systemprompt som förväntas upprätthålla varje gräns och reproducera dess resultat under samma angivna förhållanden.
Övergången till detta skede av AI-säkerhetsåtgärder börjar med att validera föreslagna åtgärder innan utförandet och bör avslutas med ett resultat som kan stödja eskalering, loggning och förbättring efter incidenter. Registrera osäkerhet, avvisade alternativ, resursanvändning och eventuell mänsklig eller mjukvarukontroll som tillämpas vid gränsen. Den spårningen är där team kan upptäcka om säkerhetsåtgärder kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet innan samma svaghet når ett avgörande resultat.
5. Eskalera, logga och förbättra efter incidenter: Utdata, återkoppling och stoppregel i AI-säkerhetsåtgärder
I detta skede av AI-säkerhetsåtgärder måste systemet eskalera, logga och förbättra efter incidenter. Den relevanta frågan är inte bara om den operationen sker, utan vilken information den konsumerar, vilket tillstånd den förändrar och vilket bevis som visar att förändringen var giltig. En granskare bör kunna skilja operationen från ett enskilt systemprompt som förväntas upprätthålla varje gräns och reproducera dess resultat under samma angivna förhållanden.
Övergången till detta skede av AI-säkerhetsåtgärder börjar med att inspektera utdata och förändrat tillstånd och bör avslutas med ett resultat som kan stödja övervakning eller ett slutgiltigt beslut. Registrera osäkerhet, avvisade alternativ, resursanvändning och eventuell mänsklig eller mjukvarukontroll som tillämpas vid gränsen. Den spårningen är där team kan upptäcka om säkerhetsåtgärder kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet innan samma svaghet når ett avgörande resultat.
Läs AI-säkerhetsåtgärders karta framåt för att förstå produktion och bakåt för att diagnostisera fel. Framåtanalyser frågar hur ett steg levererar till nästa. Bakåtanalyser startar från ett felaktigt, långsamt, dyrt eller osäkert resultat och spårar vilket tidigare antagande som möjliggjorde det. Den omvända vägen är ofta där ett team upptäcker att det avgörande felet inträffade innan modellen producerade något.
Ett genomarbetat exempel på AI-säkerhetsåtgärder
En finansiell assistent kan utarbeta en överföringsinstruktion, men en deterministisk regel och en auktoriserad granskare måste godkänna utförandet.
Detta exempel är informativt eftersom AI-säkerhetsåtgärder kan knytas till observerbara indata, mellansteg och ett resultat snarare än att bedömas genom en polerad demonstration. Ett rigoröst test skulle konstruera vanliga, svåra och avsiktligt missledande fall kring scenariot, bevara en baslinje utan tekniken och registrera både genomsnittlig prestanda och allvaret i enskilda misslyckanden.
Ändra ett antagande i AI-säkerhetsåtgärdsexemplet och upprepa analysen. Ta bort en obligatorisk indata, introducera en motstridig signal, begränsa beräkning, ändra användarpopulationen eller tvinga systemet att avstå. En mekanism som bara lyckas under en noggrant arrangerad demonstration har inte bevisat att den generaliserar till driftsmiljön.
AI-säkerhetsåtgärder vs. dess vanligaste genväg
AI-säkerhetsåtgärder reduceras ofta till ett enda systemprompt som förväntas upprätthålla varje gräns. Denna förenkling tar bort den gräns som definierar konceptet. Det kan leda köpare till att jämföra olikartade produkter, forskare till att överdriva vad ett experiment visar och operatörer till att övervaka fel signal efter implementering.
| Lins | Praktiskt svar |
|---|---|
| Definition | AI‑guardrails är lager av tekniska och procedurmässiga kontroller som begränsar indata, handlingar, utdata och eskalering kring en modell eller agent. |
| Förvirring | ett enda systemprompt förväntas upprätthålla varje gräns. |
| Risk | guardrails kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet. |
Jämförelsen bör också identifiera analysenheten. En artikel om AI‑guardrails kan isolera en modell eller algoritm, medan en distribuerad tjänst lägger till hämtning, routning, cachning, policy, identitet, användargränssnitt och övervakning. Två produkter kan använda samma rubrikterm men implementera olika delar av den stacken. Fråga vilken komponent som utför den avgörande transformationen och vilka andra komponenter som behövs för det rapporterade resultatet.
Varför AI‑guardrails är viktiga i nuvarande AI‑system
AI‑guardrails är viktiga nu eftersom AI‑system får större kontexter, fler modaliteter, mer beräkningskraft i drift, bredare verktygsåtkomst och djupare kopplingar till organisatoriska beslut. Under dessa förhållanden kan något som tidigare verkade vara en forskningsdetalj bestämma latens, säkerhet, tillgänglighet, miljökostnad, produktkvalitet eller juridiskt ansvar.
Den relevanta måttet är inte om AI‑guardrails kan producera ett imponerande resultat. Det handlar om huruvida tekniken förbättrar ett resultat som är viktigt över representativa förhållanden och gör det mer effektivt än en enklare baslinje. Rapportera fördelningar, felkategorier, svanslatens, resursanvändning och påverkade undergrupper snarare än att komprimera varje resultat till ett genomsnitt.
Övervaka både tekniska mått och påverkan på människor. Dokumentera osäkerhet, bevara härstamning, möjliggör eskalering och designa återhämtning innan systemet utsätts för föränderliga verkliga förhållanden. När det tillämpas specifikt på AI‑guardrails gör den disciplinen bevisen portabla: ett annat team kan bedöma om den påstådda vinsten sannolikt överlever en annan modell, språk, hårdvaruplattform, dataset, användarpopulation eller risktolerans.
Fördelar som AI‑guardrails kan leverera
Det starkaste skälet att använda AI‑guardrails är att de kan adressera den avsedda flaskhalsen direkt. Beroende på implementeringen kan fördelen visa sig som bättre förankring, en mer trogen representation, förbättrad generalisering, lägre latens, minskad minnesförflyttning, tydligare ansvarstagande eller en säkrare gräns mellan ett modellförslag och en verklig handling.
Fördelar bör uttryckas som beslut och mätningar. ”Mer intelligent” är inte ett acceptanskriterium för AI‑guardrails. Ett användbart mål kan specificera felprocent på svåra fall, återhämtning efter motstridig evidens, kostnad vid en viss trafikpercentil, tid för mänsklig granskning, kalibrering eller andelen handlingar som hålls inom en definierad befogenhetsgräns.
Felmodellen som definierar AI‑guardrails
Den centrala begränsningen är att guardrails kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet. Detta fel är inte en eftertanke att lista när utvecklingen är klar. Det bör forma datainsamling, arkitektur, behörigheter, utvärdering, release‑grindar och övervakning för AI‑guardrails från början.
En kontroll för AI‑guardrails är bara användbar om den verkar innan en dyr eller irreversibel konsekvens inträffar. Identifiera den tidigaste observerbara föregångaren till felet, sätt en tröskel eller regel, tilldela en ansvarig ägare och testa återhämtning. Beroende på användningsfallet kan återhämtning innebära att avstå, falla tillbaka till ett enklare system, begära mer evidens, eskalera till en person, rulla tillbaka en modell eller stoppa en handling helt.
En utvärderingsplan för AI‑guardrails
Påbörja utvärderingen av AI‑skyddsräcken genom att formulera det beslut som bevisen måste stödja. Definiera den operativa populationen, konsekvensen av ett felaktigt resultat, den information som faktiskt finns tillgänglig vid beslutsögonblicket och det enklaste trovärdiga alternativet. Detta förhindrar att ett referensvärde blir målet enbart för att det är lätt att köra.
Använd en orörd testuppsättning för kontrollerade jämförelser och validera sedan AI‑skyddsräcken i en stegvis operativ miljö. Offline‑utvärdering gör varianter jämförbara; skuggläge, kanarier, hastighetsgränser eller godkännandegater visar hur verklig trafik, återkopplingsslingor och människor förändrar beteendet. Implementeringsstadiet bör ha ett explicit stoppvillkor snarare än att anta att varje förbättring förtjänar full utrullning.
Versionera de indata som behövs för att reproducera AI‑skyddsräcken: källdata, förbehandling, tokeniserare eller kodare, modellvikter, konfiguration, prompt eller policy, återhämtningsindex, utvärderingsuppsättning, hårdvaruförutsättningar och serverkod där det är tillämpligt. Utan spårbarhet kan ett team inte avgöra om ett förändrat resultat beror på tekniken, miljön eller en förbisedda pipeline‑ändring.
Fråga slutligen vilken observation som skulle falsifiera påståendet att AI‑skyddsräcken hjälper. Om inget resultat kan vända beslutet om antagandet blir utvärderingen marknadsföring. Förhandsbestämda acceptanstoleranser och en bevarad bekräftelseuppsättning förvandlar övningen till bevis.
Frågor att ställa innan AI‑skyddsräcken antas
- Mål: Vilken mätbar flaskhals är AI‑skyddsräcken avsedda att lösa?
- Mechanism: Vilken av de fem faserna innehåller den distinkta transformationen?
- Baslinje: Hur jämför den sig med en enskild systemprompt som förväntas upprätthålla varje gräns eller ett annat enklare alternativ?
- Bevis: Vilka vanliga, svåra, adversariella och undergruppsfall testades?
- Drift: Vilken latens, minne, beräkningskraft, energi, underhålls- och granskningskostnad uppstår i skala?
- Risk: Hur kommer teamet att upptäcka att skyddsräcken kan blockera legitimt arbete, kringgås eller skapa en falsk känsla av säkerhet?
- Återhämtning: Kan systemet avstå, falla tillbaka, rulla tillbaka eller eskalera innan skada uppstår?
Primära källor för att studera AI‑skyddsräcken
Auktoritativa startpunkter för den del av AI‑stacken som omger AI‑skyddsräcken inkluderar NIST AI Risk Management Framework, C2PA specifications, NIST Privacy Framework. Läs dem tillsammans med dokumentationen för den specifika modellen, datasetet, hårdvaran och jurisdiktionen som är inblandad. En generell källa kan definiera mekanismen, men endast implementeringsspecifik evidens kan fastställa att en viss implementation är lämplig.
Vad man bör komma ihåg om AI‑skyddsräcken
AI‑skyddsräcken är en definierad mekanism inom ett större sociotekniskt system. Dess värde kommer från att förbättra ett specifikt resultat under explicita villkor, inte från själva benämningen. Den femstegs‑kartan gör informationsflödet synligt, jämförelsen identifierar vad det inte är, och kontrollvägen visar var en ansvarig operatör kan ingripa.
Den praktiska regeln för AI‑skyddsräcken är att definiera målet, jämföra mot en trovärdig baslinje, testa det fel som är mest kritiskt, och behålla de bevis som behövs för att övervaka förändring. Med dessa komponenter på plats blir konceptet ett ingenjörs‑ och styrningsval som kan utvärderas. Utan dem förblir det bara ett lovande namn kopplat till en okänd operativ risk.


