
Andersons vinkel
Mot realtids‑AI‑människor med Neural Lumigraph Rendering

 Lägg till Unite.AI bland dina föredragna källor på Google
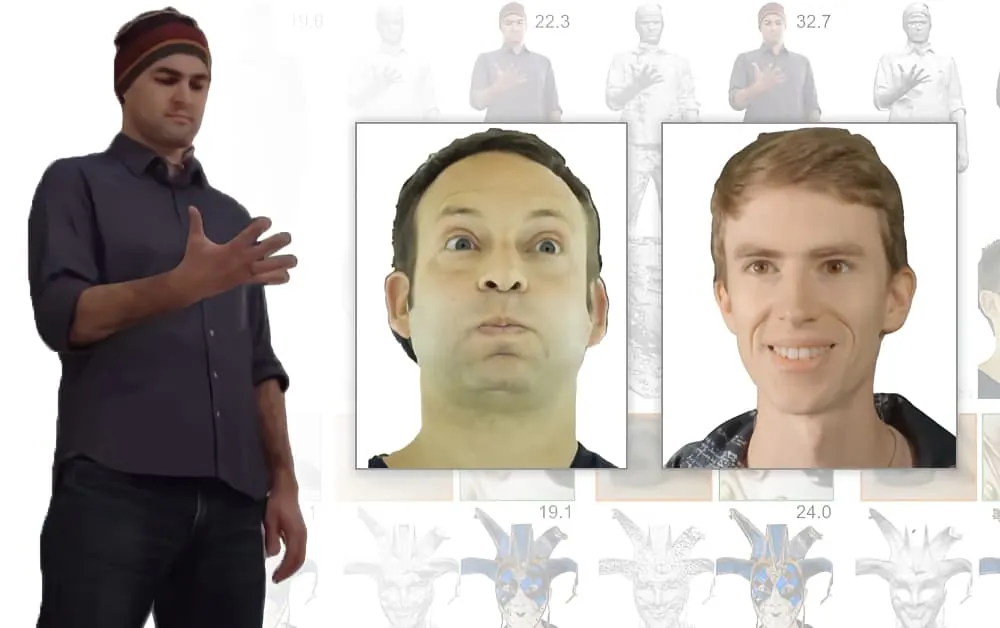
Trots den nuvarande vågen av intresse för Neural Radiance Fields (NeRF), en teknik som kan skapa AI‑genererade 3D‑miljöer och objekt, kräver detta nya tillvägagångssätt för bildsyntes fortfarande mycket träningstid och saknar en implementation som möjliggör realtids‑ och högresponsiva gränssnitt.
Dock erbjuder ett samarbete mellan några imponerande namn inom industri och akademi ett nytt grepp på denna utmaning (allmänt känt som Novel View Synthesis, eller NVS).
Forskningsartikeln, med titeln Neural Lumigraph Rendering, påstår en förbättring av state‑of‑the‑art med cirka två storleksordningar, vilket innebär flera steg mot realtids‑CG‑rendering via maskininlärnings‑pipeline.

Neural Lumigraph Rendering (right) offers better resolution of blending artifacts, and improved handling of occlusion over previous methods. Source.
Även om författarna till artikeln endast nämner Stanford University och holografisk display‑teknikföretaget Raxium (för närvarande i stealth‑läge), inkluderar bidragsgivarna en huvudansvarig för maskininlärning arkitekt på Google, en datorforskare på Adobe (ADBE ), samt CTO på StoryFile (som nyligen fick rubriker med en AI‑version av William Shatner).
Med anledning av den senaste Shatner‑publicitetskampanjen verkar StoryFile använda NLR i sin nya process för att skapa interaktiva, AI‑genererade enheter baserade på egenskaper och berättelser hos enskilda personer.
StoryFile föreställer sig att använda denna teknik i museiexponat, interaktiva online‑berättelser, holografiska skärmar, förstärkt verklighet (AR) och kulturarvsdokumentation – och verkar också rikta blicken mot potentiella nya tillämpningar av NLR i rekryteringsintervjuer och virtuella dejtingapplikationer:

Proposed uses from an online video by StoryFile.
Volymetrisk fångst för Novel View Synthesis‑gränssnitt och video
Principen för volymetrisk fångst, i de många artiklar som samlas kring ämnet, är idén att ta stillbilder eller videor av ett motiv och använda maskininlärning för att ‘fylla i’ de synvinklar som inte täcktes av den ursprungliga kameraraden.
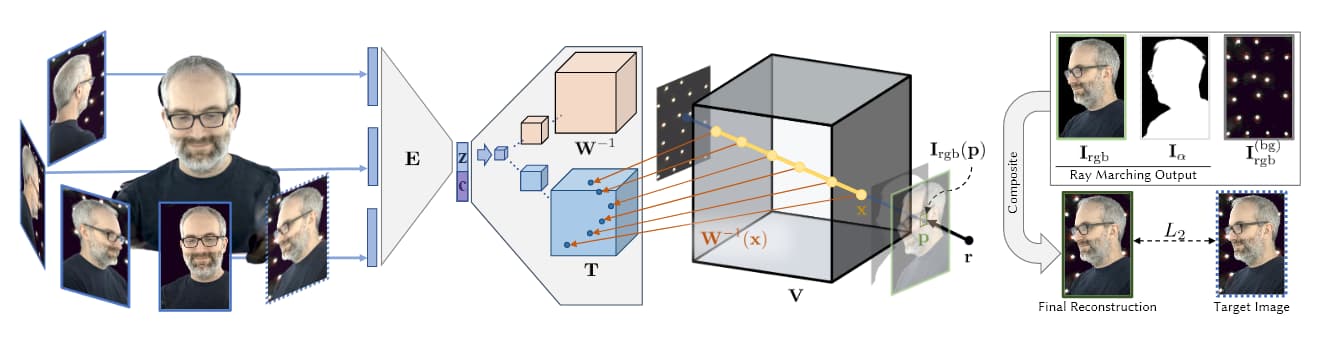
Source: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
I bilden ovan, tagen från Facebooks AI‑forskning 2019 (se nedan), ser vi de fyra stegen i volymetrisk fångst: flera kameror får bilder/video; en kodare/dekodare‑arkitektur (eller andra arkitekturer) beräknar och sammanfogar vyernas relativitet; ray‑marching‑algoritmer beräknar voxels (eller andra XYZ‑rumsliga geometriska enheter) för varje punkt i det volymetriska rummet; och (i de flesta senaste artiklarna) sker träning för att syntetisera en komplett entitet som kan manipuleras i realtid.
Det är denna ofta omfattande och datatunga träningsfas som hittills har hållit Novel View Synthesis utanför realtids‑ eller högresponsiv fångst.
Det faktum att Novel View Synthesis skapar en komplett 3D‑karta av ett volymetriskt rum innebär att det är relativt enkelt att sammanfoga dessa punkter till ett traditionellt datorgenererat mesh, vilket effektivt fångar och artikulerar en CGI‑människa (eller något annat relativt avgränsat objekt) i realtid.
Metoder som använder NeRF förlitar sig på punktmoln och djupkartor för att generera interpolationerna mellan de glesa synvinklarna från fångst‑enheterna:
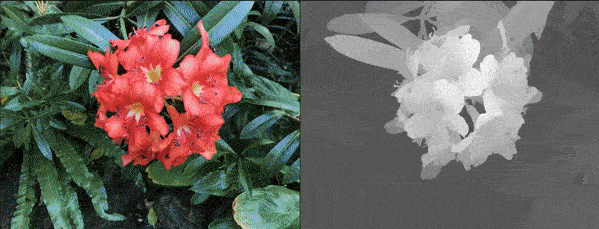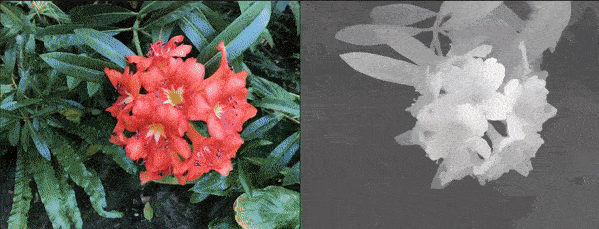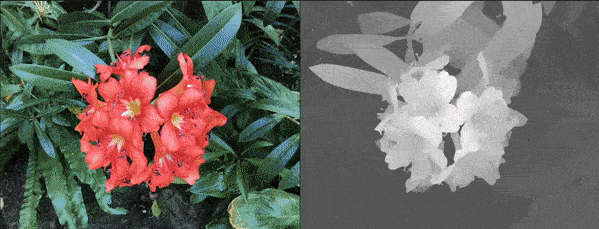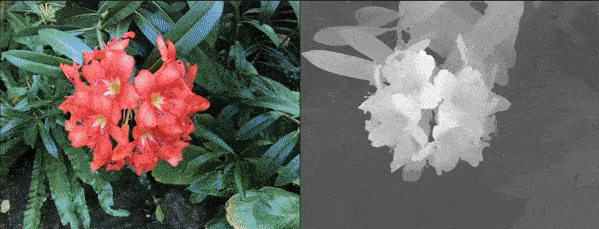
NeRF can generate volumetric depth through calculation of depth maps, rather than generation of CG meshes. Source: https://www.youtube.com/watch?v=JuH79E8rdKc
Även om NeRF är kapabel att beräkna mesh‑strukturer, använder de flesta implementationer detta inte för att generera volymetriska scener.
I kontrast utnyttjar metoden Implicit Differentiable Renderer (IDR) som publicerades av Weizmann Institute of Science i oktober 2020, den automatiska genereringen av 3D‑mesh‑information från fångst‑arrayer:
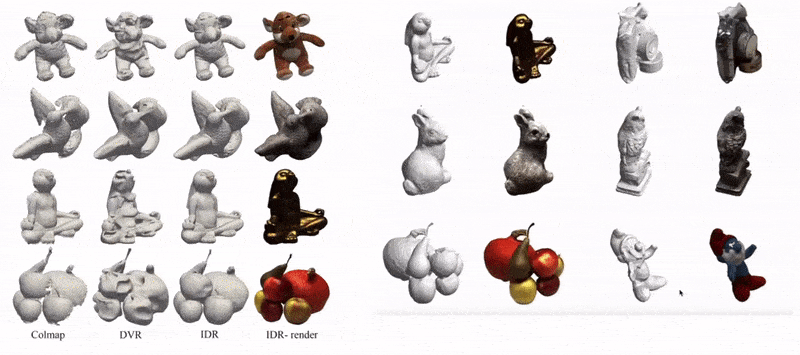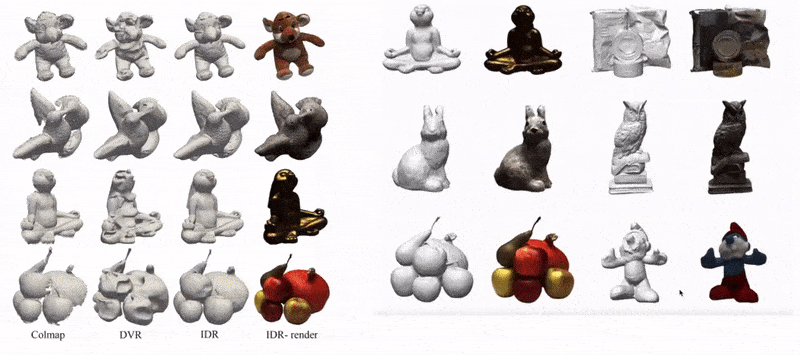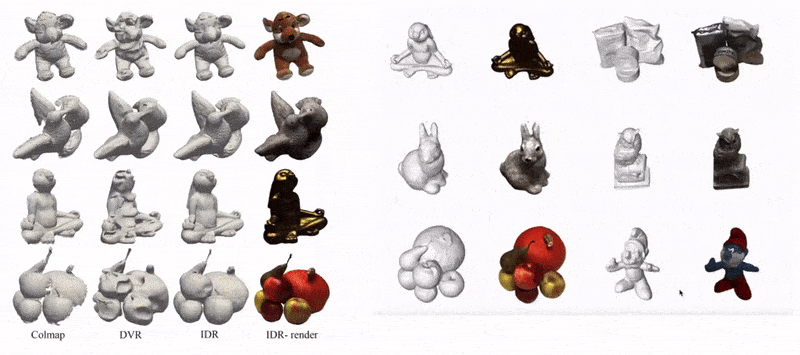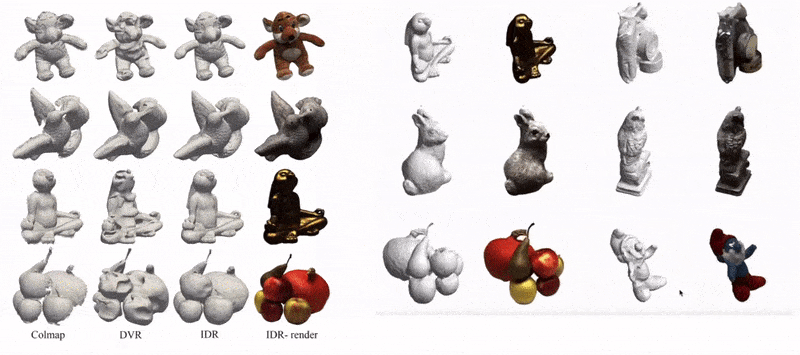
Examples of IDR captures turned into interactive CGI meshes. Source: https://www.youtube.com/watch?v=C55y7RhJ1fE
Medan NeRF saknar IDR:s förmåga till formestimering, kan IDR inte matcha NeRF:s bildkvalitet, och båda kräver omfattande resurser för att tränas och samlas (även om nyare innovationer i NeRF börjar att ta itu med detta).

NLR’s Custom camera rig featuring 16 GoPro HERO7 and 6 central Back-Bone H7PRO cameras. For ‘real time’ rendering, these operate at a minimum of 60fps. Source: https://arxiv.org/pdf/2103.11571.pdf
Istället använder Neural Lumigraph Rendering SIREN (Sinusoidal Representation Networks) för att integrera styrkorna i varje metod i sin egen ram, vilket är avsett att generera resultat som direkt kan användas i befintliga realtids‑grafik‑pipeline.
SIREN har använts för liknande implementationer under det senaste året, och representerar nu ett populärt API‑anrop för hobby‑Colabs i bildsyntes‑gemenskaper; dock är NLR:s innovation att tillämpa SIREN på tvådimensionell multi‑view‑bild‑supervision, vilket är problematiskt på grund av att SIREN tenderar att producera överanpassade snarare än generaliserade resultat.
Efter att CG‑meshen har extraherats från bildarrayerna rasteriseras meshen via OpenGL, och vertex‑positionerna på meshen mappas till lämpliga pixlar, varefter blandning av de olika bidragande kartorna beräknas.
Den resulterande meshen är mer generaliserad och representativ än NeRF:s (se bilden nedan), kräver mindre beräkning och applicerar inte överdriven detaljrikedom på områden (såsom slät ansiktshud) som inte kan dra nytta av det:

Source: https://arxiv.org/pdf/2103.11571.pdf
På den negativa sidan har NLR ännu ingen kapacitet för dynamisk belysning eller omljusning, och resultatet är begränsat till skuggkartor och andra ljusaspekter som erhölls vid fångsttidpunkten. Forskarna avser att åtgärda detta i framtida arbete.
Dessutom medger artikeln att de former som genereras av NLR inte är lika exakta som vissa alternativa metoder, såsom Pixelwise View Selection for Unstructured Multi-View Stereo, eller Weizmann Institute‑forskningen som nämndes tidigare.
Volymetrisk bildsyntesens framväxt
Idén att skapa 3D‑entiteter från en begränsad serie foton med neurala nätverk föregår NeRF, med visionära artiklar som går tillbaka till 2007 eller tidigare. År 2019 producerade Facebooks AI‑forskningsavdelning en banbrytande forskningsartikel, Neural Volumes: Learning Dynamic Renderable Volumes from Images, som först möjliggjorde responsiva gränssnitt för syntetiska människor genererade av maskininlärnings‑baserad volymetrisk fångst.
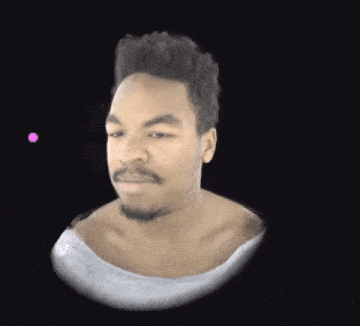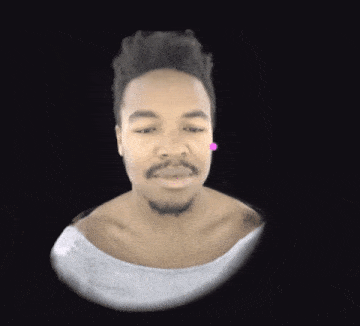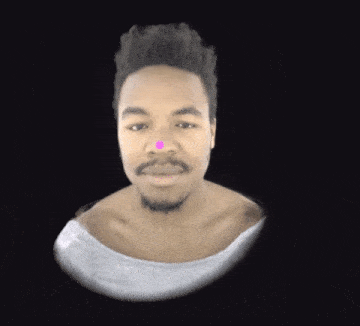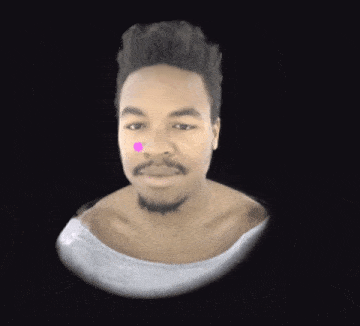
Facebook’s 2019 research enabled the creation of a responsive user interface for a volumetric person. Source: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


