
Intervjuer
Razi Raziuddin, medgrundare och VD för FeatureByte – Intervjuserie

 Lägg till Unite.AI bland dina föredragna källor på Google
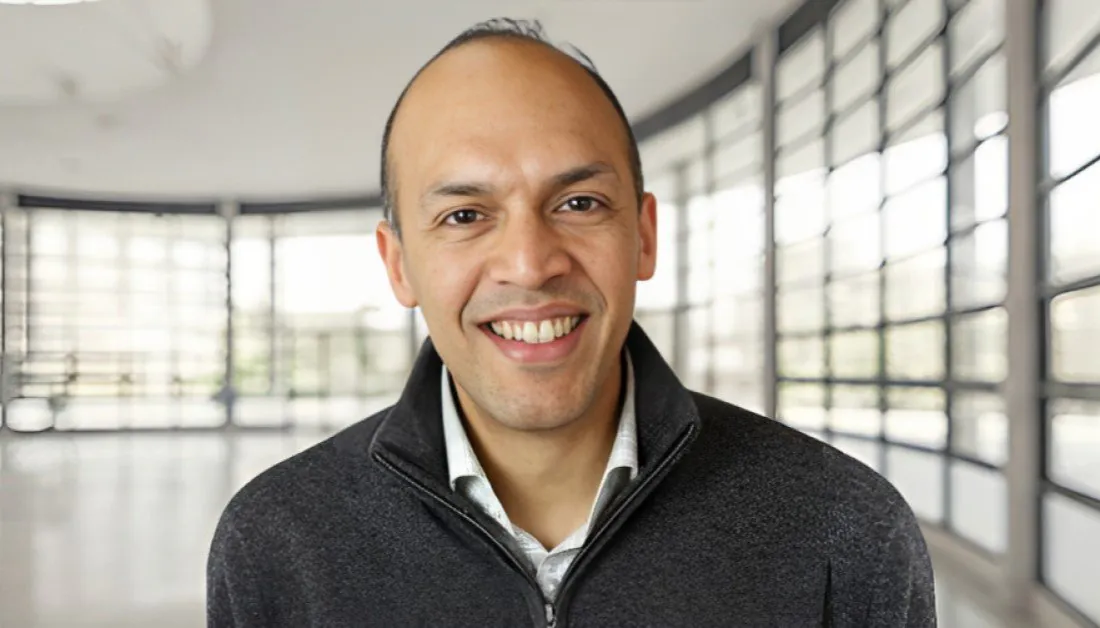
Razi Raziuddin är medgrundare och VD för FeatureByte, hans vision är att lösa den sista stora utmaningen för att skala AI i företaget. Razi’s analytiska och tillväxtorienterade erfarenhet omfattar ledningsteamet i två enhörningsstartups. Razi hjälpte till att skala DataRobot från 10 till 850 anställda på under sex år. Han banade väg för en tjänsteledande marknadsstrategi som blev kännetecknet för DataRobots snabba tillväxt.
FeatureByte är på en mission att skala företags-AI genom att radikalt förenkla och industrialisera AI-data. Plattformen för feature engineering och management (FEM) möjliggör för data scientists att skapa och dela toppmoderna modellvariabler och produktionsklara data pipelines på några minuter – istället för veckor eller månader.
Vad var det som initialt drog dig till datavetenskap och maskinlärning?
Som någon som började koda i gymnasiet, var jag fascinerad av en maskin som jag kunde “prata” med och kontrollera genom kod. Jag var omedelbart fast i de oändliga möjligheterna för nya tillämpningar. Maskinlärning representerade ett paradigmskifte i programmering, som tillät maskiner att lära sig och utföra uppgifter utan att man behöver ange stegen i kod. De oändliga möjligheterna för ML-tillämpningar är vad som får mig att bli entusiastisk varje dag.
Du var den första affärsrekryteringen på DataRobot, en automatiserad maskinlärningsplattform som möjliggör för organisationer att bli AI-drivna. Du hjälpte sedan till att skala företaget från 10 till 1 000 anställda på under 6 år. Vilka var några viktigaste lärdomar från denna erfarenhet?
Att gå från noll till en är svårt, men otroligt spännande och givande. Varje stadium i företagets utveckling presenterar en annan uppsättning utmaningar, men att se företaget växa och lyckas är en fantastisk känsla.
Min erfarenhet med AutoML öppnade mina ögon för den obegränsade potentialen för AI. Det är fascinerande att se hur denna teknik kan användas i så många olika branscher och tillämpningar. I slutändan handlar det om att skapa en ny kategori, vilket är en sällsynt prestation, men otroligt givande. Mina viktigaste lärdomar från erfarenheten:
- Bygg en fantastisk produkt och undvik att jaga trender
- Var inte rädd för att gå mot strömmen
- Fokusera på att lösa kundproblem och tillhandahålla värde
- Var alltid öppen för innovation och prova nya saker
- Skapa och förankra rätt företagskultur från början
Kan du dela berättelsen bakom FeatureByte?
Det är ett välkänt faktum i AI/ML-världen – att bra AI börjar med bra data. Men att förbereda, distribuera och hantera AI-data (eller modellvariabler) är komplext och tidskrävande. Min medgrundare, Xavier Conort, och jag såg detta problem med egna ögon på DataRobot. Medan modellering har blivit väsentligt förenklad tack vare AutoML-verktyg, kvarstår utveckling av modellvariabler och hantering som en enorm utmaning. Baserat på vår kombinerade erfarenhet och expertis, kände Xavier och jag att vi kunde hjälpa organisationer att lösa denna utmaning och infria löftet om AI överallt.
Utveckling av modellvariabler är kärnan i FeatureByte, kan du förklara vad detta är för våra läsare?
Till slut är det kvaliteten på data som driver kvaliteten och prestandan hos AI-modeller. Data som matas in i modeller för att träna dem och förutsäga framtida resultat kallas modellvariabler. Modellvariabler representerar information om entiteter och händelser, såsom demografisk eller psykografisk data om konsumenter, eller avståndet mellan en kortinnehavare och handlare för en kreditkortstransaktion eller antalet artiklar av olika kategorier från en butiks köp.
Processen att omvandla rådata till modellvariabler – för att träna ML-modeller och förutsäga framtida resultat – kallas utveckling av modellvariabler.
Varför är utveckling av modellvariabler en av de mest komplicerade aspekterna av maskinlärningsprojekt?
Utveckling av modellvariabler är super viktigt eftersom processen är direkt ansvarig för prestandan hos ML-modeller. Bra utveckling av modellvariabler kräver tre ganska oberoende färdigheter som måste komma samman – domänkunskap, data science och data engineering. Domänkunskap hjälper data scientists att bestämma vilka signaler som ska extraheras från data för ett visst problem eller användningsfall. Du behöver data science-färdigheter för att extrahera dessa signaler. Och slutligen hjälper data engineering dig att distribuera pipelines och utföra alla dessa operationer i stor skala på stora datamängder.
I de flesta organisationer finns dessa färdigheter i olika team. Dessa team använder olika verktyg och kommunicerar inte bra med varandra. Detta leder till mycket friktion i processen och bromsar den till ett stopp.
Kan du dela någon insikt om varför utveckling av modellvariabler är den svagaste länken i att skala AI?
Enligt Andrew Ng, en känd expert inom AI, “är tillämpad maskinlärning i princip utveckling av modellvariabler.” Trots dess kritiska betydelse för maskinlärningslivscykeln, kvarstår utveckling av modellvariabler som komplext, tidskrävande och beroende av expertkunskap. Det finns en allvarlig brist på verktyg för att göra processen enklare, snabbare och mer industrialiserad. Ansträngningen och expertisen som krävs håller företag tillbaka från att kunna distribuera AI i stor skala.
Kan du dela några av utmaningarna bakom att bygga en datacentrerad AI-lösning som radikalt förenklar utveckling av modellvariabler för data scientists?
Att bygga en produkt som har en 10X-fördel gentemot status quo är super svårt. Tack och lov har Xavier djup data science-expertis som han använder för att ompröva hela arbetsflödet för modellvariabler utifrån grundläggande principer. Vi har ett världsklass-team av full-stack data scientists och ingenjörer som kan förvandla vår vision till verklighet. Och användare och utvecklingspartners för att ge råd om att förenkla UX för att lösa deras utmaningar.
Hur kommer FeatureByte-plattformen att påskynda förberedelsen av data för maskinlärningsapplikationer?
Dataförberedelse för ML är en iterativ process som förlitar sig på snabba experiment. Den öppna källkoden FeatureByte SDK är ett deklarativt ramverk för att skapa toppmoderna modellvariabler med bara några rader kod och distribuera data pipelines på några minuter istället för veckor eller månader. Detta tillåter data scientists att fokusera på kreativ problemlösning och iterera snabbt på live-data, snarare än att oroa sig för den tekniska grundinfrastrukturen.
Resultatet är inte bara snabbare dataförberedelse och tillgängliggörande av data i produktion, utan också förbättrad modellprestanda genom kraftfulla modellvariabler.
Kan du diskutera hur FeatureByte-plattformen kommer att erbjuda möjligheten att förenkla olika pågående hanteringsuppgifter?
FeatureByte-plattformen är utformad för att hantera hela livscykeln för modellvariabler. Det deklarativa ramverket tillåter FeatureByte att distribuera data pipelines automatiskt, samtidigt som det extraherar metadata som är relevant för att hantera den övergripande miljön. Användare kan övervaka pipeline-hälsa och kostnader, och hantera härstamning, version och korrekthet för modellvariabler, allt från samma GUI. Företagsklassad rollbaserad åtkomst och godkännandeflöden säkerställer dataskydd och säkerhet, samtidigt som de undviker okontrollerad tillväxt av modellvariabler.
Finns det något annat du vill dela om FeatureByte?
De flesta företags-AI-verktyg fokuserar på att förbättra maskinlärningsmodeller. Vi har gjort det till vår mission att hjälpa företag att skala sin AI, genom att förenkla och industrialisera AI-data. På FeatureByte, adresserar vi den största utmaningen för AI-praktiker: Att tillhandahålla ett konsekvent, skalbart sätt att förbereda, tillgängliggöra och hantera data över hela livscykeln för en modell, samtidigt som vi radikalt förenklar hela processen.
Om du är en data scientist eller ingenjör som är intresserad av att hålla dig i framkant av data science, uppmuntrar jag dig att uppleva kraften hos FeatureByte gratis.
Tack för den underbara intervjun, läsare som vill lära sig mer kan besöka FeatureByte.


