
Intervjuer
Läkaren Ittai Dayan, medgrundare och vd för Rhino Health – intervjuserien

 Lägg till Unite.AI bland dina föredragna källor på Google
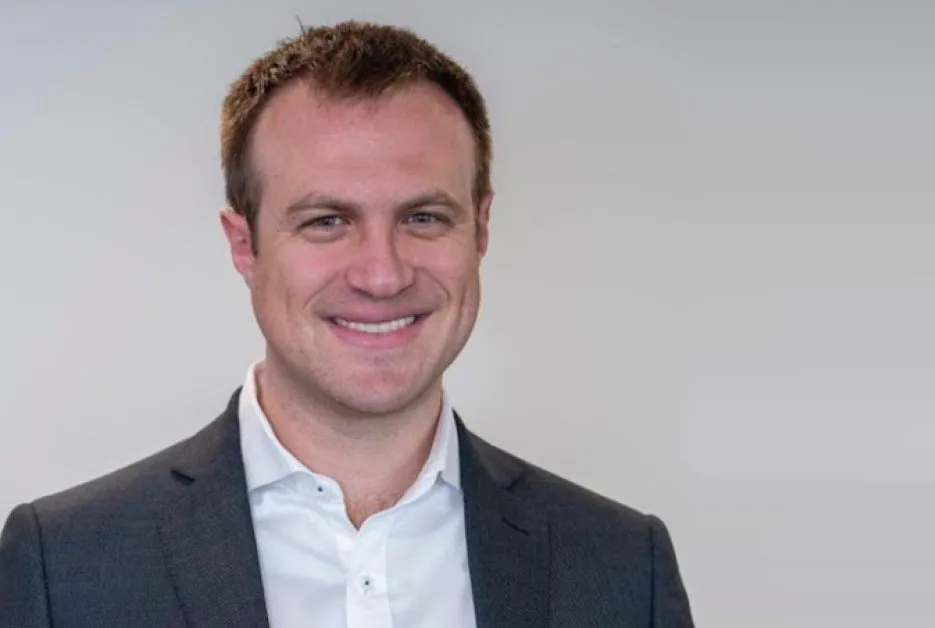
Ittai Dayan, MD, är medgrundare och VD för Rhino Health. Hans bakgrund är inom utveckling av artificiell intelligens och diagnostik, samt klinisk medicin och forskning. Han är en före detta kärnmedlem i BCG:s verksamhetsområde för hälso- och sjukvård och sjukhusledare. Han fokuserar för närvarande på att bidra till utvecklingen av säker, rättvis och effektiv artificiell intelligens inom hälso- och livsvetenskapsindustrin. På Rhino Health använder de distribuerad beräkning och federerat lärande som ett sätt att upprätthålla patientsekretess och främja samarbete inom det fragmenterade vårdlandskapet.
Han tjänstgjorde i IDF – specialstyrkor, ledde världens största centrum för translationell AI vid ett akademiskt medicinskt centrum. Han är expert på AI-utveckling och kommersialisering, och en långdistanslöpare.
Kan du dela med dig av ursprunget till Rhino Health?
Min resa inom AI började när jag var kliniker och forskare, och använde en tidig form av en “digital biomarkör” för att mäta behandlingssvar i psykiska störningar. Senare ledde jag Centrum för klinisk datavetenskap (CCDS) vid Mass General Brigham. Där övervakade jag utvecklingen av dussintals kliniska AI-applikationer, och upplevde på nära håll de grundläggande utmaningarna med att få tillgång till och “aktivera” de data som behövs för att utveckla och träna AI-produkter som uppfyller myndighetskrav.
Trots de många framstegen inom hälso- och sjukvårds-AI, är vägen från utveckling till lansering av en produkt på marknaden lång och ofta ojämn. Lösningar kraschar (eller bara gör användarna besvikna) när de distribueras kliniskt, och att stödja hela AI-livscykeln är nästan omöjligt utan kontinuerlig tillgång till en mängd kliniska data. Utmaningen har förskjutits från skapande av modeller, till underhåll av dem. För att besvara denna utmaning, övertygade jag Mass General Brigham-systemet om värdet av att ha sin egen “specialiserade CRO för AI” (CRO = Klinisk forskningsorganisation), för att testa algoritmer från flera kommersiella utvecklare.
Men problemet kvarstod – hälso- och sjukvårdsdata är fortfarande mycket isolerad, och även stora mängder data från ett nätverk räcker inte för att möta den medicinska AI:ns allt snävare användningsområden. Sommaren 2020 initierade och ledde jag (tillsammans med Dr. Mona Flores från NVIDIA (NVDA )) världens största hälso- och sjukvårdsstudie med federerat lärande (FL) på den tiden, EXAM. Vi använde FL för att skapa en COVID-utfallsprognosmodell, med data från hela världen, utan att dela någon data. Denna studie publicerades senare i Nature Medicine, och visade den positiva effekten av att utnyttja olika och disparata dataset, och underströk potentialen för en mer omfattande användning av federerat lärande inom hälso- och sjukvården.
Denna erfarenhet belyste dock ett antal utmaningar. Dessa inkluderade att samordna data mellan samarbetande verksamheter, säkerställa data-spårbarhet och korrekt karakterisering, samt den börda som lades på IT-avdelningarna från varje institution, som var tvungna att lära sig avancerad teknik som de inte var vana vid. Detta krävde en ny plattform som skulle stödja dessa nya “distribuerade data”-samarbeten. Jag bestämde mig för att samarbeta med min medgrundare, Yuval Baror, för att skapa en heltäckande plattform som stöder samarbeten som skyddar patientsekretessen. Den plattformen är “Rhino Health-plattformen”, som använder FL och edge-beräkning.
Varför tror du att AI-modeller ofta inte levererar förväntade resultat i en hälso- och sjukvårdsmiljö?
Medicinsk AI är ofta tränad på små, snäva dataset, såsom dataset från en enda institution eller geografisk region, vilket leder till att den resulterande modellen bara fungerar bra på de typer av data den har sett. När algoritmen appliceras på patienter eller scenarier som skiljer sig från det snäva träningsdatasetet, påverkas prestandan kraftigt.
Andrew Ng, fångade begreppet väl när han sa, “Det visar sig att när vi samlar in data från Stanford Hospital… kan vi publicera studier som visar [algoritmerna] är jämförbara med mänskliga radiologer i att upptäcka vissa tillstånd. … [När] du tar samma modell, samma AI-system, till ett äldre sjukhus nerför gatan, med en äldre maskin, och teknikern använder ett något annorlunda bildtagningsprotokoll, så förändras data och orsakar AI-systemets prestanda att försämras avsevärt.” 3
Enkelt uttryckt är de flesta AI-modeller inte tränade på data som är tillräckligt diversifierade och av hög kvalitet, vilket resulterar i dålig “verklighetsprestanda”. Denna fråga har väl dokumenterats i både vetenskapliga och mainstream-kretsar, såsom i Science och Politico.
Hur viktigt är det att testa på diversifierade patientgrupper?
Att testa på diversifierade patientgrupper är avgörande för att säkerställa att den resulterande AI-produkten inte bara är effektiv och presterar bra, utan också säker. Algoritmer som inte tränas eller testas på tillräckligt diversifierade patientgrupper kan lida av algoritmisk snedvridning, ett allvarligt problem inom hälso- och sjukvård och hälso- och sjukvårdsteknologi. Inte bara kommer sådana algoritmer att reflektera den bias som fanns i träningsdata, utan också förvärra den och förstärka befintliga ojämlikheter kopplade till ras, etnicitet, religion, kön och andra faktorer inom hälso- och sjukvården. Att inte testa på diversifierade patientgrupper kan resultera i farliga produkter.
En nyligen publicerad studie 5, som använt Rhino Health-plattformen, undersökte prestandan hos en AI-algoritm för att upptäcka hjärnaneurysm, utvecklad vid en plats, på fyra olika platser med olika skannertyper. Resultaten visade en betydande prestandavariation på platser med olika skannertyper, och betonade vikten av att träna och testa på diversifierade dataset.
Hur identifierar du om en subpopulation inte är representerad?
En vanlig metod är att analysera fördelningen av variabler i olika dataset, individuellt och kombinerat. Det kan informera utvecklare både när de förbereder “tränings”-dataset och valideringsdataset. Rhino Health-plattformen tillåter dig att göra detta, och dessutom kan användare se hur modellen fungerar på olika kohorter för att säkerställa generaliserbarhet och hållbar prestanda över subpopulationer.
Kan du beskriva vad Federated Learning är och hur det löser några av dessa problem?
Federerat lärande (FL) kan i bred mening definieras som processen där AI-modeller tränas och sedan fortsätter att förbättras över tid, med hjälp av disparata data, utan att dela eller centralisera data. Detta är ett stort steg framåt i AI-utvecklingen. Historiskt sett måste varje användare som vill samarbeta med flera platser samla alla dessa data på ett ställe, vilket orsakar en mängd besvärliga, dyra och tidskrävande juridiska, risk- och efterlevnadsfrågor.
Idag, med programvara som Rhino Health-plattformen, blir FL en vardaglighet inom hälso- och sjukvård och livsvetenskapsindustrin. Federerat lärande tillåter användare att utforska, kurera och validera data medan data förblir på samarbetspartners lokala servrar. Containeriserad kod, såsom en AI/ML-algoritm eller en analytisk applikation, skickas till den lokala servern där koden körs lokalt, exempelvis för att träna eller validera en AI/ML-algoritm. Data förblir alltid hos “dataförvaltaren”.
Sjukhus, i synnerhet, är oroliga för de risker som är förknippade med att samla in känslig patientdata. Detta har redan lett till pinsamma situationer, där det har blivit tydligt att hälso- och sjukvårdsorganisationer har samarbetat med industrin utan att förstå användningen av deras data. I sin tur begränsar de mängden samarbete som både industri- och akademiska forskare kan göra, vilket bromsar R&D och påverkar produktkvaliteten inom hälso- och sjukvården. FL kan mildra detta och möjliggöra data-samarbeten som aldrig tidigare, samtidigt som risken förknippad med dessa samarbeten kontrolleras.
Kan du dela med dig av Rhino Healths vision för att möjliggöra snabbt modellbyggande med hjälp av mer diversifierad data?
Vi ser en framtid där AI-utvecklare och användare samarbetar utan rädsla eller begränsningar, samtidigt som de respekterar regleringsgränserna. Samarbetande parter kan snabbt identifiera nödvändig tränings- och testdata från hela världen, komma åt och interagera med data, och iterera på modellutveckling för att säkerställa tillräcklig generaliserbarhet, prestanda och säkerhet.
I centrum för detta ligger Rhino Health-plattformen, som tillhandahåller en “one-stop-shop” för AI-utvecklare att konstruera stora och diversifierade dataset, träna och validera AI-algoritmer, och kontinuerligt övervaka och underhålla driftsatta AI-produkter.
Hur förhindrar Rhino Health-plattformen AI-bias och erbjuder AI-förklarbarhet?
Genom att låsa upp och strömlinjeforma data-samarbeten kan AI-utvecklare utnyttja större och mer diversifierade dataset vid tränings- och testningsprocessen för sina applikationer. Resultatet av mer robusta dataset är en mer generaliserbar produkt som inte belastas av bias från en enda institution eller smalt dataset. I stöd för AI-förklarbarhet tillhandahåller vår plattform en tydlig vy över de data som används under utvecklingsprocessen, med möjlighet att analysera dataursprung, fördelning av värden och andra nyckelparametrar för att säkerställa tillräcklig data-diversitet och kvalitet. Dessutom möjliggör vår plattform funktioner som inte är möjliga om data bara poolas tillsammans, inklusive att tillåta användare att ytterligare förbättra sina dataset med ytterligare variabler, såsom de som beräknas från befintliga datapunkter, för att undersöka kausala inferenser och minska påverkan från störfaktorer.
Hur svarar du på läkare som är oroliga för att en överdriven tillit till AI kan leda till bias-resultat som inte är oberoende validerade?
Vi förstår och delar denna oro, och erkänner att många av de applikationer som finns på marknaden idag kan vara snedvridna. Vårt svar är att vi som bransch, som en hälso- och sjukvårdscommunity som i första hand värnar patientsäkerheten, måste komma samman för att definiera policys och procedurer för att förhindra sådana bias och säkerställa säkra och effektiva AI-applikationer. AI-utvecklare har ansvaret att säkerställa att deras marknadsförda AI-produkter är oberoende validerade för att uppnå förtroendet hos både hälso- och sjukvårdspersonal och patienter. Rhino Health är dedikerat till att stödja säkra och pålitliga AI-produkter, och arbetar med partners för att möjliggöra och strömlinjeforma oberoende validering av AI-applikationer innan de distribueras i kliniska miljöer, genom att undanröja hindren för tillgång till nödvändiga valideringsdata.
Vad är din vision för framtiden för AI inom hälso- och sjukvården?
Rhino Healths vision är en värld där AI har uppnått sin fulla potential inom hälso- och sjukvården. Vi arbetar hårt för att skapa transparens och främja samarbete genom att säkerställa integritetsskyddet för att möjliggöra denna värld. Vi ser en framtid där hälso- och sjukvårds-AI inte är begränsad av brandväggar, geografiska områden eller regulatoriska begränsningar. AI-utvecklare kommer att ha kontrollerad tillgång till all den data de behöver för att bygga kraftfulla och generaliserbara modeller, och för att kontinuerligt övervaka och förbättra dem med en ström av data i realtid. Leverantörer och patienter kommer att ha förtroendet för att de inte förlorar kontrollen över sina data, och kan säkerställa att de används för det bästa. Regulatoriska myndigheter kommer att kunna övervaka modellernas effektivitet som används inom läkemedels- och enhetsutveckling i realtid. Folkhälsoorganisationer kommer att dra nytta av dessa framsteg inom AI, medan patienter och leverantörer kan sova gott, säkra på att sekretessen skyddas.
Tack för den underbara intervjun, läsare som vill lära sig mer kan besöka Rhino Health.



