Andersons vinkel
Uttrycka känslor genom typografi med AI

 Lägg till Unite.AI bland dina föredragna källor på Google
Viktiga punkterTalmodulerad typografi mappar tonhöjd, varaktighet och ljudstyrka till…
Visa mer
- Talmodulerad typografi mappar tonhöjd, varaktighet och ljudstyrka till baslinjeförskjutning, kerning och teckenvikt.
- Dynamiska undertexter fick sämre resultat än statiska eftersom animerad läsning ökar den kognitiva belastningen för tittarna.
- Prosodimedveten text skulle kunna berika datamängder och uppgifter inom affektberäkning, såsom kundnöjdhet eller inferens av depression.
Nuvarande trender och innovationer inom textkommunikation (inklusive e-post, meddelanden och undertextningssystem) måste överbrygga den känslomässiga klyftan mellan skrivet och talat språk på ett grovt och approximativt sätt.
Till exempel har de senaste åren lett till växlande stora och små bokstäver som en provokativ meme i sociala medier-flamkrig, medan den mycket hatade användningen av Caps Lock (samt feta och skärande typografiska effekter som tillåts av vissa kommentarsplattformar) fortsätter att provocera ingripande från moderatorer. Dessa är monotona och endast grovt representativa metoder för att förtydliga avsikten med det skrivna ordet.
Samtidigt har populariteten för emotikoner och emojis, som en hybrid textuell/visuell sentimentbärare, aktivt engagerat den naturliga språkbehandlingsforskningen (NLP) under de senaste åren, tillsammans med intresse för betydelsen av animerade GIF:er som användare publicerar i kommentarstrådar.
Över tiden har det skrivna språket utvecklat en innovativ repertoar av dessa “additiva” lingvistiska metoder, som antingen försöker förmedla känslor indirekt eller framkalla dem i avsaknad av den tonala informationen i det talade ordet.
Vanligtvis måste vi dock återge känslan så gott vi kan från sammanhanget i det skrivna ordet. Till exempel kan man betrakta utropet ‘Oh, Oh, Oh!’, i slutet av Lady Macbeths förvirrade nattliga monolog, som en fallstudie av den utsträckning till vilken intonation kan påverka betydelsen.
I de flesta adaptationer varar denna plågade klagan i 2-6 sekunder; i Trevor Nunns 1976 Royal Shakespeare Company-produktion av Macbeth tog Judi Dench läsningen av denna rad till ett möjligen oöverträffat rekord på 24,45 sekunder, i en banbrytande tolkning av rollen.
(YouTube’s eget auto-undertextningssystem för detta klipp beskriver Denchs ululation som [MUSIK])
Översättning av prosodi till typografi
En nyligen publicerad artikel från Brasilien föreslår ett system för talmodulerad typografi som potentiellt kan inkorporera sådan prosodi och andra paralingvistiska komponenter direkt i undertextat tal, och lägga till en dimension av känslor som dåligt fångas av att sätta adjektiv före texten som [Skrikande], eller andra “platta” trick som finns tillgängliga för stängd undertextning.
‘Vi föreslår en ny modell för talmodulerad typografi, där akustiska egenskaper från tal används för att modulera det visuella utseendet på texten. Detta kan tillåta transkriptionen av ett visst yttrande att inte bara representera de ord som sägs, utan hur de sades.
‘Med detta hoppas vi att avslöja typografiska parametrar som kan allmänt erkännas som visuella proxier för de prosodiska egenskaperna av amplitud, tonhöjd och varaktighet.’

Arbetsflödet som translittererar prosodi till typografisk stil. I syfte att producera det mest mångsidiga och bredast distribuerbara systemet möjligt, begränsade författarna sig till baslinjeförskjutning, teckenavstånd och fetstil, den senare tillhandahålls av flexibiliteten hos ett OpenType-teckensnitt. Källa: https://arxiv.org/pdf/2202.10631.pdf
Artikeln har titeln Dolda skrik, viskningar och ylande: kan text göras att låta mer än bara dess ord? och kommer från Calua de Lacerda Pataca och Paula Dornhofer Paro Costa, två forskare vid Universidade Estadual de Campinas i Brasilien.
Feta ord
Även om det bredare målet med projektet är att utveckla system som kan förmedla prosodi och andra parametriska språkegenskaper i undertextning, tror författarna också att ett system av detta slag potentiellt kan utveckla en bredare publik i den hörande världen.
Det finns många tidigare initiativ inom detta område, inklusive ett 1983-projekt som föreslog ett undertextningssystem som kunde inkludera ‘specialeffekter, färg och versaler [för att representera] den rika tonala informationen som förnekas döva barn[.]’.
Det brasilianska projektet kan däremot ta till vara både automatiserad transkription och nya utvecklingar inom affekterkänningsområdet, som kombineras för att möjliggöra ett arbetsflöde som kan importera och karakterisera komponenterna i ett ljudspår med tal.
Efter att de prosodiska egenskaperna har extraherats och bearbetats, mappas de till tidsstämplarna för orden i talet, vilket producerar token som sedan kan användas för att tillämpa regelbaserad modulering av undertextens typografi (se bild ovan).
Detta resultat kan visuellt representera den utsträckning till vilken en viss stavelse kan vara förlängd, viskad, betonad eller på annat sätt innehålla kontextuell information som skulle gå förlorad i en rå transkription.

Från projektets testfas: notera hur teckenavståndet, avståndet mellan bokstäverna i ett ord, har ökats för att återspegla ett utdraget uttal.
Författarna förtydligar att deras arbete inte är tänkt att bidra direkt till forskning om känsloigenkänning och affektigenkänning, utan snarare syftar till att klassificera talets egenskaper och representera dem med enkla och begränsade nya visuella konventioner.
Åtminstone gör systemets extra betoning det lättare att tolka meningar där föremålet för handlingen kanske inte är tydligt för tittare som inte kan höra ljudet (antingen på grund av funktionshinder eller omständigheterna kring uppspelningen, såsom bullriga miljöer).
För att låna mitt eget exempel från 2017, som tittade på hur maskinlärningssystem kan också ha svårt att förstå var föremålet och handlingen ligger i en mening, är det lätt att se den utsträckning till vilken betoning kan radikalt ändra meningarna i en enkel mening:
Jag stal inte det. (Någon annan stal det)
Jag stal inte det. (Jag förnekar anklagelsen att jag stal det)
Jag stal inte det. (Det är mitt; stöld är inte aktuellt) Jag stal inte det. (Men jag stal något annat)
Potentiellt kunde ett mekaniskt prosodi-typografi-arbetsflöde som de brasilianska författarna föreslår också vara användbart som ett hjälpmedel i utvecklingen av datamängder för forskning om affektiv databehandling, eftersom det underlättar bearbetningen av rent textbaserad data som ändå inkorporerar vissa på förhand härledda paralingvistiska dimensioner.
Dessutom noterar forskarna att den extra lingvistiska nyttan av prosodi-medveten text kunde vara användbar i en rad NLP-baserade uppgifter, inklusive kundtillfredsställelseutvärdering och för inferens av depression från textinnehåll.
Elastisk typografi
Ramverket som utvecklats av forskarna erbjuder variation i baslinjeförskjutning, där en bokstav kan vara högre eller lägre i förhållande till “baslinjen” som meningen vilar på; teckenavstånd, där avståndet mellan bokstäverna i ett ord kan kontraheras eller utvidgas; och teckensnittsvikt (fetstil).
Dessa tre stilar motsvarar de extraherade egenskaperna hos talet som projektet har begränsat sig till: respektive tonhöjd, varaktighet och amplitud.

Stilens utveckling i en mening. I #1 ser vi de stavelsegränser som har definierats i extraheringsprocessen. I #2 ser vi en representation av var och en av de tre moduleringarna (amplitud/vikt, teckenavstånd/varaktighet och tonhöjd/baslinjeförskjutning), som appliceras enskilt. I #3 ser vi de kombinerade typografiska moduleringarna i den slutliga utmatningen, som presenterades för 117 deltagare i ett test av systemet.
Eftersom ett enda teckensnitt kan kräva ett extra och separat teckensnitt för variationer som fetstil och kursiv, använde forskarna en Google implementering av det OpenType-baserade teckensnittet Inter, som integrerar en granulär serie vikter i ett enda teckensnitt.

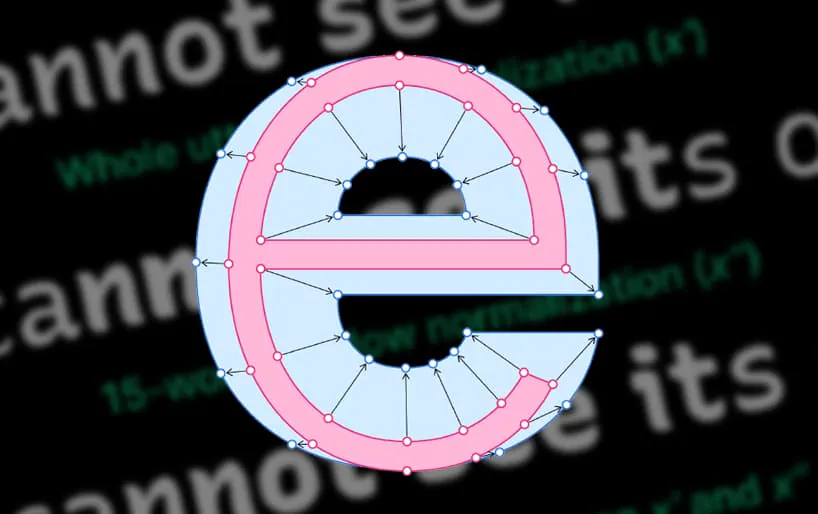
Från artikeln, en graf som visar den utsträckning till vilken en OpenType-glyf från teckensnittet Inter kan uttrycka en serie feta betoningar längs skelettet av den minimala bas-spline.
Testning
Uttrycket av teckenavstånd och baslinjeförskjutning inkorporerades i ett webbläsartillägg, som möjliggjorde tester som genomfördes på 117 deltagare med hörsel.
Dataset för testerna skapades specifikt för projektet, genom att anställa en skådespelare som läste en samling dikter flera gånger med olika betoning på varje tagning, motsvarande de tre egenskaper som projektet studerar. Poesi valdes eftersom det tillåter en rad betoningar (även utöver poetens avsikt) utan att låta konstgjort.
Deltagarna delades in i två grupper. Den första gruppen fick 15 omgångar av skådespelarens läsning av en strof, åtföljd av synkroniserad, animerad och modulerad text, som rullades ut i takt med ljudklippet.
Den andra gruppen fick exakt samma uppgift, men presenterades med statiska bilder av den modulerade texten, som inte ändrades alls under uppspelningen av skådespelarens läsning.
Den genomsnittliga andelen rätta svar var 67 %, ett resultat som inte berodde på slumpen, för den statiska bildgruppen och 63% för den animerade textgruppen. Deltagarnas kommentarer, som forskarna sammanställde efter testerna, bekräftade deras teori att den kognitiva belastningen av dynamisk tolkning kan ha bidragit till de lägre poängerna för de icke-statiska testerna. Men de slags undertextnings- och meddelandesystem som ett sådant ramverk skulle vara avsett för tillhandahåller vanligtvis färdig text som standard.
Deltagarnas kommentarer indikerade också att det finns hårda gränser för användningen av teckenavstånd för att indikera varaktighet, med en kommentar som noterade att när bokstäver är för långt ifrån varandra, blir det svårt att individuera ett ord.
Forskarna noterar också:
‘[Vissa] deltagare kände att modellen borde kunna inkorporera mer nyanserade och komplexa representationer av tal, som den borde göra med en mer varierad och uttrycksfull visuell vokabulär. Medan detta inte är en enkel uppgift, är det ändå uppmuntrande att föreställa sig hur olika tillämpningar av talmodulerad typografi kunde utvecklas när detta nya fält utvecklas.’
Publicerad första gången den 24 februari 2022.