
Andersons vinkel
AI-assisterad objektredigering med Googles Imagic och Runways ‘Erase and Replace’

 Lägg till Unite.AI bland dina föredragna källor på Google

Denna vecka erbjuder två nya, men kontrasterande AI-drivna grafikalgoritmer nya sätt för slutanvändare att göra mycket detaljerade och effektiva förändringar av objekt i foton.
Den första är Imagic, från Google Research, i samarbete med Israels Institut för Teknik och Weizmann Institute of Science. Imagic erbjuder text‑styrd, fin‑granulär redigering av objekt via finjustering av diffusionsmodeller.

Ändra det du vill, och låt resten vara – Imagic lovar granulär redigering av endast de delar du vill förändra. Källa: https://arxiv.org/pdf/2210.09276.pdf
Alla som någonsin har försökt ändra bara ett element i en Stable Diffusion‑omrendering vet alltför väl att för varje lyckad redigering kommer systemet att förändra fem saker som du gillade precis som de var. Det är en brist som för närvarande får många av de mest begåvade SD‑entusiasterna att ständigt hoppa mellan Stable Diffusion och Photoshop för att åtgärda den här typen av ‘kollateralschada’. Enbart ur detta perspektiv verkar Imagics prestationer anmärkningsvärda.
När detta skrivs saknar Imagic ännu en promotionsvideo, och med tanke på Googles försiktiga hållning till att släppa obegränsade bildsyntesverktyg är det osäkert i vilken grad, om någon, vi får möjlighet att testa systemet.
Det andra erbjudandet är Runway ML:s något mer tillgängliga funktion Erase and Replace, en ny funktion i avsnittet ‘AI Magic Tools’ i deras uteslutande online‑svit av maskininlärningsbaserade visuella effektverktyg.
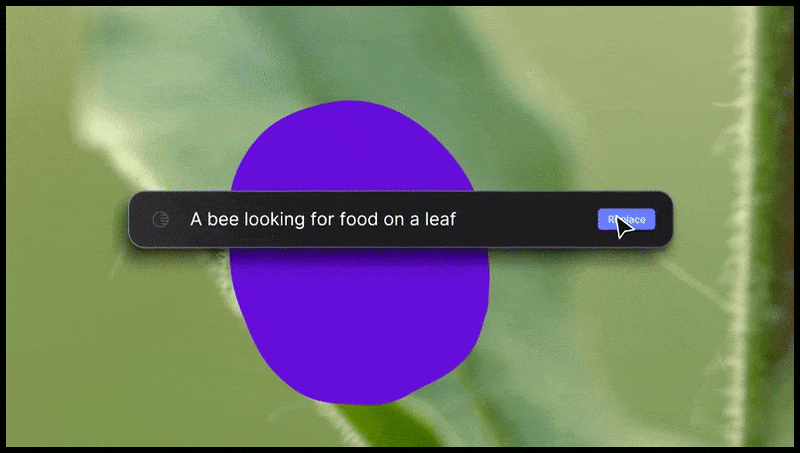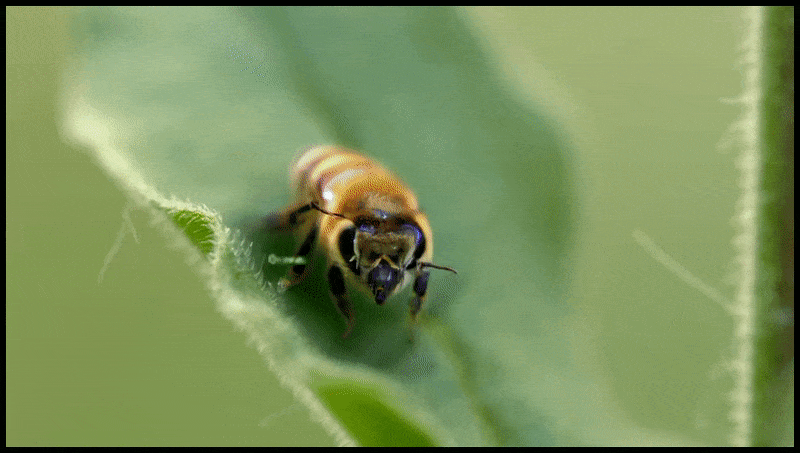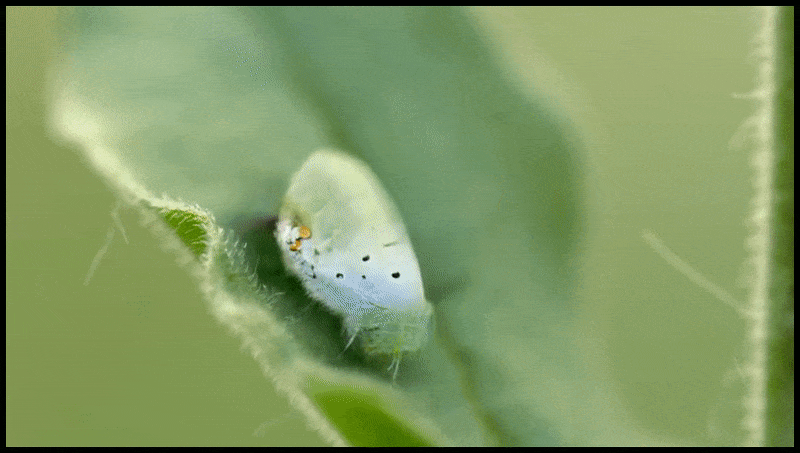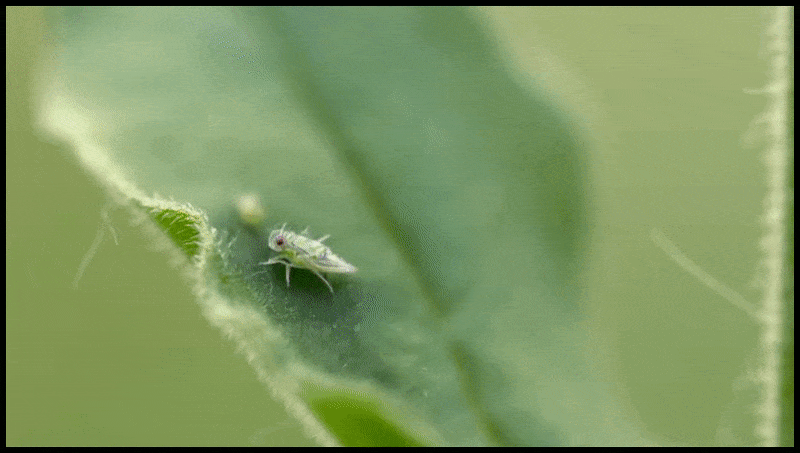
Runway ML:s Erase and Replace-funktion, redan visad i en förhandsvisning av ett text‑till‑video‑redigeringssystem.
Låt oss först titta på Runways lansering.
Radera och Ersätt
Precis som Imagic hanterar Erase and Replace uteslutande stillbilder, men Runway har visat en förhandsvisning av samma funktionalitet i en text‑till‑video‑redigeringslösning som ännu inte släppts:
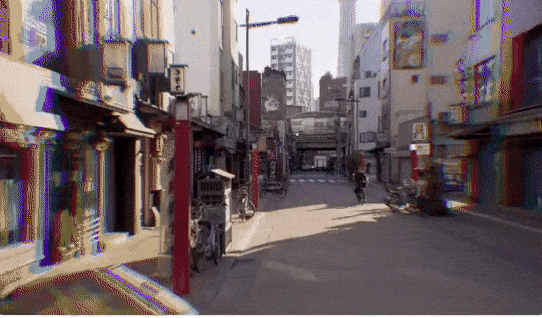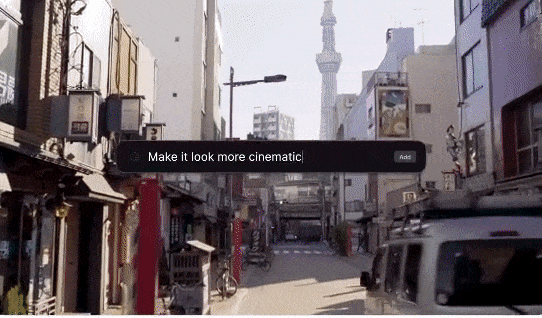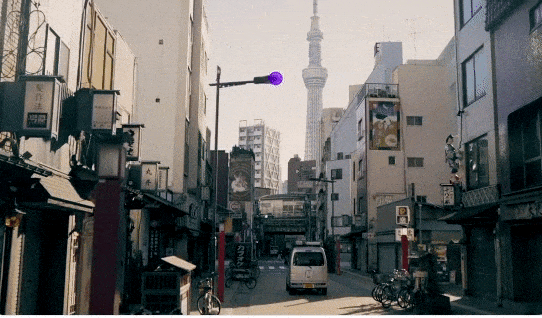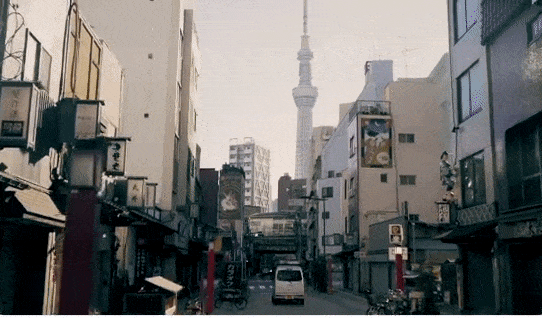
Även om vem som helst kan testa den nya Erase and Replace på bilder, är videoversionen ännu inte offentligt tillgänglig. Källa: https://twitter.com/runwayml/status/1568220303808991232
Även om Runway ML inte har släppt detaljer om teknologierna bakom Erase and Replace, indikerar den hastighet med vilken du kan ersätta en krukväxt med ett rimligt övertygande likställning av Ronald Reagan att en diffusionsmodell som Stable Diffusion (eller, mycket mindre sannolikt, en licensierad DALL‑E 2) är den motor som återskapar det objekt du väljer i Erase and Replace.

Att ersätta en krukväxt med ett likställning av ‘The Gipper’ är inte riktigt lika snabbt som detta, men det är ganska snabbt. Källa: https://app.runwayml.com/
Systemet har vissa DALL‑E 2‑liknande begränsningar – bilder eller text som flaggar Erase and Replace‑filtren kommer att utlösa en varning om möjlig kontosuspension vid ytterligare överträdelser – i praktiken en standardiserad kopia av OpenAIs pågående policyer för DALL‑E 2.
Många av resultaten saknar de typiska grova kanterna hos Stable Diffusion. Runway ML är investerare och forskningspartner i SD, och det är möjligt att de har tränat en proprietär modell som är överlägsen de öppna källkods‑1.4‑checkpoint‑vikterna som resten av oss för närvarande kämpar med (eftersom många andra utvecklingsgrupper, både hobbyister och proffs, för närvarande tränar eller finjusterar Stable Diffusion‑modeller).
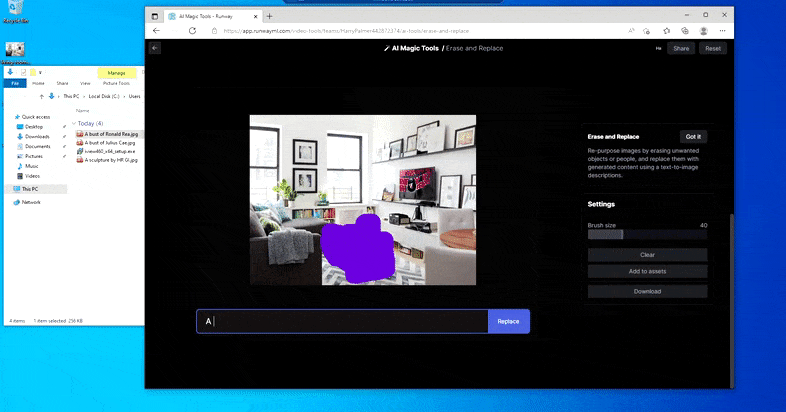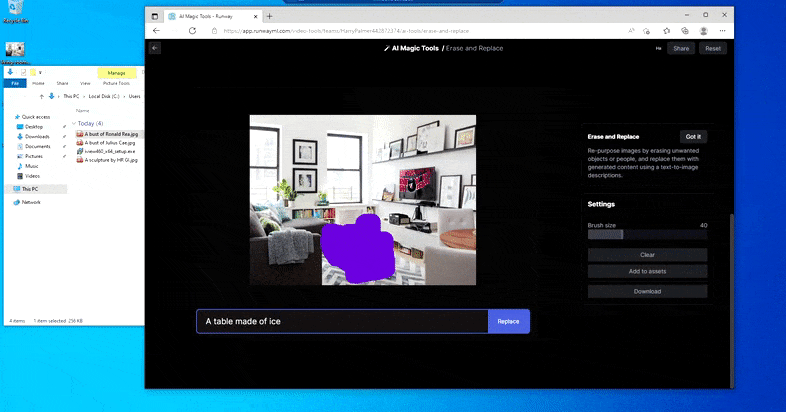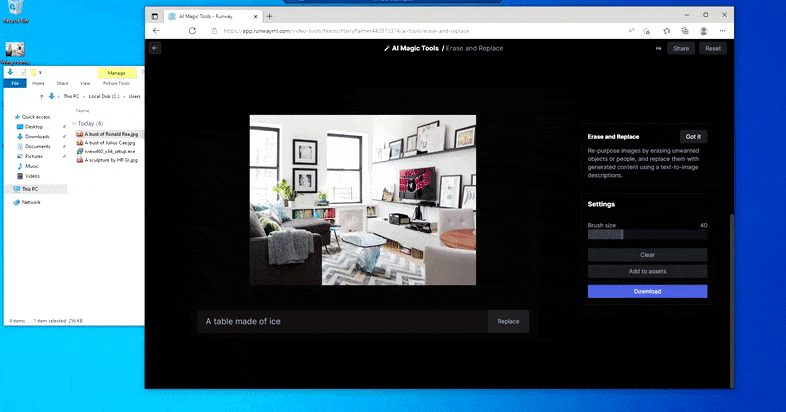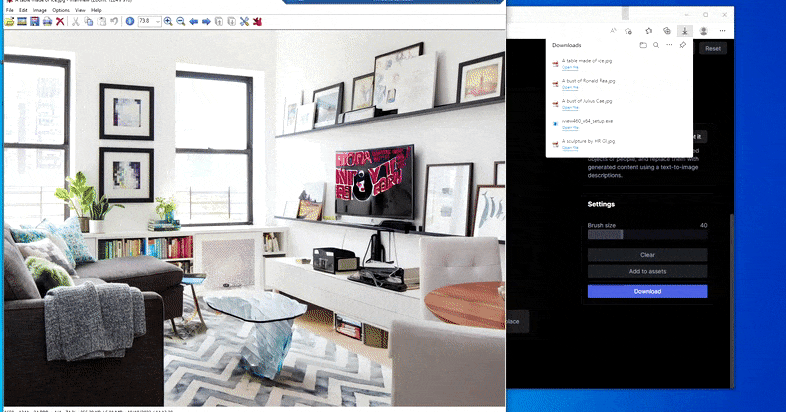
Att ersätta ett hushållsbord med ett ‘bord gjort av is’ i Runway ML:s Erase and Replace.
Precis som med Imagic (se nedan) är Erase and Replace ‘objekt‑orienterad’, så att säga – du kan inte bara radera en ‘tom’ del av bilden och fylla i den med resultatet av ditt textprompt; i det scenariot kommer systemet helt enkelt att spåra det närmaste uppenbara objektet längs maskens synlinje (t.ex. en vägg eller en TV) och applicera transformationen där.
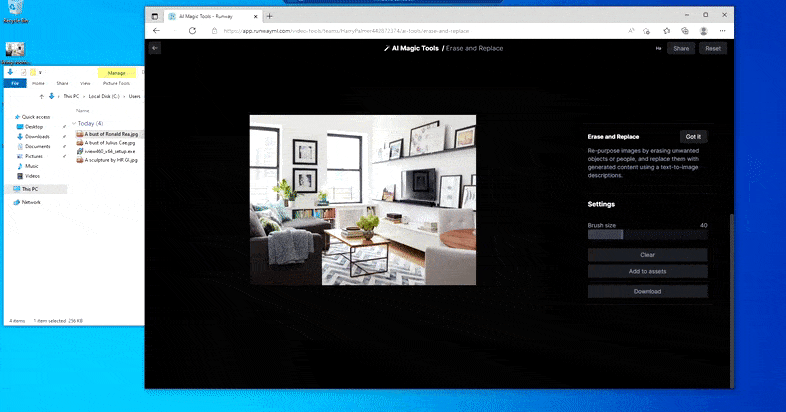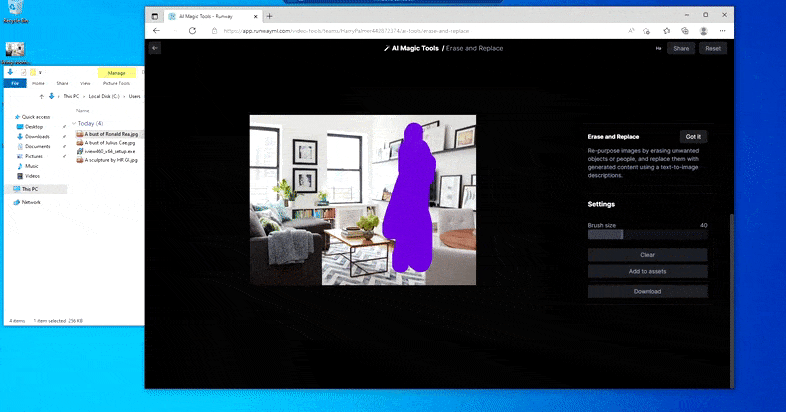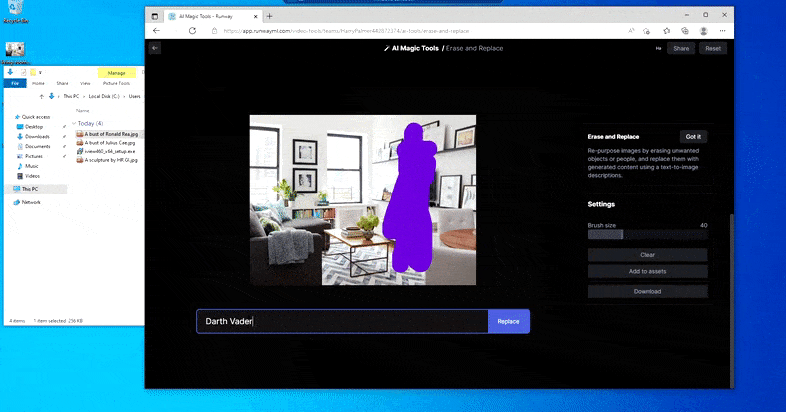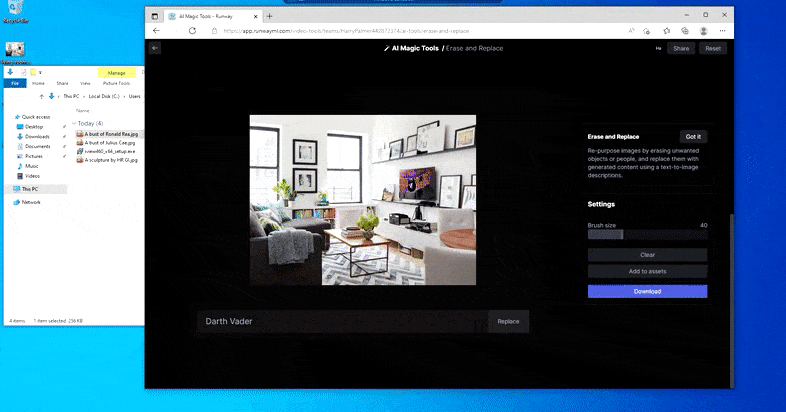
Som namnet antyder kan du inte injicera objekt i tomt utrymme i Erase and Replace. Här resulterar ett försök att åkalla den mest berömda av Sith‑herrarna i ett märkligt Vader‑relaterat mural på TV:n, ungefär där ‘replace’-området ritades.
Det är svårt att avgöra om Erase and Replace undviker att använda upphovsrättsskyddade bilder (som fortfarande i stor utsträckning blockeras, om än med varierande framgång, i DALL‑E 2), eller om modellen som används i bakgrundens renderingsmotor helt enkelt inte är optimerad för den typen av sak.

Den något NSFW‑’Mural of Nicole Kidman’ indikerar att den (troligen) diffusionsbaserade modellen saknar DALL‑E 2:s tidigare systematiska avvisande av att rendera realistiska ansikten eller sexigt innehåll, medan resultaten för försök att återge upphovsrättsskyddade verk varierar från tvetydiga (‘xenomorph’) till absurda (‘the iron throne’). Inskattning nedre högra hörnet, källbilden.
Det vore intressant att veta vilka metoder Erase and Replace använder för att isolera de objekt den kan ersätta. Troligen körs bilden genom någon variant av CLIP, där de enskilda objekten identifieras genom objektigenkänning och efterföljande semantisk segmentering. Ingen av dessa operationer fungerar någorlunda lika bra i en vanlig installation av Stable Diffusion.
Men inget är perfekt – ibland verkar systemet radera utan att ersätta, även när (som vi har sett i bilden ovan) den underliggande renderingsmekanismen definitivt förstår vad ett textprompt betyder. I detta fall är det omöjligt att förvandla ett soffbord till en xenomorph – snarare försvinner bordet helt.
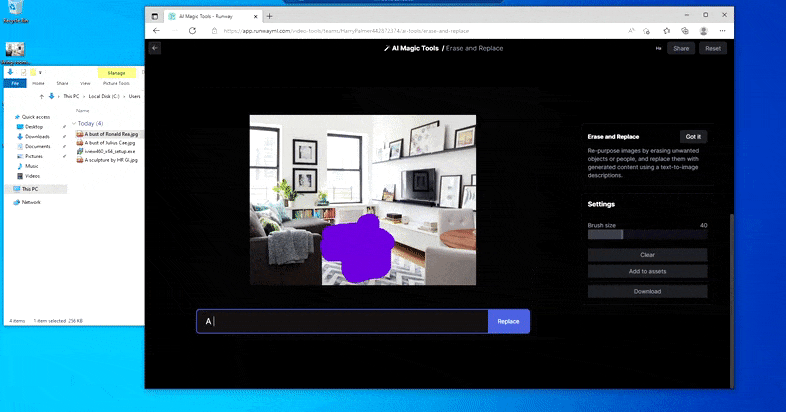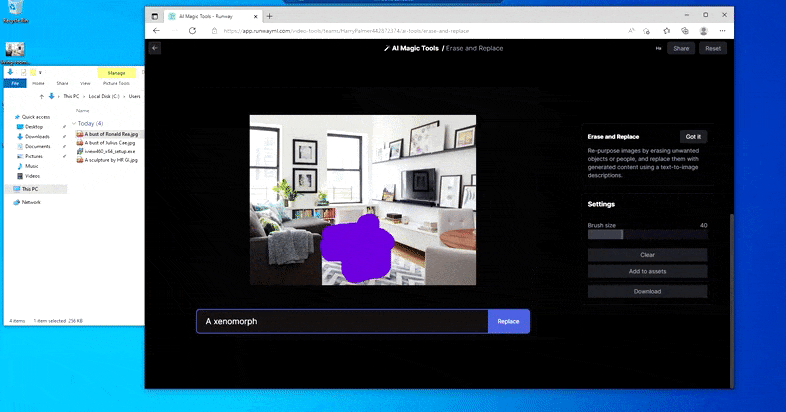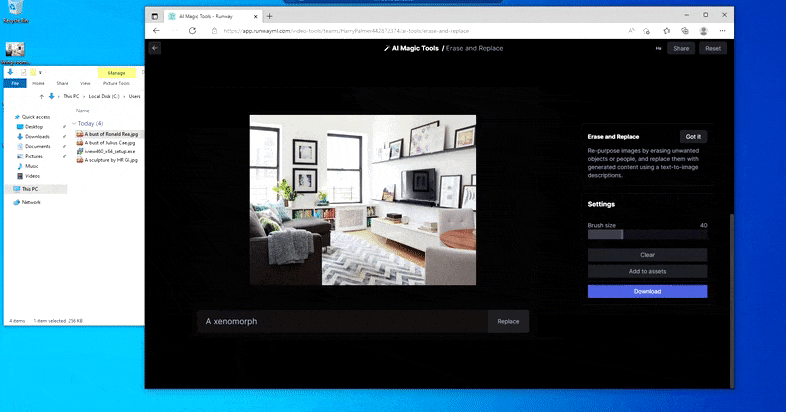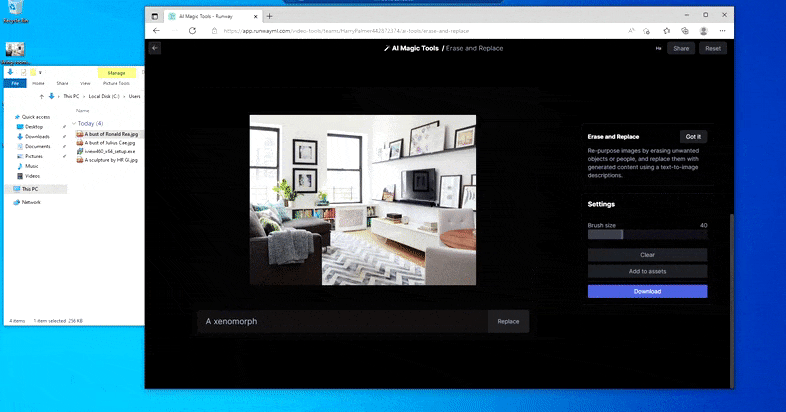
En läskigare version av ‘Var är Waldo’, då Erase and Replace misslyckas med att skapa en alien.
Erase and Replace verkar vara ett effektivt system för objektsubstitution, med utmärkt inpainting. Dock kan det inte redigera befintliga uppfattade objekt, utan bara ersätta dem. Att faktiskt förändra befintligt bildinnehåll utan att kompromissa med omgivande material är sannolikt en mycket svårare uppgift, kopplad till datorsynsforskningens långa kamp mot disentanglement i de olika latenta rummen i de populära ramverken.
Imagic
Det är en uppgift som Imagic adresserar. Det nya papperet erbjuder många exempel på redigeringar som framgångsrikt förändrar enskilda delar av ett foto samtidigt som resten av bilden förblir orörd.

I Imagic lider de redigerade bilderna inte av den karakteristiska sträckningen, förvrängningen och ‘okklusionsgissandet’ som är typiska för deepfake‑dockteater, som använder begränsade förkunskaper hämtade från en enda bild.
Systemet använder en trestegsprocess – optimering av textinbäddning; finjustering av modell; och slutligen generering av den redigerade bilden.

Imagic kodar det önskade textpromptet för att hämta den initiala textinbäddningen och optimerar sedan resultatet för att erhålla indatabilden. Därefter finjusteras den generativa modellen mot källbilden, med tillägg av ett antal parametrar, innan den utsätts för den begärda interpolationen.
Inte förvånande är ramverket baserat på Googles Imagen text‑till‑video‑arkitektur, även om forskarna påstår att systemets principer är brett tillämpliga på latenta diffusionsmodeller.
Imagen använder en tredelad arkitektur, snarare än den sjudelade uppsättningen som används för företagets mer nyliga text‑till‑video‑iteration av mjukvaran. De tre distinkta modulerna består av en generativ diffusionsmodell som arbetar på 64 × 64 px upplösning; en super‑upplösningsmodell som skalar upp detta resultat till 256 × 256 px; och ytterligare en super‑upplösningsmodell som tar resultatet hela vägen upp till 1024 × 1024 px.
Imagic ingriper i det tidigaste steget av denna process, genom att optimera den begärda textinbäddningen i 64 px‑stadiet med en Adam‑optimerare med en statisk inlärningshastighet på 0,0001.

En mästarklass i disentanglement: de slutanvändare som har försökt ändra något så enkelt som färgen på ett renderat objekt i en diffusion, GAN‑ eller NeRF‑modell vet hur betydelsefullt det är att Imagic kan utföra sådana transformationer utan att ‘riva sönder’ konsistensen i resten av bilden.
Finjustering sker sedan på Imagen:s basmodell, i 1500 steg per indatabild, villkorad av den reviderade inbäddningen. Samtidigt optimeras det sekundära 64 px→256 px‑lagret parallellt på den villkorade bilden. Forskarna noterar att en liknande optimering för det sista 256 px→1024 px‑lagret har ‘lite till ingen effekt’ på slutresultaten, och har därför inte implementerat detta.
Papprutet anger att optimeringsprocessen tar ungefär åtta minuter per bild på dubbla TPUV4-chippar. Den slutgiltiga renderingen sker i Imagen‑kärnan under DDIM‑samplingsschemat.
I likhet med liknande finjusteringsprocesser för Googles DreamBooth kan de resulterande inbäddningarna dessutom användas för att driva stilisering, liksom fotorealistiska redigeringar som innehåller information hämtad från den bredare underliggande databasen som driver Imagen (eftersom, som den första kolumnen nedan visar, källbilderna saknar allt nödvändigt innehåll för att genomföra dessa transformationer).

Flexibel fotorealistisk rörelse och redigeringar kan framkallas via Imagic, medan de härledda och disentanglerade koderna som erhålls i processen lika lätt kan användas för stiliserad output.
Forskarna jämförde Imagic med tidigare verk SDEdit, ett GAN‑baserat tillvägagångssätt från 2021, ett samarbete mellan Stanford University och Carnegie Mellon University; samt Text2Live, ett samarbete från april 2022 mellan Weizmann Institute of Science och NVIDIA.

En visuell jämförelse mellan Imagic, SDEdit och Text2Live.
Det är tydligt att de tidigare metoderna har svårigheter, men i den nedre raden, som innebär en massiv förändring av pose, misslyckas de etablerade helt med att omforma källmaterialet, jämfört med Imagic som visar en anmärkningsvärd framgång.
Imagic:s resurskrav och träningstid per bild, även om de är korta enligt standarden för sådana strävanden, gör det osannolikt att den kan inkluderas i en lokal bildredigeringsapplikation på persondatorer – och det är oklart i vilken grad finjusteringsprocessen kan skalas ner till konsumentnivå.
Som det ser ut nu är Imagic ett imponerande erbjudande som är mer lämpat för API:er – en miljö som Google Research, försiktigt med kritik kring underlättande av deepfakes, sannolikt känner sig mest bekväm i.
Först publicerad 18 oktober 2022.


