
Основы ИИ
Что такое отравление данных? Как злоумышленники портят модели ИИ и наборы данных
Отравление данных — это манипулирование данными для обучения, дообучения, оценки или поиска, в результате которого система ИИ усваивает искаженное поведение или выдает результаты, выбранные злоумышленником. В этом руководстве рассматриваются механизм, компромиссы, оценка и меры контроля, имеющие практическое значение.

 Добавьте Unite.AI в избранные источники в Google
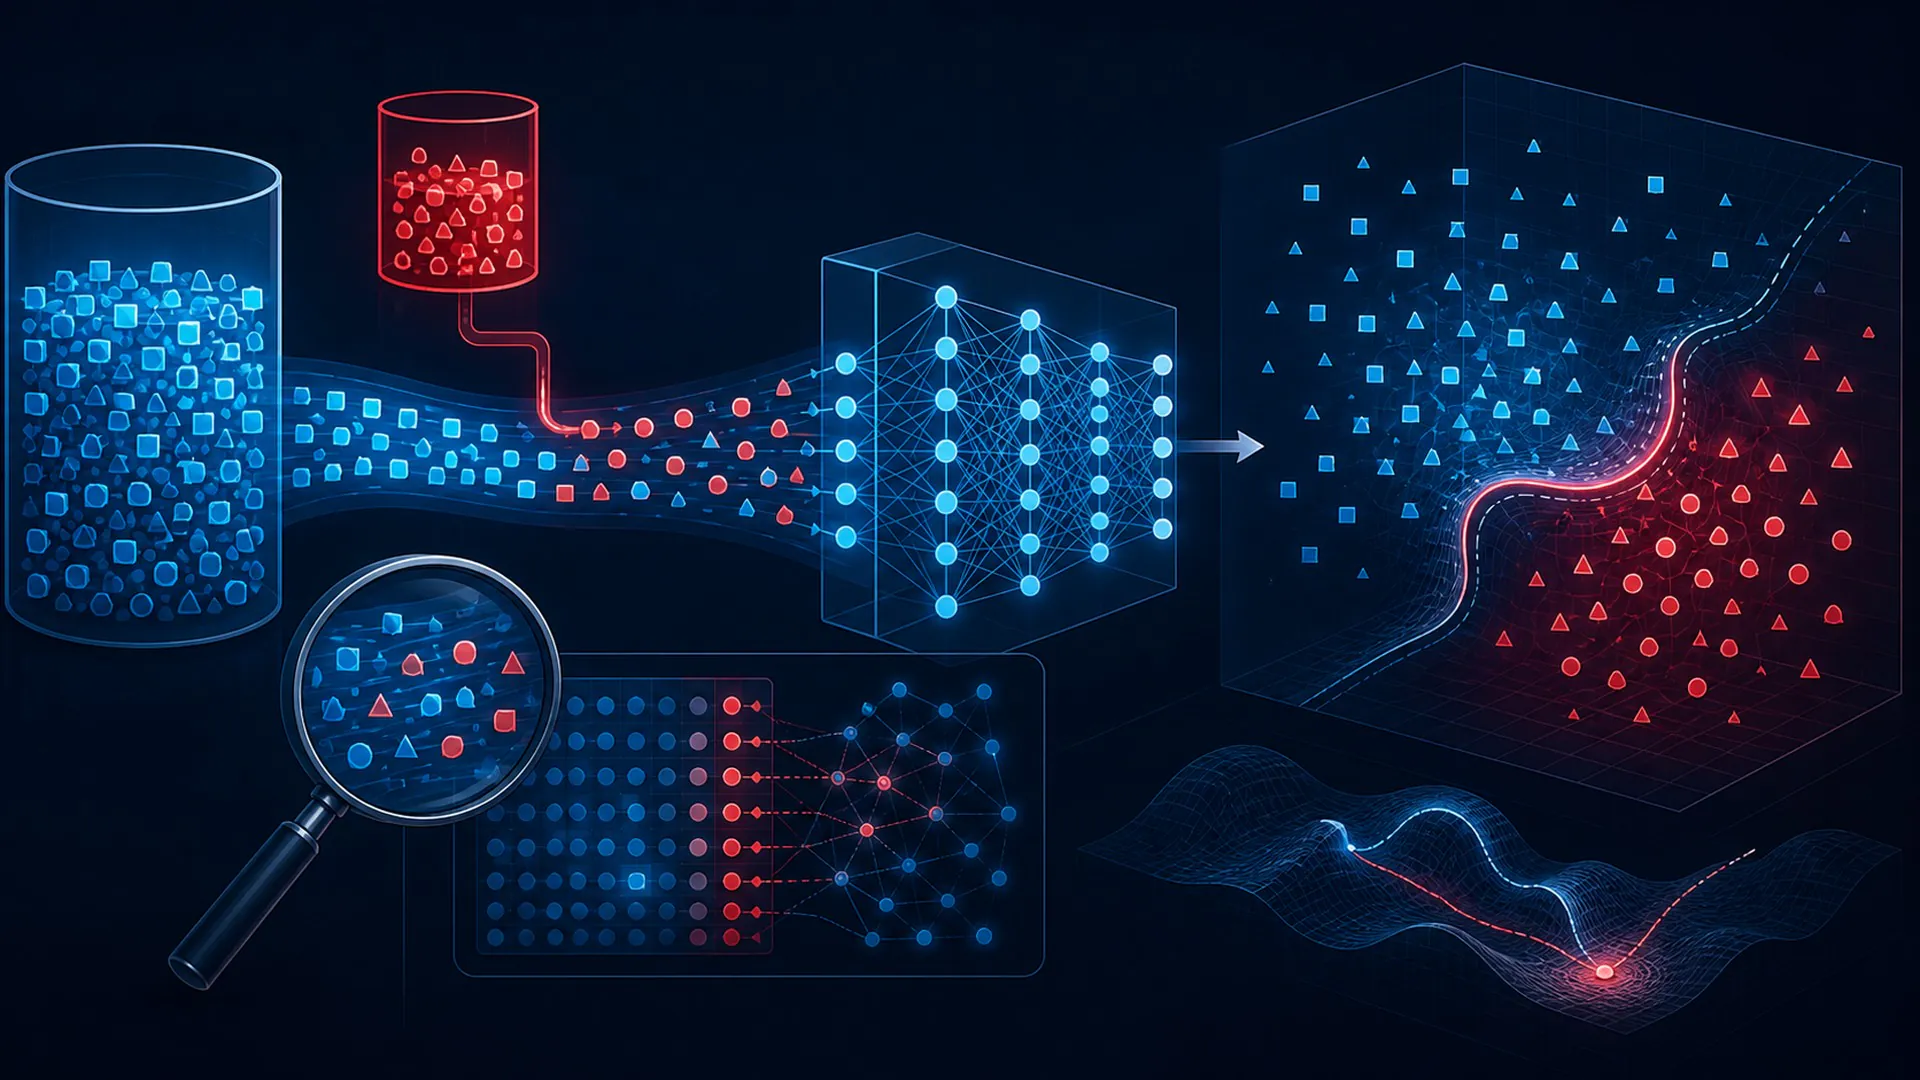
Отравление данных — это манипулирование данными для обучения, дообучения, оценки или поиска, в результате которого система ИИ усваивает искажённое поведение или выдаёт результаты, выбранные злоумышленником.
Отравление данных требует точного объяснения, поскольку это название обозначает конкретный информационный поток, выбор данных для обучения, механизм во время выполнения или границу управления. Если считать его синонимом «передового ИИ», утверждения невозможно проверить. В этом руководстве мы проследим путь отравления данных от входных данных и исходных допущений до наблюдаемого результата, а затем проверим, не подменяют ли его понятием, которое чаще всего с ним путают.
Отравление данных: определение, границы и цель
Отравление данных — это манипулирование данными для обучения, дообучения, оценки или поиска, в результате которого система ИИ усваивает искажённое поведение или выдаёт результаты, выбранные злоумышленником. Это определение включает три практических условия: должен существовать идентифицируемый вход, преобразование или решение, характерное для отравления данных, и результат, который можно оценить в соответствии с заявленной целью. Если хотя бы одного из этих элементов нет, это понятие может описывать желаемый результат, а не реализованный механизм.
Надёжность ИИ должна подтверждаться данными на всех этапах жизненного цикла. Мера контроля имеет смысл, только если чётко определены ответственный за неё, область действия, условия срабатывания, ожидаемое поведение и способ проверки. При отравлении данных такой системный взгляд важен, поскольку на результаты могут влиять окружающие данные, интерфейсы, оборудование, разрешения и люди, даже если сама модель не меняется. Поэтому полезно отделять усвоенное моделью поведение от продукта, который определяет, когда, где и с какими полномочиями оно применяется.
Ближайшая по смыслу, но вводящая в заблуждение подмена — это атака уклонения, применяемая только после развёртывания модели. У неё может быть заметный общий признак с отравлением данных, но причинно-следственная картина при этом меняется: успех подтверждают другие свидетельства, на затраты влияют другие ресурсы, а для предотвращения вреда нужны другие меры контроля. Поэтому граница здесь определяется практическим действием, а не терминологией.
Пять этапов отравления данных
Диаграмма представляет собой краткую причинно-следственную схему отравления данных, а не утверждение, что в каждой реализации используются пять программных компонентов. В одних системах несколько этапов объединены, в других они повторяются циклически. Эта схема полезна тем, что позволяет проследить для каждого изменения информации или полномочий, кто за него отвечает, каковы его входные и выходные данные и каким тестом его можно проверить.
1. Получить влияние на источник данных: входные данные и исходные допущения при отравлении данных
На этом этапе отравления данных система должна получить влияние на источник данных. Важно не просто выяснить, происходит ли это действие, а определить, какую информацию оно использует, какое состояние меняет и какие свидетельства подтверждают правомерность этого изменения. Проверяющий должен иметь возможность отличить это действие от атаки уклонения, применяемой только после развёртывания модели, и воспроизвести его результат при тех же заявленных условиях.
Передача данных на этот этап отравления данных начинается с заявленной цели и должна завершиться результатом, который позволит добавить неверно размеченные, предвзятые или содержащие триггеры примеры. Фиксируйте неопределённость, отвергнутые альтернативы, использованные ресурсы, а также любые меры контроля со стороны человека или программного обеспечения, применённые на этом этапе. По этой записи команды могут определить, можно ли не заметить небольшую целевую подвыборку среди огромного объёма веб-данных, прежде чем та же уязвимость приведёт к значимым последствиям.
2. Добавить неверно размеченные, предвзятые или содержащие триггеры примеры: представление данных или принятие решений при отравлении данных
На этом этапе отравления данных система должна добавить неверно размеченные, предвзятые или содержащие триггеры примеры. Важно не просто выяснить, происходит ли это действие, а определить, какую информацию оно использует, какое состояние меняет и какие свидетельства подтверждают правомерность этого изменения. Проверяющий должен иметь возможность отличить это действие от атаки уклонения, применяемой только после развёртывания модели, и воспроизвести его результат при тех же заявленных условиях.
Передача данных на этот этап отравления данных начинается с получения влияния на источник данных и должна завершиться результатом, который позволит пройти фильтрацию и удаление дубликатов. Фиксируйте неопределённость, отвергнутые альтернативы, использованные ресурсы, а также любые меры контроля со стороны человека или программного обеспечения, применённые на этом этапе. По этой записи команды могут определить, можно ли не заметить небольшую целевую подвыборку среди огромного объёма веб-данных, прежде чем та же уязвимость приведёт к значимым последствиям.
3. Пройти фильтрацию и дедупликацию: отличительное преобразование при отравлении данных
На этом этапе отравления данных система должна пройти фильтрацию и дедупликацию. Важно не просто выяснить, происходит ли эта операция, но и понять, какие данные она использует, какое состояние изменяет и какие свидетельства подтверждают обоснованность этого изменения. Рецензент должен уметь отличить эту операцию от атаки уклонения, применяемой только после развертывания модели, и воспроизвести ее результат в тех же заявленных условиях.
Переход к этому этапу отравления данных начинается с добавления ошибочно размеченных, предвзятых или содержащих триггер примеров и должен завершаться результатом, позволяющим изменить обученную модель или извлекаемый контекст. Фиксируйте неопределенность, отвергнутые альтернативы, использованные ресурсы, а также любые меры контроля со стороны человека или программного обеспечения на этом этапе. Такая запись помогает командам выявить, может ли небольшую целевую подвыборку быть трудно обнаружить в данных веб-масштаба, прежде чем та же уязвимость приведет к значимому результату.
4. Изменить обученную модель или извлекаемый контекст: ограничения и проверка на этапе отравления данных
На этом этапе отравления данных система должна изменить обученную модель или извлекаемый контекст. Важно не просто выяснить, происходит ли эта операция, но и понять, какие данные она использует, какое состояние изменяет и какие свидетельства подтверждают обоснованность этого изменения. Рецензент должен уметь отличить эту операцию от атаки уклонения, применяемой только после развертывания модели, и воспроизвести ее результат в тех же заявленных условиях.
Переход к этому этапу отравления данных начинается с прохождения фильтрации и дедупликации и должен завершаться результатом, позволяющим вызвать широкое ухудшение качества или активировать целевой бэкдор. Фиксируйте неопределенность, отвергнутые альтернативы, использованные ресурсы, а также любые меры контроля со стороны человека или программного обеспечения на этом этапе. Такая запись помогает командам выявить, может ли небольшую целевую подвыборку быть трудно обнаружить в данных веб-масштаба, прежде чем та же уязвимость приведет к значимому результату.
5. Вызвать широкое ухудшение качества или активировать целевой бэкдор: результат, обратная связь и правило остановки при отравлении данных
На этом этапе отравления данных система должна вызвать широкое ухудшение качества или активировать целевой бэкдор. Важно не просто выяснить, происходит ли эта операция, но и понять, какие данные она использует, какое состояние изменяет и какие свидетельства подтверждают обоснованность этого изменения. Рецензент должен уметь отличить эту операцию от атаки уклонения, применяемой только после развертывания модели, и воспроизвести ее результат в тех же заявленных условиях.
Переход к этому этапу отравления данных начинается с изменения обученной модели или извлекаемого контекста и должен завершаться результатом, который можно использовать для мониторинга или принятия окончательного решения. Фиксируйте неопределенность, отвергнутые альтернативы, использованные ресурсы, а также любые меры контроля со стороны человека или программного обеспечения на этом этапе. Такая запись помогает командам выявить, может ли небольшую целевую подвыборку быть трудно обнаружить в данных веб-масштаба, прежде чем та же уязвимость приведет к значимому результату.
Изучайте схему отравления данных в прямом направлении, чтобы понять, как она работает в производственной среде, и в обратном — чтобы диагностировать сбои. При прямом анализе выясняют, как один этап обеспечивает следующий. Обратный анализ начинают с неправильного, медленного, дорогостоящего или небезопасного результата и прослеживают, какое предшествующее допущение к нему привело. Именно при обратном анализе команда часто обнаруживает, что решающая ошибка произошла еще до того, как модель что-либо выдала.
Пример отравления данных с разбором
Злоумышленник может добавить примеры, которые научат классификатор присваивать редкому визуальному фрагменту доверенную метку.
Этот пример полезен, поскольку отравление данных можно оценить по наблюдаемым входным данным, промежуточным состояниям и результату, а не по эффектной демонстрации. Строгая проверка должна включать обычные, сложные и намеренно вводящие в заблуждение случаи, связанные с этим сценарием; сохранять базовый вариант без данной техники; а также фиксировать и среднюю производительность, и серьезность отдельных сбоев.
Измените одно допущение в примере отравления данных и повторите анализ. Уберите обязательный входной сигнал, добавьте противоречащий сигнал, ограничьте вычислительные ресурсы, измените состав пользователей или заставьте систему воздержаться от ответа. Если механизм работает только в одной тщательно подготовленной демонстрации, это еще не доказывает, что он применим в реальных условиях эксплуатации.
Отравление данных и его самое распространенное упрощение
Отравление данных часто сводят к атаке уклонения, применяемой только после развертывания модели. Такое упрощение устраняет границу, которая и определяет это понятие. Из-за этого покупатели могут сравнивать несопоставимые продукты, исследователи — преувеличивать значимость результатов эксперимента, а операторы — отслеживать после развертывания не тот сигнал.
| Аспект | Практический ответ |
|---|---|
| Определение | Отравление данных — это манипулирование данными для обучения, дообучения, оценки или поиска, в результате которого система ИИ усваивает искажённое поведение или выдаёт результаты, выбранные злоумышленником. |
| Путаница | атака уклонения, применяемая только после развёртывания модели. |
| Риск | крошечную целевую подвыборку может быть трудно обнаружить в данных веб-масштаба. |
В сравнении также следует определить единицу анализа. В статье об отравлении данных может рассматриваться отдельная модель или алгоритм, тогда как развёрнутый сервис включает поиск, маршрутизацию, кэширование, политики, управление идентификацией, пользовательские интерфейсы и мониторинг. Два продукта могут использовать один и тот же термин в заголовке, но реализовывать разные компоненты этого стека. Следует выяснить, какой компонент выполняет определяющее преобразование и какие другие компоненты необходимы для получения заявленного результата.
Почему отравление данных важно для современных систем ИИ
Отравление данных важно сейчас, потому что системам ИИ предоставляют более обширный контекст, больше модальностей, больше вычислительных ресурсов во время работы, более широкий доступ к инструментам и более тесную интеграцию с процессами принятия решений в организациях. В таких условиях то, что раньше казалось деталью исследования, может определять задержку, безопасность, доступность, экологические издержки, качество продукта или юридическую ответственность.
Важно не то, может ли отравление данных дать один впечатляющий результат. Важно, улучшает ли этот метод значимый результат в репрезентативных условиях и эффективнее ли он более простого базового решения. Вместо того чтобы сводить все результаты к одному среднему значению, следует приводить распределения, категории ошибок, задержку на верхних процентилях, расход ресурсов и данные по затронутым подгруппам.
Отслеживайте как технические показатели, так и влияние на людей. Документируйте неопределённость, сохраняйте сведения о происхождении данных и моделей, предусматривайте возможность эскалации и разрабатывайте план восстановления до того, как система столкнётся с меняющимися условиями реального мира. Применительно к отравлению данных такая дисциплина делает результаты применимыми в других условиях: другая команда сможет оценить, сохранится ли заявленный выигрыш при использовании другой модели, языка, аппаратной платформы, набора данных, пользовательской группы или уровня допустимого риска.
Какие преимущества может дать отравление данных
Главный аргумент в пользу применения отравления данных состоит в том, что этот метод может напрямую устранить узкое место, на которое он нацелен. В зависимости от реализации преимущества могут выражаться в более точной опоре на источники, более достоверном представлении, лучшей способности к обобщению, меньшей задержке, сокращении перемещения данных в памяти, более чёткой подотчётности или более безопасном разграничении между предложением модели и реальным действием.
Преимущества следует описывать через решения и измеримые показатели. «Больше интеллекта» — не критерий приемки отравления данных. Полезная целевая метрика может задавать частоту ошибок на сложных примерах, восстановление после противоречивых свидетельств, затраты на заданном процентиле запросов, время проверки человеком, калибровку или долю действий, остающихся в пределах установленного лимита полномочий.
Сбой, определяющий отравление данных
Главное ограничение состоит в том, что крошечную целевую подвыборку может быть трудно обнаружить в данных веб-масштаба. Об этой проблеме нельзя вспоминать лишь под конец разработки. Она должна с самого начала определять сбор данных, архитектуру, разрешения, оценку, условия выпуска и мониторинг системы отравления данных.
Мера контроля отравления данных полезна лишь в том случае, если она срабатывает до того, как возникнут серьёзные или необратимые последствия. Определите самый ранний наблюдаемый признак сбоя, задайте пороговое значение или правило, назначьте ответственного и проверьте возможность восстановления. В зависимости от сценария применения восстановление может означать отказ от ответа, переход на более простую систему, запрос дополнительных свидетельств, передачу вопроса специалисту, откат модели или полный отказ от выполнения действия.
План оценки отравления данных
Начните оценку отравления данных с формулировки решения, которое должны обосновать имеющиеся данные. Определите целевую совокупность пользователей или объектов, последствия ошибочного результата, информацию, действительно доступную на момент принятия решения, и простейшую заслуживающую доверия альтернативу. Это не позволит превратить бенчмарк в самоцель лишь потому, что его легко запустить.
Используйте нетронутый тестовый набор для контролируемых сравнений, а затем проверяйте отравление данных в поэтапно вводимой в эксплуатацию среде. Офлайн-оценка позволяет сопоставлять варианты; теневой режим, канареечные развертывания, ограничения частоты запросов или этапы утверждения показывают, как реальный трафик, петли обратной связи и люди меняют поведение. На этапе развертывания следует заранее установить четкое условие остановки, а не считать, что любое улучшение заслуживает полномасштабного внедрения.
Фиксируйте версии входных данных, необходимых для воспроизведения отравления данных: исходные данные, этап предварительной обработки, токенизатор или энкодер, веса модели, конфигурацию, запрос или политику, индекс для поиска, набор для оценки, допущения относительно аппаратного обеспечения и код обслуживания модели — в зависимости от того, что применимо. Без отслеживания происхождения данных команда не сможет определить, вызвано ли изменение результата примененной методикой, средой или незамеченной правкой конвейера обработки.
Наконец, спросите себя, какое наблюдение опровергло бы утверждение о том, что отравление данных приносит пользу. Если никакой результат не может изменить решение о внедрении, оценка превращается в маркетинг. Заранее установленные пороговые значения приемки и сохраненный контрольный набор превращают такую проверку в получение доказательств.
Что спросить перед внедрением отравления данных
- Цель: Какое измеримое узкое место призвано устранить отравление данных?
- Механизм: На каком из пяти этапов происходит характерное преобразование?
- Базовый вариант: Как этот подход соотносится с атакой уклонения, применяемой только после развертывания модели, или с другой, более простой альтернативой?
- Доказательства: Какие типичные, сложные, состязательные случаи и случаи для отдельных подгрупп проверялись?
- Эксплуатация: Какие затраты на задержку, память, вычисления, энергию, обслуживание и проверку возникают при масштабировании?
- Риск: Как команда обнаружит, что небольшую целевую выборку может быть трудно выявить в данных масштаба интернета?
- Восстановление: Может ли система воздержаться от ответа, перейти к запасному варианту, откатить изменения или передать вопрос специалисту до того, как будет причинен вред?
Основные источники для изучения отравления данных
Авторитетные отправные точки для изучения той части стека ИИ, которая связана с отравлением данных, — это структура управления рисками ИИ NIST, спецификации C2PA и структура конфиденциальности NIST. Изучайте их вместе с документацией по конкретной модели, набору данных, аппаратному обеспечению и применимой юрисдикции. Общий источник может описать механизм, но установить пригодность конкретной реализации позволяют только данные, полученные в условиях ее развертывания.
Что важно помнить об отравлении данных
Отравление данных — определенный механизм в рамках более широкой социотехнической системы. Его ценность заключается в улучшении конкретного результата при явно заданных условиях, а не в самом названии. Карта из пяти этапов делает видимым поток информации, сравнение показывает, чем этот механизм не является, а схема управления указывает, где ответственный оператор может вмешаться.
Практическое правило при работе с отравлением данных: определить цель, сравнить подход с заслуживающим доверия базовым вариантом, проверить наиболее значимый сбой и сохранить доказательства, необходимые для отслеживания изменений. При наличии этих составляющих концепцию можно оценить как инженерное решение и вариант управления. Без них это лишь многообещающее название, связанное с неизвестным эксплуатационным риском.



