
Взгляд Anderson
Удаление объектов из видео более эффективно с помощью машинного обучения

 Добавьте Unite.AI в избранные источники в Google
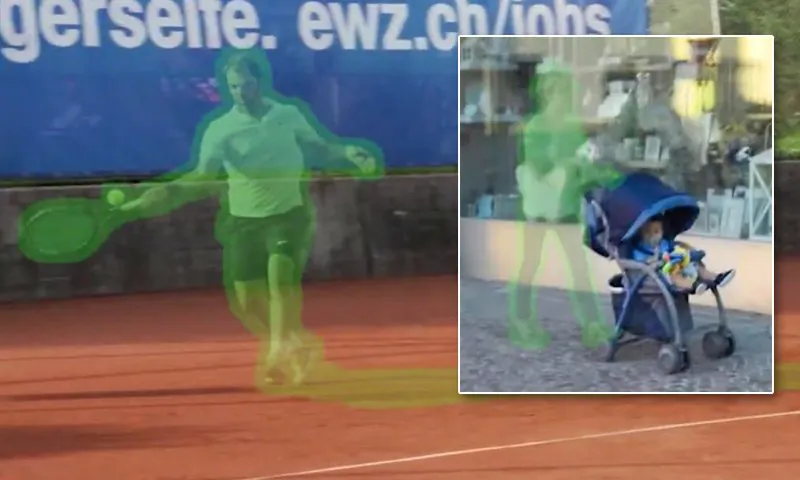
Новые исследования из Китая сообщают о результатах, соответствующих современным стандартам, а также о впечатляющем улучшении эффективности для новой системы видеоинпейтинга, которая может умело удалять объекты из видеозаписей.
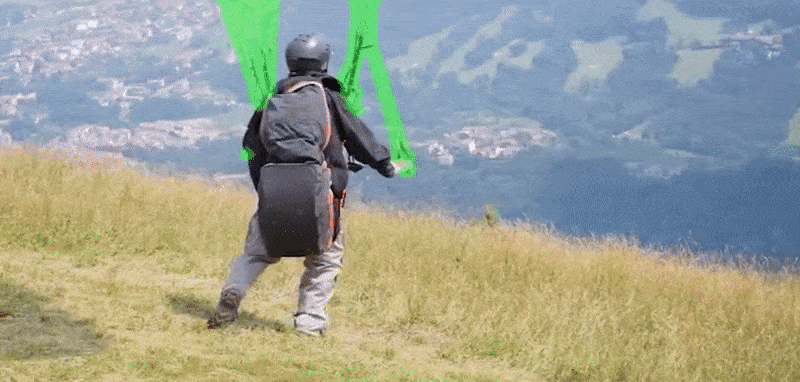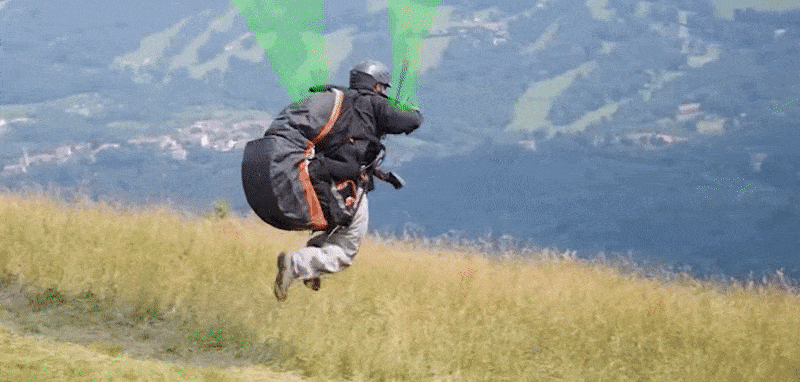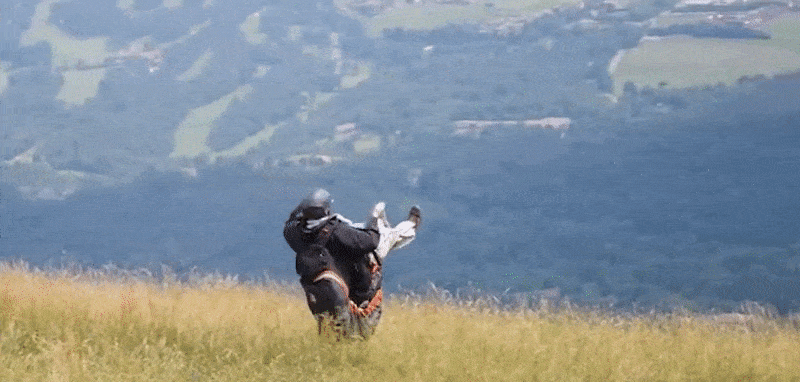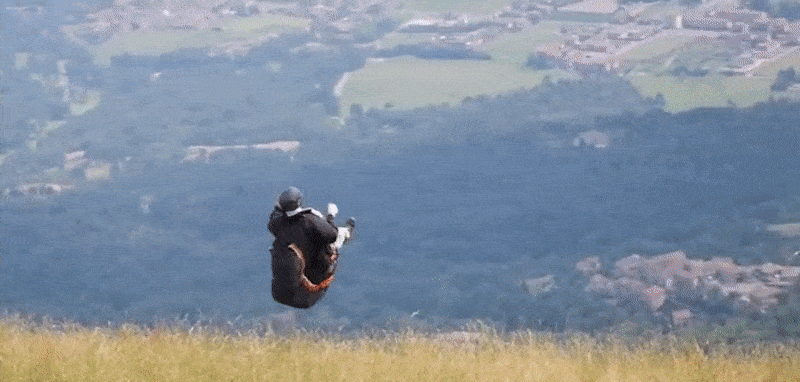
Устройство для полета на дельтаплане удалено новым методом. Смотрите исходное видео для лучшего разрешения и больше примеров. Источник: https://www.youtube.com/watch?v=N–qC3T2wc4
Эта техника, называемая рамкой End-to-End для Flow-Guided видеоинпейтинга (E2FGVI), также способна удалять водяные знаки и различные другие виды заслонения из видеоконтента.
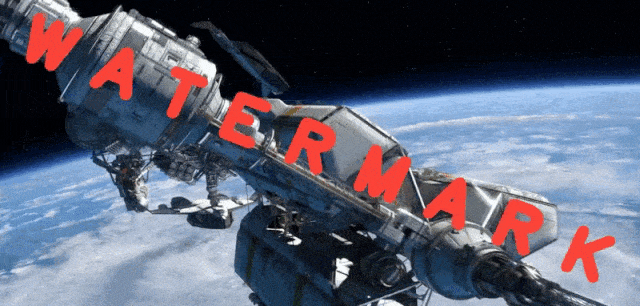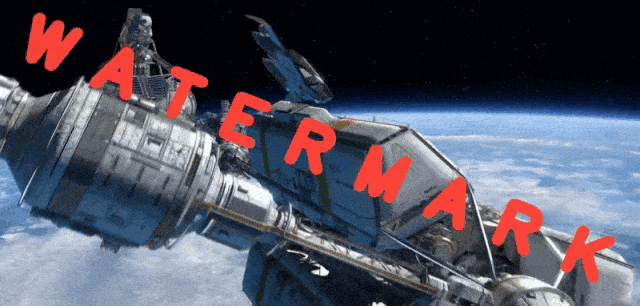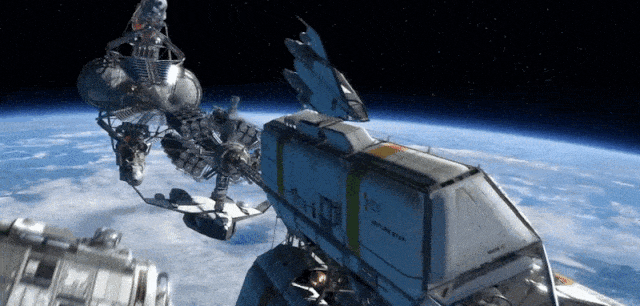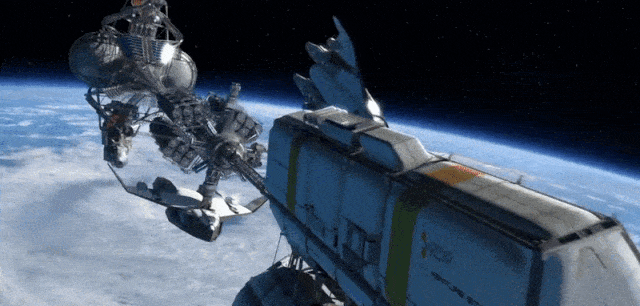
E2FGVI рассчитывает прогнозы для содержимого, которое находится за заслонениями, что позволяет удалять даже заметные и трудноудалимые водяные знаки. Источник: https://github.com/MCG-NKU/E2FGVI
(Чтобы увидеть больше примеров в лучшем разрешении, посмотрите видео)
Хотя модель, представленная в опубликованной статье, была обучена на видео размером 432px x 240px (обычно низкие размеры входных данных, ограниченные доступным пространством GPU по сравнению с оптимальными размерами пакетов и другими факторами), авторы с тех пор выпустили E2FGVI-HQ, который может обрабатывать видео любого разрешения.
Код для текущей версии доступен на GitHub, а версия HQ, выпущенная в прошлое воскресенье, может быть загружена с Google Drive и Baidu Disk.

Ребенок остается на картинке.
E2FGVI может обрабатывать видео 432×240 за 0,12 секунды на кадр на GPU Titan XP (12GB VRAM), и авторы сообщают, что система работает в пятнадцать раз быстрее, чем предыдущие методы, основанные на оптическом потоке.
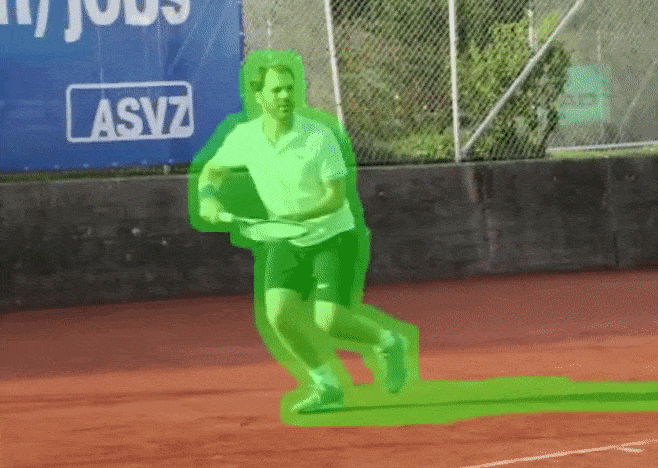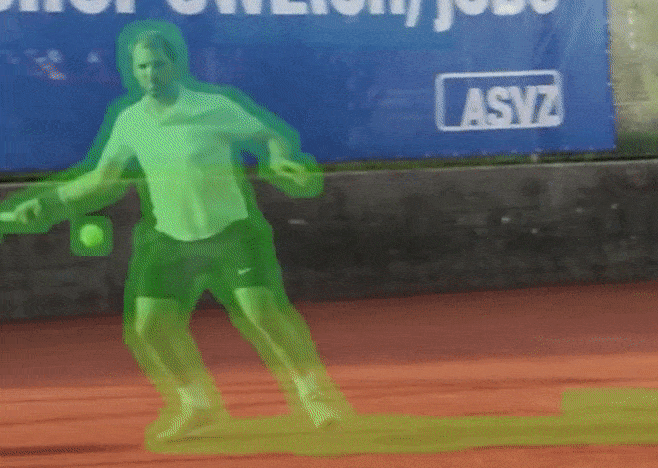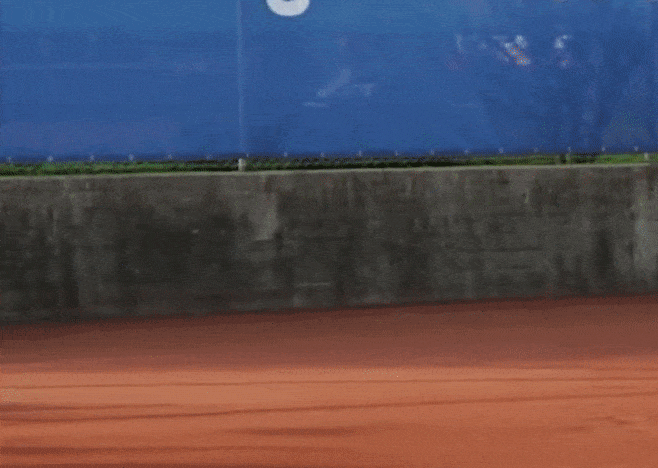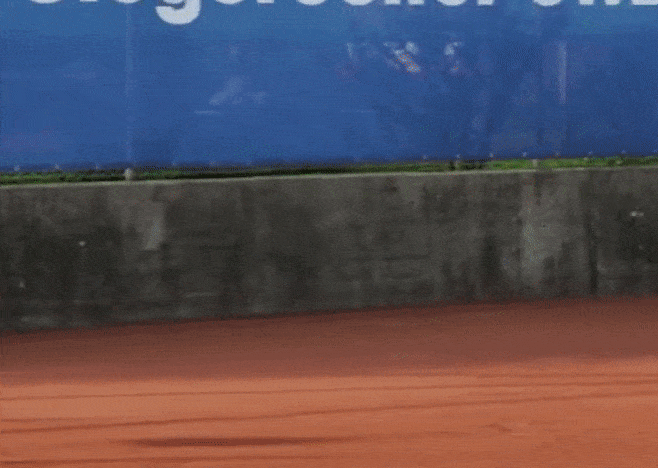
Теннисист делает неожиданный выход.
Тестирование на стандартных наборах данных для этого подsectorа исследований синтеза изображений показало, что новый метод смог превзойти своих соперников как в качественной, так и в количественной оценке.

Тесты против предыдущих подходов. Источник: https://arxiv.org/pdf/2204.02663.pdf
Статья называется К рамке End-to-End для Flow-Guided видеоинпейтинга и является совместной работой четырех исследователей из Нанкинского университета, вместе с исследователем из Hisilicon Technologies.
Что не хватает в этой картине
Помимо очевидных применений для визуальных эффектов, высококачественная видеоинпейтинг должна стать основной определяющей функцией новых технологий синтеза и изменения изображений на основе ИИ.
Это особенно актуально для приложений в области моды, изменяющих тело, и других рамок, которые пытаются ‘сделать более стройным’ или иным образом изменить сцены в изображениях и видео. В таких случаях необходимо убедительно ‘заполнить’ дополнительный фон, который открывается синтезом.

Из недавней статьи, алгоритм ‘перестройки’ тела задача состоит в том, чтобы заполнить новый фон, когда субъект изменен в размере. Здесь этот недостаток представлен красной границей, которую занимал (в реальной жизни, смотрите изображение слева) человек с более полной фигурой. Основано на исходном материале из https://arxiv.org/pdf/2203.10496.pdf
Коherentный оптический поток
Оптический поток (OF) стал основной технологией в разработке удаления объектов из видео. Как атлас, OF предоставляет карту временной последовательности. Часто используемый для измерения скорости в инициативах компьютерного зрения, OF также может обеспечить временно последовательную инпейтинг, где сумма задачи может быть рассмотрена в одном проходе, вместо ‘кадр за кадром’, что неизбежно приводит к временной не连续ности.
Методы видеоинпейтинга до сих пор были сосредоточены на трехэтапном процессе: завершение потока, где видео по сути отображается в дискретную и исследуемую сущность; пропагация пикселей, где дыры в ‘поврежденных’ видео заполняются путем двусторонней пропагации пикселей; и галлюцинация контента (изобретение пикселей, знакомое нам из глубоких фейков и текст-изображение рамок, таких как серия DALL-E) где оцененное ‘пропавшее’ содержимое изобретается и вставляется в видео.
Центральное нововведение E2FGVI заключается в объединении этих трех этапов в рамку End-to-End, исключая необходимость ручных операций над содержимым или процессом.

Статья отмечает, что необходимость ручного вмешательства требует, чтобы старые процессы не использовали GPU, что делает их довольно длительными. Из статьи*:
‘Взяв DFVI как пример, завершение одного видео размером 432 × 240 из DAVIS, которое содержит около 70 кадров, требует около 4 минут, что является неприемлемым в большинстве реальных приложений. Кроме того, кроме вышеупомянутых недостатков, использование только предварительно обученной сети инпейтинга изображений на этапе галлюцинации контента игнорирует отношения между содержимым во временных соседях, что приводит к не последовательному сгенерированному содержимому в видео.’
Объединив три этапа видеоинпейтинга, E2FGVI может заменить второй этап, пропагацию пикселей, на пропагацию функций. В более сегментированных процессах предыдущих работ функции не так широко доступны, потому что каждый этап относительно герметичен, и рабочий процесс только полуавтоматизирован.
Кроме того, исследователи разработали временной фокальный трансформер для этапа галлюцинации контента, который учитывает не только прямых соседей пикселей в текущем кадре (т.е. что происходит в этой части кадра в предыдущем или следующем изображении), но также отдаленных соседей, которые находятся вдалеке и будут влиять на сплоченный эффект любых операций, выполняемых над видео в целом.

Архитектура E2FGVI.
Новая функциональная центральная часть рабочего процесса может использовать больше функциональных процессов и обучаемых смещений выборки, а новый фокальный трансформер проекта, по словам авторов, расширяет размер фокальных окон ‘от 2D до 3D’.
Тесты и данные
Чтобы протестировать E2FGVI, исследователи оценили систему против двух популярных наборов данных для видеообъектного разделения: YouTube-VOS и DAVIS. YouTube-VOS содержит 3741 обучающий видеоклип, 474 validaционных клипа и 508 тестовых клипов, а DAVIS содержит 60 обучающих видеоклипов и 90 тестовых клипов.
E2FGVI был обучен на YouTube-VOS и оценен на обоих наборах данных. Во время обучения объектные маски (зеленые области на изображениях выше и сопровождающем видео на YouTube) были сгенерированы для симуляции видеозаполнения.
Для метрик исследователи приняли пиковое соотношение сигнал-шум (PSNR), структурное сходство (SSIM), видео-основанное расстояние Фрэчета (VFID) и ошибку закрутки потока – последнее для измерения временной стабильности в затронутом видео.
Предыдущие архитектуры, против которых была протестирована система, были VINet, DFVI, LGTSM, CAP, FGVC, STTN и FuseFormer.

Из раздела количественных результатов статьи. Стрелки вверх и вниз указывают, что более высокие или более низкие числа лучше, соответственно. E2FGVI достигает лучших результатов во всех отношениях. Методы оцениваются согласно FuseFormer, хотя DFVI, VINet и FGVC не являются системами End-to-End, что делает невозможным оценку их FLOPs.
Помимо достижения лучших результатов против всех конкурирующих систем, исследователи провели качественное пользовательское исследование, в котором видео, преобразованные пятью представительными методами, были показаны индивидуально двадцати добровольцам, которые были попросены оценить их в плане визуального качества.

Вертикальная ось представляет процент участников, которые предпочли выход E2FGVI в плане визуального качества.
Авторы отмечают, что, несмотря на единогласное предпочтение их методу, один из результатов, FGVC, не отражает количественные результаты, и они предполагают, что это указывает на то, что E2FGVI может, казалось бы, генерировать ‘более визуально приятные результаты’.
В плане эффективности авторы отмечают, что их система значительно снижает операции с плавающей запятой в секунду (FLOPs) и время вывода на одном GPU Titan на наборе данных DAVIS, и наблюдают, что результаты показывают, что E2FGVI работает в пятнадцать раз быстрее, чем методы, основанные на потоке.
Они комментируют:
‘[E2FGVI] имеет наименьшие FLOPs по сравнению со всеми другими методами. Это указывает на то, что предложенный метод очень эффективен для видеоинпейтинга.’
*Мое преобразование INLINE-цитат авторов в гиперссылки.
Опубликовано впервые 19 мая 2022 года.
Исправлено во вторник, 28 октября 2025 года, для удаления неисправного встроенного видео и изменения ссылок на встроенное видео в теле статьи.


