
Интервью
Никундж Баджай, сооснователь и генеральный директор TrueFoundry – серия интервью

 Добавьте Unite.AI в избранные источники в Google
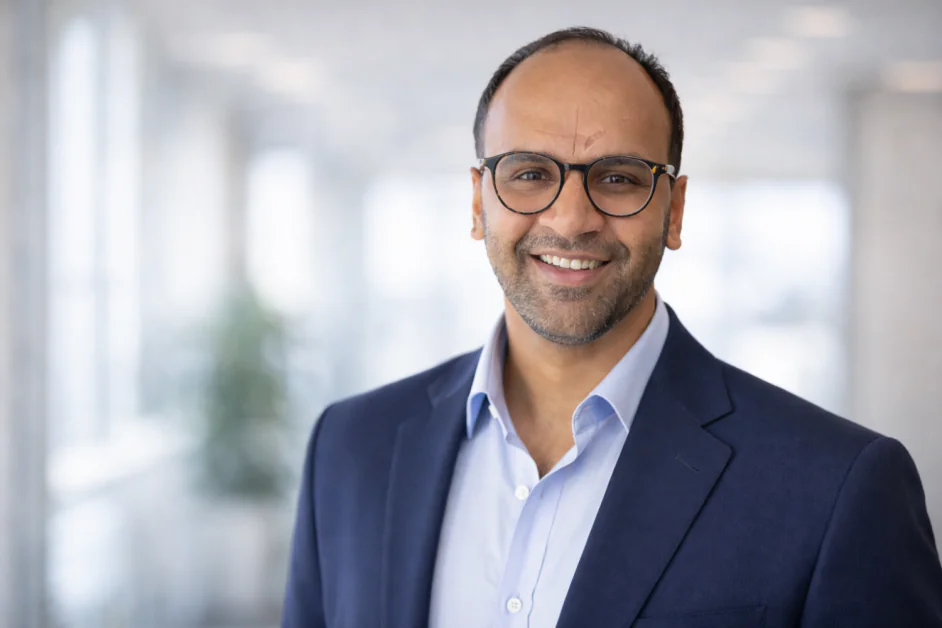
До основания TrueFoundry вы занимались исследованиями машинного обучения, системами ИИ в промышленной эксплуатации в Facebook (META ) и крупномасштабными рекомендательными системами. Какой опыт наиболее непосредственно подтолкнул вас к созданию компании, разрабатывающей инфраструктуру ИИ для предприятий, и какая проблема, на ваш взгляд, тогда оставалась нерешённой?
В Meta мы рассматривали машинное обучение как частный случай программного обеспечения, а генеративный ИИ — как частный случай машинного обучения. В результате получался вертикальный технологический стек: программное обеспечение внизу, машинное обучение посередине и генеративный ИИ наверху. В такой конфигурации модели, которые я создаю как разработчик машинного обучения, следуют той же схеме развёртывания, что и остальное программное обеспечение. Это делает масштабирование систем очень простым.
Однако большинство предприятий развёртывало параллельные стеки, то есть отдельные стеки для программного обеспечения, машинного обучения и генеративного ИИ. При таких параллельных стеках масштабирование усложняется из-за необходимости передавать работу между областью машинного обучения и миром программного обеспечения.
Наша команда всегда работала на пересечении создания моделей машинного обучения и соответствующей инфраструктуры. Благодаря этой особой перспективе мы увидели возможность внедрить подобные вертикальные стеки на предприятиях и адаптировать их к конкретным требованиям. В конце 2021 года у нас также появилась гипотеза, что машинное обучение приближается к переломному моменту. Когда он наступит, большему числу компаний понадобится вертикально интегрированный стек, чтобы эффективно развёртывать и масштабировать эти системы. Именно это в итоге привело нас к основанию TrueFoundry, и наша гипотеза подтвердилась. Внедрение ИИ ускорилось после запуска ChatGPT в конце 2022 года.
Что изменилось в том, как организациям следует думать о надёжности и отказах, по мере перехода систем ИИ от экспериментов к повседневной эксплуатации?
В случае генеративного ИИ на кону значительно больше, чем в традиционных системах машинного обучения. Когда эти системы переходят в промышленную эксплуатацию, организации сталкиваются с гораздо более высокой степенью неоднозначности и недетерминированности, поскольку LLM по своей природе стохастичны. Агентные системы, построенные на их основе, добавляют ещё больше неоднозначности.
Кроме того, отказы больше не бинарны. Система не просто работает или не работает: многие проблемы проявляются в виде частичных отказов или незаметного ухудшения работы. Со временем системы могут отвечать с большей задержкой, более низким качеством или вести себя неправильно. Во многих случаях такие ухудшения сложнее обнаружить, а иногда они даже вреднее, чем полная остановка работы.
Организациям нужно оценивать надёжность не только по времени бесперебойной работы, но и с учётом ухудшения производительности со временем.
TrueFailover был запущен на фоне волны широко обсуждавшихся перебоев в облачных сервисах и сервисах ИИ. Какие недавние события ясно показали, что надёжность ИИ превратилась из желательного дополнения в основное архитектурное требование?
Один из наших клиентов в сфере здравоохранения обрабатывает в реальном времени запросы пациентов, связанные с рецептами, для которых критически важен своевременный ответ. Его затронул перебой в работе, вызванный отказом модели. Рабочие процессы клиента приносят тысячи долларов выручки в секунду, и перебой нарушил некоторые из этих критически важных процессов. Это был один из первых клиентов TrueFailover, поэтому мы смогли помочь ему быстро восстановить работу и ограничить последствия.
Такие инциденты ставят важный вопрос: если в случае систем генеративного ИИ на кону всё больше, почему процессы восстановления по-прежнему в основном ручные? Это укрепило идею о том, что системы следует строить исходя из неизбежности отказов и проектировать так, чтобы они автоматически исправляли себя. Надёжность также нужно встраивать в сам стек ИИ с помощью шлюзов ИИ, которые обеспечивают централизованную маршрутизацию, наблюдаемость, защитные механизмы и интеллектуальное переключение между моделями разных поставщиков.
Многие перебои в работе ИИ по-прежнему описывают как небольшие технические неполадки. Где, по вашему мнению, начинают проявляться реальные экономические и человеческие издержки, когда системы ИИ перестают работать?
ИИ на предприятиях развился до такой степени, что эти неполадки больше не затрагивают только внутренние рабочие процессы. Сегодня перебои и ухудшения работы прямо и немедленно влияют на общественное восприятие и прибыль, поскольку приложения в промышленной эксплуатации уже обслуживают клиентов. Именно переход от внутреннего тестирования к общедоступным приложениям, в которых многое поставлено на карту, объясняет растущую потребность во внимании и надзоре со стороны высшего руководства.
По мере того как системы ИИ глубже встраиваются в операционные рабочие процессы, перебои перестают быть только техническими проблемами. Они всё чаще имеют прямые последствия для бизнеса, клиентов и репутации.
Как быстро в критически важных средах, таких как аптеки, медицинские службы или поддержка клиентов, простой ИИ может перерасти в операционный или репутационный риск?
В критически важных средах эскалация происходит почти немедленно, поскольку эти системы поддерживают рабочие процессы в реальном времени, где своевременная обработка имеет решающее значение. Даже короткий перебой может остановить критические процессы, задержать оказание услуг или нарушить работу последующих систем, зависящих от этих результатов, вызывая каскадные операционные последствия во всей организации.
В таких отраслях, как здравоохранение, влияние выходит за рамки операционных нарушений и затрагивает клиентский опыт и результаты оказания услуг. Если пациент не может вовремя получить лекарства по рецепту, это может иметь реальные последствия. Это не только проблема для пациента: ситуация способна также навредить репутации аптеки или медицинского учреждения. В критически важных средах, где важную роль играет доверие, непрерывная работа систем имеет первостепенное значение. Поэтому организации всё чаще понимают, что системы ИИ нужно проектировать с расчётом на возникновение отказов, а механизмы восстановления должны запускаться автоматически, чтобы минимизировать риск.
Вы говорили, что многие команды проектируют архитектуру ради возможностей, а не непрерывности работы. Почему, на ваш взгляд, устойчивость исторически имела более низкий приоритет при проектировании систем ИИ?
В основном это связано со стимулами внутри организаций. Новые возможности заметны и вызывают интерес. Они открывают путь к демонстрациям, функциям и новым перспективам продукта, которые руководство может увидеть сразу.
Непрерывность по определению незаметна, когда всё работает хорошо. Поэтому системы вознаграждения обычно больше поощряют выпуск новых функций, чем обеспечение того, чтобы ничего не сломалось. В результате организации часто вкладывают непропорционально больше в развитие возможностей, чем в инженерное обеспечение устойчивости.
Какие новые уязвимые места появляются в стеке ИИ из-за растущей зависимости предприятий от внешних моделей и API, а их значение руководители, возможно, пока не осознают в полной мере?
LLM по своей сути являются общими ресурсами, и предприятия не владеют ими так, как традиционной инфраструктурой. Кроме того, важные, критические для бизнеса системы предприятий работают на внешних системах, которые ещё не прошли полноценную проверку временем. Сами LLM быстро развиваются, а значит, поставщика модели нельзя привлекать к ответственности за такие вещи, как задержка или небольшое снижение производительности модели, поскольку он очень быстро проводит новые итерации исследований.
Поскольку LLM — общие ресурсы, определённое действие другого их пользователя может вызвать резкий скачок задержки. Сама природа LLM создаёт множество подобных точек отказа, и предприятия в этом новом мире просто не имеют полного контроля. Без полного контроля лучшее, что может сделать предприятие, — обеспечить достаточную избыточность системы, чтобы спроектировать устойчивое решение.
Если не сосредотачиваться на конкретных продуктах, как организациям следует переосмыслить архитектуру ИИ, чтобы исходить из неизбежности отказов, а не считать перебои редкими пограничными случаями?
Организациям следует вернуться к основным принципам проектирования распределённых систем. Программные системы строились исходя из того, что сетевые компоненты и машины будут выходить из строя и что целый регион может прекратить работу.
Системы ИИ не должны быть исключением. Следует предполагать, что поставщики моделей столкнутся с задержками, ухудшениями работы или перебоями, и предусматривать избыточность, чтобы приложения оставались устойчивыми при разных сценариях отказа.
Ожидаете ли вы, что устойчивость ИИ станет решающим фактором при выборе платформы и поставщика, подобно тому, как время бесперебойной работы и избыточность влияли на решения об облачной инфраструктуре?
По мере перехода всё большего числа систем ИИ в промышленную эксплуатацию устойчивость станет минимальным требованием. Если поставщик не может показать графики и метрики времени бесперебойной работы и общей устойчивости, его даже не будут рассматривать. Когда устойчивость станет базовым ожиданием от всех поставщиков, решающими факторами будут пользовательский опыт, оптимизация производительности, наблюдаемость и возможности продукта более высокого уровня. Со временем такие компоненты, как шлюз ИИ и автоматическое переключение при отказе, станут основополагающими элементами корпоративной инфраструктуры ИИ.
Что в будущем на самом деле будет означать ИИ, «готовый к промышленной эксплуатации», в мире, где от него ожидают постоянной доступности, а не лишь периодической пользы?
Системы ИИ, готовые к промышленной эксплуатации, должны быть наблюдаемыми, управляемыми и восстанавливаемыми. Необходимо выполнить все три требования.
Для наблюдаемости ИИ в промышленной эксплуатации командам нужен глубокий обзор поведения моделей, задержек, частоты ошибок, использования токенов, дрейфа и закономерностей отказов. Без развитой наблюдаемости очень трудно обнаружить ухудшение до того, как его начнут замечать пользователи.
Управляемость систем включает регулирование трафика, ограничение частоты запросов, защитные механизмы, применение политик и интеллектуальную маршрутизацию между моделями и поставщиками. Здесь шлюз ИИ становится основой: он действует как централизованная плоскость управления, которая применяет защитные механизмы, обеспечивает согласованное управление и позволяет динамически переключать модели при снижении производительности или надёжности.
Наконец, для восстанавливаемости системы следует строить с расчётом на то, что компоненты могут быть частично или полностью неисправны — из-за перебоев у поставщика, ухудшения качества модели, ограничений частоты запросов или неожиданных входных данных от злоумышленников. Автоматическое переключение при отказе и механизмы самовосстановления должны быть встроены в архитектуру, а не зависеть от ручных процедур, запускаемых лишь после возникновения проблемы.
Именно в этом направлении мы работаем в TrueFoundry. Поставщики, которые так определяют готовность к промышленной эксплуатации, сочетая наблюдаемость, централизованное управление и автоматическое восстановление, заслужат долгосрочное доверие клиентов и смогут продолжать решать новые проблемы по мере их появления.
Спасибо за отличное интервью. Читатели, которые хотят узнать больше, могут посетить TrueFoundry.


