
Модели и платформы ИИ
Новые готовые наборы данных (OTS) от Appen ускоряют развертывание ИИ

 Добавьте Unite.AI в избранные источники в Google
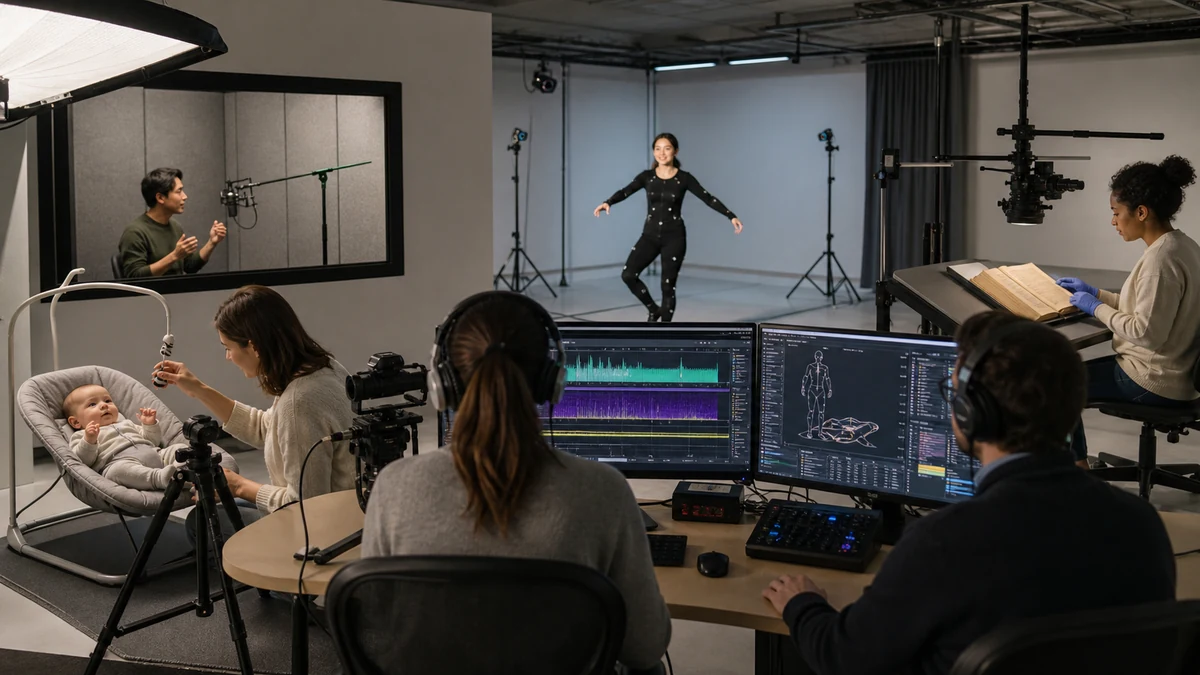
Appen Limited (ASX:APX), ведущий поставщик высококачественных обучающих данных для организаций, которые строят эффективные системы ИИ в крупном масштабе, сегодня объявила о новых готовых наборах данных (OTS). Эти наборы данных предназначены для того, чтобы сделать процесс получения высококачественных обучающих данных для бизнеса проще и быстрее, что необходимо для ускорения проектов по искусственному интеллекту (ИИ) и машинному обучению (МО). Новые OTS-наборы данных включают данные о движении человеческого тела и инновационные звуки плача младенцев, а также сценарные речи и изображения с текстом, подходящие для оптического распознавания символов (OCR) для языков с высоким спросом, но трудных для получения, таких как арабский, хорватский, греческий, венгерский, тайский и многие другие. С расширенными наборами данных общее количество OTS-предложений Appen включает более 250 наборов данных, состоящих из более 11 000 часов аудио, более 25 000 изображений и более 8,7 миллионов слов на 80 языках и диалектах.
Готовые наборы данных Appen – это быстрый и экономически эффективный инструмент для начала проекта ИИ или МО с высококачественными обучающими данными. Команды, расширяющие свои возможности ИИ, также могут использовать OTS-наборы данных для эффективного улучшения точности, разработки новых навыков моделей и внесения других улучшений в свои модели ИИ. Готовый набор данных часто поставляется в течение одной недели, например, по сравнению с восемью-двенадцатью неделями для сбора и аннотации нового набора данных – или даже дольше, в зависимости от сложности. Все наборы данных Appen разрабатываются с использованием полностью прозрачной, добровольной методологии, поэтому специалисты по ИИ могут быть уверены, что их данные чистые и соответствуют требованиям, что исключает потенциальный риск негативной реакции и ущерба репутации.
«Команды ИИ по всему миру, работающие над проектами с жесткими сроками и гибкими требованиями к данным, могут извлечь пользу из использования готовых наборов данных», – сказал Уилсон Панг, технический директор Appen. «Готовые наборы данных сокращают время до получения результатов и обеспечивают доступ к высококачественным данным по более низкой общей стоимости, чем при использовании традиционных методов. Мы в Appen принимаем необходимые меры для обеспечения того, чтобы все наши наборы данных были получены этично и были демографически сбалансированы, что позволяет компаниям поддерживать ответственные практики ИИ, минимизируя предвзятость в своих моделях и обеспечивая справедливое отношение к аннотаторам данных. Вы всегда знаете точное качество готового набора данных, что помогает создавать лучшие модели ИИ, которые работают в реальном мире».
MediaInterface поставляла языковые технологические решения медицинским учреждениям в Германии и других частях Европы более 20 лет. Когда компания расширяла свою деятельность во Францию, у нее была полностью локализированная программа, но не хватало французских лексических данных, особенно французских имен и названий мест, которые часто упоминаются в информации о здоровье пациентов. С помощью готовых наборов данных Appen MediaInterface приобрела примерно 21 000 французских имен и 14 000 названий мест. «Критические данные от Appen были включены в наш фоновый лексикон для успешного запуска на новом рынке, и это помогает нам создавать новые словари для наших клиентов и укреплять наш подход для будущих запусков рынка», – сказала Инес Вендлер, менеджер продукта в MediaInterface.
Самые опытные эксперты по ИИ сочетают готовые наборы данных с проектами сбора и аннотации данных по требованию, чтобы удовлетворить сложные потребности в обучающих данных для своих моделей ИИ. Appen является лидером в предоставлении постоянной поддержки через ряд специфических услуг по сбору данных, таких как непрерывная аннотация данных и умная маркировка, через инструменты и автоматизированные рабочие процессы, основанные на ИИ, для максимизации эффективности.
«Мы взаимодействуем с ИИ с момента пробуждения до момента сна – через виртуальных помощников, чат-ботов, поисковые системы, социальные сети, медицинские устройства, умные автомобили и другие приложения», – сказала Джудит Бишоп, старший директор Appen по ИИ-специалистам, которая руководит командой из 100 лингвистов и языковых экспертов по ИИ. «Язык часто является основным интерфейсом для многих этих интересных случаев использования ИИ, поэтому для обеспечения отличного опыта модель должна быть обучена для работы для всех. Коммит Appen к высококачественным данным и ответственной, этической разработке ИИ позволяет компаниям, покупающим наши готовые наборы данных, ускорять свои проекты ИИ с полной уверенностью в своих данных».
К новым готовым наборам данных Appen, которые теперь доступны, относятся:
- Сценарная речь для арабского (Египет), арабского (Саудовская Аравия), арабского (Объединенные Арабские Эмираты), центрального кхмерского (Камбоджа), хорватского, греческого, венгерского, польского, испанского (Испания) и турецкого
- OCR-изображения для упрощенного китайского печатного текста, тайского печатного текста и финского печатного текста – Включает предзаписанные рекламные щиты, внешнюю упаковку, знаки, журналы и меню для обучения и обновления компьютерных моделей OCR
- Движение человеческого тела (Китай) – Включает аннотированные видео людей, отслеживаемые на уровне пикселей, подходящие для разработки игр, фитнес-приложений и многого другого
- Аудио плача младенцев (Китай) – Включает предзаписанные и аннотированные звуки младенцев, которые можно использовать для обучения моделей ИИ распознавать разные звуки плача и оповещать родителей
Для получения более подробной информации и запроса образца набора данных Appen OTS нажмите здесь.


