
Взгляд Anderson
DALL-E 2 просто склеивает вещи, не понимая отношений между ними?

 Добавьте Unite.AI в избранные источники в Google

Ключевые моментыDALL-E 2 не удаётся воспроизвести базовые пространственные отношения, такие как «в» или…
Показать больше
- DALL-E 2 не удаётся воспроизвести базовые пространственные отношения, такие как «в» или «на», в генерируемых изображениях.
- Лишь 22% изображений DALL-E 2 соответствовали своим описаниям в исследовании с участием 169 человек.
- Реляционные сбои системы усугубляются, когда в обучающих данных отсутствуют примеры изображаемого события.
Новая исследовательская работа Гарвардского университета предполагает, что фреймворк генерации изображений по тексту OpenAI DALL-E 2 имеет заметные трудности в воспроизведении даже отношений, понятных младенцам, между элементами, которые он компонует в синтезированные фотографии, несмотря на ослепительную сложность большей части его вывода.
Исследователи провели пользовательское исследование, в котором приняли участие 169 участников, привлечённых через краудсорсинговую платформу, которым были представлены изображения DALL-E 2 на основе самых базовых человеческих принципов семантики отношений, вместе с текстовыми подсказками, которые создали их. Когда их спросили, связаны ли подсказки и изображения, менее 22% изображений были восприняты как имеющие отношение к их связанным подсказкам, в плане очень простых отношений, которые DALL-E 2 просили визуализировать.

Скриншот из проведенных испытаний для новой статьи. Участникам было поручено выбрать все изображения, соответствующие подсказке. Несмотря на предупреждение внизу интерфейса, все изображения на самом деле были созданы по показанной подсказке, о чём участники не знали. Источник: https://arxiv.org/pdf/2208.00005.pdf
Результаты также предполагают, что способность DALL-E 2 соединять несопоставимые элементы может уменьшиться, когда эти элементы становятся менее вероятными для возникновения в реальных данных обучения, которые управляют системой.
Например, изображения для подсказки “ребенок трогает миску” получили 87% согласия (т.е. участники нажали на большинство изображений как имеющих отношение к подсказке), тогда как подобные фотографически реалистичные изображения “обезьяны трогают игуану” достигли только 11% согласия:

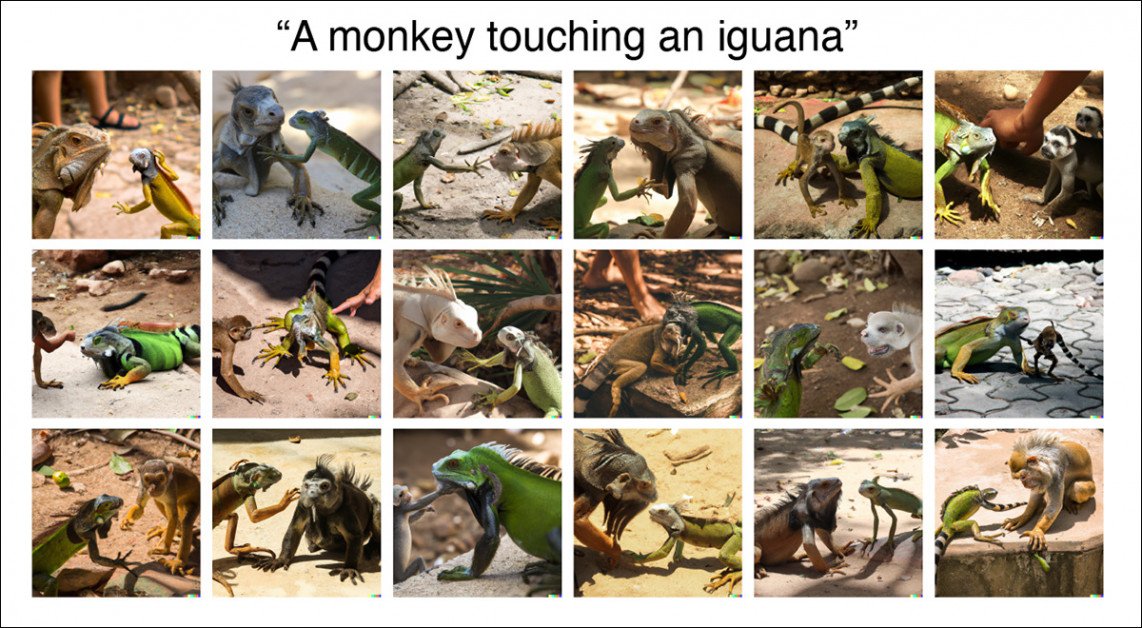
DALL-E 2 испытывает трудности в изображении маловероятного события ‘обезьяна трогает игуану’, вероятно потому, что такое событие редко встречается или вовсе отсутствует в обучающих данных.
Во втором примере DALL-E 2 часто ошибается в масштабе и даже виде, вероятно, из-за отсутствия реальных изображений, изображающих это событие. Напротив, можно ожидать, что будет большое количество обучающих фотографий, связанных с детьми и едой, и что эта подсистема/класс хорошо развит.
Трудности DALL-E 2 в сочетании резко контрастных элементов изображения предполагают, что общественность в настоящее время так ослеплена фотографически реалистичными и интерпретативными возможностями системы, что не развила критического взгляда на случаи, когда система фактически просто “приклеила” один элемент резко на другой, как в этих примерах из официального сайта DALL-E 2:
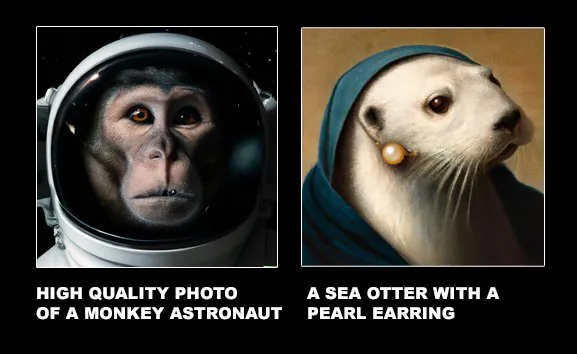
Синтез вырезки и вставки, из официальных примеров для DALL-E 2. Источник: https://openai.com/dall-e-2/
Новая статья гласит*:
‘Понимание отношений является фундаментальной составляющей человеческого интеллекта, которая проявляется рано в развитии и вычисляется быстро и автоматически в восприятии.
‘Трудности DALL-E 2 с даже базовыми пространственными отношениями (такими как в, на, под) предполагают, что чему бы система ни научилась, она ещё не усвоила представления, которые позволяют людям так гибко и устойчиво структурировать мир.
‘Прямая интерпретация этой трудности заключается в том, что системы, подобные DALL-E 2, не обладают реляционной композиционностью.’
Авторы предлагают, что системы генерации изображений, управляемые текстом, такие как серия DALL-E, могли бы извлечь выгоду из алгоритмов, распространенных в робототехнике, которые моделируют идентификаторы и отношения одновременно, из-за необходимости агента фактически взаимодействовать с окружающей средой, а не просто создавать смесь различных элементов.
Один из таких подходов, озаглавленный CLIPort, использует тот же механизм CLIP, который служит элементом оценки качества в DALL-E 2:
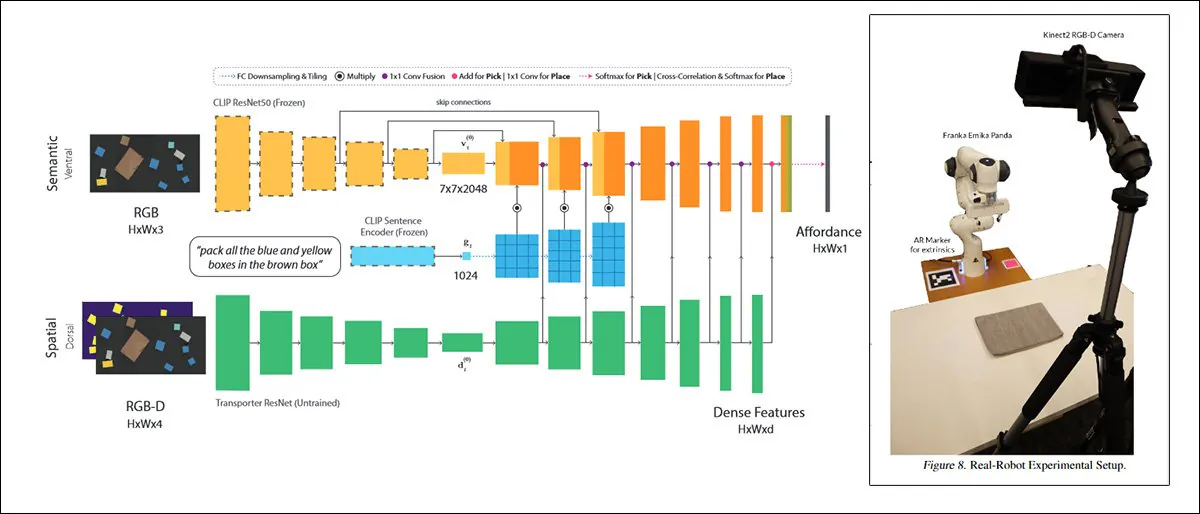
CLIPort, совместная работа 2021 года между Университетом Вашингтона и NVIDIA, использует CLIP в контексте, настолько практичном, что системы, обученные на нем, должны обязательно развить понимание физических отношений. Такого стимула нет у DALL-E 2 и сходных фреймворков синтеза фантастических изображений. Источник: https://arxiv.org/pdf/2109.12098.pdf
Авторы далее предлагают ‘другое правдоподобное улучшение’ может заключаться в том, чтобы архитектура системы синтеза изображений, такой как DALL-E, включала мультипликативные эффекты в едином слое вычислений, позволяя вычислять отношения таким образом, который вдохновлен информационными возможностями биологических систем.
Новая статья озаглавлена Тестирование реляционного понимания в генерации изображений, управляемой текстом и исходит от Колина Конвелла и Томера Д. Уллмана из психологического факультета Гарварда.
За пределами ранней критики
Комментируя “фокус” за реализмом и целостностью вывода DALL-E 2, авторы отмечают предыдущие работы, которые обнаружили недостатки в генеративных системах изображений типа DALL-E.
В июне этого года Университет Калифорнии в Беркли отметил трудности DALL-E в обработке отражений и теней; в том же месяце исследование из Кореи изучило ‘уникальность’ и оригинальность вывода DALL-E 2 с критическим взглядом; предварительный анализ изображений DALL-E 2, вскоре после запуска, из Нью-Йоркского университета и Университета Техаса, обнаружил различные проблемы с композиционностью и другими важными факторами в изображениях DALL-E 2; и в прошлом месяце совместная работа между Университетом Иллинойса и Массачусетским технологическим институтом предложила предложения для архитектурных улучшений таких систем в плане композиционности.
Исследователи далее отмечают, что известные лица DALL-E, такие как Адитья Рамеш, признали проблемы фреймворка с связыванием, относительным размером, текстом и другими проблемами.
Разработчики системы синтеза изображений Imagen от Google также предложили DrawBench, новую систему сравнения, которая оценивает точность изображений в различных фреймворках с разными метриками.
Вместо этого авторы новой статьи предлагают, что лучший результат может быть получен путем противопоставления человеческой оценки – а не алгоритмических метрик – полученным изображениям, чтобы установить, где лежат слабости, и что можно сделать, чтобы смягчить их.
Исследование
Для этого новый проект основывает свой подход на психологических принципах и стремится отойти от текущего всплеска интереса к инженерии подсказок (которая, по сути, является уступкой недостаткам DALL-E 2 или любой сравнимой системы), чтобы исследовать и потенциально устранить ограничения, которые делают такие ‘обходные пути’ необходимыми.
Статья гласит:
‘Текущая работа фокусируется на наборе из 15 основных отношений, ранее описанных, изученных или предложенных в когнитивной, возрастно-психологической или лингвистической литературе. Набор содержит как основанные на пространственных отношениях (например, ’X на Y’), так и более абстрактные агентные отношения (например, ’X помогает Y’).
‘Подсказки намеренно просты, без сложности атрибутов или разъяснений. То есть вместо подсказки типа ‘осёл и осьминог играют в игру. Осёл держит один конец верёвки, а осьминог — другой. Осёл держит верёвку во рту. Кот прыгает через веревку’, мы используем ‘коробка на ноже’.
‘Простота все еще захватывает широкий спектр отношений из различных подсистем человеческой психологии и делает потенциальные неудачи модели более заметными и конкретными.’
Для своего исследования авторы набрали 169 участников из Prolific, все из которых находились в США, со средним возрастом 33 года и 59% женщин.
Участникам были показаны 18 изображений, организованных в сетку 3×6 с подсказкой вверху и предупреждением внизу, в котором говорилось, что все, некоторые или ни одно из изображений могут быть сгенерированы из отображаемой подсказки, и были затем попросили выбрать изображения, которые, по их мнению, были связаны таким образом.
Изображения, представленные отдельным лицам, были основаны на лингвистической, возрастно-психологической и когнитивной литературе, и состояли из набора из восьми физических и семи ‘агентных’ отношений (это станет ясно через мгновение).
Физические отношения
в, на, под, покрывающий, рядом, перекрытый, висящий над, и связанный с.
Агентные отношения
толкающий, тянущий, трогая, бьющий, пинующий, помогающий, и препятствующий.
Все эти отношения были взяты из вышеупомянутых областей исследования вне информатики.
Были получены 12 сущностей для использования в подсказках, с шестью объектами и шестью агентами:
Объекты
коробка, цилиндр, одеяло, миска, чашка, и нож.
Агенты
мужчина, женщина, ребенок, робот, обезьяна, и игуана.
(Исследователи признают, что включение игуаны, не основной темы сухой социологической или психологической исследований, было ‘забавным дополнением’)
Для каждого отношения были созданы пять разных подсказок путем случайной выборки двух сущностей пять раз, в результате чего получилось 75 общих подсказок, каждая из которых была подана в DALL-E 2, и для каждой из которых были использованы первоначальные 18 предоставленных изображений, без каких-либо изменений или вторых шансов.
Результаты
Статья гласит*:
‘Участники в среднем сообщили о небольшом количестве согласия между изображениями DALL-E 2 и подсказками, использованными для их генерации, со средним значением 22,2% [18,3, 26,6] по 75 различным подсказкам.
‘Агентные подсказки, со средним значением 28,4% [22,8, 34,2] по 35 подсказкам, сгенерировали более высокое согласие, чем физические подсказки, со средним значением 16,9% [11,9, 23,0] по 40 подсказкам.’

Результаты исследования. Черные точки обозначают все подсказки, причём каждая точка соответствует отдельной подсказке. Цвет различает отношения между действующими субъектами и физические отношения между объектами.
Чтобы сравнить разницу между человеческим и алгоритмическим восприятием изображений, исследователи проанализировали свои рендеры с помощью открытого фреймворка OpenAI ViT-L/14 CLIP. В среднем они обнаружили ‘умеренную связь’ между двумя наборами результатов, что, возможно, удивительно, учитывая, насколько CLIP помогает генерировать изображения.

Результаты сравнения CLIP (ViT-L/14) с человеческими ответами.
Исследователи предполагают, что другие механизмы в архитектуре, возможно, в сочетании с случайным преобладанием (или отсутствием) данных в обучающем наборе, могут объяснить, как CLIP может распознавать ограничения DALL-E без возможности что-либо сделать с этой проблемой.
Авторы заключают, что DALL-E 2 имеет только номинальную способность, если вообще имеет её, воспроизводить изображения, которые включают реляционное понимание, фундаментальную составляющую человеческого интеллекта, которая развивается у нас очень рано.
‘Идея о том, что системы, подобные DALL-E 2, не обладают композиционностью, может удивить кого-либо, кто видел разумные ответы DALL-E 2 на подсказки типа ‘мультяшная маленькая редька дайкон в балетной пачке выгуливает пуделя’. Подсказки такого типа часто генерируют разумную аппроксимацию композиционного понятия, со всеми частями подсказки, присутствующими и находящимися в правильных местах.
‘Композиционность, однако, не только способность склеить вещи вместе – даже вещи, которые вы никогда не видели вместе раньше. Композиционность требует понимания правил, которые связывают вещи вместе. Отношения – это такие правила.’
Человек кусает Т-Рекса
Мнение Поскольку OpenAI расширяет доступ к большему количеству пользователей после недавней бета-монетизации DALL-E 2, и поскольку теперь необходимо платить за большинство генераций, ограничения DALL-E 2 в реляционном понимании могут стать более очевидными, поскольку каждая ‘неудачная’ попытка имеет финансовый вес, и возвраты не доступны.
Те, кто получил приглашение немного раньше, имели время (и, до недавнего времени, больше возможности поиграть с системой) наблюдать некоторые ‘отношенческие ошибки’, которые DALL-E 2 может выдать.
Например, для поклонника Парка Юрского периода очень трудно получить изображение, на котором динозавр преследует человека в DALL-E 2, даже хотя концепция ‘преследования’ не кажется частью системы цензуры DALL-E 2, и даже хотя долгая история фильмов о динозаврах должна обеспечить множество обучающих примеров (по крайней мере, в виде трейлеров и рекламных фотографий) для этого в противном случае невозможного встречи видов.
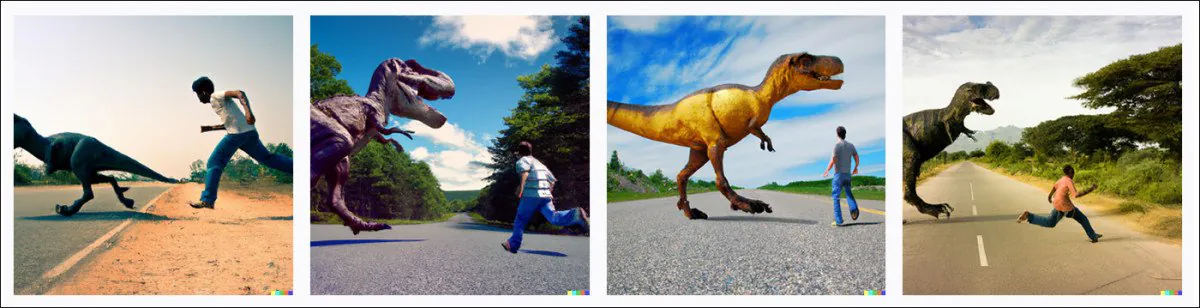
Типичный ответ DALL-E 2 на подсказку ‘Цветная фотография Т-Рекса, преследующего человека по дороге’. Источник: DALL-E 2
Я обнаружил, что изображения выше типичны для вариаций подсказки ‘[динозавр] преследует [человека]’, и что никакое количество разъяснений в подсказке не может заставить Т-Рекса действительно преследовать человека. В первом и втором фото человек (более или менее) преследует Т-Рекса; в третьем он подходит к нему с небрежным пренебрежением к безопасности; и в последнем изображении он, по-видимому, бежит параллельно великому зверю. За примерно 10-15 попыток этой темы я обнаружил, что динозавр аналогично ‘отвлечен’.
Возможно, что единственными обучающими данными, которые DALL-E 2 мог получить доступ, были данные вроде ‘человек сражается с динозавром’, из рекламных фотографий для более старых фильмов, таких как Один миллион лет до нашей эры (1966), и что знаменитое бегство Джеффа Голдблюма от короля хищников просто является выбросом в этом небольшом наборе данных.
* Мое преобразование внутренних цитат авторов в гиперссылки.
Опубликовано впервые 4 августа 2022 года.





