
Лучшее
10 лучших инструментов ИИ для веб-скрейпинга (ноябрь 2026)

 Добавьте Unite.AI в избранные источники в Google
Unite.AI может получать вознаграждение, когда вы используете ссылки на рассмотренные нами продукты. Это не влияет на наши редакционные оценки. Читайте раскрытие об аффилированности.
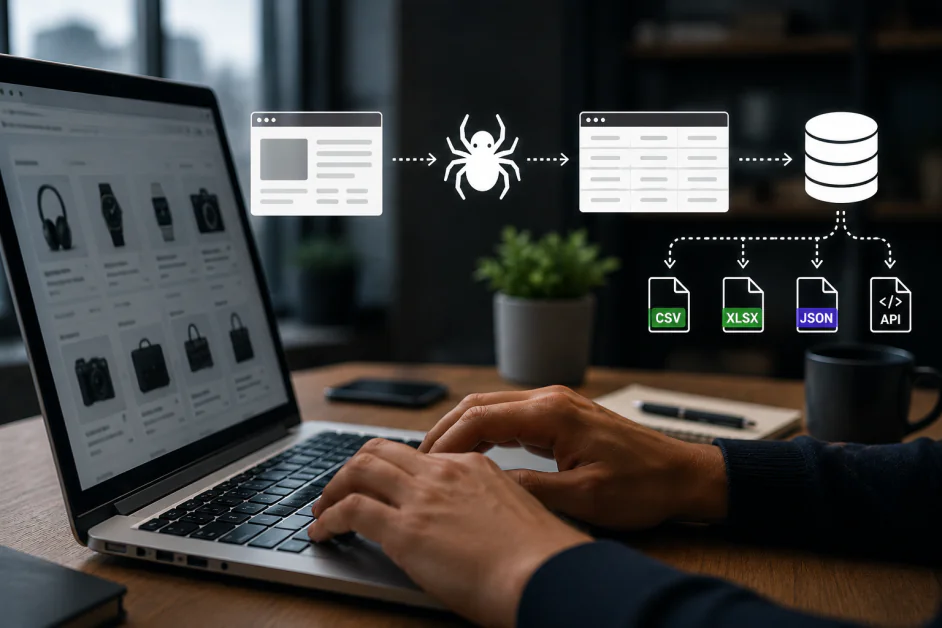
Ключевые моментыПодбирайте инструмент для скрейпинга под задачу, выполняемую после загрузки, а не…
Показать больше
- Подбирайте инструмент для скрейпинга под задачу, выполняемую после загрузки, а не рассматривайте весь сбор данных как одну проблему.
- Назначайте ответственных за рабочий процесс тех людей, которые понимают как исходные сайты, так и требуемый результат.
- Планируйте бюджет исходя из пригодных для использования записей, а не из заявленного числа запросов, поскольку рендеринг и прокси завышают итоговые показатели.
Выбор лучшего инструмента ИИ для веб-скрейпинга зависит от того, что вы хотите делать после загрузки страницы. Исследовательскому помощнику нужны удобный для чтения контент и ссылки на источники. Системе анализа рынка — единообразные записи в большом объёме. Интерактивному агенту может понадобиться браузер, способный выполнить несколько действий и сохранить активную сессию.
В этом руководстве рассмотрены десять инструментов для решения таких задач: платформы для сбора данных корпоративного уровня, API для работы с контентом, скрейперы без программирования, сервисы поисковых данных и управляемые браузеры. Мы оцениваем, как каждый продукт собирает информацию, кто может поддерживать рабочий процесс и какие компромиссы важны, когда прототип превращается в регулярно выполняемый процесс.
Наша команда самостоятельно оценила все решения, представленные в этом руководстве, рассмотрев их возможности, практические преимущества, ограничения и пригодность для сценариев использования, отражённых в нашем рейтинге.
Сравнение лучших инструментов ИИ для веб-скрейпинга
| Инструмент ИИ | Лучше всего подходит для | Ключевые преимущества |
|---|---|---|
| Bright Data | Корпоративного сбора данных и разнообразных конвейеров обработки данных | Scraper APIs, Browser API, Scraper Studio, наборы данных, прокси-серверы |
| Firecrawl | Веб-контента для приложений на базе ИИ | Поиск, скрейпинг, составление карт сайта, обход сайтов, Markdown, JSON, взаимодействие, MCP |
| Apify | Многократного запуска заданий по сбору данных и их оркестрации в облаке | Акторы, Crawlee, расписания, хранилище, прокси-серверы, API, MCP |
| Browse AI | Сбора данных без программирования и отслеживания изменений | Настройка с помощью ИИ, роботы, оповещения, расписания, интеграции |
| SearchAPI | Структурированных результатов поиска и локализованных исследований | Google, Карты, покупки, видео, поисковые сервисы на базе ИИ, JSON |
| Octoparse | Визуального скрейпинга с регулярным выполнением задач в облаке | Шаблоны, ИИ-помощник, автоматическое обнаружение, запуск в облаке, экспорт |
| Browserless | Управляемых браузеров для Puppeteer и Playwright | Размещённые в облаке браузеры, постоянные сессии, REST API, MCP |
| ScrapingBee | Управляемого извлечения данных через API приложения | Извлечение данных с помощью ИИ, CSS/XPath, Markdown, сценарии JavaScript, MCP |
| Oxylabs | Управляемого сбора данных с общедоступных сайтов, предъявляющих высокие требования | Web API /Scrape, рендеринг, структурированный вывод, MCP |
| Diffbot | Автоматического извлечения данных и анализа сущностей | Извлечение, стандартные схемы, обход сайтов, граф знаний |
Как выбрать инструмент ИИ для веб-скрейпинга
Выберите инструмент под конкретную задачу
Для базы знаний на основе ИИ отдавайте предпочтение удобному для чтения тексту, структурированному выводу и сохранению исходных URL. Для регулярных бизнес-исследований визуальный робот и оповещения об изменениях могут быть важнее программного интерфейса. Для интерактивного агента важны сохранение сессии и управление браузером. API результатов поиска решают другую задачу: они предоставляют данные поиска, а сбор содержимого страниц по ссылкам — это отдельный этап.
Определите, кто отвечает за рабочий процесс
Платформа без программирования позволяет аналитику напрямую настраивать этапы извлечения данных. API предоставляет разработчикам удобный интерфейс для интеграции сбора данных в приложение. Облачная платформа для заданий добавляет планирование запусков и хранение данных, тогда как управляемый браузер оставляет вашей команде больше логики автоматизации. Правильный выбор позволяет поручить поддержку тем, кто понимает и устройство исходных сайтов, и требования к результату.
Оценивайте стоимость полезных записей, а не громкие показатели числа запросов
Сравните стоимость выполненного задания с теми полями, которые вам нужны. На итоговую сумму могут повлиять рендеринг, премиальные прокси-серверы, продолжительность работы браузера, извлечение данных с помощью ИИ, хранение и повторные попытки. Бесплатный кредит, единица тарификации браузера и поисковый запрос — разные меры. При регулярной работе наряду с успешными ответами отслеживайте полноту данных, дубликаты, актуальность и стоимость каждой пригодной к использованию записи.
10 лучших инструментов ИИ для веб-скрейпинга
1. Bright Data
Bright Data — наш общий выбор для организаций, которым нужны разные способы сбора веб-данных в рамках одной платформы. В набор решений входят готовые Scraper APIs, предварительно собранные наборы данных, Scraper Studio, Web Unlocker и прокси-сервисы. Например, команда, анализирующая рынок электронной торговли, может использовать структурированные потоки данных для известных розничных сетей и одновременно настроить индивидуальный сбор данных с узкоспециализированной торговой площадки. Благодаря такому широкому набору возможностей сервис особенно полезен, когда программа работы с данными охватывает несколько сайтов или подразделений.
Для работы с интерактивными страницами Browser API предоставляет браузеры, которыми разработчики могут управлять с помощью Puppeteer, Playwright или Selenium. Сервис объединяет работу браузера с управлением прокси и обработкой CAPTCHA, а поддержка Chrome DevTools помогает инженерам изучать проблемные сессии. Это особенно полезно, когда для получения нужных данных требуется перейти на другую страницу или взаимодействовать с ней, а не просто скачать уже готовый набор данных.
Главный компромисс связан с выбором продуктов и управлением расходами. Работа с браузерным трафиком, результатами скрейпинга и покупкой наборов данных предполагает разные сценарии использования, поэтому одной общей цены недостаточно, чтобы описать стоимость всей платформы. Bright Data подходит командам, где есть ответственный за качество сбора, охват источников и расходы. Проект с узкой областью применения может быстрее перейти в промышленную эксплуатацию с более простым API для извлечения данных.
Плюсы и минусы
- Широкий выбор способов сбора данных на одной платформе
- Облачные браузеры поддерживают распространённые библиотеки автоматизации
- Готовые API и наборы данных упрощают настройку
- Для разных продуктов нужно отдельно планировать расходы
- Для разработки индивидуальных конвейеров по-прежнему нужен ответственный инженер
2. Firecrawl
Firecrawl — наш выбор для разработчиков, которые превращают веб-контент в полезный контекст для ИИ-приложений. Инструменты поиска, скрейпинга, составления карты сайта и обхода страниц охватывают весь процесс: от обнаружения страницы до сбора данных с сайта. Markdown и структурированный JSON сокращают объём очистки данных после получения. Благодаря этому исследовательский помощник или продукт на основе базы знаний может больше времени уделять ответам на вопросы и меньше — удалению навигационных меню из исходного HTML.
Нынешнее предложение Interact расширяет платформу, добавляя работу с браузером в реальном времени. Агенты могут описывать действия на естественном языке или выполнять браузерный код, сохранять состояние между вызовами и повторно использовать профили с аутентификацией. Это важное дополнение для страниц, где перед извлечением данных нужно нажимать кнопки, задавать фильтры или входить в систему. Доступ через MCP и командную строку также позволяет использовать Firecrawl в рабочих процессах разработки агентов, а не только как обычный API приложения.
Firecrawl лучше всего подходит, когда главная задача — сбор контента, а приложение уже отвечает за его хранение и извлечение. Командам всё равно нужно определить границы обхода сайта, сохранять исходные URL и различать отсутствующее поле и поле с пустым значением. Открытый исходный код предоставляет ещё один вариант развёртывания, но командам следует оценивать конкретные возможности и эксплуатационные требования выбранного варианта, а не считать, что облачная и самостоятельная версии идентичны.
Плюсы и минусы
- Markdown и JSON подходят для конвейеров обработки данных в ИИ
- Interact поддерживает браузерные задачи с сохранением состояния
- Доступ через API, MCP и интерфейс командной строки
- Полученные данные всё равно нужно проверять
- Самостоятельное развёртывание требует усилий по эксплуатации
3. Apify
Для команд, которым нужны повторно используемые инструменты скрейпинга и платформа для работы с ними, Apify — лучший вариант из представленных. На маркетплейсе распространяются Actors — упакованные программы, которые принимают входные данные, выполняются в облаке и возвращают результаты. Готовые Actors ускоряют распространённые задачи по сбору данных, а собственные позволяют разработчикам сохранять и использовать свою логику извлечения. Благодаря этому Apify помогает перейти от эксперимента к повторяемой задаче для промышленной эксплуатации.
Платформа также обеспечивает важные функции для эксплуатации, включая расписание запусков, хранение результатов, доступ к прокси, мониторинг и интеграции. Разработчики могут создавать решения и с помощью Crawlee — библиотеки с открытым исходным кодом для обхода сайтов и автоматизации браузера. MCP-сервер Apify предоставляет агентам ИИ доступ к Actors, поэтому один и тот же упакованный инструмент можно использовать в приложении, конвейере с запланированными запусками или помощнике — без отдельной реализации скрейпера для каждого интерфейса.
Выбор Actor не менее важен, чем выбор платформы. У разных издателей могут различаться цены, обслуживание, варианты ввода данных и качество результатов. Успешный запуск также не доказывает, что были собраны все ожидаемые записи. Apify особенно полезен, когда есть ответственный за схему данных и отслеживание изменений, а также за планирование расходов на выбранный Actor и инфраструктуру. Для ручного извлечения данных с одной страницы такая сложная оркестрация обычно не нужна.
Плюсы и минусы
- Готовые и собственные Actors доступны на одной платформе
- Планирование запусков, хранение данных и мониторинг помогают выполнять задачи регулярно
- MCP позволяет использовать Actors в рабочих процессах агентов
- Обслуживание и качество Actors различаются
- Расходы на использование платформы и Actors нужно планировать
4. Browse AI
Мы рекомендуем Browse AI бизнес-пользователям, которым регулярно нужны данные из интернета и которые не хотят создавать для этого отдельный программный проект. Сервис может обработать предоставленную страницу, предложить структуру данных, а затем дать пользователю возможность проверить или изменить поля. Для повторяемого сбора данных по-прежнему важно обучить робота. Это практичный подход для команд по операционной деятельности и маркетингу, которые собирают сведения о товарах, записи из каталогов или информацию о конкурентах в привычные таблицы.
Одна из сильных сторон сервиса — мониторинг. Роботы могут проверять страницы по расписанию, выявлять добавления и изменения, а также отправлять уведомления с пояснением, что именно изменилось. Рабочие процессы позволяют объединять сбор данных с разных страниц, а интеграции через API, вебхуки и электронные таблицы помогают передавать результаты в инструменты, которыми команда уже пользуется. Поэтому мониторинг цен может стать непрерывным бизнес-процессом, а не чередой ручных проверок в браузере.
Простота использования не отменяет необходимости четко определить нужные данные. Пользователям следует решить, какие изменения заслуживают уведомления, и убедиться, что разбиение на страницы, этапы входа в систему и отсутствие результатов обрабатываются корректно. При масштабном изменении сайта все еще может потребоваться вмешательство. Browse AI лучше всего подходит для случаев, когда бизнес-команда может проверять извлеченные строки и обслуживать робота; разработчикам, которым нужна строго контролируемая версия логики работы с браузером, может больше подойти сервис на основе кода.
Преимущества и недостатки
- Настройка полей с помощью ИИ снижает порог входа
- Плановый мониторинг помогает выявлять значимые изменения
- Интеграции с электронными таблицами, API и вебхуками
- При существенных изменениях сайта может потребоваться повторное обучение
- Для сложной логики требуется тщательно спроектировать рабочий процесс
5. SearchAPI
Мы рекомендуем SearchAPI как специализированное решение для сбора результатов поиска в структурированном виде. Его API для Google может возвращать ссылки на результаты и элементы поисковой выдачи в формате JSON, избавляя от необходимости поддерживать парсер для меняющейся страницы результатов. В более широкий каталог входят такие источники, как Карты, магазины, новости, видео и поддерживаемые сервисом интерфейсы поиска с помощью ИИ. SearchAPI особенно полезен, когда поисковая выдача и видимость в поиске сами по себе являются конечным продуктом работы с данными, а не промежуточным этапом перед сбором информации с другого сайта.
Важная часть этого соответствия задачам — локализация. Параметры местоположения, страны, языка и устройства позволяют командам изучать рынок в заданном контексте поиска. SEO-приложение может отслеживать запрос в конкретном городе, а исследовательский помощник — находить релевантные источники и сохранять полученные ссылки для последующего использования. Важно изучать документацию для конкретной поисковой системы, поскольку доступные параметры и поля результатов различаются.
SearchAPI следует выбирать с учетом поисковых систем и полей, которые действительно нужны рабочему процессу. Результат поиска не содержит всего содержимого страницы по ссылке, а расширенные элементы выдачи используют разные схемы данных. Командам следует предусмотреть необходимый объем запросов, проверить требования к пропускной способности и корректно обрабатывать отсутствие разделов в результатах. Для извлечения данных с произвольных сайтов или работы в интерактивном браузере лучше начать с другого инструмента из этого руководства.
Преимущества и недостатки
- Структурированные результаты избавляют от необходимости поддерживать парсер поисковой выдачи
- Широкий каталог поисковых систем и связанных с ними сервисов
- Подробные настройки локализации
- Результаты поиска не заменяют извлечение данных со страниц, на которые ведут ссылки
- Поля и параметры различаются в зависимости от поисковой системы
6. Octoparse
Octoparse демонстрирует возможности своего ИИ-помощника Copilot и автоматизации с участием человека. Видео: Octoparse.
Octoparse подойдет аналитикам, которые хотят наглядно настроить парсер, а затем запускать его повторно. В актуальной версии платформы есть готовые шаблоны, настройка с помощью ИИ-помощника и автоматическое обнаружение страниц в настольном приложении. Пользователи могут доработать получившуюся задачу, не начиная с написания кода для браузера. Такая гибкость полезна при сборе каталогов товаров, справочников или объявлений, когда последовательность страниц не менее важна, чем поля на каждой из них.
Облачный запуск превращает настроенную задачу в регулярный процесс сбора данных, для которого не нужно постоянно держать включенным личный компьютер. Планирование, параллельное выполнение, ротация IP-адресов и подключение к системам экспорта помогают масштабировать крупные задачи за пределы настольного прототипа. Наглядный интерфейс особенно привлекателен для команд, которые понимают устройство исходных сайтов и требования к данным, но не хотят поддерживать собственный сервис автоматизации браузера.
Для эффективной работы с Octoparse требуется тщательно проектировать задачи. Разбиение на страницы, бесконечная прокрутка, этапы заполнения форм и дублирующиеся записи могут повлиять на смысл результатов, даже если запуск выглядит успешным. Облачные лимиты и возможности тарифного плана должны соответствовать предполагаемому расписанию и объему сбора данных. Мы рекомендуем Octoparse командам, которым нужен больший контроль над этапами извлечения данных, чем дает простой инструмент с запуском в один клик, при условии, что за задачу отвечает конкретный сотрудник, готовый корректировать ее при изменении исходных страниц.
Преимущества и недостатки
- Шаблоны и помощь ИИ упрощают настройку
- Визуальное редактирование позволяет настраивать детализированные задачи по извлечению данных
- Облачный запуск поддерживает сбор данных по расписанию
- Для сложных сайтов требуется доработка сценария сбора данных
- Облачные функции зависят от выбранного тарифа
7. Browserless
Мы рекомендуем Browserless разработчикам, которые хотят управлять браузером, передав его размещение и масштабирование на обслуживание управляемому сервису. Существующие скрипты Puppeteer или Playwright можно подключить к удалённым браузерам, поэтому сервис привлекателен для проектов, где уже работает код автоматизации. Это особенно полезно, когда сбор данных предполагает несколько взаимодействий, работу с интерфейсом, активно использующим JavaScript, или сессию, которую нужно поддерживать дольше, чем длится один простой запрос.
Сервис также предоставляет REST API для сбора данных, создания снимков экрана и PDF-файлов, а также для выполнения пользовательских браузерных функций. Размещённый на платформе MCP-сервер открывает браузерные инструменты для ИИ-агентов, а функции управления сессиями и профили с аутентификацией поддерживают рабочие процессы, требующие непрерывности. Поэтому Browserless подходит и разработчику, создающему собственный сборщик данных, и агенту, которому нужно перемещаться по сайтам и собирать информацию в настоящем браузере.
При выборе сервиса важно учитывать, как тарифицируется работа браузера. Бесплатный тариф сейчас включает 1 000 единиц в месяц и два браузера, работающих одновременно, а не 1 000 гарантированных операций сбора данных. Время работы браузера расходует единицы; за прокси-трафик и успешное решение CAPTCHA взимается дополнительная плата. Ограничения на продолжительность сессий зависят от тарифа. Команды по-прежнему отвечают за логику извлечения данных и проверку результатов, поэтому Browserless особенно привлекателен, когда управление браузером важнее визуального конструктора роботов.
Преимущества и недостатки
- Поддерживает привычные рабочие процессы с Puppeteer и Playwright
- REST API позволяют собирать данные и экспортировать страницы
- Функции управления сессиями и MCP подходят для интерактивных агентов
- Время работы браузера и дополнительные функции влияют на расход единиц
- Для пользовательского извлечения данных по-прежнему нужна логика приложения
8. ScrapingBee
ScrapingBee — хороший выбор для разработчиков, которым нужен управляемый запрос для сбора данных, а не прямое управление долго работающим браузером. API объединяет получение страниц и их обработку с помощью JavaScript с управлением прокси, а извлекать данные можно по правилам CSS или XPath либо с помощью инструкций для ИИ. Такое сочетание полезно, когда проекту нужны структурированные данные с нескольких сайтов, но команда не хочет самостоятельно обслуживать парк браузеров.
Сценарии на JavaScript могут нажимать кнопки, прокручивать страницы, вводить текст или ждать перед сбором данных. Вывод в формате Markdown подходит для рабочих процессов с ИИ-контентом, а снимки экрана помогают зафиксировать отображённую страницу. В актуальную версию продукта также входят специальные API для отдельных целевых ресурсов, а ещё доступ через CLI и MCP. Для стабильных полей разработчик может задать явные правила извлечения, а если структура страницы или вопрос менее предсказуемы — использовать инструкции на естественном языке.
Отличие от платформы с размещённым браузером проявляется на практике: ScrapingBee ориентирован на запрос и возвращаемый результат, тогда как более широкий рабочий процесс остаётся под управлением пользовательского приложения. Для координации сбора данных с нескольких страниц, удаления дубликатов, планирования обновлений и проверки записей по-прежнему потребуется отдельное решение. Расход кредитов также зависит от используемых функций, включая обработку страниц и варианты прокси. Мы рекомендуем этот сервис командам разработчиков приложений, которым нужен простой интерфейс HTTP и которые хотят управлять оркестрацией конвейера данных в собственном коде.
Преимущества и недостатки
- Правила выбора элементов и извлечение данных с помощью ИИ обеспечивают гибкость
- Обработка страниц и сценарии подходят для интерактивных сайтов
- Markdown, CLI и MCP поддерживают рабочие процессы с ИИ
- Расширенные параметры запросов увеличивают расход кредитов
- Для заданий с несколькими страницами по-прежнему нужна оркестрация
9. Oxylabs
Oxylabs — хороший вариант для команд, которым нужен управляемый доступ к сложным общедоступным сайтам и возможность собирать данные в больших объёмах. В актуальную линейку Web API входит предложение /Scrape для получения и структурирования веб-данных; обработка JavaScript и управление доступом встроены в сервис. В линейку продукта также входят /Search и браузерная инфраструктура, что позволяет командам выбирать подходящий подход в зависимости от того, начинается ли задача с поиска, извлечения данных или взаимодействия с сайтом.
Варианты для конкретных целевых ресурсов помогают получать полезные поля из популярных поисковых систем и интернет-магазинов, а подключение агентов через MCP и Agent Skills позволяет использовать сбор данных в рабочих процессах с ИИ. Oxylabs также продолжает отдельно документировать Classic Web Scraper API. Это различие важно для уже существующих интеграций: командам, которые поддерживают Classic Web Scraper API, следует обращаться к соответствующей документации, а не считать, что пример для более нового Web API можно использовать вместо неё.
Oxylabs наиболее оправдан, когда сложность целевых сайтов, требуемая пропускная способность или затраты на поддержку инфраструктуры доступа делают управляемую платформу целесообразным выбором. При этом приложению всё равно нужно определить требуемую схему данных, период их актуальности и порядок обработки неполных записей. Перед внедрением следует соотнести выбранную версию API, параметры для целевых ресурсов и модель оплаты с реальной задачей. Для небольшого объёма данных, собираемых вручную, визуальный скрапер может оказаться более удобным вариантом.
Преимущества и недостатки
- Инфраструктура для рендеринга и доступа под управлением сервиса
- Варианты структурированного извлечения данных с учетом целевого ресурса
- Текущий Web API поддерживает интеграцию с агентами
- Для классического и текущего API требуется отдельная настройка
- Качество результатов по-прежнему нужно проверять на уровне приложения
10. Diffbot
Мы рекомендуем Diffbot, когда важно понять содержание веб-страницы, а не воспроизвести ее структуру. Сервис Extract использует компьютерное зрение и обработку естественного языка, чтобы классифицировать страницы и формировать структурированные данные в формате JSON по стандартным схемам. Для команды, которая собирает статьи или сведения о товарах из множества источников, это может сократить объем кода для разбора данных с отдельных сайтов, необходимого для преобразования страниц в сопоставимые записи.
Knowledge Graph решает смежную, но отдельную задачу: работу с организациями, людьми, статьями и другими сущностями, уже собранными из общедоступных источников в интернете. Записи могут объединять сведения из нескольких источников и связывать сущности значимыми отношениями. Поэтому Diffbot подходит для обогащения данных, исследования компаний и аналитических приложений, которым нужен контекст за пределами полей, видимых на одной странице.
Компромисс заключается в необходимости учитывать модель данных Diffbot. Стандартизированное извлечение полезно, когда типы страниц и поля соответствуют задаче, но для нестандартного поля или специализированного взаимодействия может понадобиться другой подход. Командам следует различать извлечение данных с выбранных URL и запросы к уже существующему графу знаний, а затем соответствующим образом оценивать полноту охвата и актуальность источников. Diffbot лучше подходит техническим командам, создающим нормализованные информационные продукты, чем пользователям, которым нужно просто скопировать несколько строк в электронную таблицу.
Преимущества и недостатки
- Автоматическая классификация сокращает объем работ по созданию парсеров
- Стандартные схемы помогают нормализовать данные с похожих страниц
- Knowledge Graph дополняет данные контекстом о сущностях
- Стандартных полей может быть недостаточно для специализированных задач
- Извлечение данных и работа с графом знаний подходят для разных сценариев
Часто задаваемые вопросы
Что делает инструмент для веб-скрейпинга ИИ-инструментом?
ИИ помогает определять поля, интерпретировать содержимое страниц, формировать инструкции для извлечения данных или управлять действиями в браузере. Одни инструменты используют ИИ при настройке, другие — при каждом извлечении данных. Кроме того, сервис может поддерживать ИИ-приложения, предоставляя им чистые данные без обращения к языковой модели для каждого запроса. Выбирайте возможности, которые решают вашу задачу по сбору данных, а не ориентируйтесь только на название.
Чем скрейпинг отличается от автоматизации браузера?
Скрейпинг собирает информацию. Автоматизация браузера выполняет действия на странице: например, открывает меню, вводит поисковый запрос или проходит многоэтапный сценарий. Эти методы часто применяются вместе: автоматизированный браузер открывает нужное состояние страницы, после чего этап извлечения данных собирает необходимые поля. Если такое взаимодействие не требуется, обычно проще отправить прямой запрос к API.
Какие инструменты лучше подходят для команды без технической подготовки?
Для простого регулярного сбора данных и отслеживания изменений мы в первую очередь рекомендуем Browse AI. Хорошая альтернатива — Octoparse, если команде нужен более гибкий визуальный контроль над этапами задачи. Оба инструмента эффективнее всего работают, когда кто-то проверяет полученные записи и отслеживает изменения на исходном сайте.
Какие данные следует сохранять при подготовке конвейера ИИ или RAG?
Сохраняйте URL источника, время сбора данных, заголовок страницы, а также текст или структурированные поля, необходимые приложению. Формат Markdown позволяет сохранить удобную для чтения структуру документа, а JSON подходит для записей с заданной схемой. Удаляйте дубликаты и не смешивайте навигационные элементы с основным содержимым. Сохранение сведений об источнике упрощает проверку ответов и обновление данных в дальнейшем.
В каких случаях стоит использовать управляемый браузер?
Управляемый браузер полезен, если для сбора данных требуется выполнение JavaScript, несколько взаимодействий со страницей или сохранение сессии, а команда не хочет размещать у себя процессы браузера. Browserless — специализированное решение для уже существующего кода на Puppeteer или Playwright. Для одной статической страницы может хватить более простого API для загрузки или извлечения данных, которое потребует меньше ресурсов.
Означают ли 1 000 бесплатных единиц 1 000 операций скрейпинга?
Нет. Правила учета единиц и кредитов у каждого провайдера свои. Browserless учитывает подключения браузера интервалами продолжительностью до 30 секунд; прокси-трафик и решение CAPTCHA дополнительно расходуют единицы. Другие сервисы взимают плату с учетом параметров запроса, количества записей или вычислительных ресурсов. Оценивайте стоимость всего процесса, а не приравнивайте друг к другу разные лимиты бесплатных тарифов.
Можно ли доверять результату извлечения данных с помощью ИИ без проверки?
Даже корректный ответ в формате JSON может не содержать нужную запись или неверно интерпретировать поле. Задайте обязательные поля, проверяйте типы и диапазоны значений, выборочно сверяйте исходные страницы и отслеживайте изменения количества записей. Для регулярных задач полезнее явно обрабатывать ошибки и пустые результаты, чем считать каждый ответ полным набором данных.
Заключение: инструменты для веб-скрейпинга с помощью ИИ
Bright Data — наш лучший выбор для масштабной программы сбора данных из интернета, а Firecrawl — оптимальный вариант для начала работы с преобразованием веб-страниц в контент, готовый для использования ИИ. Выбирайте Apify, если для проекта важны повторно используемые инструменты, запланированные задачи и работа в облаке.
Для бизнес-команд Browse AI упрощает регулярный мониторинг, а Octoparse позволяет пользователям настраивать более сложные задачи извлечения данных с помощью визуального интерфейса. SearchAPI — специализированное решение, если на выходе нужны структурированные поисковые данные.
Browserless заслуживает внимания разработчиков, которым нужно управляемое выполнение браузерных задач с помощью привычных библиотек автоматизации. ScrapingBee — достойная альтернатива, если управляемый запрос на извлечение данных лучше подходит приложению. Oxylabs подходит для сложных задач по сбору данных из открытого интернета, а Diffbot выделяется стандартизированным извлечением данных и анализом сущностей.
Лучший вариант на перспективу — тот, который предоставляет нужную информацию и предлагает рабочий процесс, который ваша команда сможет поддерживать. Подбирайте метод сбора данных под задачу, сохраняйте контекст источника и оценивайте ценность по тому, насколько результат пригоден к использованию, а не по количеству запрошенных страниц.




