

Модели и платформы ИИ
AniPortrait: Аудио-ориентированная синтеза фотorealistic портретной анимации

 Добавьте Unite.AI в избранные источники в Google
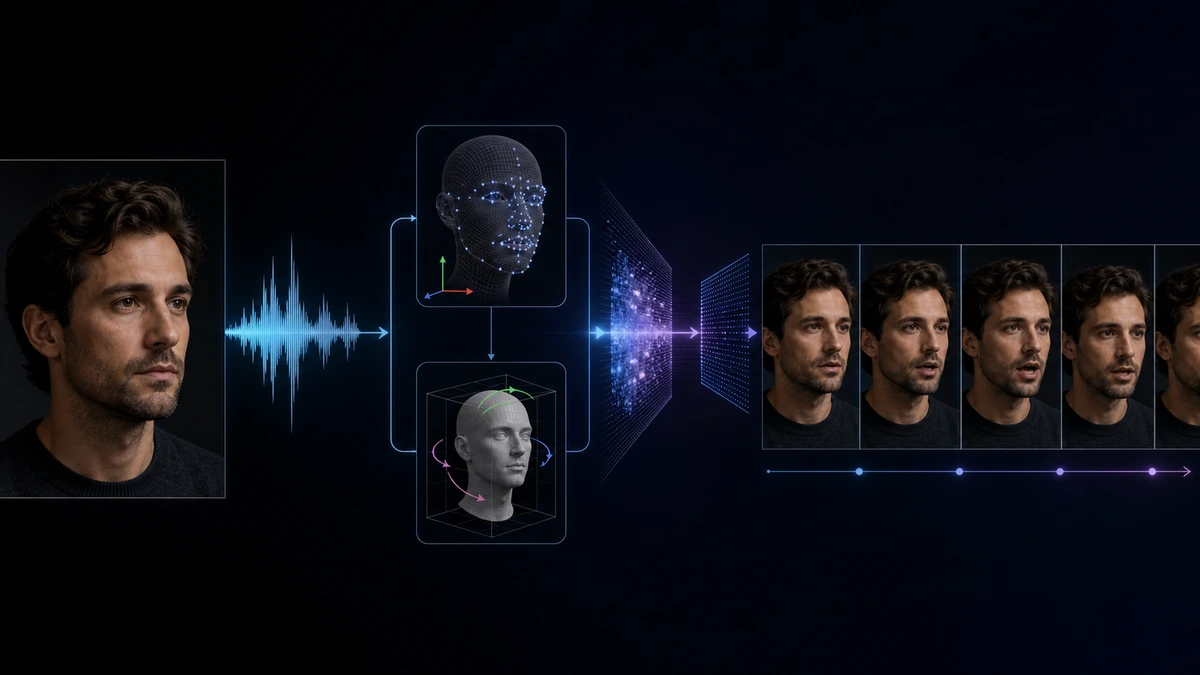
За годы создания реалистичных и выразительных портретных анимаций из статических изображений и аудио нашли широкое применение в играх, цифровых СМИ, виртуальной реальности и многом другом. Несмотря на потенциальное применение, разработчикам все еще сложно создавать рамки, способные генерировать высококачественные анимации, которые сохраняют временную последовательность и визуально привлекательны. Основной причиной этой сложности является необходимость сложной координации движений губ, положения головы и выражений лица, чтобы создать визуально привлекательный эффект.
В этой статье мы будем говорить об AniPortrait, новой рамке, предназначенной для генерации высококачественных анимаций, управляемых ссылочным изображением портрета и аудио-примером. Работа рамки AniPortrait делится на два этапа. Сначала рамка AniPortrait извлекает промежуточные 3D-представления из аудио-примеров и проецирует их в последовательность 2D-ориентиров лица. Затем рамка использует прочную диффузионную модель, объединенную с модулем движения, чтобы преобразовать последовательность ориентиров в временно последовательные и фотorealistic анимации. Экспериментальные результаты демонстрируют превосходство и способность рамки AniPortrait генерировать высококачественные анимации с исключительным визуальным качеством, разнообразием поз и естественностью лица, предлагая улучшенный и обогащенный перцептивный опыт. Кроме того, рамка AniPortrait имеет замечательный потенциал в плане управляемости и гибкости и может быть эффективно применена в таких областях, как переигрывание лица, редактирование движения лица и многое другое. Эта статья направлена на углубленное изучение рамки AniPortrait, и мы исследуем механизм, методологию, архитектуру рамки, а также ее сравнение с рамками, являющимися лучшими в своей области. Итак, давайте начнем.
AniPortrait: Фотorealistic портретная анимация
Создание реалистичных и выразительных портретных анимаций было предметом внимания исследователей в течение некоторого времени, благодаря их невероятному потенциалу и применению, охватывающему цифровые СМИ, виртуальную реальность, игры и многое другое. Несмотря на годы исследований и разработок, производство высококачественных анимаций, которые сохраняют временную последовательность и визуально привлекательны, все еще представляет значительную проблему. Основным препятствием для разработчиков является необходимость сложной координации между положением головы, визуальными выражениями и движением губ, чтобы создать визуально привлекательный эффект. Существующие методы не смогли преодолеть эти проблемы, в основном потому, что большинство из них полагаются на ограниченные возможности генераторов, такие как NeRF, декодеры, основанные на движении, и GAN для создания визуального контента. Эти сети демонстрируют ограниченные возможности обобщения и нестабильны при генерации высококачественного контента. Однако недавнее появление диффузионных моделей облегчило генерацию высококачественных изображений, и некоторые рамки, построенные на основе диффузионных моделей, вместе с временными модулями, облегчили создание привлекательных видео, позволяя диффузионным моделям преуспеть.
Основываясь на достижениях диффузионных моделей, рамка AniPortrait направлена на генерацию высококачественных анимированных портретов, используя ссылочное изображение и аудио-пример. Работа рамки AniPortrait делится на два этапа. На первом этапе рамка AniPortrait использует модели, основанные на трансформерах, чтобы извлечь последовательность 3D-решетки лица и положения головы из аудио-входа и проецирует их затем в последовательность 2D-ориентиров лица. Первый этап позволяет рамке AniPortrait захватить движение губ и тонкие выражения из аудио, а также движения головы, синхронизированные с ритмом аудио-примера. На втором этапе рамка AniPortrait использует прочную диффузионную модель и интегрирует ее с модулем движения, чтобы преобразовать последовательность ориентиров в фотorealistic и временно последовательные анимации. Более конкретно, рамка AniPortrait опирается на архитектуру сети от существующей модели AnimateAnyone, которая использует Stable Diffusion 1.5, мощную диффузионную модель, чтобы генерировать реалистичные и плавные анимации на основе ссылочного изображения и последовательности движения тела. Что стоит отметить, так это то, что рамка AniPortrait не использует модуль pose guider внутри этой сети, как это реализовано в рамке AnimateAnyone, но перерабатывает его, позволяя рамке AniPortrait не только сохранять легкую конструкцию, но и демонстрировать повышенную точность при генерации движения губ.
Экспериментальные результаты демонстрируют превосходство рамки AniPortrait в создании анимаций с впечатляющей естественностью лица, отличным визуальным качеством и разнообразием поз. Используя 3D-представления лица как промежуточные особенности, рамка AniPortrait приобретает гибкость для изменения этих представлений по мере необходимости. Эта адаптивность значительно повышает применимость рамки AniPortrait в различных областях, включая переигрывание лица и редактирование движения лица.
AniPortrait: Работа и методология
Предложенная рамка AniPortrait состоит из двух модулей, а именно Lmk2Video и Audio2Lmk. Модуль Audio2Lmk пытается извлечь последовательность ориентиров, которая захватывает тонкие движения губ и выражения лица из аудио-входа, в то время как модуль Lmk2Video использует эту последовательность ориентиров, чтобы генерировать высококачественные портретные видео с временной стабильностью. Следующая фигура представляет обзор работы рамки AniPortrait. Как можно наблюдать, рамка AniPortrait сначала извлекает 3D-решетку лица и положение головы из аудио, и проецирует эти два элемента в 2D-ключевые точки затем. На втором этапе рамка использует диффузионную модель, чтобы преобразовать 2D-ключевые точки в портретное видео, причем два этапа обучаются одновременно внутри сети.

Audio2Lmk
Для заданной последовательности фрагментов речи основной целью рамки AniPortrait является предсказание соответствующей 3D-решетки лица с векторными представлениями перевода и вращения. Рамка AniPortrait использует предварительно обученный метод wav2vec, чтобы извлечь аудио-особенности, и модель демонстрирует высокую степень обобщения, способную точно распознавать интонацию и произношение из аудио, что играет решающую роль в генерации реалистичных анимаций лица. Используя полученные прочные аудио-особенности, рамка AniPortrait может эффективно использовать простую архитектуру, состоящую из двух слоев fc, чтобы преобразовать эти особенности в 3D-решетки лица. Рамка AniPortrait наблюдает, что этот прямой дизайн, реализованный моделью, не только повышает эффективность процесса вывода, но и обеспечивает точность. Когда аудио преобразуется в позу, рамка AniPortrait использует ту же сеть wav2vec в качестве основы, хотя модель не делится весами с модулем аудио в решетку. Это в основном связано с тем, что поза более связана с тоном и ритмом, присутствующими в аудио, что имеет другой акцент по сравнению с задачами аудио в решетку. Чтобы учесть влияние предыдущих состояний, рамка AniPortrait использует декодер трансформера, чтобы декодировать последовательность поз. Во время этого процесса рамка интегрирует аудио-особенности в декодер с помощью механизмов перекрестного внимания, и для обоих модулей рамка обучает их с использованием потери L1. Как только модель получает последовательность поз и решетки, она использует перспективную проекцию, чтобы преобразовать эти последовательности в 2D-последовательность ориентиров лица, которые затем используются в качестве входных сигналов для следующего этапа.
Lmk2Video
Для заданного ссылочного изображения портрета и последовательности ориентиров лица предложенный модуль Lmk2Video создает временно последовательную портретную анимацию, и эта анимация соответствует движению с последовательностью ориентиров, сохраняет внешний вид, последовательный с ссылочным изображением, и, наконец, рамка представляет портретную анимацию как последовательность портретных кадров. Дизайн сети модуля Lmk2Video черпает вдохновение из существующей рамки AnimateAnyone. Рамка AniPortrait использует Stable Diffusion 1.5, чрезвычайно мощную диффузионную модель, в качестве основы, и включает в себя временный модуль движения, который эффективно преобразует многофреймовый шумовый вход в последовательность видеокадров. В то же время компонент сети ReferencenNet отражает структуру Stable Diffusion 1.5 и использует ее, чтобы извлечь информацию о внешнем виде из ссылочного изображения, и интегрирует ее в основу. Стратегический дизайн обеспечивает, что идентификатор лица остается последовательным на протяжении всего выходного видео. Отличаясь от рамки AnimateAnyone, рамка AniPortrait повышает сложность дизайна модуля PoseGuider. Оригинальная версия рамки AnimateAnyone состоит только из нескольких слоев свертки после того, как особенности ориентиров объединяются с латентными входными данными на входном слое основы. Рамка AniPortrait обнаруживает, что этот дизайн не справляется с захватом тонких движений губ, и чтобы решить эту проблему, рамка принимает многоуровневую стратегию архитектуры ConvNet и включает особенности ориентиров соответствующих масштабов в различные блоки основы. Кроме того, рамка AniPortrait вводит дополнительное улучшение, включая ориентиры ссылочного изображения в качестве дополнительного входа. Модуль перекрестного внимания компонента PoseGuider облегчает взаимодействие между целевыми ориентирами каждого кадра и ориентирами ссылочного изображения. Этот процесс предоставляет сети дополнительные подсказки, чтобы понять связь между внешним видом и ориентирами лица, тем самым помогая в генерации портретных анимаций с более точным движением.
AniPortrait: Реализация и результат
Для этапа Audio2Lmk рамка AniPortrait принимает компонент wav2vec2.0 в качестве основы и использует архитектуру MediaPipe, чтобы извлечь 3D-решетки и 6D-позы для аннотаций. Модель получает обучающие данные для компонента Audio2Mesh из своего внутреннего набора данных, который включает почти 60 минут высококачественных данных речи, полученных от одного диктора. Чтобы обеспечить стабильность 3D-решетки, извлеченной компонентом MediaPipe, голосовой актер инструктируется лицом к камере и сохранять устойчивое положение головы на протяжении всего процесса записи. Для модуля Lmk2Video рамка AniPortrait реализует двухэтапный подход к обучению. На первом этапе рамка фокусируется на обучении ReferenceNet и PoseGuider, 2D-компонента основы, и исключает модуль движения. На втором этапе рамка AniPortrait замораживает все остальные компоненты и концентрируется на обучении модуля движения. Для этого этапа рамка использует два крупномасштабных высококачественных набора данных видео лица, чтобы обучить модель, и обрабатывает все данные с помощью компонента MediaPipe, чтобы извлечь 2D-ориентиры лица. Кроме того, чтобы повысить чувствительность сети к движению губ, модель AniPortrait различает верхнюю и нижнюю губы разными цветами при рендеринге изображения позы из 2D-ориентиров.
Как демонстрируется на следующем изображении, рамка AniPortrait генерирует ряд анимаций, демонстрирующих превосходное качество и реализм.

Рамка затем использует промежуточное 3D-представление, которое можно редактировать, чтобы манипулировать выходными данными по мере необходимости. Например, пользователи могут извлечь ориентиры из определенного источника и изменить его идентификатор, позволяя рамке AniPortrait создать эффект переигрывания лица.
Финальные мысли
В этой статье мы говорили о рамке AniPortrait, новой рамке, предназначенной для генерации высококачественных анимаций, управляемых ссылочным изображением портрета и аудио-примером. Просто вводя ссылочное изображение и аудио-клип, рамка AniPortrait способна генерировать портретное видео, демонстрирующее естественное движение головы и плавное движение губ. Используя прочные возможности обобщения диффузионной модели, рамка AniPortrait генерирует анимации, демонстрирующие впечатляющее реалистичное качество изображения и реалистичное движение. Работа рамки AniPortrait делится на два этапа. Сначала рамка AniPortrait извлекает промежуточные 3D-представления из аудио-примеров и проецирует их в последовательность 2D-ориентиров лица. Затем рамка использует прочную диффузионную модель, объединенную с модулем движения, чтобы преобразовать последовательность ориентиров в временно последовательные и фотorealistic анимации. Экспериментальные результаты демонстрируют превосходство и способность рамки AniPortrait генерировать высококачественные анимации с исключительным визуальным качеством, разнообразием поз и естественностью лица, предлагая улучшенный и обогащенный перцептивный опыт. Кроме того, рамка AniPortrait имеет замечательный потенциал в плане управляемости и гибкости и может быть эффективно применена в таких областях, как переигрывание лица, редактирование движения лица и многое другое.


