Взгляд Anderson
Маттинг изображений с помощью ИИ с пониманием сцены

 Добавьте Unite.AI в избранные источники в Google
Ключевые моментыВырезание с помощью ИИ теперь использует понимание сцены для замены зелёных экранов.
Показать больше
- Вырезание с помощью ИИ теперь использует понимание сцены для замены зелёных экранов.
- Новый конвейер SPG-IM значительно превосходит методы без тримапов.
- Текстовые метки предлагают недорогую альтернативу дорогостоящей попиксельной аннотации.
В документальном фильме, вошедшем в дополнительные материалы DVD-издания фильма Alien3 (1992), выпущенного в 2003 году, легенда визуальных эффектов Ричард Эдлунд с ужасом вспоминал о «борьбе сумо» — так он описывал фотохимическое извлечение масок, которое доминировало в работе над визуальными эффектами с конца 1930-х годов до конца 1980-х. Эдлунд сравнил непредсказуемость этого процесса с «борьбой сумо», противопоставив его цифровым технологиям с синим и зеленым экраном, которые пришли ему на смену в начале 1990-х (и с тех пор он снова обращался к этой метафоре).
Изначально передний план — например, человека или модель космического корабля — отделяли от фона, снимая объект на ровном синем или зеленом фоне, чтобы затем совместить вырезанное изображение с фоновой подложкой.
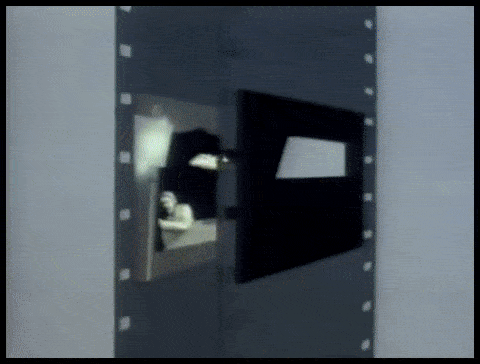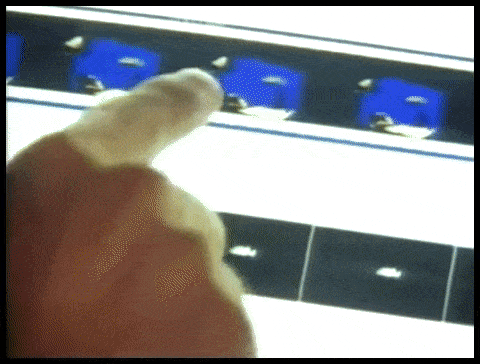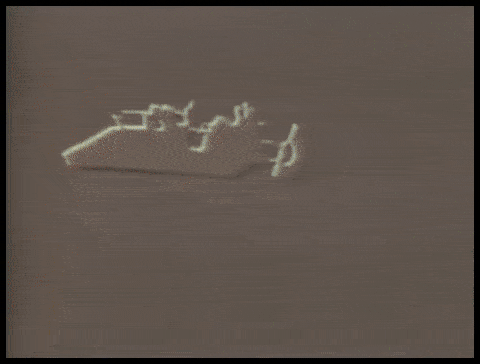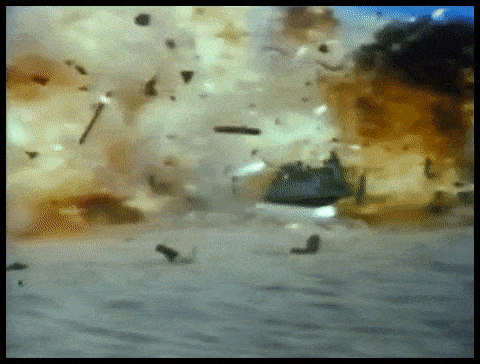
Трудоемкие фотохимические процессы извлечения масок для кадра с визуальными эффектами, созданного ILM для фильма «Возвращение джедая» (1983).
На полученных кадрах цвет фона затем химическим способом выделяли и использовали как шаблон для повторной печати объекта переднего плана (или человека) на оптическом принтере — так он выглядел «парящим» на прозрачном участке пленки.
Этот процесс назывался наложением с разделением цветов (CSO), однако со временем этот термин стал ассоциироваться прежде всего с примитивными видеоэффектами «хромакей» в телепередачах с небольшим бюджетом, выходивших в 1970-х и 1980-х годах: для их создания использовали аналоговые, а не химические или цифровые методы.

Демонстрация наложения с разделением цветов в 1970 году в британской детской программе «Blue Peter». Источник: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
В любом случае, будь то кино- или видеоматериалы, извлеченные кадры затем можно было вставить в любые другие кадры.
Хотя принадлежащий компании Disney и заметно более дорогой метод натриевого пара (он выделял именно желтый цвет и также применялся при создании фильма ужасов Альфреда Хичкока «The Birds» 1963 года) обеспечивал более четкие контуры и маски, фотохимическое извлечение по-прежнему оставалось кропотливым и ненадежным процессом.

Для собственного метода извлечения масок с помощью натриевого пара, разработанного Disney, требовался фон с цветом, близким к желтому на спектре. На снимке Анджела Лэнсбери подвешена на тросах во время съемок сцены с визуальными эффектами для фильма «Bedknobs and Broomsticks» (1971). Источник
За пределами цифрового маттинга
В 1990-х цифровая революция позволила отказаться от химикатов, но потребность в зеленых экранах никуда не исчезла. Теперь удалить зеленый (или любой другой) фон можно было, просто найдя в программах для редактирования изображений, таких как Photoshop, пиксели нужного цвета с заданным допуском. Появилось и новое поколение программ для видеомонтажа, способных автоматически удалять цветной фон. Почти в одночасье шестьдесят лет истории оптической печати канули в прошлое.
Исследования в области компьютерного зрения с ускорением на графических процессорах, ведущиеся последние десять лет, открывают третий этап развития извлечения масок: исследователям предстоит создать системы, способные формировать маски высокого качества без зеленого экрана. На Arxiv статьи о новых разработках в области машинного обучения для извлечения объектов переднего плана появляются каждую неделю.
Поместить нас в кадр
Интерес академических кругов и индустрии к извлечению объектов с помощью ИИ уже отразился на потребительских технологиях: всем знакомы примитивные, но вполне работоспособные фильтры в Zoom и Skype, которые во время видеозвонков могут заменить фон в нашей гостиной на тропические острова и тому подобное.
Однако для получения самых качественных масок по-прежнему нужен зеленый экран, как отметила Zoom в прошлую среду.

Слева — мужчина перед зеленым экраном; волосы хорошо выделены с помощью функции «Виртуальный фон» в Zoom. Справа — женщина на фоне обычной домашней обстановки; волосы выделены алгоритмически, менее точно и с большими вычислительными затратами. Источник: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
В еще одной публикации на платформе поддержки Zoom предупреждается, что извлечение объектов без зеленого экрана также требует большей вычислительной мощности от устройства захвата.
Необходимость вырезать фон
Повышение качества, портативности и экономичности систем выделения маски «в естественных условиях» (то есть изоляции людей без необходимости использовать зеленый экран) актуально для гораздо большего числа отраслей и сфер деятельности, чем одни лишь фильтры для видеоконференций.
При создании наборов данных улучшенное распознавание лиц, целых голов и тел позволяет не допустить, чтобы посторонние элементы фона попадали в обучающие данные моделей компьютерного зрения, работающих с изображениями людей; более точная изоляция объектов значительно повысила бы эффективность методов семантической сегментации, предназначенных для различения и усвоения категорий (то есть «кошки», «человека», «лодки»), а также систем синтеза изображений на основе VAE и трансформеров, таких как новая разработка OpenAI DALL-E 2; кроме того, более совершенные алгоритмы выделения объектов сократили бы необходимость в дорогостоящем ручном ротоскопировании в ресурсоемких процессах создания визуальных эффектов.
На самом деле, все более широкое распространение мультимодальных методов (обычно текстовых и визуальных), при которых такая категория, как «кошка», кодируется и в виде изображения, и с помощью связанных с ним текстовых описаний, уже начинает проникать в сферу обработки изображений. Один из недавних примеров — архитектура Text2Live, использующая мультимодальное обучение (на текстовых и визуальных данных) для создания видео, в том числе, среди множества других возможностей, с хрустальными лебедями и стеклянными жирафами.
ИИ-маттинг с учетом сцены
Большая часть исследований автоматического маттинга на основе ИИ сосредоточена на распознавании границ и оценке групп пикселей внутри изображения или видеокадра. Однако новое исследование из Китая предлагает конвейер обработки, который улучшает очерчивание объектов и качество маттинга за счет использования текстовых описаний сцены — мультимодального подхода, который набирает популярность в исследованиях компьютерного зрения на протяжении последних 3–4 лет. Авторы утверждают, что их метод превосходит предыдущие по ряду параметров.

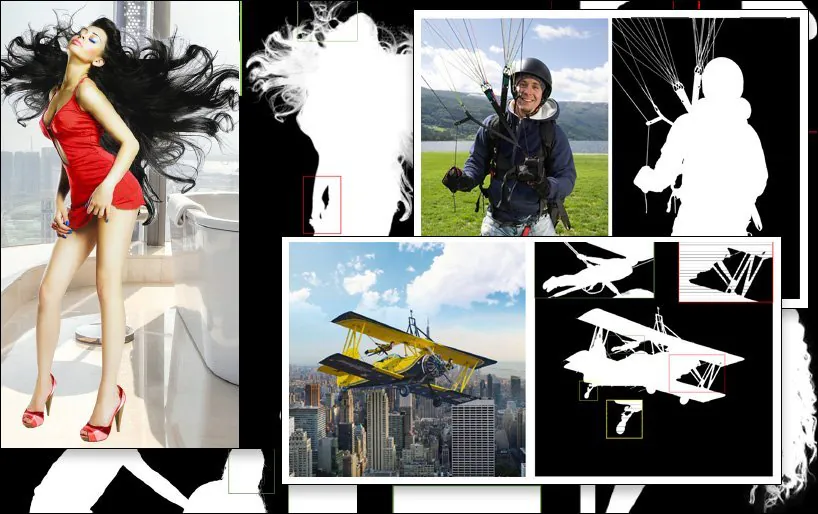
Пример выделения объекта методом SPG-IM (последнее изображение, внизу справа) в сравнении с конкурирующими прежними методами. Источник: https://arxiv.org/pdf/2204.09276.pdf
Задача исследований в области выделения объектов — разработать рабочие процессы, требующие минимальной ручной разметки и вмешательства человека, а в идеале обходящиеся без них вовсе. Помимо связанных с этим затрат, авторы новой работы отмечают, что разметка и ручная сегментация, выполняемые привлеченными краудворкерами из разных культур, могут приводить к тому, что изображения будут помечать или даже сегментировать по-разному, из-за чего алгоритмы получаются непоследовательными и неудовлетворительными.
Один из примеров — субъективная трактовка того, что считать «объектом переднего плана»:

Из новой статьи: прежние методы LFM и MODNet («GT» означает Ground Truth — «истинные данные», то есть «идеальный» результат, которого часто добиваются вручную или неалгоритмическими методами) по-разному и с неодинаковой эффективностью определяют содержимое переднего плана, тогда как новый метод SPG-IM точнее очерчивает «близкие объекты», учитывая контекст сцены.
Чтобы решить эту задачу, исследователи разработали двухэтапный конвейер под названием Маттинг изображений с учетом ситуационного восприятия (SPG-IM). Двухэтапная архитектура кодировщика-декодировщика включает Situational Perception Distillation (SPD) и Situational Perception Guided Matting (SPGM).

Архитектура SPG-IM.
Сначала SPD предварительно обучает преобразования визуальных признаков в текстовые и генерирует подписи, соответствующие изображениям. Затем для прогнозирования маски переднего плана конвейер дополняют новым методом предсказания зрительной заметности.
Затем SPGM формирует расчетную альфа-маску на основе исходного изображения RGB и маски, созданной первым модулем.
Цель — обеспечить ситуационное восприятие: система должна понимать контекст и содержимое изображения, чтобы, например, решать задачу выделения сложных прядей волос на фоне с учетом известных особенностей этой конкретной задачи.

В примере ниже SPG-IM понимает, что стропы являются неотъемлемой частью «парашюта», тогда как MODNet не сохраняет и не выделяет эти детали. Аналогичным образом на изображении выше MODNet произвольно теряет целостную структуру игрового оборудования на площадке.
Новая статья называется Situational Perception Guided Image Matting и подготовлена исследователями из OPPO Research Institute, PicUp.ai и Xmotors.
Интеллектуальные автоматизированные маски
SPG-IM также предлагает сеть уточнения Adaptive Focal Transformation (AFT), которая может отдельно обрабатывать локальные детали и глобальный контекст, создавая «интеллектуальные маски».

Понимание контекста сцены — в данном случае «девочка с лошадью» — потенциально может упростить выделение переднего плана по сравнению с прежними методами.
В статье говорится:
«Мы считаем, что визуальные представления, полученные в задачах преобразования визуальной информации в текст, например при создании подписей к изображениям, опираются на более полные с семантической точки зрения сигналы: а) связи между объектами и б) связи объектов с окружающей средой. Это позволяет создавать описания, охватывающие как общую информацию, так и локальные детали. Кроме того, в отличие от затратной попиксельной разметки изображений для маттинга, текстовые метки можно собирать в больших объемах с очень низкими затратами».
Ветвь SPD архитектуры проходит предварительное обучение совместно с текстовым декодером на основе трансформера VirTex Мичиганского университета, который обучается визуальным представлениям на основе семантически насыщенных подписей к изображениям.

VirTex совместно обучает ConvNet и трансформеры на парах «изображение — подпись» и переносит полученные знания на последующие задачи компьютерного зрения, например обнаружение объектов. Источник: https://arxiv.org/pdf/2006.06666.pdf
Помимо других тестов и абляционных исследований, исследователи сравнили SPG-IM с передовыми методами на основе тримапа: Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA и Semantic Image Matting (SIM).
В число проверенных ранее разработанных систем также вошли методы без тримапа: LFM, HAttMatting и MODNet. Для корректного сравнения тестируемые методы адаптировали с учетом различий в методиках; если исходный код был недоступен, методы из статьи воспроизводили по описанной архитектуре.
В новой статье говорится:
«Наша модель SPG-IM значительно превосходит все конкурирующие методы без тримапа ([LFM], [HAttMatting] и [MODNet]). Кроме того, по всем четырем метрикам на общедоступных наборах данных (Composition-1K, Distinction-646 и Human-2K), а также на нашем тестовом наборе Multi-Object-1K наша модель демонстрирует заметное превосходство над передовыми методами на основе тримапов и масок».
Далее авторы отмечают:
«Очевидно, что наш метод сохраняет мелкие детали (например, кончики волос, прозрачные текстуры и границы) без использования тримапа. Кроме того, по сравнению с другими конкурирующими моделями без тримапа SPG-IM лучше сохраняет общую семантическую полноту».


Впервые опубликовано 24 апреля 2022 года.