
Взгляд Anderson
Согласованное редактирование видеоконтента с помощью ИИ и текстовых указаний

 Добавьте Unite.AI в избранные источники в Google
Ключевые моментыText2Live позволяет выполнять согласованные изменения видео по текстовым запросам без…
Показать больше
- Text2Live позволяет выполнять согласованные изменения видео по текстовым запросам без покадровой обработки.
- Система использует нейронный слоистый атлас для однократного применения изменений ко всей временной шкале видео.
- Text2Live автоматизирует маскирование и композитинг, устраняя необходимость в ротоскопировании или хромакее.
Хотя профессиональное сообщество визуальных эффектов заинтересовано – и иногда чувствует угрозу – новыми инновациями в синтезе изображений и видео, отсутствие временной непрерывности в большинстве проектов видеомонтажа на основе ИИ отводит многие из этих усилий в сферу «психоделики», с мерцающими и быстро меняющимися текстурами и структурами, несогласованными эффектами и грубыми технологическими манипуляциями, напоминающими фотохимическую эпоху визуальных эффектов.
Если вы хотите изменить что-то очень конкретное в видео, что не входит в сферу глубоких подделок (т. е. наложения новой личности на существующую запись человека), большинство текущих решений работают под довольно строгими ограничениями в плане точности, необходимой для производства высококачественных визуальных эффектов.
Одним из исключений является продолжающаяся работа свободного объединения академиков из Института Вейцмана. В 2021 году три его исследователя, в сотрудничестве с Adobe (ADBE ), объявили о новом методе разложения видео и наложения последовательной внутренней карты – слоистой нейронной карты – в составной результат с альфа-каналами и согласованностью во времени.
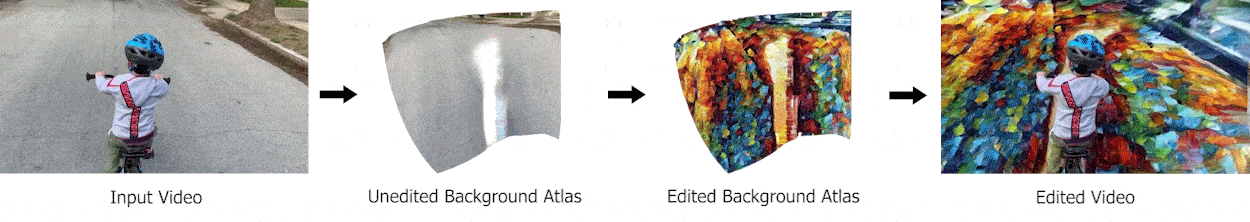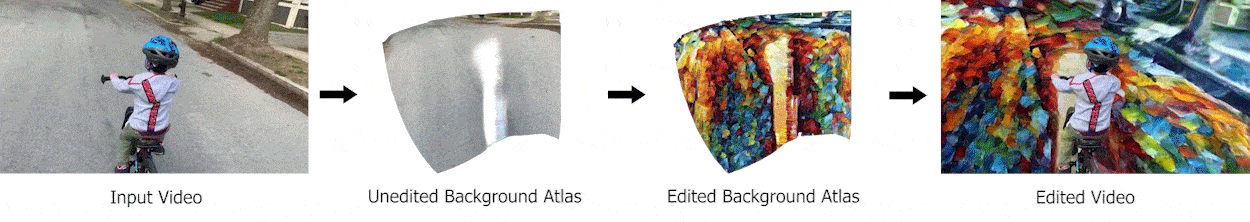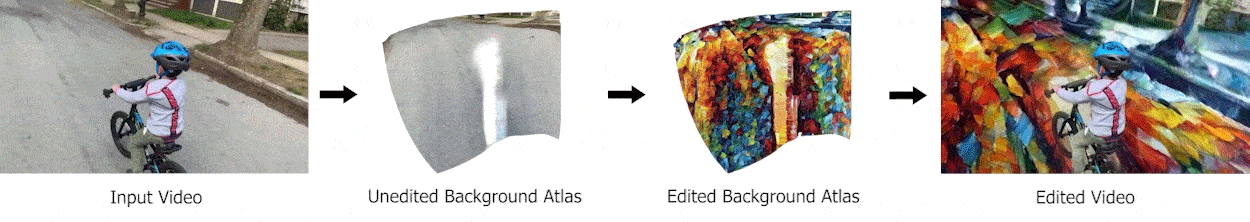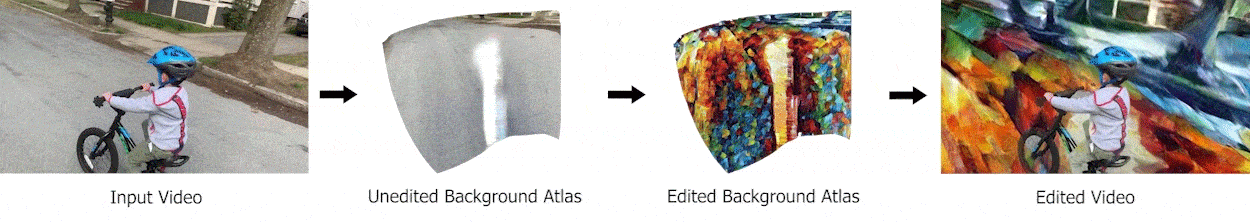
Из статьи 2021 года: оценка полного прохождения дороги в исходном клипе редактируется с помощью нейронной сети так, что традиционно потребовало бы обширного ротоскопирования и матч-мувинга. Поскольку элементы фона и переднего плана обрабатываются разными сетями, маски действительно ‘автоматические’. Источник: https://layered-neural-atlases.github.io/
Хотя это попадает в сферу, покрытую оптическим потоком в пайплайнах VFX, слоистая карта не имеет прямого аналога в традиционных рабочих процессах CGI, поскольку она по сути представляет собой ‘временную текстурную карту’, которую можно производить и редактировать с помощью традиционных программных методов. На втором изображении в иллюстрации выше фон дороги представлен (фигурально) на протяжении всего времени выполнения видео. Изменение этого базового изображения (третье изображение слева в иллюстрации выше) производит последовательное изменение фона.
Изображения ‘развернутой’ карты выше представляют только отдельные интерпретированные кадры; последовательные изменения в любом целевом кадре видео отображаются обратно в исходный кадр, сохраняя необходимые перекрытия и другие необходимые эффекты сцены, такие как тени или отражения.
Основная архитектура использует многослойный перцептрон (MLP) для представления развернутых атласов, альфа-каналов и карт, все из которых оптимизируются вместе и полностью в 2D-пространстве, исключая необходимость предварительных знаний о точках 3D-геометрии, как в NeRF, картах глубины и подобных атрибутах CGI.
Опорный атлас отдельных объектов также можно надежно изменить:
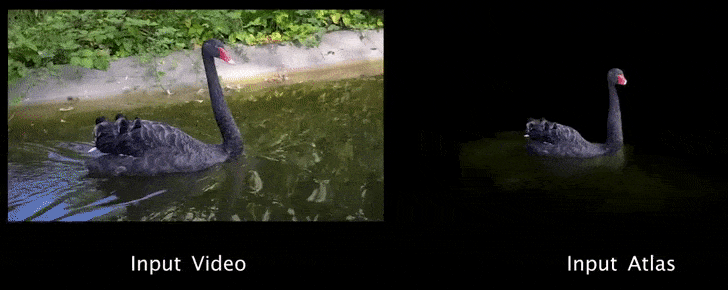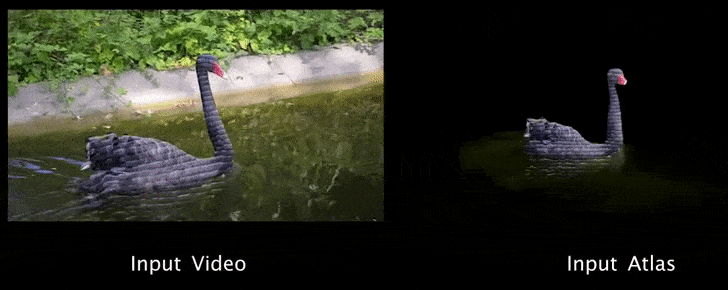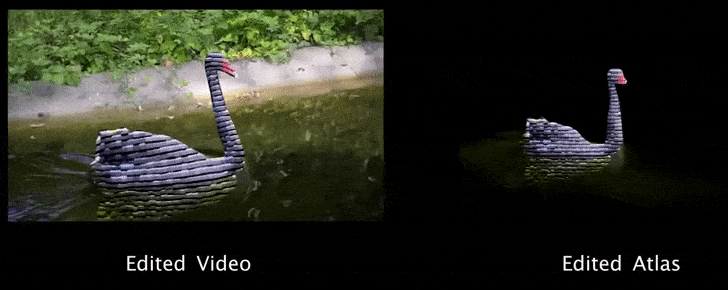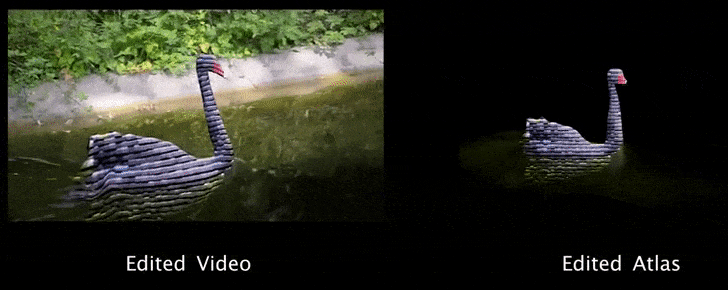
Последовательное изменение движущегося объекта в рамках работы 2021 года. Источник: https://www.youtube.com/watch?v=aQhakPFC4oQ
По сути, система 2021 года объединяет выравнивание геометрии, матч-мувинг, картографирование, ретекстуризацию и ротоскопирование в дискретный нейронный процесс.
Text2Live
Три автора первоначальной статьи 2021 года, вместе с исследователями NVIDIA (NVDA ), входят в число авторов нового усовершенствования на основе этого метода, который объединяет силу слоистых атласов с текстово-управляемой технологией CLIP, которая вернулась в центр внимания на этой неделе с выпуском DALL-E 2 от OpenAI.
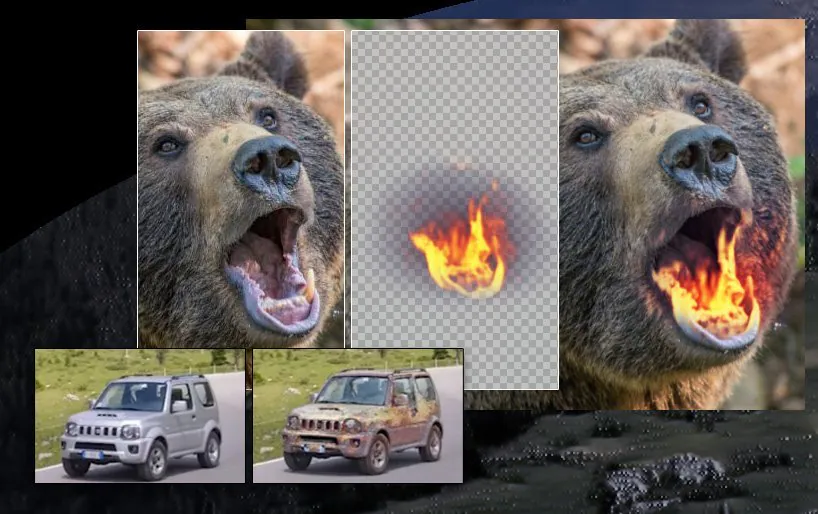
Новая архитектура, озаглавленная Text2Live, позволяет конечному пользователю создавать локализованные правки реального видеоконтента на основе текстовых подсказок:
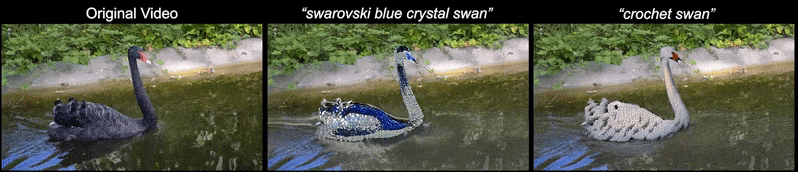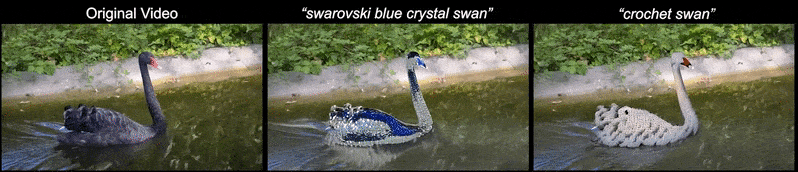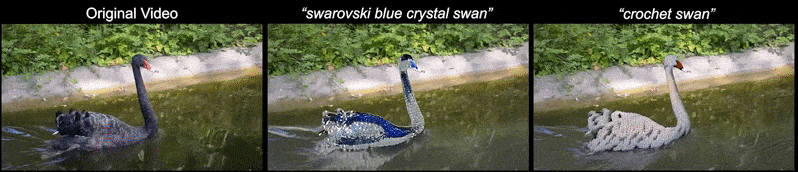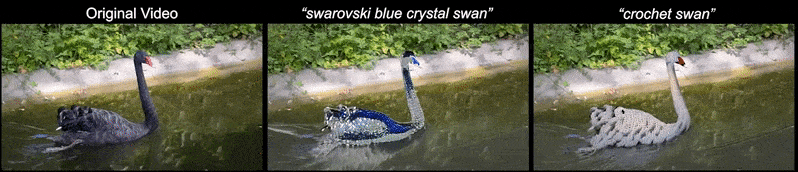
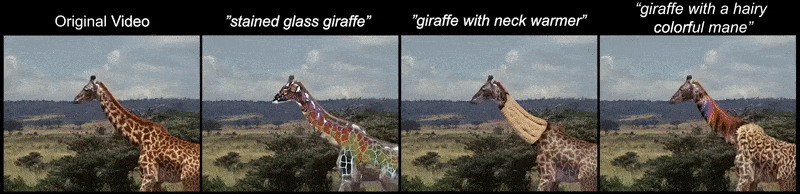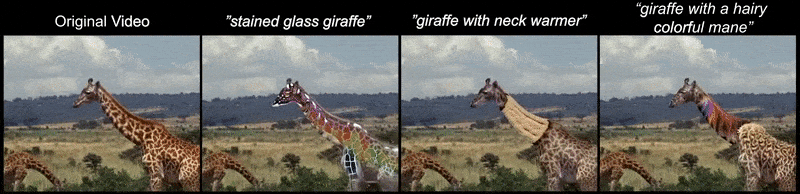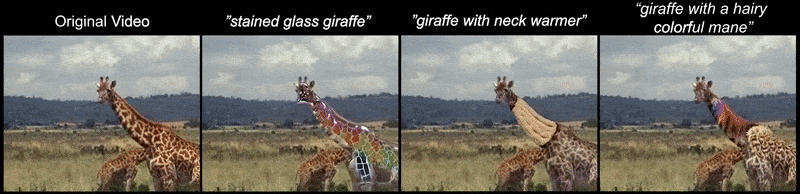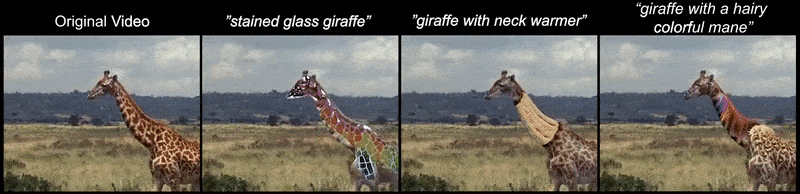
Два примера редактирования переднего плана. Для лучшего разрешения и четкости посетите оригинальные видео по адресу https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live предлагает семантическое и высоко локализованное редактирование без использования предварительно обученного генератора, используя внутреннюю базу данных, специфичную для видеоклипа, подвергающегося влиянию.

Преобразования фона и объекта под Text2Live. Источник: https://text2live.github.io/sm/pages/video_results_atlases.html
Техника не требует масок, предоставленных пользователем, таких как типичный рабочий процесс ротоскопирования или зеленого экрана, а скорее оценивает карты релевантности через технику бутстрэппинга на основе исследований 2021 года из Школы компьютерных наук Тель-Авивского университета и Facebook AI Research (FAIR).

Карты, сгенерированные с помощью модели внимания на основе трансформера.
Новая статья озаглавлена Text2LIVE: Текстово-управляемое слоистое редактирование изображений и видео. К первоначальной команде 2021 года присоединились Омер Бар-Тал из Института Вейцмана и Йони Кастен из NVIDIA Research.
Архитектура
Text2Live состоит из генератора, обученного на единственном входном изображении и целевых текстовых подсказках. Модель контрастивного предварительного обучения на языке и изображениях (CLIP), предварительно обученная на 400 миллионах пар текст/изображение, предоставляет связанный визуальный материал, из которого можно интерпретировать пользовательские преобразования.

Генератор принимает входное изображение (кадр) и выдает целевой слой RGBA, содержащий информацию о цвете и непрозрачности. Этот слой затем компонуется в исходное видео с дополнительными дополнениями.

Альфа-канал в сгенерированном слое RGBA предоставляет внутреннюю композиционную функцию без обращения к традиционным пайплайнам, включающим программное обеспечение на основе пикселей, такое как After Effects.
Обучаясь на внутренних изображениях, релевантных для целевого видео или изображения, Text2Live избегает необходимости либо инвертировать входное изображение в латентное пространство генеративно-состязательной сети (GAN), что в настоящее время далеко не достаточно точно для требований редактирования видео, либо использовать модель диффузии, которая более точна и настраиваема, но не может сохранить верность целевому видео.

Различные редактирования на основе подсказок от Text2Live.
Предыдущие подходы использовали либо методы на основе распространения, либо подходы на основе оптического потока. Поскольку эти методы в той или иной степени основаны на отдельных кадрах, ни один из них не может создать последовательный временной вид изменений в выходном видео. Слоистая нейронная карта, вместо этого, предоставляет единственное пространство, в котором можно решать изменения, которые могут остаться верными внесенным изменениям, пока видео продолжается.
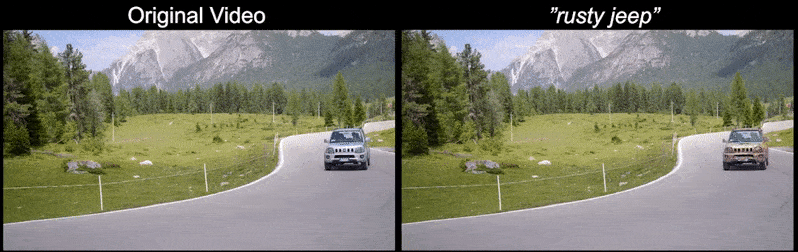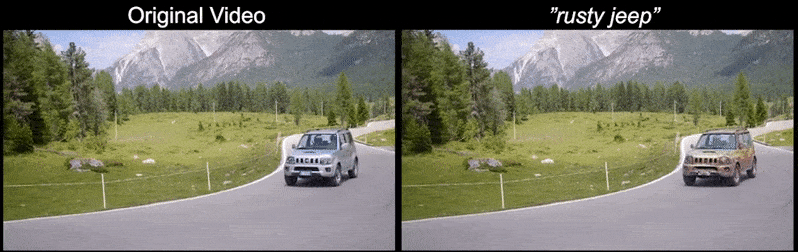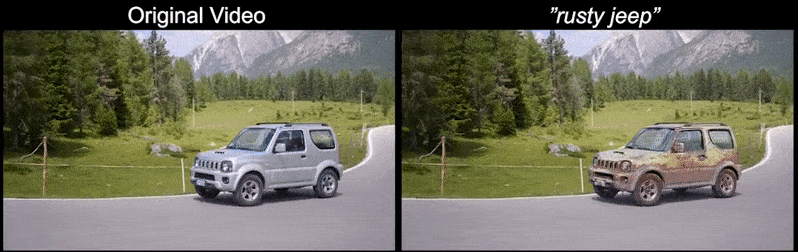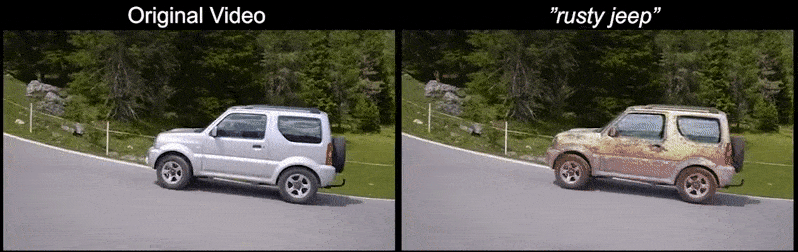
Нет ‘мерцания’ или случайных галлюцинаций: Text2Live получает интерпретацию текстовой подсказки ‘ржавый джип’ и применяет ее один раз к нейронной слоистой карте машины в видео, вместо того, чтобы перезапускать преобразование для каждого интерпретированного кадра.

Рабочий процесс последовательного преобразования джипа в ржавый реликт с помощью Text2Live.
Text2Live ближе к прорыву в области композитинга на основе ИИ, чем в плодородной сфере текст-изображение, которая привлекла так много внимания на этой неделе с выпуском второго поколения фреймворка DALL-E от OpenAI (который может включать целевые изображения в процесс преобразования, но остается ограниченным в способности напрямую изменять фотографию, помимо цензуры исходных данных обучения и наложения фильтров, предназначенных для предотвращения злоупотреблений со стороны пользователей).
Вместо этого Text2Live позволяет конечному пользователю извлечь атлас и отредактировать его за один проход в высококонтрольных пиксельных средах, таких как Photoshop (и, возможно, даже более абстрактных системах синтеза изображений, таких как NeRF), прежде чем вернуть его в правильно ориентированную среду, которая, тем не менее, не полагается на оценку 3D или подходы CGI, возвращающиеся к прежним методам.
Кроме того, Text2Live, по утверждению авторов, является первым сравнимым фреймворком, который достигает маскирования и композитинга полностью автоматическим способом.
Опубликовано впервые 7 апреля 2022 года.





