
Взгляд Anderson
Редактирование объектов с помощью ИИ: Imagic от Google и функция «Erase and Replace» от Runway

 Добавьте Unite.AI в избранные источники в Google

На этой неделе два новых, но противоположных алгоритма графики, основанные на ИИ, предлагают пользователям новые способы вносить чрезвычайно детальные и эффективные изменения объектов на фотографиях.
Первый — Imagic, разработанный Google Research совместно с Израильским технологическим институтом и Институтом Вейцмана. Imagic предоставляет редактирование объектов, управляемое текстом, с высокой точностью посредством дообучения диффузионных моделей.

Изменяйте то, что хотите, а остальное оставляйте нетронутым — Imagic обещает детальное редактирование только тех частей, которые вы хотите изменить. Source: https://arxiv.org/pdf/2210.09276.pdf
Любой, кто пытался изменить лишь один элемент при повторном рендеринге в Stable Diffusion, знает, что каждый удачный правка приводит к изменению пяти других элементов, которые вам нравились именно в таком виде. Это недостаток, из‑за которого многие из самых талантливых энтузиастов SD постоянно переключаются между Stable Diffusion и Photoshop, чтобы исправлять такие «побочные эффекты». Уже с этой точки зрения достижения Imagic выглядят примечательно.
На момент написания у Imagic ещё нет даже рекламного ролика, и учитывая осторожный подход Google к выпуску неограниченных инструментов синтеза изображений, неизвестно, насколько мы получим возможность протестировать эту систему.
Второй продукт — более доступный инструмент Runway ML Erase and Replace, новая функция в разделе «AI Magic Tools» их полностью онлайн‑пакета визуальных эффектов на основе машинного обучения.
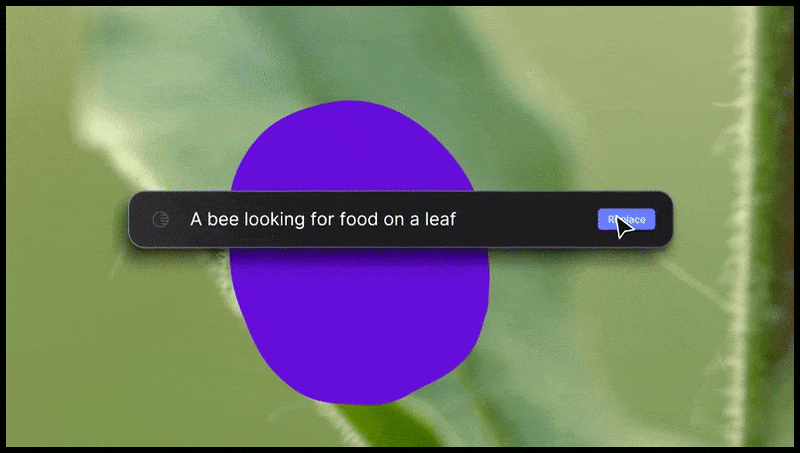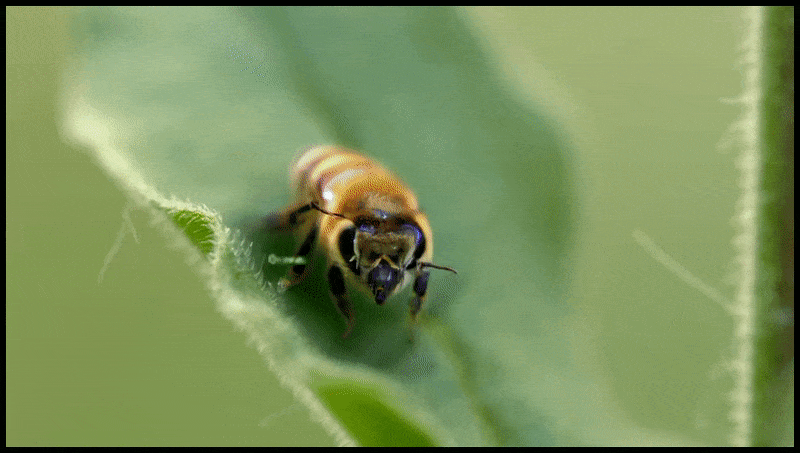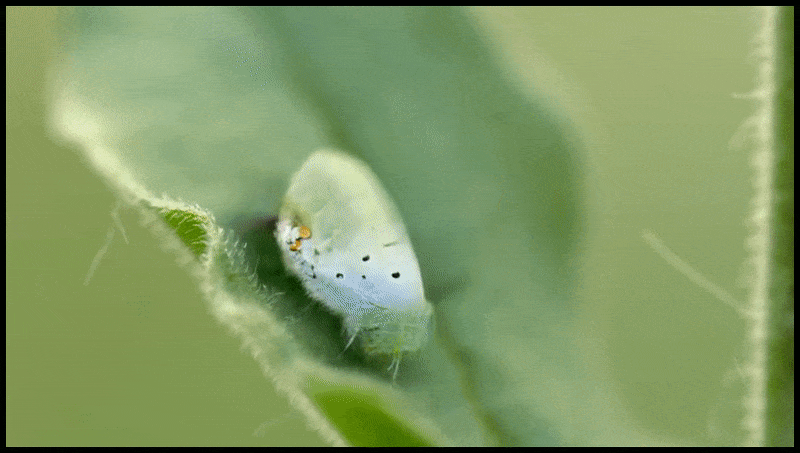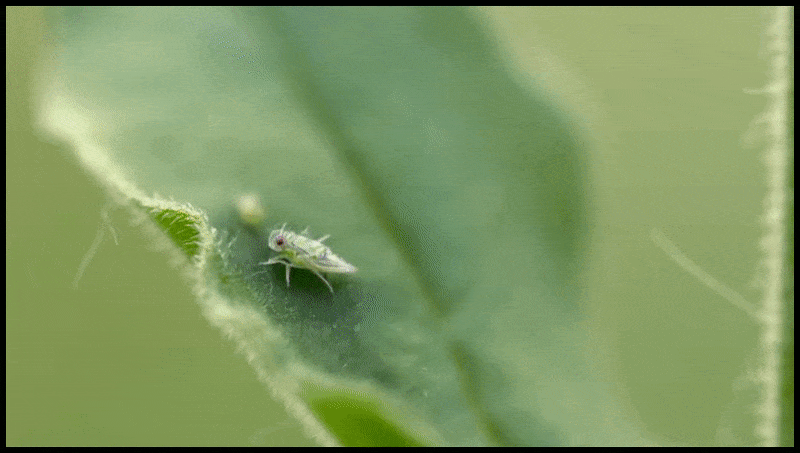
Функция Erase and Replace от Runway ML, уже продемонстрированная в предварительном просмотре системы редактирования текста в видео.
Давайте сначала посмотрим на релиз Runway.
Erase and Replace
Как и Imagic, Erase and Replace работает исключительно со статичными изображениями, хотя Runway предварительно показала ту же функцию в решении по редактированию текста в видео, которое ещё не выпущено:
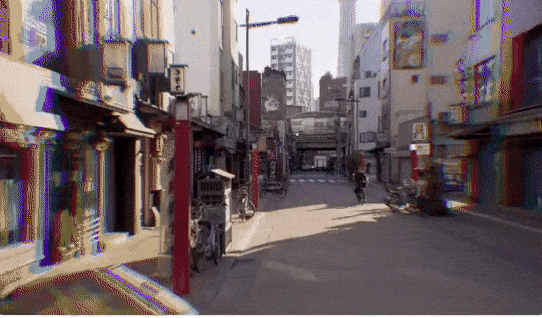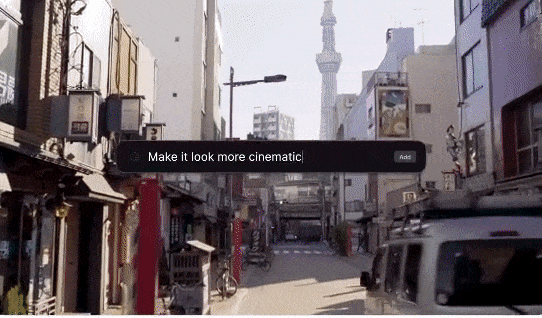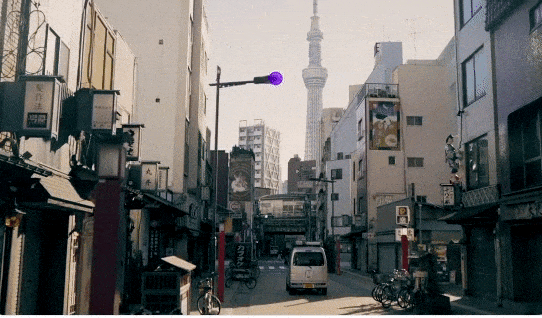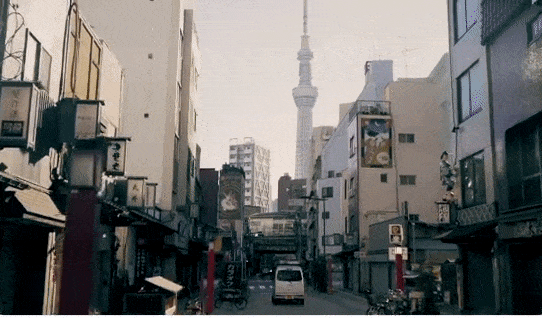
Хотя любой может протестировать новую функцию Erase and Replace на изображениях, видеоверсия пока недоступна публично. Source: https://twitter.com/runwayml/status/1568220303808991232
Хотя Runway ML не раскрыла детали технологий, лежащих в основе Erase and Replace, скорость, с которой можно заменить комнатное растение на довольно убедительный бюст Рональда Рейгана, указывает на то, что в качестве движка используется диффузионная модель, такая как Stable Diffusion (или, гораздо менее вероятно, лицензированная DALL‑E 2).

Замена комнатного растения бюстом «Гиппера» не столь быстра, как это, но всё же довольно быстра. Source: https://app.runwayml.com/
Система имеет некоторые ограничения, аналогичные DALL‑E 2 — изображения или текст, которые вызывают срабатывание фильтров Erase and Replace, вызывают предупреждение о возможной блокировке аккаунта при дальнейших нарушениях — по сути, шаблонная копия политик OpenAI для DALL‑E 2.
Во многих результатах отсутствуют типичные шероховатости Stable Diffusion. Runway ML являются инвесторами и научными партнёрами в SD, и возможно, что они обучили собственную модель, превосходящую открытые веса контрольной точки 1.4, с которыми сейчас борются все остальные (поскольку многие другие группы разработчиков, как любители, так и профессионалы, сейчас обучают или дообучают модели Stable Diffusion).
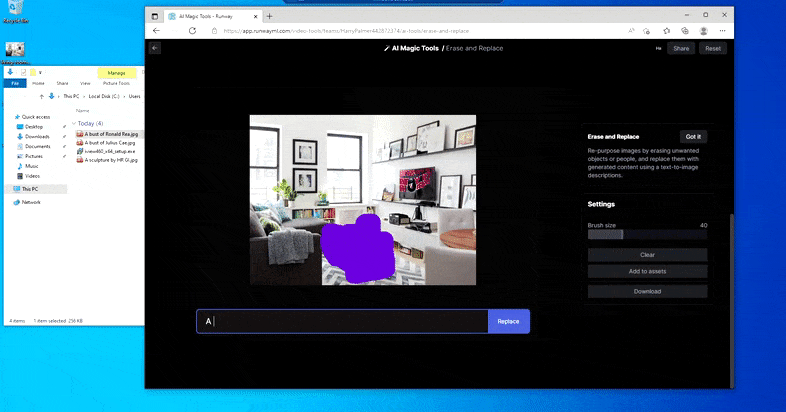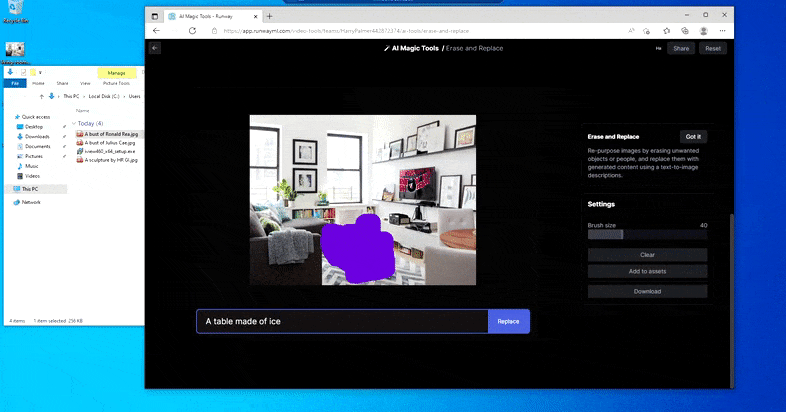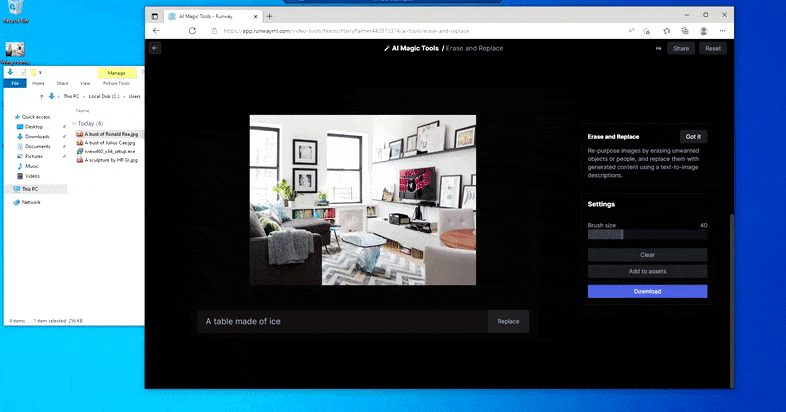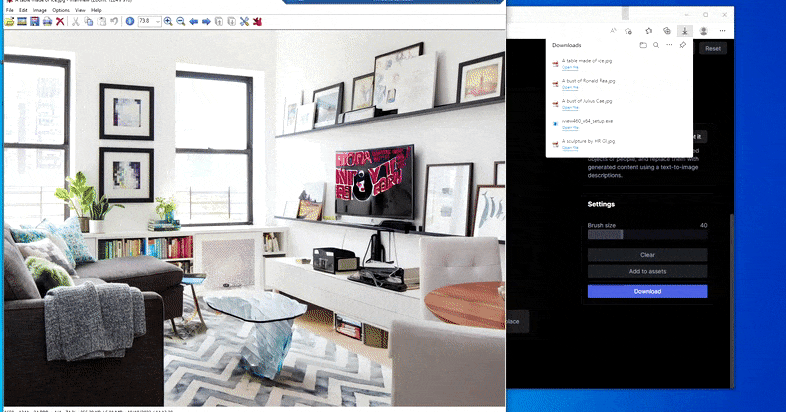
Замена обычного стола на «стол изо льда» в Erase and Replace от Runway ML.
Как и в Imagic (см. ниже), Erase and Replace по сути «ориентирован на объекты» — нельзя просто стереть «пустую» часть изображения и заполнить её результатом вашего текстового запроса; в таком случае система просто определит ближайший видимый объект вдоль линии маски (например, стену или телевизор) и применит трансформацию к нему.
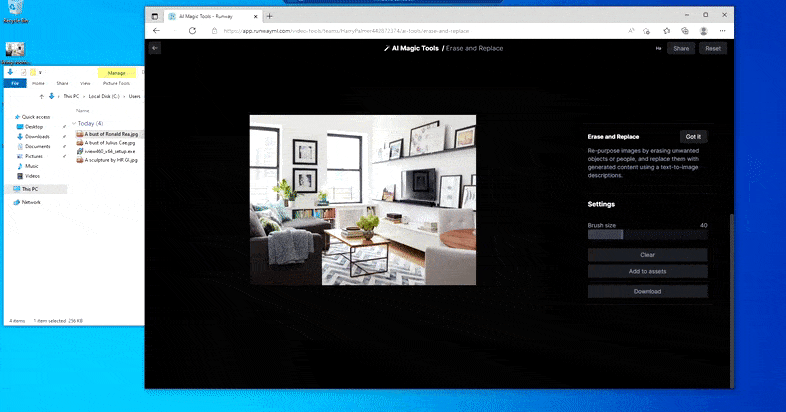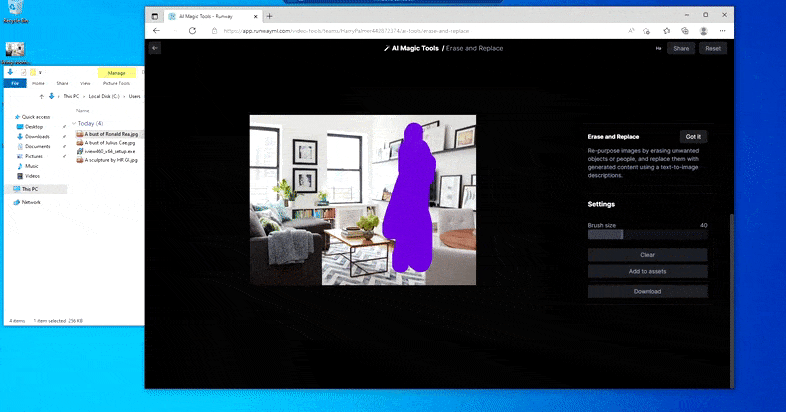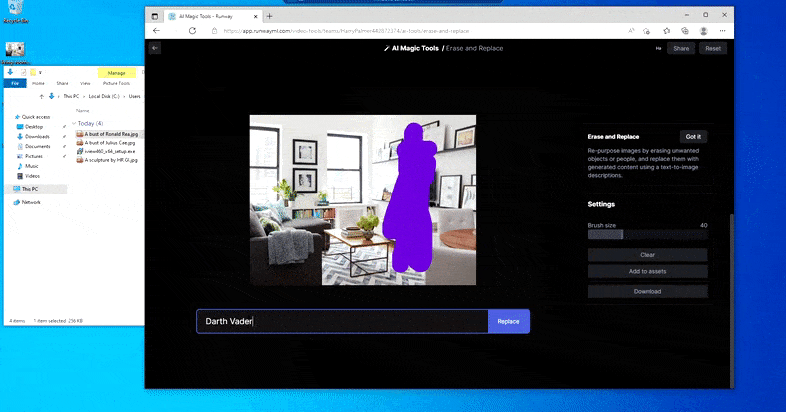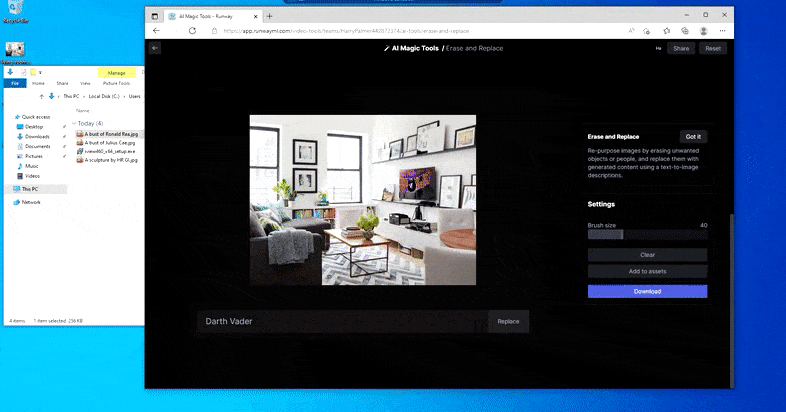
Как следует из названия, в Erase and Replace нельзя внедрять объекты в пустое пространство. Здесь попытка вызвать самого известного лорда Ситхов приводит к странному вейдеровскому муралу на телевизоре, примерно в том месте, где была нарисована область «замены».
Трудно определить, уклоняется ли Erase and Replace от использования защищённых авторским правом изображений (которые всё ещё в значительной степени блокируются, хотя с разной степенью успеха, в DALL‑E 2), или же модель, используемая в бек‑энд движке рендеринга, просто не оптимизирована для подобных задач.

Слегка NSFW «Мурал с Николь Кидман» показывает, что (по всей видимости) используемая диффузионная модель не обладает прежним системным отбрасыванием реалистичных лиц или откровенного контента, характерным для DALL‑E 2, а результаты попыток отобразить защищённые авторским правом работы варьируются от неоднозначных («ксеноморф») до абсурдных («железный трон»). В правом нижнем углу — исходное изображение.
Было бы интересно узнать, какие методы использует Erase and Replace для выделения объектов, которые он способен заменять. Предположительно, изображение проходит через некоторую модификацию CLIP, где отдельные элементы идентифицируются с помощью распознавания объектов и последующей семантической сегментации. Ни одна из этих операций не работает почти так же эффективно в обычной установке Stable Diffusion.
Но ничто не идеально — иногда система стирает, но не заменяет, даже когда (как мы видели на изображении выше) базовый механизм рендеринга явно понимает смысл текстового запроса. В таком случае превратить кофейный столик в ксеноморфа оказывается невозможным — стол просто исчезает.
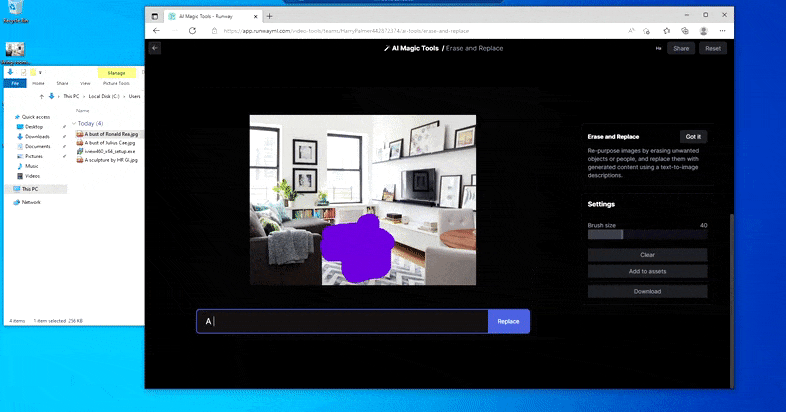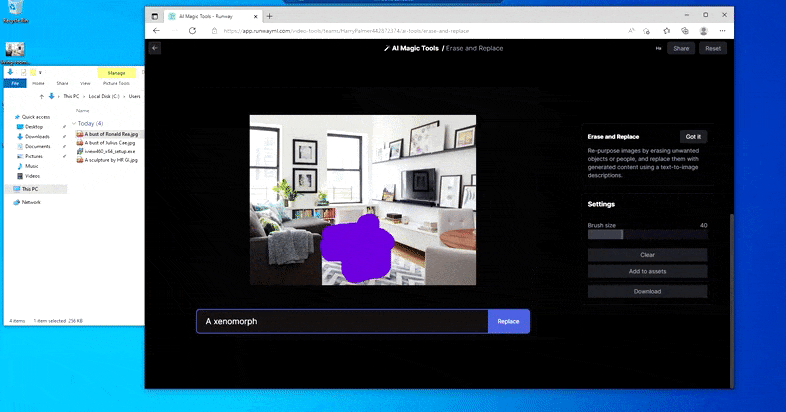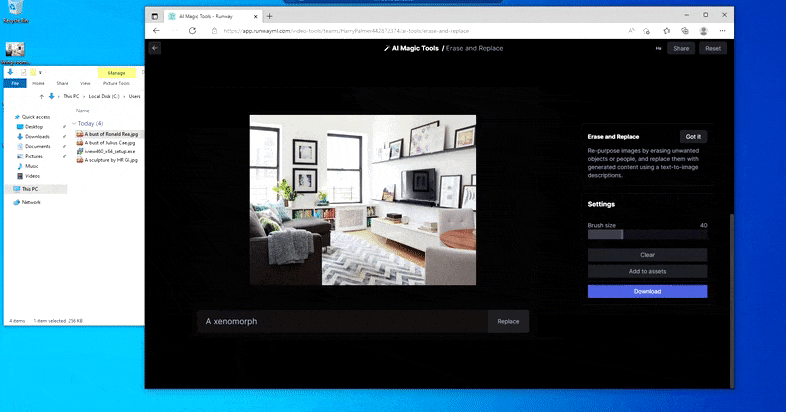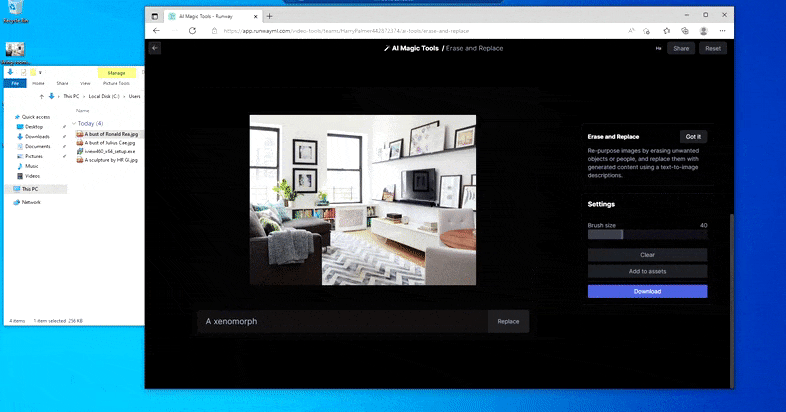
Более жуткая версия «Где Уолдо?», поскольку Erase and Replace не смог создать пришельца.
Erase and Replace кажется эффективной системой замены объектов с отличным inpainting‑ом. Однако она не может редактировать уже существующие воспринимаемые объекты, а лишь заменять их. На самом деле изменить содержимое изображения, не нарушая окружающие материалы, — задача гораздо сложнее, тесно связанная с длительной борьбой исследователей компьютерного зрения за дисентанглмент в различных латентных пространствах популярных фреймворков.
Imagic
Это задача, которую решает Imagic. Новая статья предлагает множество примеров правок, успешно изменяющих отдельные аспекты фотографии, оставляя остальное изображение нетронутым.

В Imagic изменённые изображения не страдают от характерного растягивания, искажений и «угадывания окклюзий», присущих deepfake‑марионеткам, использующим ограниченные приоры, полученные из одного изображения.
Система использует трёхэтапный процесс — оптимизацию текстовых эмбеддингов; дообучение модели; и, наконец, генерацию изменённого изображения.

Imagic кодирует целевой текстовый запрос, чтобы получить начальный эмбеддинг, затем оптимизирует результат для получения входного изображения. После этого генеративная модель дообучается на исходном изображении, добавляя ряд параметров, прежде чем применяется запрошенная интерполяция.
Неудивительно, что основа фреймворка — архитектура текст‑видео от Google Imagen, хотя исследователи отмечают, что принципы системы в целом применимы к латентным диффузионным моделям.
Imagen использует трёхуровневую архитектуру, в отличие от семьюуровневой схемы, применяемой в более недавней текст‑видео итерации программного обеспечения компании. Три отдельных модуля включают генеративную диффузионную модель с разрешением 64×64 px; модель супер‑разрешения, увеличивающую вывод до 256×256 px; и дополнительную модель супер‑разрешения, выводящую результат до 1024×1024 px.
Imagic вмешивается на самом раннем этапе этого процесса, оптимизируя запрошенный текстовый эмбеддинг на этапе 64 px с помощью Adam‑оптимизатора при фиксированном темпе обучения 0,0001.

Мастер‑класс по дисентанглменту: пользователи, пытавшиеся изменить, например, цвет отрисованного объекта в диффузионной, GAN‑ или NeRF‑модели, поймут, насколько значимо, что Imagic способен выполнять такие трансформации, не «разрывая» согласованность остального изображения.
Дальше происходит дообучение базовой модели Imagen, 1500 шагов на каждое входное изображение, с условием на изменённый эмбеддинг. Одновременно вторичный слой 64px>256px оптимизируется параллельно на условном изображении. Исследователи отмечают, что аналогичная оптимизация финального слоя 256px>1024px оказывает «мало или совсем не влияет» на конечный результат, поэтому они его не реализовали.
В статье указано, что процесс оптимизации занимает примерно восемь минут на каждое изображение на двойных чипах TPUV4. Финальный рендер происходит в ядре Imagen согласно схеме выборки DDIM.
Как и в аналогичных процессах дообучения для Google DreamBooth, полученные эмбеддинги могут дополнительно использоваться для стилизации, а также для фотореалистичных правок, содержащих информацию из более широкой базовой базы данных, поддерживающей Imagen (поскольку, как показывает первый столбец ниже, исходные изображения не содержат необходимого контента для выполнения этих трансформаций).

Гибкое фотореалистичное перемещение и правки могут быть получены с помощью Imagic, а полученные в процессе дисентанглмент коды также могут использоваться для стилизованного вывода.
Исследователи сравнили Imagic с предыдущими работами SDEdit, подходом на основе GAN 2021 года, разработанным совместно Стэнфордским университетом и Университетом Карнеги‑Меллон; и Text2Live, совместным проектом из апреля 2022 года Института Вейцмана и NVIDIA.

Визуальное сравнение Imagic, SDEdit и Text2Live.
Очевидно, что предыдущие подходы сталкиваются с трудностями, но в нижнем ряду, где требуется кардинальное изменение позы, конкуренты полностью не справляются с перестройкой исходного материала, в отличие от заметного успеха Imagic.
Требования Imagic к ресурсам и время обучения на одно изображение, хотя и небольшие по сравнению с аналогичными задачами, делают его маловероятным кандидатом для локального приложения по редактированию изображений на персональных компьютерах — и неясно, насколько процесс дообучения можно масштабировать до уровня потребителя.
На данный момент Imagic представляет собой впечатляющий продукт, более подходящий для API — среды, в которой Google Research, осторожный в отношении критики за содействие deepfake, вероятно, будет чувствовать себя наиболее комфортно.
Первоначально опубликовано 18 октября 2022 года.


