
Interviuri
Piotr Tomasik, Co-Fondator și Președinte al TensorWave – Seria de Interviuri

 Adaugă Unite.AI la sursele tale preferate pe Google
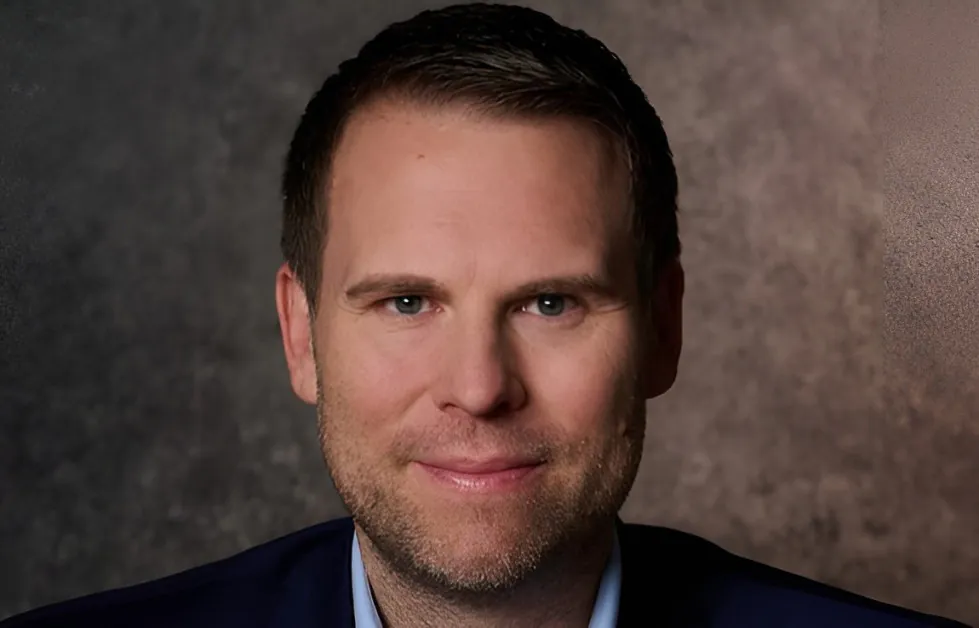
Piotr Tomasik, Co-Fondator și Președinte al TensorWave, este un veteran antreprenor în tehnologie și un executiv în infrastructura de inteligență artificială, cu peste două decenii de experiență în domenii precum inteligența artificială, SaaS, computerele în cloud, fintech și economia creativă. Înainte de a co-fonda TensorWave în 2023, el a co-fondat Influential, o platformă de marketing influențator bazată pe inteligență artificială, care a fost ulterior achiziționată de Publicis pentru aproximativ 500 de milioane de dolari, unde a ocupat funcția de CTO, înainte de a trece la un rol de consilier.
De-a lungul carierei sale, Tomasik a fondat sau condus companii precum Lets Rolo, On Guard Data și ActiveSide, ocupând funcții de conducere în tehnologie la CARD.com și Marker Trax. Pe lângă rolurile sale operaționale, el este Partener General la 1864 Fund și co-fondator al StartUp Vegas, unde sprijină activ ecosistemul de startup-uri din Las Vegas și talentele emergente în tehnologie. Absolvent al Universității din Nevada, Las Vegas, la specializarea știința calculatoarelor, și recunoscut ca lider în tehnologie, Tomasik a devenit cunoscut pentru ajutorul acordat în poziționarea TensorWave ca o companie de infrastructură de calcul cu inteligență artificială în creștere rapidă, axată pe platforme de cloud cu GPU-uri mari, alimentate de acceleratoare AMD.
TensorWave este o companie de infrastructură de inteligență artificială care se axează pe furnizarea de computere în cloud de înaltă performanță, alimentate de GPU-uri AMD, poziționându-se ca o alternativă la ecossistemele de inteligență artificială mai închise. Fondată în 2023 și cu sediul în Las Vegas, compania construiește clusteruri de GPU de mare scară, optimizate pentru antrenarea și implementarea modelelor avansate de inteligență artificială, cu accent pe performanță, flexibilitate și eficiență a costurilor. Prin utilizarea de ecosisteme de hardware și software deschise, TensorWave își propune să extindă accesul la resurse de calcul cu inteligență artificială puternice pentru întreprinderi, cercetători și dezvoltatori, permițând încărcări de lucru cu inteligență artificială scalabile, fără restricțiile de blocare a furnizorilor tradiționali.
Nvidia (NVDA ) domină majoritatea pieței de GPU – de ce ați decis să vă axați exclusiv pe AMD și care sunt avantajele acestei alegeri pentru TensorWave și clienții săi?
În urma lansării ChatGPT, cererea de inteligență artificială a explodat. GPU-urile s-au epuizat rapid, iar NVIDIA a fost practic singura opțiune, dacă se putea obține și dacă se putea suporta costul. Această penurie a generat un interes enorm pentru alternative. Acum, că suntem dincolo de hype-ul inițial, există o oportunitate reală de a contesta dominanța NVIDIA cu soluții accesibile, eficiente din punct de vedere al costurilor și ușor de utilizat.
Ca start-up, am luat întotdeauna decizii de afaceri cu un focus puternic și un scop bine definit. De aceea, nu am experimentat cu NVIDIA și am continuat să ne extindem capacitățile pe AMD. Următoarea fază a companiei noastre se axează pe aprofundarea capabilităților noastre concentrate, astfel încât oricine să poată să se implice și să facă ceva semnificativ cu inteligența artificială. AMD este o alternativă credibilă, cu o scară de fabricație reală, o atitudine deschisă în ceea ce privește software-ul și o direcție de dezvoltare a memoriei pentru inteligența artificială modernă.
Cum se diferențiază abordarea TensorWave în ceea ce privește infrastructura de inteligență artificială de cea a furnizorilor tradiționali de cloud cu GPU?
Diferențierea noastră este una simplă: suntem singurul cloud exclusiv AMD la scară, care își propune să restaureze alegerea în ceea ce privește calculul cu inteligență artificială, să înfrângă dominanța NVIDIA și să democratizeze accesul. Dar este și despre etosul și angajamentul nostru de a aduce o adevărată alternativă pe piață. În primul rând, dorim să livrăm infrastructură de înaltă calitate, bazată pe AMD, la scară. De acolo, vom extinde serviciile de top pe baza acesteia – Modele ca Serviciu, Inteligență Artificială ca Serviciu, făcând totul mai simplu.
Ca cloud exclusiv AMD, avem experiență în software dezvoltat special pentru AMD, de la început. Acest focus ne permite să optimizăm siliciul, rețeaua și software-ul de la capăt la capăt, asigurându-ne că echipele pot scala atunci când au nevoie.
Care este rolul parteneriatului strategic cu AMD în creșterea și diferențierea TensorWave?
Este fundamental. AMD a investit în TensorWave, ne-a invitat la lansarea MI300X Instinct și continuăm să colaborăm strâns în ceea ce privește hardware-ul, activarea software-ului și creșterea ecosistemului. Fiind un cloud exclusiv AMD, putem să ne mișcăm rapid cu fiecare generație Instinct și să servim ca un laborator viu care oferă, la scară, alternative în piața noastră. Diferențierea noastră exclusiv AMD ne-a permis să lucrăm la un ritm care nu este atât de realizabil pe piața infrastructurii de inteligență artificială. Parteneriatul lor ne permite să închidem golurile rapid, să livrăm primii noi GPU-uri și să publicăm performanțe reale la scară.
Accesul la GPU rămâne o problemă majoră pentru echipele de inteligență artificială – cum abordează TensorWave această provocare?
Noi abordăm aceste blocaje, în primul rând, prin independența aprovizionării: prin construirea pe AMD, evităm cea mai proastă parte a constrângerilor de aprovizionare ale altor producători de cipuri și transmitem disponibilitatea clienților noștri. Independența aprovizionării prin AMD asigură că clienții noștri nu sunt blocați, așteptând în aceeași coadă cu toată lumea.
Golurile din ecosistemul infrastructurii de inteligență artificială există pentru că mulți jucători construiesc soluții similare, ceea ce creează o suprapunere semnificativă. Acest lucru provine adesea din lipsa de conștientizare a ceea ce se întâmplă pe piață. Primul pas pentru a închide aceste goluri este înțelegerea cui face ce, unde există oportunități de colaborare, unde concurența poate stimula inovația și, în cele din urmă, cum ecosistemul poate fi îmbunătățit în ansamblu. O gol în ecosistemul infrastructurii de inteligență artificială este puterea; chiar dacă GPU-urile sunt disponibile, adesea nu există suficientă energie pentru a susține numărul tot mai mare de aplicații de inteligență artificială. Rezolvarea acestor provocări de resurse este cheia noastră pentru a permite creșterea și inovația durabilă în anii următori.
Cum îmbunătățesc caracteristici precum răcirea lichidă directă și rețeaua pregătită UEC (Universal Ethernet Consortium) performanța și eficiența costurilor?
Răcirea lichidă directă și rețeaua pregătită UEC sunt fundamentale pentru ceea ce face un cloud de inteligență artificială modern economic viabil la scară și sunt centrale pentru modul în care am proiectat TensorWave.
În ceea ce privește DLC: noile generații de acceleratoare, AMD MI355X și MI455X, rulează la enveloppe termice pe care aerul nu le poate gestiona eficient. Vorbeam despre 1400W+ TDP pe GPU. Răcirea lichidă directă elimină căldura la sursă prin intermediul unor proiecte de placă rece sau imersie, ceea ce face trei lucruri pentru clienții noștri. În primul rând, permite o densitate de rack semnificativ mai mare, 120-300kW+ pe rack, în loc de 30 la 40kW, ceea ce comprimă amprenta și reduce costurile cu spațiul și distribuția energiei. În al doilea rând, conduce PUE spre 1,1, în comparație cu 1,4 până la 1,5 pentru facilitățile cu răcire cu aer; la scala noastră, acest lucru se traduce în zeci de milioane de dolari în economii anuale la utilități. În al treilea rând, și adesea subapreciat, DLC menține siliciul la temperaturi mai scăzute și mai stabile, ceea ce prelungește durata de viață utilă a hardware-ului. Acest ultim punct contează enorm atunci când sunteți obligați să garantați un activ pe o perioadă de șase ani.
În ceea ce privește UEC: specificația Ultra Ethernet Consortium, care a ajuns la 1.0 în 2025 și la care AMD a contribuit, ne oferă o țesătură deschisă, de merchant-silicon, care îndeplinește sau depășește InfiniBand pe metricile care contează cu adevărat pentru antrenarea distribuită. Latența cozii la colective, lățimea de bandă efectivă sub contenție și comportamentul de scalare dincolo de pragul de 100.000 de GPU. Povestea costurilor este structurală. Ethernet are o jumătate de duzină de furnizori de siliciu credibili care concurează pe preț, în comparație cu o alternativă cu sursă unică care implică un premiu bine documentat. Pentru un site de 100MW, alegerea rețelei UEC în loc de o țesătură proprietară este, de obicei, o decizie de capital de nouă cifre, iar avantajele operaționale se cumulează pentru că inginerii noștri de rețea cunosc deja Ethernet.
Luându-le împreună, aceste alegeri ne permit să oferim o mai bună economie de antrenament decât cloud-urile tradiționale. Clienții noștri observă o putere de calcul mai mare pe dolar, timpi de pas mai predictibili pentru joburi mari și o perspectivă clară de scalare a modelelor. Pentru noi, acestea înseamnă o structură de costuri mai defensivă și flexibilitatea de a oferi tarife concurențiale.
Puteți să împărtășiți exemple de moduri în care clienții utilizează TensorWave pentru a antrena modele de inteligență artificială de mare scară?
Clienții TensorWave au nevoie de computere cu inteligență artificială de înaltă performanță, fără penurie de GPU, fără blocare a furnizorilor și fără costuri care să scape de sub control. TensorWave oferă cloud exclusiv AMD – deschis, optimizat pentru memorie și gata de producție, ceea ce oferă echipelor infrastructură de inteligență artificială scalabilă, accesibilă, flexibilă și eficientă din punct de vedere al costurilor.
De exemplu, Modular a ales să ruleze stiva sa MAX de inferență pe infrastructura de GPU AMD a TensorWave, deoarece TensorWave oferă o economie de cost-performanță semnificativ mai bună pentru inferența de inteligență artificială de mare scară. Prin rularea MAX pe computerele AMD ale TensorWave, ei realizează o reducere de până la 70% a costului pe milioane de tokeni, o rată de transfer de 57% mai rapidă și costuri totale mai mici decât alte stive de GPU.
Cu dominanța continuă a Nvidia, unde vedeți cele mai mari oportunități pentru competitori precum TensorWave?
Într-un spațiu de calcul cu inteligență artificială dominat de câțiva jucători majori, cele mai mari provocări sunt atingerea vitezei de piață, livrarea celei mai recente tehnologii și oferirea unui suport excepțional. Hiperscaleratorii oferă adesea o gamă largă de opțiuni, dar luptă pentru a oferi focusul sau îndrumarea personalizată de care au nevoie clienții. Pentru a străpunge acest spațiu dominat, TensorWave se concentrează pe punctele sale forte, colaborând pentru a oferi cea mai bună tehnologie posibilă și asigurându-se că clienții au opțiuni alternative.
Cele mai mari oportunități pentru competitorii dominanței NVIDIA în infrastructura de inteligență artificială sunt în ecosistemele deschise și memoria. Ecosistemele deschise elimină blocarea la fiecare nivel (hardware, interconectare și software). În plus, memoria, însoțită de antrenament și inferență optimizate pentru rețea, inversează curba costurilor.
Privind spre următorii cinci ani, cum vă imaginați viitorul infrastructurii de inteligență artificială și rolul TensorWave în acesta?
De-a lungul anilor, obiectivul în infrastructura de inteligență artificială a fost să o facă bună, stabilă și ușor de utilizat. Următoarea fază va fi despre ceea ce puteți livra pe baza acesteia – servicii gestionate, Inteligență Artificială ca Serviciu, orice care ajută clienții să implementeze și să scaleze mai ușor.
Suntem la începutul unei transformări majore. Tehnologia de inteligență artificială continuă să evolueze, iar alternativele precum AMD devin din ce în ce mai viabile. Pe măsură ce se întâmplă acest lucru, clienții vor deveni mai confortabili în a le implementa la scară, iar întregul ecosistem va începe să se deschidă și să crească.
Mulțumim pentru acest interviu minunat; oricine dorește să afle mai multe despre această companie inovatoare de infrastructură de inteligență artificială ar trebui să viziteze TensorWave.


