
Interviuri
Dr. Mathilde Pavis, Șef de Legal, OpenOrigins – Seria de Interviuri

 Adaugă Unite.AI la sursele tale preferate pe Google
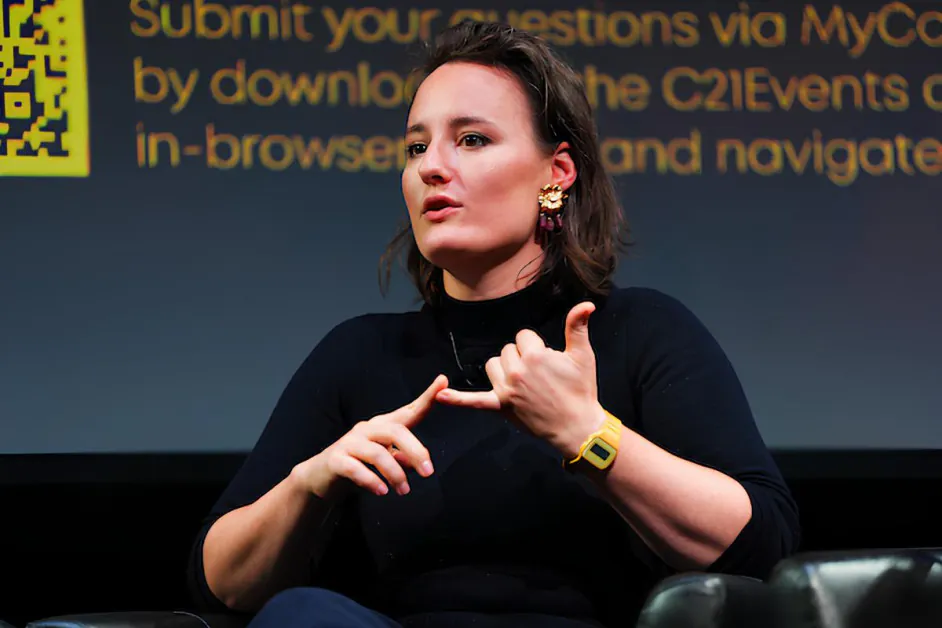
Dr. Mathilde Pavis, Șef de Legal la OpenOrigins, este un expert de top în reglementarea inteligenței artificiale și guvernanța mass-media digitale, specializându-se în deepfakes, mass-media sintetice și proveniența conținutului. Ea consiliază companii, guverne și sindicate cu privire la conformitate, licențiere și risc în inteligența artificială generativă și a lucrat cu Microsoft (MSFT ) și ElevenLabs la politica și strategia de inteligență artificială. De asemenea, a consiliat UNESCO cu privire la inteligența artificială și proprietatea intelectuală și oferă în mod regulat dovezi de expertiză legislatorilor din Regatul Unit.
OpenOrigins dezvoltă tehnologie pentru a combate dezinformarea și deepfakes prin crearea unor înregistrări verificabile și protejate împotriva falsificării a conținutului digital. Platforma sa se concentrează pe stabilirea unei proveniențe clare, permițând mass-media, creatorilor și platformelor să dovedească când și cum a fost creat, editat și distribuit conținutul – o capacitate din ce în ce mai critică pe măsură ce mass-media sintetică devine mai avansată și mai greu de detectat.
Ați consiliat guverne, instituții globale precum UNESCO și companii precum Microsoft și ElevenLabs cu privire la reglementarea inteligenței artificiale. Ce v-a determinat să vă concentrați în special pe deepfakes, replici digitale și mass-media sintetică, și cum a influențat această călătorie decizia dvs. de a înființa Replique?
Lucrul meu cu deepfakes nu a început cu tehnologia – a început cu o puzzle legală mult mai veche. Când am început să cercetez proprietatea intelectuală pentru doctoratul meu în 2013, am fost izbit de faptul că artiștii primesc o protecție mult mai mică decât autorii, compozitorii sau regizorii. În practică, acest lucru înseamnă că cuvintele sau muzica dvs. sunt mai bine protejate în lege decât vocea, fața și corpul dvs. Această lipsă de echilibru mi s-a părut ciudată și m-a determinat să pun o întrebare mai profundă: cum valorizăm cultural și legal munca cuiva a cărui contribuție este fața, vocea și corpul său pe ecran?
Această întrebare m-a condus spre drepturile artiștilor și date. La acea vreme, era considerat un domeniu de nișă, cu puțină relevanță comercială. Mi s-a sfătuit în mod activ să mă mut în domenii mai “lucrative”, cum ar fi brevetele de invenție sau dreptul de autor clasic. Presupunerea era că problemele legate de asemănarea unei persoane sau de voce erau gestionate în mare parte informal, prin norme ale industriei sau “înțelegeri gentlemenești” în Hollywood. Dar pentru mine, această lipsă de protecție formală a semnalat o lacună, nu un punct final pentru cercetarea mea, așa că am continuat să o urmăresc.
Ce s-a schimbat este faptul că astăzi, aproape toată lumea este un artist. Viețile noastre sunt mediate prin camere – pe telefoane, laptopuri, apeluri video și platforme sociale. Indiferent dacă este pentru muncă sau utilizare personală, oamenii înregistrează și împărtășesc în mod constant versiuni ale lor înșiși. Întrebările legale care odinioară se aplicau în principal artiștilor sau muzicienilor se aplică acum oricui are un smartphone.
Deepfakes nu au creat aceste probleme – le-au expus și accelerat. Cercetarea pe care o făceam din 2013 a devenit brusc urgentă. În jurul anilor 2017 și 2018, dezvoltările în rețelele neuronale – în special din locuri precum MIT și UC Berkeley – au început să demonstreze cât de convingător poate fi manipulată digital fața, vocea și corpul unei persoane. Într-un an, această capacitate a devenit cunoscută sub numele de “deepfakes” și a câștigat inițial tracțiune în moduri extrem de dăunătoare, în special prin conținut sexual non-consensual care vizează femei și copii.
Abia mai târziu au apărut implicațiile comerciale, pe măsură ce industriile creative au început să adopte mass-media sintetică. Atunci, întrebările contractuale și economice pe care le lucram au devenit fundamentale. Practic peste noapte, ceea ce fusese considerat un domeniu în mare parte teoretic sau doctrinar al legii a devenit un domeniu foarte practic, comercial semnificativ și social urgent.
La nivelul său fundamental, provocarea legală nu s-a schimbat: oamenii vor să împărtășească aspecte ale lor înșiși, dar să păstreze în același timp un control semnificativ. Cadrul existent luptă cu această nuanță. Tendința este de a trata indivizii ca fiind complet privați sau complet publici – fie protejați, fie jocuri echitabile. Dar majoritatea oamenilor există undeva între acestea. Această tensiune este acum centrală nu numai pentru artiștii profesioniști, ci și pentru oricine participă la viața digitală.
Am devenit cunoscută ca o persoană care a cercetat și a lucrat în acest domeniu, ceea ce m-a condus să lucrez cu guverne interesate să protejeze oamenii împotriva deepfakes și cu companii care doresc să creeze produse de clonare digitală sigure pentru utilizare, cum ar fi ElevenLabs. La Replique, aduc tot ceea ce am învățat oamenilor și companiilor care doresc să utilizeze tehnologia de clonare digitală sau de replică digitală în mod responsabil și sigur. Am transformat, în esență, cercetarea mea “blue sky” într-o afacere de consultanță care oferă sfaturi legale specializate pentru industriile creative.
Ca Șef de Legal la OpenOrigins, o companie axată pe stabilirea unui registru imutabil al provenienței conținutului pentru a combate deepfakes, cum considerați că sistemele bazate pe proveniență concurează sau înlocuiesc abordările tradiționale de detectare a deepfakes?
Compararea instrumentelor de detectare a deepfakes poate deveni rapid o exercițiu de comparare a mere și portocale, deoarece eficacitatea lor depinde de context și scop. Dintr-o perspectivă politică, ceea ce avem nevoie este un set de instrumente complementare – nu există o singură “cea mai bună” soluție, iar OpenOrigins este o parte a acestui ecosistem mai larg. În situațiile în care un creator de conținut sau o organizație de informații are nevoie să dovedească autenticitatea conținutului pe care îl împărtășește cu parteneri, public sau audiență, tehnologia OpenOrigins se remarcă ca o soluție de detectare a deepfakes.
Prin furnizarea de proveniență verificabilă și “chitanțe” la momentul creării, oferă o formă puternică de prevenire, demonstrând că conținutul nu este un deepfake. Cu toate acestea, această abordare este mai puțin utilă pentru utilizatorii de internet obișnuiți care doresc să evalueze rapid conținutul pe care îl întâlnesc online. În aceste cazuri, detectarea se bazează mai mult pe metode probabilistice și de analiză a conținutului decât pe verificarea bazată pe proveniență. Avem nevoie de instrumente diferite pentru nevoi diferite și trebuie să acceptăm că nu există o soluție magică împotriva deepfakes.
Din punct de vedere legal, ce este cel mai mare gol în modul în care jurisdicțiile abordează consimțământul și proprietatea în conținutul generat sau replicat de inteligență artificială?
Oof, cât timp aveți? Răspunsurile depind de ceea ce înțelegem prin conținut generat sau replicat de inteligență artificială. Problemele variază în funcție de faptul că ne uităm la o imagine generată de inteligență artificială a unei case sau a unui animal. Sau la o recreare digitală a feței unei persoane sau a vocii sale. Să ne concentrăm pe subiectul deepfakes și replicilor digitale și să răspundem la întrebarea dvs. în contextul “clonării digitale”.
În ceea ce privește consimțământul, problema de bază este că majoritatea contractelor – fie acorduri de muncă, fie termene și condiții ale platformelor – conțin clauze largi și vagi care acordă drepturi extinse asupra conținutului utilizatorului. Acestea pot fi interpretate ca o formă de “consimțământ prin ușa din spate”, unde acordarea termenilor poate fi considerată a însemna consimțământul pentru utilizări precum clonarea, chiar dacă majoritatea oamenilor ar contesta puternic această interpretare. Acest lucru creează un decalaj semnificativ între interpretarea legală și așteptările utilizatorilor, un decalaj care în prezent favorizează companiile, în timp ce reglementarea rămâne în urmă.
În ceea ce privește proprietatea, nu există un răspuns clar din punct de vedere legal cu privire la cine deține o clonă digitală, deoarece cadrul existent – protecția datelor, dreptul de autor și drepturile de personalitate – nu a fost conceput pentru această tehnologie. Astăzi, majoritatea oamenilor sunt scanați și clonați la locul de muncă, la cererea și cu finanțarea unui angajator sau client. Și aceste entități așteaptă de obicei un nivel ridicat de control asupra acestui activ, ceea ce este înțelept, dar adesea problematic, deoarece acest activ este o imitație digitală a feței sau vocii tale și poate face să spui lucruri pe care nu le-ai spus niciodată sau să faci lucruri pe care nu le-ai făcut niciodată.
Întrebarea “cine deține clona ta?” este foarte importantă, dar rămâne fără răspuns în legea de astăzi.
Ați lucrat îndeaproape cu tehnologiile de clonare a vocii. Care sunt riscurile legale cele mai puțin înțelese atunci când vine vorba de voci sintetice, atât pentru companii, cât și pentru indivizi?
Problema cea mai puțin înțeleasă în ceea ce privește conformitatea legală este echilibrul dintre interesul comercial al unei companii de a finanța și exploata o clonă digitală și dreptul individului la confidențialitate și demnitate digitală. Această tensiune se află între multiple regimuri legale (în primul rând proprietate intelectuală, protecția datelor și confidențialitatea), care nu au fost concepute pentru a funcționa împreună și interpretează clonarea în moduri fundamental diferite. Ca urmare, traducerea acestuia în practici comerciale funcționale și prietenoase este complexă și adesea neclară. Companiile fie ignoră riscurile cheie, fie suportă costuri semnificative pentru a le naviga corect. Acest lucru duce la un rezultat pervers în care conformitatea responsabilă devine drumul mai greu și mai scump, în loc de drumul implicit.
Cum ar trebui companiile să gândească despre arhitectura consimțământului în sistemele de inteligență artificială, în special atunci când au de-a face cu asemănarea, identitatea și datele de antrenament?
Companiile ar trebui să-și proiecteze sistemele în jurul a trei capacități de bază. În primul rând, acestea trebuie să obțină un consimțământ informat și contextual la înscriere. În al doilea rând, trebuie să facă ușor pentru utilizatori să-și retragă acel consimțământ și să șteargă unele sau toate datele lor, ceea ce este din punct de vedere tehnic dificil și adesea ignorat, dar esențial pentru conformitatea cu legi precum Regulamentul General privind Protecția Datelor (GDPR) din Regatul Unit și UE și regimuri similare din Statele Unite. Menținerea consimțământului în timp înseamnă construirea unor sisteme în care retragerea este operațională netedă și aliniată cu modelul de afaceri.
Consimțământul trebuie să fie granular. Și, în al treilea rând, utilizatorii ar trebui să poată gestiona permisiunile la nivel de fișier individual, să-și actualizeze datele de asemănare și să înțeleagă cum sunt utilizate. Acest lucru necesită transparență și control – instrumente care permit utilizatorilor să monitorizeze, să revizuiască și să modereze cum sunt utilizate clonele lor digitale. Acest nivel de flexibilitate este încă rar, dar este acolo unde se află avantajul competitiv în creștere.
În experiența dvs. de a consilia atât startup-uri, cât și guverne, unde este cel mai mare decalaj între modul în care se construiește inteligența artificială și modul în care este reglementată?
Decalajul dintre modul în care se construiește inteligența artificială și modul în care este reglementată se reduce la misiuni fundamental diferite. Guvernele reglementează în interes public, în timp ce companiile de inteligență artificială (adesea finanțate de venture) sunt conduse în primul rând de creștere, venituri și profit. Aceste priorități nu sunt întotdeauna în conflict, dar adesea trag în direcții diferite, reglementarea fiind văzută ca o constrângere, mai degrabă decât un sprijin.
Acest lucru creează o tensiune structurală: regulatorii și inovatorii operează cu stimulente, valori și chiar limbi diferite. Acest lucru face alinierea dificilă în practică, chiar dacă nu este imposibilă. Începem să vedem o nouă valură de companii tehnologice care se aliniază mai strâns cu obiectivele de interes public, dar acestea rămân excepția, mai degrabă decât regula – în special printre cele care reușesc să se extindă cu succes.
OpenOrigins se concentrează pe verificarea conținutului la momentul creării sale, utilizând proveniența criptografică. Cât de critică este această abordare “de la sursă” în comparație cu măsurile de siguranță post-distribuire?
Acest lucru se leagă de răspunsul meu de mai sus. Autentificarea conținutului la creare, “în amonte”, este mult mai eficientă decât încercarea de a verifica conținutul la momentul distribuirii sau chiar al consumului, adică “în aval”. Autentificarea conținutului la creare este ca urmărirea alimentelor de la momentul în care sunt cultivate pe fermă, în loc de a încerca să le urmăriți din ceea ce este pe farfurie. Dacă știți de unde a fost crescut puiul, cum a fost manipulat și cum a trecut prin lanțul de aprovizionare, puteți avea încredere în ceea ce mâncați. Dacă încercați să deduceți toate acestea doar privind felul de mâncare finit, vă bazați pe presupuneri. La fel este și cu deosebirea dintre conținutul creat de oameni și conținutul generat de inteligență artificială online: proveniența de la sursă oferă asigurarea verificabilă, în timp ce detectarea “în aval” este în mod inerent mai incertă și reactivă.
Care este rolul pe care îl vedeți pentru standarde precum C2PA în viitorul mass-media și sunt ele suficiente singure pentru a restabili încrederea online?
C2PA este o inițiativă binevenită și, în multe feluri, sprijină același impuls pentru autenticitatea conținutului ca și OpenOrigins. Acestea sunt o parte importantă a ecosistemului de siguranță și autenticitate a conținutului. Ca și instrument de securitate cibernetică, nu există o soluție magică.
Pentru creatori și talente din industrii precum film, muzică și jocuri, care sunt pașii practici pe care ar trebui să-i ia astăzi pentru a se proteja de replicarea neautorizată digitală?
Artiștii se confruntă astăzi cu două riscuri distincte: replicarea lucrării lor (cum ar fi muzică, imagini sau scrieri) și replicarea asemănării lor, inclusiv fața, vocea și corpul. Cu un input minim, sistemele de inteligență artificială pot reproduce acum ambele cu un nivel ridicat de fidelitate. În termeni practici, protecția începe cu a fi deliberat cu privire la ceea ce partajați online, recunoscând că orice conținut postat poate fi extras și utilizat în seturi de date de antrenament, adesea fără consimțământ clar sau vizibilitate.
Acest risc este acum o realitate de bază a funcționării online. Dar riscul mai imediat și mai controlabil se află adesea în contracte. Acordurile pe care le încheie artiștii cu colaboratorii, distribuitorii sau platformele lor pot include clauze care permit utilizarea inteligenței artificiale, reutilizarea sau revânzarea conținutului pentru scopuri de antrenament – frecvent fără o participare semnificativă la veniturile ulterioare.
Pentru artiști, acest lucru face ca examinarea contractelor să fie critică. Înțelegerea modului în care lucrarea și asemănarea lor pot fi utilizate, licențiate sau reutilizate este acum la fel de importantă ca și procesul creativ în sine. Multă parte din dezbaterea actuală (în cadrul uniunilor, organismelor industriale și platformelor) se concentrează pe corectarea acestui dezechilibru și asigurarea faptului că creatorii păstrează atât controlul, cât și o compensație echitabilă.
Așadar, două sfaturi cheie: fiți atenți la ceea ce partajați online și citiți contractele și căutați clauzele de inteligență artificială înainte de a semna.
Privind înainte trei până la cinci ani, credeți că vom ajunge la un moment în care fiecare piesă de conținut digital va trebui să aibă o proveniență verificabilă, sau încrederea va rămâne fragmentată pe platforme și jurisdicții?
Aș dori să spun da, dar realist, nu – nu în cinci ani. În tehnologie, cinci ani par lungi; în ceea ce privește schimbarea comportamentului și obișnuințelor utilizatorilor, este foarte scurt. Majoritatea consumatorilor sunt puțin probabil să-și bazeze deciziile pe faptul că conținutul vine cu o proveniență autentificată. Platformele tind să urmeze cererea utilizatorilor, optimizând pentru implicare, mai degrabă decât pentru proveniență.
Acest lucru ar putea să se schimbe dacă reglementarea intervine. Începem să vedem mișcări incipiente în locuri precum California, unde cerințele de etichetare și moderare sunt în curs de apariție, dar extinderea la nivel global va dura probabil mai mult timp – probabil mai aproape de un deceniu decât de cinci ani.
O altă zonă de schimbare este cea sectorială: industrii precum jurnalismul, finanțele, asigurările și sănătatea pot începe să solicite proveniență și autentificare, deoarece încrederea este fundamentală pentru operațiunile lor.
În cele din urmă, consumatorii nu se pot sinchisi de informațiile despre proveniență în termen scurt, dar se pot sinchisi de calitatea conținutului și de calitatea informației. Dacă conținutul generat de inteligență artificială devine prea omogen sau “plictisitor”, publicul poate începe să valorizeze conținutul creat de oameni în mod explicit. Acest lucru ar putea să conducă la o segmentare a pieței, cu unele platforme care prioritizează scala și conținutul generat de inteligență artificială, iar altele care se axează pe autenticitate, proveniență și material condus de oameni de încredere – dar această schimbare rămâne necunoscută.
Vă mulțumim pentru răspunsurile dvs. excelente, cititorilor care doresc să afle mai multe, li se recomandă să viziteze OpenOrigins.


