
Modele și platforme AI
Îmbunătățirea Generării Ecranului Verde pentru Difuzia Stabilă

 Adaugă Unite.AI la sursele tale preferate pe Google
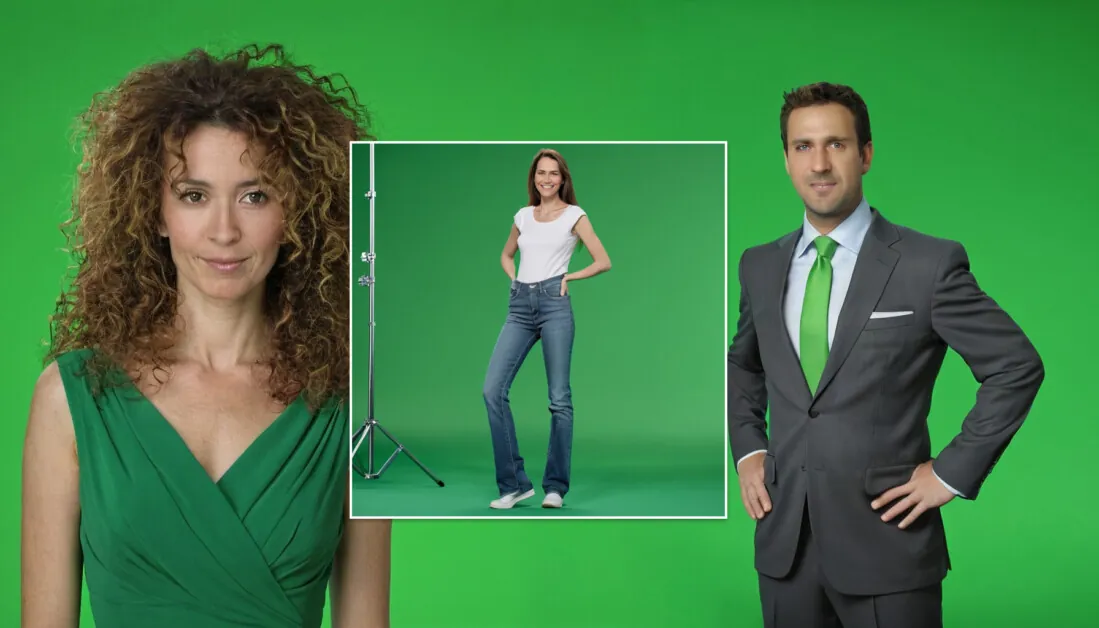
În ciuda entuziasmului comunității și al investitorilor în jurul inteligenței artificiale vizuale generative, ieșirile din astfel de sisteme nu sunt întotdeauna gata pentru utilizare în lumea reală; un exemplu este acela că sistemele de inteligență artificială generativă tind să producă imagini întregi (sau o serie de imagini, în cazul videoclipurilor), mai degrabă decât elemente individuale izolate care sunt de obicei necesare pentru diverse aplicații în multimedia și pentru practicienii de efecte vizuale.
Un exemplu simplu în acest sens este clip-art-ul proiectat pentru a “pluti” deasupra oricărui fundal țintă pe care utilizatorul l-a selectat:

Fundalul gri-deschis cu caroiaj, poate cel mai familiar utilizatorilor de Photoshop, a devenit reprezentativ pentru canalul alfa, sau canalul de transparență, chiar și în articole simple de consum, cum ar fi imaginile stoc.
Transparența acestui tip a fost disponibilă în mod obișnuit timp de peste treizeci de ani; de la revoluția digitală din anii 1990, utilizatorii au putut extrage elemente din videoclipuri și imagini prin intermediul unei serii din ce în ce mai sofisticate de seturi de instrumente și tehnici.
De exemplu, provocarea de a “scoate” fundalurile albastre și verzi din imagini video, care a fost odinioară domeniul unor procese chimice scumpe și imprimante optice (precum și măști hand-made), ar deveni munca de minute în sisteme precum Adobe After Effects și aplicațiile Photoshop (printre multe alte programe și sisteme gratuite și proprietare).
Odată ce un element a fost izolat, un canal alfa (efectiv o mască care ascunde orice conținut nerelevant) permite oricărui element din imagine să fie suprapus cu ușurință peste noi fundaluri sau compus împreună cu alte elemente izolate.

Exemple de canale alfa, cu efectele lor reprezentate în rândul inferior. Sursă: https://helpx.adobe.com/photoshop/using/saving-selections-alpha-channel-masks.html
Scoaterea în evidență
În viziunea computerizată, crearea de canale alfa intră sub incidența segmentării semantice, cu proiecte open source precum Segment Anything de la Meta, care oferă o metodă de izolare/extragere a obiectelor țintă, prin recunoaștere de obiecte semantică îmbunătățită.
Framework-ul Segment Anything a fost utilizat într-o gamă largă de fluxuri de lucru de extragere și izolare a efectelor vizuale, cum ar fi proiectul Alpha-CLIP.

Extrageri de exemple utilizând Segment Anything, în cadrul framework-ului Alpha-CLIP: Sursă: https://arxiv.org/pdf/2312.03818
Există multe alte metode de segmentare semantică care pot fi adaptate pentru atribuirea de canale alfa.
Cu toate acestea, segmentarea semantică se bazează pe date antrenate care pot să nu conțină toate categoriile de obiecte care trebuie să fie extrase. Deși modelele antrenate pe volume foarte mari de date pot permite recunoașterea unui spectru mai larg de obiecte (efectiv devenind modele fundamentale sau modele de lume), ele sunt totuși limitate de clasele pe care sunt antrenate să le recunoască cel mai bine.

Sistemele de segmentare semantică, cum ar fi Segment Anything, pot avea dificultăți în a identifica anumite obiecte sau părți ale obiectelor, așa cum se exemplifică aici în ieșirile din prompturi ambigue. Sursă: https://maucher.pages.mi.hdm-stuttgart.de/orbook/deeplearning/SAM.html
În orice caz, segmentarea semantică este la fel de mult un proces post-factum ca și o procedură de ecran verde, și trebuie să izoleze elemente fără a avea avantajul unui singur fundal de culoare care poate fi recunoscut și eliminat.
Pentru această reasons, a apărut ideea în rândul comunității utilizatorilor că imaginile și videoclipurile ar putea fi generate care conțin efectiv fundaluri de ecran verde care ar putea fi eliminate instantaneu prin metode convenționale.
Din nefericire, modelele latente de difuzie populare, cum ar fi Stable Diffusion, au adesea dificultăți în a reda un ecran verde foarte viu. Acest lucru se datorează faptului că datele de antrenare ale modelelor nu conțin de obicei multe exemple ale acestui scenariu specializat. Chiar și atunci când sistemul reușește, ideea de “verde” are tendința de a se răspândi în mod nedorit către subiectul din prim-plan, din cauza încurcăturii conceptuale:

Mai sus, vedem că Stable Diffusion a priorizat autenticitatea imaginii în detrimentul necesității de a crea o singură intensitate a culorii verzi, replicând efectiv problemele din lumea reală care apar în scenariile tradiționale de ecran verde. Mai jos, vedem că conceptul de “verde” a poluat imaginea din prim-plan. Cu cât promptul se concentrează mai mult pe conceptul de “verde”, cu atât mai gravă va fi această problemă. Sursă: https://stablediffusionweb.com/
În ciuda metodelor avansate utilizate, atât rochia femeii, cât și cravata bărbatului (în imaginile de jos de mai sus) ar avea tendința de a “dispărea” odată cu fundalul verde – o problemă care datează de la zilele îndepărtate ale îndepărtării chimice a culorilor în anii 1970 și 1980.
Ca întotdeauna, lipsurile unui model pot fi depășite prin aruncarea unor date specifice la o problemă și prin alocarea unor resurse considerabile de antrenare. Sisteme precum LayerDiffuse de la Stanford creează un model finisat capabil să genereze imagini cu canale alfa:

Proiectul LayerDiffuse de la Stanford a fost antrenat pe un milion de imagini potrivite, capabile să îmbunătățească modelul cu capacități de transparență. Sursă: https://arxiv.org/pdf/2402.17113
Din nefericire, pe lângă resursele considerabile de curare și antrenare necesare pentru această abordare, setul de date utilizat pentru LayerDiffuse nu este disponibil public, limitând utilizarea modelelor antrenate pe el. Chiar și dacă acest impediment nu ar exista, această abordare este dificil de personalizat sau dezvoltat pentru cazuri de utilizare specifice.
La scurt timp după aceea, în 2024, Adobe (ADBE ) Research a colaborat cu Universitatea Stonybrook pentru a produce MAGICK, o abordare de extragere AI antrenată pe imagini de difuzie create special.

Din lucrarea din 2024, un exemplu de extragere fină a canalului alfa în MAGICK. Sursă: https://openaccess.thecvf.com/content/CVPR2024/papers/Burgert_MAGICK_A_Large-scale_Captioned_Dataset_from_Matting_Generated_Images_using_CVPR_2024_paper.pdf
150.000 de obiecte extrase și generate de AI au fost utilizate pentru a antrena MAGICK, astfel încât sistemul să dezvolte o înțelegere intuitivă a extragerii:

Exemple din setul de date de antrenare MAGICK.
Acest set de date, așa cum afirmă lucrarea sursă, a fost foarte dificil de generat din cauza faptului că metodele de difuzie au dificultăți în a crea porțiuni solide de culoare. Prin urmare, a fost necesară selecția manuală a matelor generate.
Această blocaj logistic conduce din nou la un sistem care nu poate fi ușor dezvoltat sau personalizat, ci trebuie utilizat în cadrul capacităților sale inițiale de antrenare.
TKG-DM – Extracția ‘Nativă’ a Chroma pentru un Model de Difuzie Latentă
O nouă colaborare între cercetători germani și japonezi a propus o alternativă la astfel de metode antrenate, capabilă – așa cum afirmă lucrarea – să obțină rezultate mai bune decât metodele menționate anterior, fără a necesita antrenarea pe seturi de date special curate.

TKG-DM modifică zgomotul aleator care inițializează o imagine generativă, astfel încât să poată produce un fundal solid și cheie în orice culoare. Sursă: https://arxiv.org/pdf/2411.15580
Noua metodă abordează problema la nivelul de generare, prin optimizarea zgomotului aleator din care se generează o imagine într-un model de difuzie latentă (LDM) precum Stable Diffusion.
Abordarea se bazează pe o investigație anterioară asupra schemei de culori a unei distribuții Stable Diffusion și este capabilă să producă culori de fundal de orice fel, cu mai puțină (sau deloc) încurcătură a culorii cheie în conținutul din prim-plan, comparativ cu alte metode.

Zgomotul inițial este condiționat de o deplasare a mediei canalului care poate influența aspecte ale procesului de denoising, fără a încurca semnalul de culoare în conținutul din prim-plan.
Lucrarea afirmă:
‘Experimentele noastre extinse demonstrează că TKG-DM îmbunătățește scorurile FID și mask-FID cu 33,7% și, respectiv, 35,9%.
‘Astfel, modelul nostru fără antrenare rivalizează cu modelele finisate, oferind o soluție eficientă și versatilă pentru diverse sarcini de creare de conținut vizual care necesită control precis al prim-planului și fundalului. ‘
Noua lucrare, intitulată TKG-DM: Model de Difuzie pentru Generarea de Conținut Chroma fără Antrenare, provine de la șapte cercetători de la Universitatea Hosei din Tokyo și RPTU Kaiserslautern-Landau & DFKI GmbH, din Kaiserslautern.
Metodă
Noua abordare extinde arhitectura Stable Diffusion prin condiționarea zgomotului Gaussian inițial printr-o deplasare a mediei canalului (CMS), care produce modele de zgomot proiectate să încurajeze separarea dorită a fundalului și prim-planului în imaginea generată.

Schema fluxului de lucru al sistemului propus.
CMS ajustează media fiecărui canal de culoare, menținând în același timp dezvoltarea generală a procesului de denoising.
Autorii explică:
‘Pentru a genera obiectul din prim-plan pe fundalul chroma, aplicăm o strategie de selecție a zgomotului inițial care combină selectiv zgomotul inițial și zgomotul de culoare inițială, utilizând o mască Gaussiană 2D.
‘Această mască creează o tranziție graduală, păstrând zgomotul original în regiunea din prim-plan și aplicând zgomotul de culoare deplasat în regiunea fundalului.’

Culoarea canalului dorit pentru culoarea chroma a fundalului este instantanee cu un prompt de text vid, în timp ce conținutul real din prim-plan este creat semantic, din instrucțiunea textului utilizatorului.
Atenția proprie și atenția încrucișată sunt utilizate pentru a separa cele două fețe ale imaginii (fondalul chroma și conținutul din prim-plan). Atenția proprie ajută la coerența internă a obiectului din prim-plan, în timp ce atenția încrucișată menține fidelitatea față de promptul text. Lucrarea subliniază că, deoarece imagistica fundalului este de obicei mai puțin detaliată și accentuată în generări, influența sa mai slabă este relativ ușor de învins și înlocuită cu o porțiune de culoare pură.

O vizualizare a influenței atenției proprii și atenției încrucișate în procesul de generare a stilului chroma.
Date și Teste
TKG-DM a fost testat utilizând Stable Diffusion V1.5 și Stable Diffusion SDXL. Imaginile au fost generate la 512x512px și 1024x1024px, respectiv.
Imaginile au fost create utilizând programatorul DDIM nativ pentru Stable Diffusion, la o scară de ghidare de 7,5, cu 50 de pași de denoising. Culoarea fundalului țintită a fost verde, acum metoda dominantă de eliminare.
Noua abordare a fost comparată cu DeepFloyd, sub setările utilizate pentru MAGICK; cu modelul de difuzie de rang scăzut finisat GreenBack LoRA; și, de asemenea, cu LayerDiffuse.
Pentru date, au fost utilizate 3000 de imagini din setul de date MAGICK.

Exemple din setul de date MAGICK, din care au fost selectate 3000 de imagini pentru testele noului sistem. Sursă: https://ryanndagreat.github.io/MAGICK/Explorer/magick_rgba_explorer.html
Pentru metrici, autorii au utilizat Distanța de Incepție Fréchet (FID) pentru a evalua calitatea prim-planului. De asemenea, au dezvoltat o metrică specifică proiectului, numită m-FID, care utilizează sistemul BiRefNet pentru a evalua calitatea măștii rezultate.

Comparații vizuale ale sistemului BiRefNet față de metodele anterioare. Sursă: https://arxiv.org/pdf/2401.03407
Pentru a testa alinierea semantică cu prompturile de intrare, au fost utilizate metodele CLIP-Sentence (CLIP-S) și CLIP-Image (CLIP-I). CLIP-S evaluează fidelitatea promptului, iar CLIP-I asemănarea vizuală cu adevărul.

Primul set de rezultate calitative pentru noua metodă, de data aceasta pentru Stable Diffusion V1.5. Vă rugăm să consultați PDF-ul sursă pentru o rezoluție mai bună.
Autorii afirmă că rezultatele (vizualizate mai sus și mai jos, SD1.5 și SDXL, respectiv) demonstrează că TKG-DM obține rezultate superioare fără inginerie de prompt sau necesitatea de a antrena sau finisa un model.

Rezultate calitative SDXL. Vă rugăm să consultați PDF-ul sursă pentru o rezoluție mai bună.
Ei observă că, atunci când se dă un prompt pentru a incita un fundal verde în rezultatele generate, Stable Diffusion 1.5 are dificultăți în a genera un fundal curat, în timp ce SDXL (deși performează puțin mai bine) produce nuanțe de verde instabile care pot interfera cu separarea într-un proces chroma.
Ei mai subliniază că, deși LayerDiffuse generează fundaluri bine separate, acesta poate pierde uneori detalii, cum ar fi numere sau litere precise, și atribuie acest lucru limitărilor din setul de date. Ei adaugă că generarea măștii poate eşua uneori, ducând la imagini “neîndepărtate”.
Pentru testele cantitative, deși LayerDiffuse pare a avea un avantaj în SDXL pentru FID, autorii subliniază că acest lucru se datorează unui set de date specializat care, în esență, constituie un produs “copt” și neflexibil. Așa cum s-a menționat anterior, orice obiecte sau clase care nu sunt acoperite în acel set de date sau care sunt acoperite în mod inadecvat nu pot funcționa la fel de bine, în timp ce o nouă finisare pentru a acomoda clase noi prezintă utilizatorului o povară de curare și antrenare a datelor.

Rezultate cantitative pentru comparații. Avantajul aparent al LayerDiffuse, așa cum afirmă lucrarea, vine la un cost al flexibilității și al poverii de curare și antrenare a datelor.
Lucrarea afirmă:
‘DeepFloyd’s scoruri FID, m-FID și CLIP-I ridicate reflectă similaritatea cu adevărul, bazată pe ieșirile DeepFloyd. Cu toate acestea, această aliniere îi conferă un avantaj inerent, făcându-l nepotrivit ca o benchmark corectă pentru calitatea imaginii. Scorul său CLIP-S mai scăzut indică, de asemenea, o aliniere semantică mai slabă în comparație cu alte modele.
În general, aceste rezultate subliniază capacitatea modelului nostru de a genera prim-planuri de înaltă calitate, aliniate cu prompturile, fără finisare, oferind o soluție eficientă pentru generarea de conținut chroma.’
În final, cercetătorii au efectuat un studiu cu utilizatorii pentru a evalua aderenta la prompturi în diferitele metode. O sută de participanți au fost rugați să evalueze 30 de perechi de imagini din fiecare metodă, cu subiecte extrase utilizând BiRefNet și refinerii manuale pe toate exemplele. Abordarea fără antrenare a cercetătorilor a fost preferată în acest studiu.

Rezultatele studiului cu utilizatorii.
TKG-DM este compatibil cu sistemul terță parte popular ControlNet pentru Stable Diffusion, și autorii susțin că produce rezultate superioare capacității native a ControlNet de a obține acest tip de separare.
Concluzie
Poate cea mai remarcabilă concluzie din această nouă lucrare este măsura în care modelele de difuzie latentă sunt încurcate, în contrast cu percepția publică populară că acestea pot separa cu ușurință aspectele imaginilor și videoclipurilor atunci când generează conținut nou.
Studiul subliniază, de asemenea, măsura în care comunitatea de cercetare și de hobby a recurs la finisarea ca o soluție post-factum pentru lipsurile modelelor – o soluție care va aborda întotdeauna clase și tipuri specifice de obiecte. Într-un astfel de scenariu, un model finisat va funcționa foarte bine pe un număr limitat de clase sau va funcționa tolerabil de bine pe un volum mult mai mare de clase și obiecte posibile, în funcție de cantitatea mai mare de date din seturile de antrenare.
Prin urmare, este împroșcător să vedem cel puțin o soluție care nu se bazează pe astfel de soluții laborioase și, în mod discutabil, neîncredere.
* La filmările filmului Superman din 1978, actorul Christopher Reeve a trebuit să poarte un costum Superman de culoare turcoaz pentru a evita ca costumul iconic albastru să fie ștears. Culoarea albastră a costumului a fost restaurată ulterior prin color-grading.


