
Ângulo de Anderson
Três desafios à frente para o Stable Diffusion

 Adicione Unite.AI às suas fontes preferidas no Google
Pontos-chaveO Stable Diffusion tem dificuldades com membros humanos devido a anotações de dados de…
Ver mais
- O Stable Diffusion tem dificuldades com membros humanos devido a anotações de dados de treinamento insuficientemente granulares.
- Métodos de upscaling baseados em blocos podem gerar imagens fragmentadas sem a consciência contextual mais ampla.
- A resolução nativa de 512x512 do modelo limita a qualidade da saída e exige soluções complexas.
A lançamento do modelo de síntese de imagem de difusão latente da stability.ai, Stable Diffusion, há algumas semanas, pode ser uma das mais significativas divulgações tecnológicas desde DeCSS em 1999; certamente é o maior evento em imagens geradas por IA desde que o código de deepfakes de 2017 foi copiado para o GitHub e bifurcado no que se tornaria DeepFaceLab e FaceSwap, bem como o software de transmissão de deepfakes em tempo real DeepFaceLive.
De repente, a frustração do usuário sobre as restrições de conteúdo na API de síntese de imagens do DALL-E 2 foram eliminadas, pois se descobriu que o filtro NSFW da Stable Diffusion podia ser desativado alterando uma única linha de código. Reddits de Stable Diffusion com foco em pornografia surgiram quase imediatamente e foram rapidamente cortados, enquanto a comunidade de desenvolvedores e usuários se dividiu no Discord em comunidades oficiais e NSFW, e o Twitter começou a se encher de criações fantásticas da Stable Diffusion.
No momento, cada dia parece trazer alguma inovação incrível dos desenvolvedores que adotaram o sistema, com plugins e complementos de terceiros sendo escritos rapidamente para Krita, Photoshop, Cinema4D, Blender e muitas outras plataformas de aplicativos.
Enquanto isso, a criação de prompts – a arte profissional de “sussurrar” para a IA, que pode acabar sendo a opção de carreira mais curta desde “organizador de Filofax” – já está sendo comercializada, enquanto a monetização inicial da Stable Diffusion está ocorrendo no nível Patreon, com a certeza de que haverá ofertas mais sofisticadas por vir, para aqueles que não querem navegar por instalações baseadas em Conda do código-fonte, ou os filtros NSFW proibitivos de implementações baseadas na web.
O ritmo de desenvolvimento e a liberdade de exploração dos usuários estão ocorrendo a uma velocidade tão vertiginosa que é difícil ver muito à frente. Basicamente, não sabemos exatamente com o que estamos lidando ainda, ou quais são as limitações ou possibilidades.
No entanto, vamos dar uma olhada em três dos desafios mais interessantes e difíceis que a comunidade da Stable Diffusion, que se formou e cresceu rapidamente, pode enfrentar e, esperamos, superar.
1: Otimizando Pipelines Baseados em Blocos
Apresentados com recursos de hardware limitados e limites rígidos na resolução das imagens de treinamento, parece provável que os desenvolvedores encontrem soluções para melhorar tanto a qualidade quanto a resolução da saída da Stable Diffusion. Muitos desses projetos estão prestes a envolver a exploração das limitações do sistema, como sua resolução nativa de apenas 512×512 pixels.
Como é sempre o caso com iniciativas de visão computacional e síntese de imagens, a Stable Diffusion foi treinada em imagens com razão de aspecto quadrado, neste caso, reamostradas para 512×512, para que as imagens de origem pudessem ser regularizadas e caber nos limites dos GPUs que treinaram o modelo.
Portanto, a Stable Diffusion “pensa” (se é que pensa) em termos de 512×512, e certamente em termos quadrados. Muitos usuários que atualmente estão explorando os limites do sistema relatam que a Stable Diffusion produz os resultados mais confiáveis e menos propensos a falhas nessa razão de aspecto bastante limitada (veja “resolvendo problemas com membros” abaixo).
Embora várias implementações apresentem escalas via RealESRGAN (e possam corrigir faces mal renderizadas via GFPGAN), vários usuários estão atualmente desenvolvendo métodos para dividir imagens em seções de 512x512px e costurá-las para formar obras compostas maiores.

Esta renderização de 1024×576, uma resolução normalmente impossível em uma única renderização da Stable Diffusion, foi criada copiando e colando o arquivo attention.py do fork DoggettX do Stable Diffusion (uma versão que implementa o escalonamento baseado em blocos) em outro fork. Fonte: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Embora algumas iniciativas desse tipo usem código original ou outras bibliotecas, a adaptação txt2imghd do GOBIG (um modo no ProgRockDiffusion faminto de VRAM) está prestes a fornecer essa funcionalidade ao ramo principal em breve. Embora o txt2imghd seja uma adaptação dedicada do GOBIG, outros esforços de desenvolvedores da comunidade envolvem implementações diferentes do GOBIG.

Uma imagem convenientemente abstrata na renderização original de 512x512px (à esquerda e segunda à esquerda); escalada pelo ESGRAN, que agora é mais ou menos nativo em todas as distribuições da Stable Diffusion; e dado ‘atenção especial’ por meio de uma implementação do GOBIG, produzindo detalhes que, pelo menos dentro dos limites da seção da imagem, parecem melhor escalados. Fonte: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
O tipo de exemplo abstrato apresentado acima tem muitos “pequenos reinos” de detalhes que se adequam a essa abordagem solipsística de escalonamento, mas que podem exigir soluções de código mais desafiadoras para produzir escalonamento coeso e não repetitivo que não pareça ter sido montado a partir de muitas partes. Não menos, no caso de faces humanas, onde estamos particularmente atentos a aberrações ou artefatos “desconcertantes”. Portanto, as faces podem eventualmente precisar de uma solução dedicada.
A Stable Diffusion atualmente não tem mecanismo para focar a atenção na face durante uma renderização da mesma maneira que os humanos priorizam as informações faciais. Embora alguns desenvolvedores nas comunidades do Discord estejam considerando métodos para implementar esse tipo de “atenção aprimorada”, atualmente é muito mais fácil melhorar a face manualmente (e, eventualmente, automaticamente) após a renderização inicial ter ocorrido.
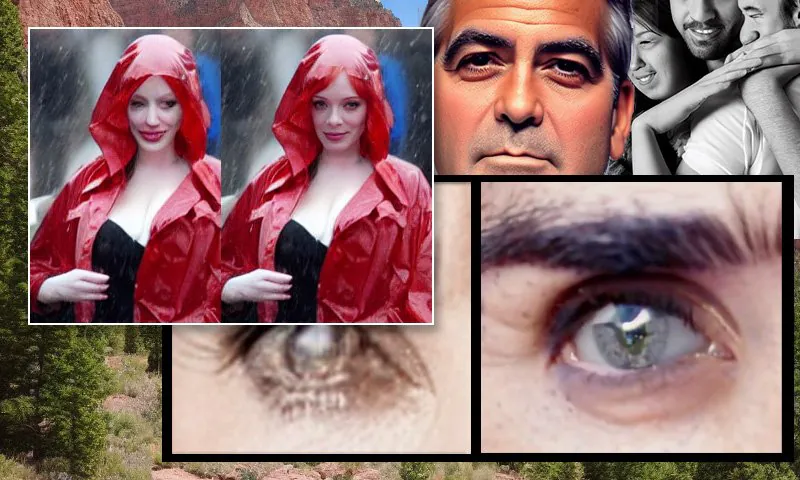
Um rosto humano tem uma lógica semântica interna e completa que não será encontrada em um “bloco” do canto inferior de (por exemplo) um prédio, e, portanto, é atualmente possível “zoomar” e re-renderizar um rosto “esboçado” na saída da Stable Diffusion.

À esquerda, o esforço inicial da Stable Diffusion com o prompt ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’. À direita, um rosto aprimorado obtido alimentando o rosto borrado e esboçado da primeira renderização de volta para a atenção total da Stable Diffusion usando Img2Img (veja imagens animadas abaixo).
Na ausência de uma solução de inversão textual dedicada (veja abaixo), isso só funcionará para imagens de celebridades onde a pessoa em questão já está bem representada nos subconjuntos de dados LAION que treinaram a Stable Diffusion. Portanto, funcionará com pessoas como Tom Cruise, Brad Pitt, Jennifer Lawrence e um número limitado de verdadeiras personalidades da mídia que estão presentes em grande número de imagens nos dados de origem.
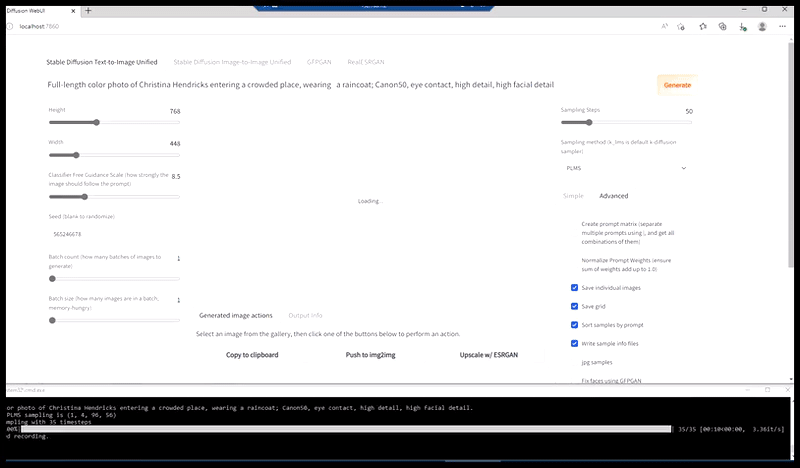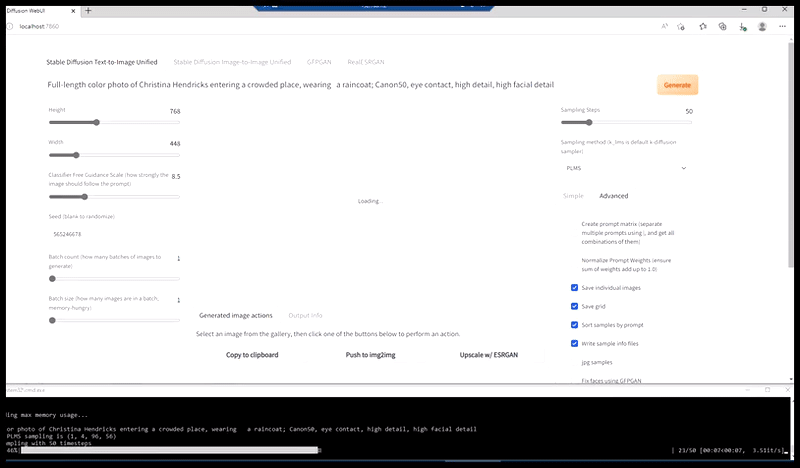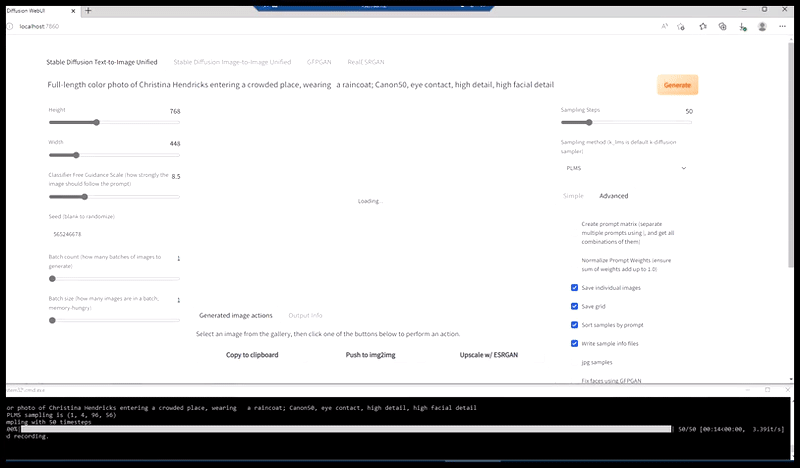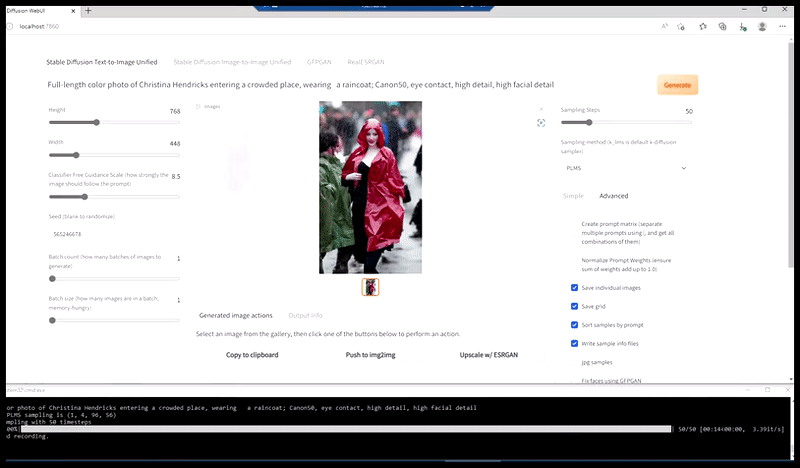
Gerando uma foto de imprensa plausível com o prompt ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’.
Para celebridades com carreiras longas e duradouras, a Stable Diffusion geralmente gerará uma imagem da pessoa em uma idade recente (ou seja, mais velha), e será necessário adicionar prompts adjuntos, como ‘young’ ou ‘in the year [YEAR]’, para produzir imagens com aparência mais jovem.

Com uma carreira proeminente, muito fotografada e consistente que abrange quase 40 anos, a atriz Jennifer Connelly é uma das poucas celebridades no LAION que permitem que a Stable Diffusion represente diversas idades. Fonte: prepack Stable Diffusion, local, v1.4 checkpoint; prompts relacionados à idade.
Isso ocorre principalmente devido à proliferação da fotografia de imprensa digital (e não à dispendiosa fotografia baseada em emulsão) a partir da metade dos anos 2000, e ao posterior crescimento no volume de saída de imagens devido ao aumento das velocidades de banda larga.
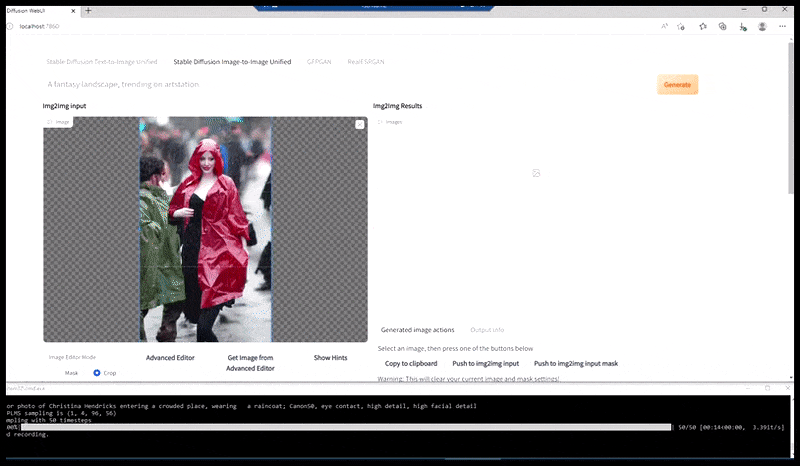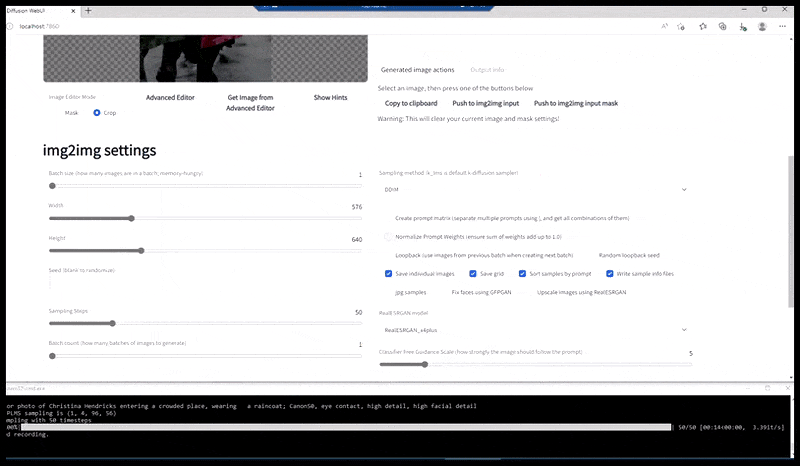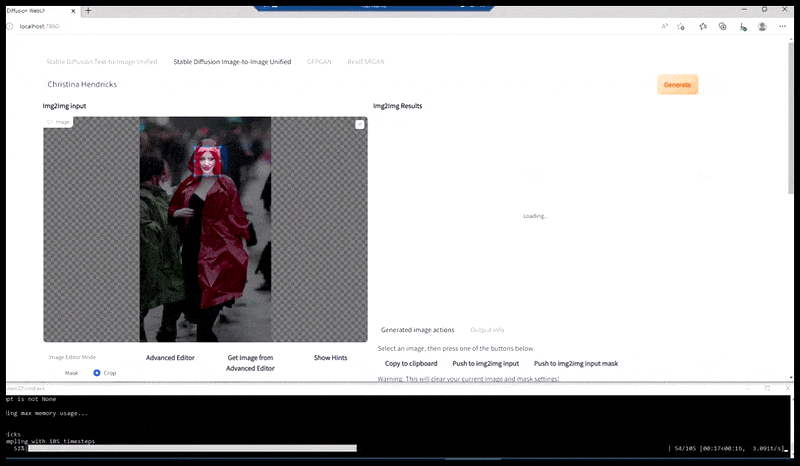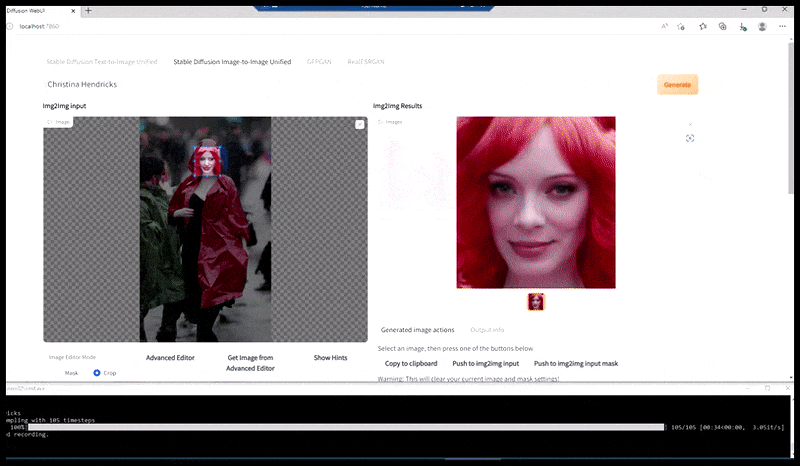
A imagem renderizada é passada para o Img2Img na Stable Diffusion, onde uma ‘área de foco’ é selecionada, e uma nova renderização de tamanho máximo é feita apenas dessa área, permitindo que a Stable Diffusion concentre todos os recursos disponíveis em recriar o rosto.
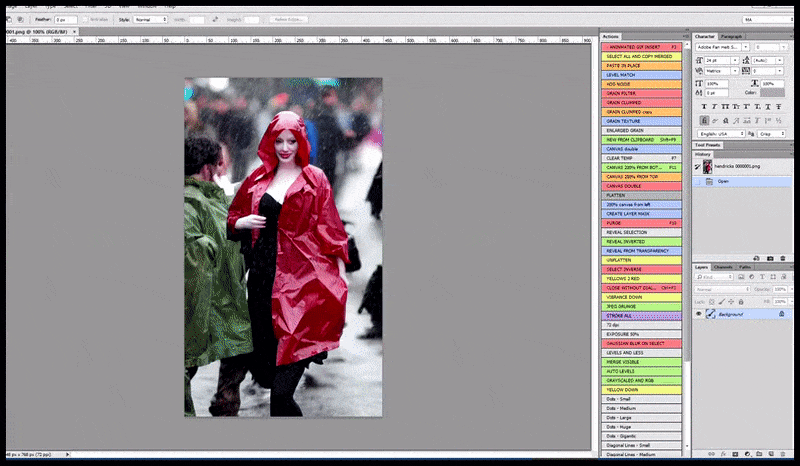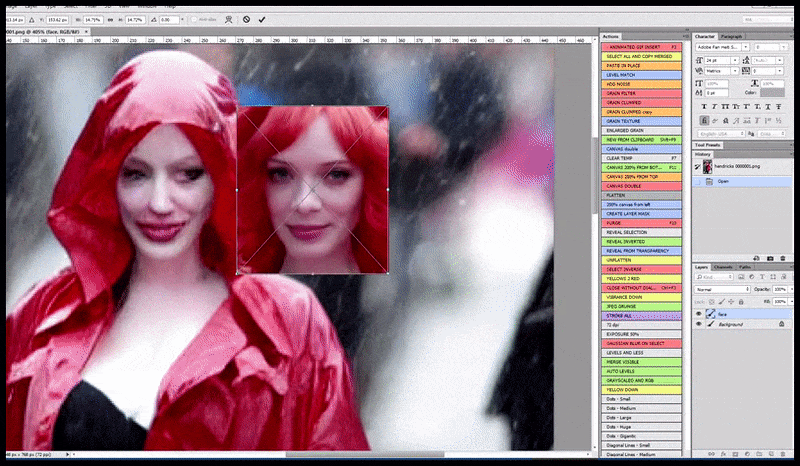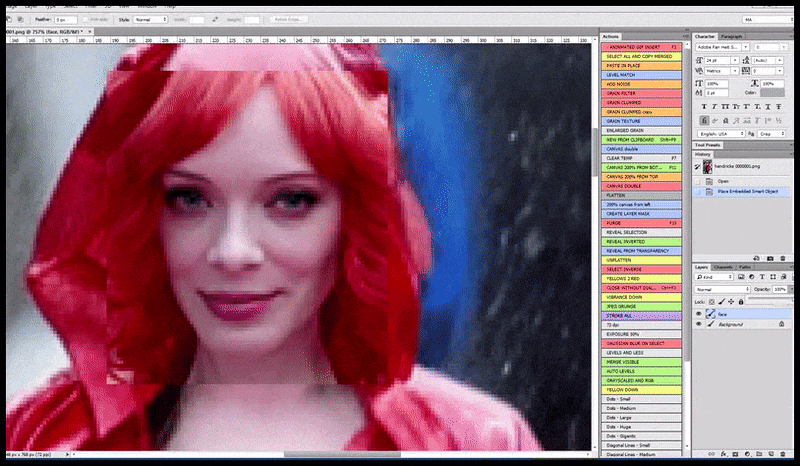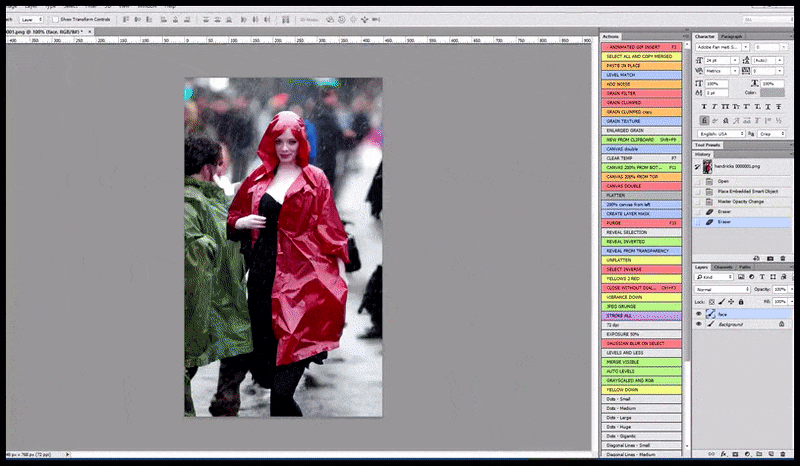
Compondo o rosto de ‘alta atenção’ de volta para a renderização original. Além das faces, esse processo só funcionará com entidades que tenham uma aparência coesa e integral conhecida, como uma porção da foto original que tenha um objeto distinto, como um relógio ou um carro. Escalonar uma seção de – por exemplo – uma parede, levará a uma parede re montada com uma aparência muito estranha, porque as renderizações de blocos não tinham contexto mais amplo para essa ‘peça de quebra-cabeça’ enquanto estavam renderizando.
Algumas celebridades no banco de dados vêm ‘congeladas’ no tempo, seja porque morreram cedo (como Marilyn Monroe), ou porque alcançaram apenas uma proeminência mainstream passageira, produzindo um grande volume de imagens em um período de tempo limitado. As consultas ao Stable Diffusion pode ser considerada um tipo de ‘índice de popularidade atual’ para estrelas modernas e mais antigas. Para algumas celebridades mais velhas e atuais, não há imagens suficientes nos dados de origem para obter uma semelhança muito boa, enquanto a popularidade duradoura de certas estrelas falecidas ou desaparecidas assegura que sua semelhança razoável possa ser obtida do sistema.

As renderizações da Stable Diffusion revelam rapidamente quais rostos famosos estão bem representados nos dados de treinamento. Apesar de sua enorme popularidade como uma adolescente mais velha no momento da escrita, Millie Bobby Brown era mais jovem e menos conhecida quando os conjuntos de dados de origem LAION foram coletados da web, tornando uma semelhança de alta qualidade com a Stable Diffusion problemática no momento.
Onde os dados estão disponíveis, soluções de escalonamento baseadas em blocos na Stable Diffusion podem ir além de se concentrar no rosto: elas podem potencialmente permitir faces ainda mais precisas e detalhadas, dividindo as características faciais e aplicando todos os recursos de GPU locais em recursos salientes individualmente, antes da re montagem – um processo que atualmente é manual.

Isso não se limita a faces, mas é limitado a partes de objetos que sejam pelo menos tão previsivelmente colocadas no contexto mais amplo do objeto hospedeiro e que se conformem a embeddings de alto nível que se possa razoavelmente esperar encontrar em um conjunto de dados de larga escala.
O limite real é a quantidade de dados de referência disponíveis no conjunto de dados, porque, eventualmente, detalhes profundamente iterados se tornarão completamente ‘alucinados’ (ou seja, fictícios) e menos autênticos.
Tais ampliações granulares de alto nível funcionam no caso de Jennifer Connelly, porque ela está bem representada em diversas idades na estética LAION (o subconjunto principal da LAION 5B que a Stable Diffusion usa), e geralmente em toda a LAION; em muitos outros casos, a precisão sofreria de falta de dados, necessitando de ajustes finos (treinamento adicional, veja ‘Customização’ abaixo) ou Inversão Textual (veja abaixo).
Os blocos são uma maneira poderosa e relativamente barata para a Stable Diffusion produzir saídas de alta resolução, mas o escalonamento algorítmico de blocos dessa natureza, se carece de algum tipo de mecanismo de atenção de alto nível, pode não atingir os padrões desejados em uma variedade de tipos de conteúdo.
2: Resolvendo problemas com membros humanos
A Stable Diffusion não vive à altura de seu nome ao retratar a complexidade dos membros humanos. As mãos podem se multiplicar aleatoriamente, os dedos se fundem, uma terceira perna aparece sem ser convidado e os membros existentes desaparecem sem deixar rastros. Em sua defesa, a Stable Diffusion compartilha o problema com outros modelos semelhantes, e certamente com o DALL-E 2.

Resultados não editados do DALL-E 2 e da Stable Diffusion (1.4) no final de agosto de 2022, ambos mostrando problemas com membros. O prompt é ‘A woman embracing a man’
Os fãs da Stable Diffusion que esperam que o próximo checkpoint 1.5 (uma versão mais intensamente treinada do modelo, com parâmetros aprimorados) resolva o problema dos membros podem ficar desapontados. O novo modelo, que será lançado em cerca de duas semanas, está sendo lançado no portal comercial stability.ai DreamStudio, que usa o 1.5 por padrão, e onde os usuários podem comparar a nova saída com renderizações de seus sistemas locais ou outros sistemas 1.4:

Fonte: prepack local 1.4 e https://beta.dreamstudio.ai/

Fonte: prepack local 1.4 e https://beta.dreamstudio.ai/

Fonte: prepack local 1.4 e https://beta.dreamstudio.ai/
Como é muitas vezes o caso, a qualidade dos dados pode ser a causa principal contribuinte.
Os bancos de dados de código aberto que alimentam sistemas de síntese de imagens, como a Stable Diffusion e o DALL-E 2, podem fornecer muitas etiquetas para humanos individuais e ações inter-humanas. Essas etiquetas são treinadas em conjunto com as imagens associadas ou segmentos de imagens.

Os usuários da Stable Diffusion podem explorar os conceitos treinados no modelo, consultando o conjunto de dados LAION-aesthetics, um subconjunto do conjunto de dados LAION 5B maior, que alimenta o sistema. As imagens são ordenadas não por suas etiquetas alfabéticas, mas por sua ‘pontuação estética’. Fonte: https://rom1504.github.io/clip-retrieval/
Uma boa hierarquia de etiquetas individuais e classes que contribuem para a representação de um braço humano seria algo como corpo>braço>mão>dedos>[subdedos + polegar]> [segmentos de dedos]>Unhas.

Segmentação semântica granular das partes de uma mão. Mesmo essa deconstrução extraordinariamente detalhada deixa cada ‘dedo’ como uma entidade única, não contabilizando as três seções de um dedo e as duas seções de um polegar. Fonte: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
Na realidade, as imagens de origem são improváveis de serem consistentemente anotadas em todo o conjunto de dados, e algoritmos de etiquetagem não supervisionados provavelmente pararão no nível mais alto de – por exemplo – ‘mão’, e deixarão os pixels internos (que tecnicamente contêm informações de ‘dedos’) como uma massa não etiquetada de pixels, da qual características serão derivadas arbitrariamente, e que podem se manifestar em renderizações posteriores como um elemento desconcertante.

Como deveria ser (no alto à direita, se não for um gancho de boxe), e como tende a ser (à direita, abaixo), devido a recursos limitados para etiquetagem, ou exploração arquitetônica de tais etiquetas, se elas existem no conjunto de dados.
Portanto, se um modelo de difusão latente chegar a renderizar um braço, é quase certo que pelo menos tentará renderizar uma mão no final daquele braço, porque braço>mão é a hierarquia mínima necessária, bastante alta no que a arquitetura sabe sobre ‘anatomia humana’.
Depois disso, ‘dedos’ podem ser o menor agrupamento, mesmo que haja 14 subpartes de dedos/polegar adicionais a considerar ao representar mãos humanas.
Se essa teoria se mantém, não há remédio real, devido à falta de orçamento setorial para anotação manual, e à falta de algoritmos eficazes o suficiente que possam automatizar a etiquetagem enquanto produziam taxas de erro baixas. Em essência, o modelo pode atualmente estar confiando na consistência anatômica humana para encobrir as deficiências do conjunto de dados em que foi treinado.
Um possível motivo pelo qual não pode confiar nisso, recentemente proposto no Discord da Stable Diffusion, é que o modelo pode se confundir sobre a quantidade correta de dedos que uma mão humana realista deve ter, porque o banco de dados LAION derivado que alimenta o modelo apresenta personagens de desenho animado que podem ter menos dedos (o que é em si um atalho para economizar trabalho).

Dois dos possíveis culpados pelo ‘síndrome de dedos faltantes’ na Stable Diffusion e modelos semelhantes. Abaixo, exemplos de mãos de desenho animado do conjunto de dados LAION-aesthetics que alimenta a Stable Diffusion. Fonte: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Se isso for verdade, então a única solução óbvia é retreinar o modelo, excluindo conteúdo humano não realista – garantindo que casos genuínos de omissão (ou seja, amputados) sejam etiquetados como exceções. Do ponto de vista da curação de dados, isso seria um desafio considerável, particularmente para esforços comunitários com recursos limitados.
A segunda abordagem seria aplicar filtros que excluam tal conteúdo (ou seja, ‘mão com três ou cinco dedos’) de se manifestar no momento da renderização, da mesma forma que a OpenAI, em certa medida, filtrou o GPT-3 e o DALL-E 2, para que sua saída pudesse ser regulamentada sem precisar retreinar os modelos de origem.

Para a Stable Diffusion, a distinção semântica entre dedos e até membros pode se tornar terrivelmente confusa, lembrando o filão de ‘horror corporal’ dos filmes de terror dos anos 80, de diretores como David Cronenberg. Fonte: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
No entanto, isso novamente exigiria etiquetas que talvez não existam em todas as imagens afetadas, deixando o mesmo desafio logístico e orçamentário.
Pode-se argumentar que restam dois caminhos: jogar mais dados no problema e aplicar sistemas interpretativos de terceiros que possam intervir quando erros físicos do tipo descrito aqui estão sendo apresentados ao usuário final (pelo menos, o último daria à OpenAI um método para fornecer reembolsos por renderizações de ‘horror corporal’, se a empresa estivesse motivada a fazê-lo).
3: Customização
Uma das possibilidades mais empolgantes para o futuro da Stable Diffusion é a perspectiva de usuários ou organizações desenvolverem sistemas revisados; modificações que permitem que o conteúdo fora da esfera pré-treinada LAION seja integrado ao sistema – idealmente sem o custo descontrolado de treinar o modelo inteiro novamente, ou o risco envolvido ao treinar um grande volume de imagens novas em um modelo existente, maduro e capaz.
Por analogia: se dois alunos menos talentosos se juntam a uma turma avançada de trinta alunos, eles ou se adaptarão e alcançarão o nível, ou falharão como outsiders; em qualquer caso, o desempenho médio da turma provavelmente não será afetado. Se 15 alunos menos talentosos se juntarem, no entanto, a curva de notas da turma inteira provavelmente sofrerá.
Da mesma forma, a rede sinérgica e bastante delicada de relacionamentos que se desenvolvem durante o treinamento de modelo prolongado e caro pode ser comprometida, e em alguns casos efetivamente destruída, por novos dados excessivos, reduzindo a qualidade da saída do modelo como um todo.
O caso para fazer isso é principalmente onde seu interesse reside em completamente sequestrar a compreensão conceitual do modelo de relacionamentos e coisas, e apropriá-lo para a produção exclusiva de conteúdo que é semelhante ao material adicional que você adicionou.
Assim, treinar 500.000 quadros de Os Simpsons em um checkpoint de Stable Diffusion existente provavelmente resultará em um simulador de Os Simpsons melhor do que o original poderia oferecer, supondo que suficientes relações semânticas amplas sobrevivam ao processo (ou seja, Homer Simpson comendo um cachorro-quente, que pode exigir material sobre cachorros-quentes que não estava em seu material adicional, mas já existia no checkpoint), e supondo que você não queira mudar repentinamente de conteúdo de Os Simpsons para criar paisagens fabulosas de Greg Rutkowski – porque seu modelo pós-treinado teve sua atenção massivamente desviada, e não será tão bom em fazer esse tipo de coisa como costumava ser.
Um exemplo notável disso é o waifu-diffusion, que treinou com sucesso 56.000 imagens de anime em um checkpoint de Stable Diffusion treinado e concluído. É uma perspectiva difícil para um hobbyista, no entanto, já que o modelo exige um mínimo de 30GB de VRAM, muito além do que provavelmente estará disponível no nível de consumidor nas próximas versões da série 40XX da NVIDIA.

O treinamento de conteúdo personalizado na Stable Diffusion via waifu-diffusion: o modelo levou duas semanas de pós-treinamento para produzir esse nível de ilustração. As seis imagens à esquerda mostram o progresso do modelo, à medida que o treinamento prosseguiu, em produzir saídas coerentes com base nos novos dados de treinamento. Fonte: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Um grande esforço pode ser gasto em ‘bifurcações’ de checkpoints da Stable Diffusion, apenas para ser frustrado pela dívida técnica. Desenvolvedores no Discord oficial já indicaram que lançamentos de checkpoints posteriores não serão necessariamente compatíveis com versões anteriores, mesmo com a lógica de prompt que pode ter funcionado com uma versão anterior, já que seu interesse principal é obter o melhor modelo possível, em vez de suportar aplicativos e processos legados.
Portanto, uma empresa ou indivíduo que decide bifurcar um checkpoint em um produto comercial efetivamente não tem volta; sua versão do modelo é, a partir desse ponto, uma ‘bifurcação rígida’, e não poderá aproveitar os benefícios upstream de lançamentos posteriores da stability.ai – o que é um compromisso considerável.
A esperança atual e maior para a customização da Stable Diffusion é a Inversão Textual, onde o usuário treina um punhado de CLIP imagens alinhadas.

Uma colaboração entre a Universidade de Tel Aviv e a NVIDIA, a inversão textual permite o treinamento de entidades discretas e novas, sem destruir as capacidades do modelo de origem. Fonte: https://textual-inversion.github.io/
A limitação aparente da inversão textual é que um número muito baixo de imagens é recomendado – tão baixo quanto cinco. Isso efetivamente produz uma entidade limitada que pode ser mais útil para tarefas de transferência de estilo do que para a inserção de objetos fotorealistas.
No entanto, experimentos estão atualmente ocorrendo nos vários Discords da Stable Diffusion que usam um número muito maior de imagens de treinamento, e ainda não se sabe quão produtivo o método pode se provar. Mais uma vez, a técnica exige uma grande quantidade de VRAM, tempo e paciência.
Devido a esses fatores limitantes, podemos ter que esperar um pouco para ver alguns dos experimentos de inversão textual mais sofisticados dos entusiastas da Stable Diffusion – e se essa abordagem pode ‘colocar você na foto’ de uma maneira que pareça melhor do que um corte e cola do Photoshop, enquanto retém a funcionalidade assombrosa dos checkpoints oficiais.
Publicado pela primeira vez em 6 de setembro de 2022.


