
Ângulo de Anderson
As Falsificações Menores Podem Ser a Grande Ameaça

 Adicione Unite.AI às suas fontes preferidas no Google
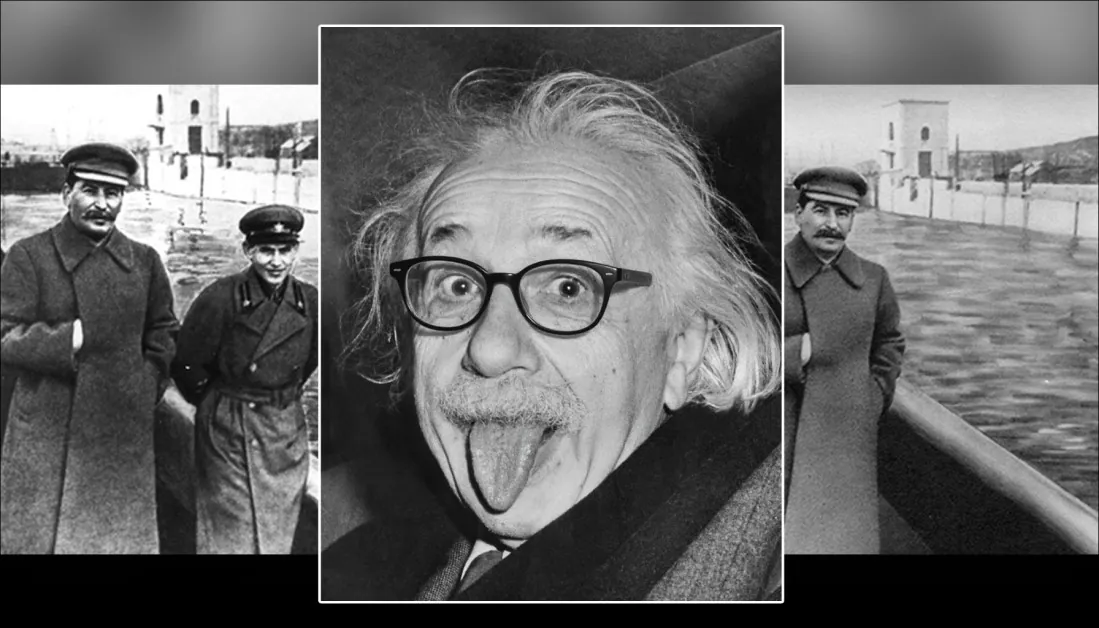
As ferramentas de IA conversacional, como ChatGPT e Google Gemini, estão sendo usadas para criar deepfakes que não trocam rostos, mas de maneiras mais sutis podem reescrever toda a história dentro de uma imagem. Alterando gestos, objetos e fundos, essas edições enganam tanto os detectores de IA quanto os humanos, aumentando as apostas para identificar o que é real online.
No clima atual, particularmente após a promulgação de legislações significativas, como a lei TAKE IT DOWN, muitos de nós associam deepfakes e síntese de identidade impulsionada por IA a pornografia não consensual e manipulação política – em geral, distorsões grosseiras da verdade.
Isso nos acostuma a esperar que as imagens manipuladas por IA sejam sempre direcionadas a conteúdos de alto impacto, onde a qualidade da renderização e a manipulação do contexto possam alcançar um golpe de credibilidade, pelo menos no curto prazo.
Historicamente, no entanto, alterações muito mais sutis tiveram frequentemente um efeito mais sinistro e duradouro – como a fotografia de truques de estado da arte que permitiu que Stálin removesse aqueles que haviam caído em desfavor do registro fotográfico, como satirizado no romance de George Orwell 1984, onde o protagonista Winston Smith passa seus dias reescrevendo a história e tendo fotos criadas, destruídas e ’emendadas’.
No exemplo a seguir, o problema com a segunda foto é que não sabemos o que não sabemos – que o ex-chefe da polícia secreta de Stálin, Nikolai Yezhov, costumava ocupar o espaço onde agora há apenas uma barreira de segurança:

Agora você vê, agora ele… some. A manipulação fotográfica da era de Stálin remove um membro do partido da história. Fonte: Domínio público, via https://www.rferl.org/a/soviet-airbrushing-the-censors-who-scratched-out-history/29361426.html
Correntes desse tipo, frequentemente repetidas, persistem de muitas maneiras; não apenas culturalmente, mas na própria visão computacional, que deriva tendências de temas e motivos estatisticamente dominantes nos conjuntos de dados de treinamento. Para dar um exemplo, o fato de que os smartphones reduziram a barreira de entrada e massivamente reduziram o custo da fotografia, significa que sua iconografia se tornou inelutavelmente associada a muitos conceitos abstratos, mesmo quando isso não é apropriado.
Se as deepfakes convencionais podem ser percebidas como um ato de ‘assalto’, alterações perniciosas e persistentes em mídia áudio-visual são mais semelhantes a ‘gaslighting’. Além disso, a capacidade dessas deepfakes de passar despercebidas torna difícil identificá-las por meio de sistemas de detecção de deepfakes de última geração (que estão procurando por alterações grosseiras). Essa abordagem é mais semelhante à água desgastando a rocha ao longo de um período prolongado do que uma rocha atirada na cabeça.
MultiFakeVerse
Pesquisadores da Austrália fizeram uma tentativa de abordar a falta de atenção às deepfakes ‘sutis’ na literatura, criando um novo conjunto de dados substancial de manipulações de imagens centradas em pessoas que alteram contexto, emoção e narrativa sem alterar a identidade central da pessoa:

Amostrado do novo conjunto, pares reais/falsos, com algumas alterações mais sutis do que outras. Note, por exemplo, a perda de autoridade para a mulher asiática, inferior-direita, à medida que seu estetoscópio de médico é removido pela IA. Ao mesmo tempo, a substituição do bloco do médico pelo clipe não tem um ângulo semântico óbvio. Fonte: https://huggingface.co/datasets/parulgupta/MultiFakeVerse_preview
Intitulado MultiFakeVerse, o conjunto consiste em 845.826 imagens geradas por meio de modelos de linguagem de visão (VLMs), que podem ser acessados online e baixados, com permissão.
Os autores afirmam:
‘Essa abordagem VLM impulsionada permite alterações semânticas e cientes de contexto, como modificar ações, cenas e interações entre humanos e objetos, em vez de trocas de identidade sintéticas ou edições de nível baixo e regionais específicas comuns em conjuntos de dados existentes.
‘Nossos experimentos revelam que os atuais modelos de detecção de deepfakes de última geração e os observadores humanos lutam para detectar essas manipulações sutis, mas significativas.’
Os pesquisadores testaram tanto humanos quanto os principais sistemas de detecção de deepfakes em seu novo conjunto de dados para ver quão bem essas manipulações sutis poderiam ser identificadas. Os participantes humanos lutaram, classificando imagens como reais ou falsas apenas cerca de 62% do tempo, e tiveram ainda mais dificuldade em identificar quais partes da imagem haviam sido alteradas.
Os detectores de deepfakes existentes, treinados principalmente em conjuntos de dados de troca de faces ou inpainting, performaram mal também, frequentemente falhando em registrar que qualquer manipulação havia ocorrido. Mesmo após ajuste fino no MultiFakeVerse, as taxas de detecção permaneceram baixas, exposto como os sistemas atuais lidam mal com esses tipos de edições narrativas impulsionadas.
O novo artigo é intitulado Multiverse Through Deepfakes: O Conjunto de Dados MultiFakeVerse de Manipulações Visuais e Conceituais Centradas em Pessoas, e vem de cinco pesquisadores de universidades da Austrália. O código e os dados relacionados foram lançados no GitHub, além do hospedagem no Hugging Face mencionado anteriormente.
Método
O conjunto de dados MultiFakeVerse foi construído a partir de quatro conjuntos de imagens do mundo real que apresentam pessoas em situações diversas: EMOTIC; PISC, PIPA, e PIC 2.0. A partir de 86.952 imagens originais, os pesquisadores produziram 758.041 versões manipuladas.
Os quadros Gemini-2.0-Flash e ChatGPT-4o foram usados para propor seis edições mínimas para cada imagem – edições projetadas para alterar sutilmente como a pessoa mais proeminente na imagem seria percebida por um espectador.
Os modelos foram instruídos a gerar modificações que fariam com que o assunto parecesse ingênuo, orgulhoso, arrependido, inexperiente, ou descuidado, ou para ajustar algum elemento factual dentro da cena. Juntamente com cada edição, os modelos também produziram uma expressão de referência para claramente identificar o alvo da modificação, garantindo que o processo de edição subsequente pudesse aplicar alterações à pessoa ou objeto correto dentro de cada imagem.
Os autores esclarecem:
‘Observe que expressão de referência é um domínio amplamente explorado na comunidade, que significa uma frase que pode desambiguar o alvo em uma imagem, por exemplo, para uma imagem com dois homens sentados em uma mesa, um falando ao telefone e o outro olhando para documentos, uma expressão de referência adequada para o último seria o homem à esquerda segurando um pedaço de papel.’
Uma vez que as edições foram definidas, a manipulação de imagem real foi realizada por meio de modelos de linguagem de visão que aplicavam as alterações especificadas, deixando o resto da cena intacta. Os pesquisadores testaram três sistemas para essa tarefa: GPT-Image-1; Gemini-2.0-Flash-Image-Generation; e ICEdit.
Após a geração de vinte e dois mil amostras de imagens, o Gemini-2.0-Flash emergiu como o método mais consistente, produzindo edições que se misturavam naturalmente com a cena sem introduzir artefatos visíveis; o ICEdit frequentemente produziu forjas mais óbvias, com falhas notáveis nas regiões alteradas; e o GPT-Image-1 ocasionalmente afetou partes não intencionais da imagem, em parte devido à sua conformidade com razões de saída fixas.
Análise de Imagem
Cada imagem manipulada foi comparada com sua original para determinar quanto da imagem havia sido alterada. As diferenças de nível de pixel entre as duas versões foram calculadas, com ruído aleatório pequeno filtrado para se concentrar em edições significativas. Em algumas imagens, apenas áreas minúsculas foram afetadas; em outras, até oitenta por cento da cena foi modificada.
Para avaliar o quanto o significado de cada imagem mudou à luz dessas alterações, legendas foram geradas para as imagens originais e manipuladas usando o modelo de linguagem de visão ShareGPT-4V.
Essas legendas foram então convertidas em embeddings usando Long-CLIP, permitindo uma comparação de quanto o conteúdo havia divergido entre as versões. As mudanças semânticas mais fortes foram vistas em casos onde objetos próximos ou diretamente envolvidos com a pessoa haviam sido alterados, pois essas pequenas alterações podiam mudar significativamente como a imagem era interpretada.
O Gemini-2.0-Flash foi então usado para classificar o tipo de manipulação aplicada a cada imagem, com base em onde e como as edições foram feitas. As manipulações foram agrupadas em três categorias: edições de nível de pessoa envolviam mudanças na expressão facial do sujeito, pose, olhar, roupas ou outros recursos pessoais; edições de nível de objeto afetavam itens conectados à pessoa, como objetos que estavam segurando ou interagindo com no primeiro plano; e edições de nível de cena envolviam elementos de fundo ou aspectos mais amplos do cenário que não envolviam diretamente a pessoa.

O pipeline de geração do conjunto de dados MultiFakeVerse começa com imagens reais, onde modelos de linguagem de visão propõem edições narrativas que visam pessoas, objetos ou cenas. Essas instruções são então aplicadas por modelos de edição de imagens. O painel direito mostra a proporção de manipulações de nível de pessoa, nível de objeto e nível de cena em todo o conjunto de dados. Fonte: https://arxiv.org/pdf/2506.00868
Já que imagens individuais podiam conter vários tipos de edições ao mesmo tempo, a distribuição dessas categorias foi mapeada em todo o conjunto de dados. Aproximadamente um terço das edições visava apenas a pessoa, cerca de um quinto afetavam apenas a cena, e cerca de um sexto estavam limitados a objetos.
Avaliação do Impacto Perceptual
O Gemini-2.0-Flash foi usado para avaliar como as manipulações poderiam alterar a percepção do espectador em seis áreas: emoção, identidade pessoal, dinâmica de poder, narrativa da cena, intenção da manipulação, e preocupações éticas.
Para emoção, as edições foram frequentemente descritas com termos como alegre, envolvente, ou acessível, sugerindo mudanças na forma como os assuntos eram enquadrados emocionalmente. Em termos narrativos, palavras como profissional ou diferente indicavam mudanças na história implícita ou no cenário:

O Gemini-2.0-Flash foi solicitado a avaliar como cada manipulação afetou seis aspectos da percepção do espectador. Esquerda: estrutura de prompt de exemplo que orienta a avaliação do modelo. Direita: nuvens de palavras resumindo mudanças em emoção, identidade, narrativa da cena, intenção, dinâmica de poder e preocupações éticas em todo o conjunto de dados.
Descrições de mudanças de identidade incluíam termos como mais jovem, brincalhão, e vulnerável, mostrando como alterações menores podiam influenciar como os indivíduos eram percebidos. A intenção por trás de muitas edições foi rotulada como persuasiva, enganosa, ou estética. Embora a maioria das edições tenha sido julgada como levantando apenas preocupações éticas leves, uma pequena fração foi vista como carregando implicações éticas moderadas ou graves.

Exemplos do MultiFakeVerse mostrando como pequenas edições deslocam a percepção do espectador. Caixas amarelas destacam as regiões alteradas, com análise acompanhante de mudanças em emoção, identidade, narrativa e preocupações éticas.
Métricas
A qualidade visual do conjunto de dados MultiFakeVerse foi avaliada usando três métricas padrão: Taxa de Sinal para Ruído de Pico (PSNR); Índice de Similaridade Estrutural (SSIM); e Distância de Início de Fréchet (FID):

Pontuações de qualidade de imagem para MultiFakeVerse medidas por PSNR, SSIM e FID.
A pontuação SSIM de 0,5774 reflete um grau moderado de similaridade, consistente com o objetivo de preservar a maior parte da imagem enquanto aplica edições direcionadas; a pontuação FID de 3,30 sugere que as imagens geradas mantêm alta qualidade e diversidade; e um valor PSNR de 66,30 decibéis indica que as imagens retêm boa fidelidade visual após manipulação.
Estudo de Usuário
Um estudo de usuário foi realizado para ver quão bem as pessoas podiam identificar as falsificações sutis no MultiFakeVerse. Dezoito participantes foram mostrados cinquenta imagens, divididas igualmente entre exemplos reais e manipulados que cobriam uma variedade de tipos de edições. Cada pessoa foi solicitada a classificar se a imagem era real ou falsa, e, se falsa, a identificar que tipo de manipulação havia sido aplicada.
A precisão geral para decidir real versus falso foi de 61,67 por cento, significando que os participantes classificaram incorretamente as imagens mais de um terço do tempo.
Os autores afirmam:
‘Analisando as previsões humanas dos níveis de manipulação para as imagens falsas, a interseção média entre as previsões e os níveis de manipulação reais foi encontrada em 24,96%.
‘Isso mostra que não é trivial para os observadores humanos identificar as regiões de manipulações em nosso conjunto de dados.’
A construção do conjunto de dados MultiFakeVerse exigiu recursos computacionais extensivos: para a geração de instruções de edição, mais de 845.000 chamadas de API foram feitas para os modelos Gemini e GPT, com essas tarefas de promptamento custando cerca de $1000; produzir as imagens baseadas em Gemini custou aproximadamente $2.867; e gerar imagens usando o GPT-Image-1 custou cerca de $200. As imagens do ICEdit foram criadas localmente em um GPU NVIDIA A6000, completando a tarefa em cerca de vinte e quatro horas.
Testes
Antes dos testes, o conjunto de dados foi dividido em conjuntos de treinamento, validação e teste, selecionando primeiro 70% das imagens reais para treinamento; 10% para validação; e 20% para teste. As imagens manipuladas geradas a partir de cada imagem real foram atribuídas ao mesmo conjunto que a imagem original correspondente.

Mais exemplos de conteúdo real (esquerda) e alterado (direita) do conjunto de dados.
O desempenho na detecção de falsificações foi medido usando a precisão de nível de imagem (se o sistema classifica corretamente a imagem inteira como real ou falsa) e pontuações F1. Para a localização de regiões manipuladas, a avaliação usou Área Sob a Curva (AUC), pontuações F1 e interseção sobre união (IoU).
O conjunto de dados MultiFakeVerse foi usado contra os principais sistemas de detecção de deepfakes no conjunto de teste completo, com os frameworks rivais sendo CnnSpot; AntifakePrompt; TruFor; e o baseado em linguagem de visão SIDA. Cada modelo foi avaliado primeiro no modo zero-shot, usando seus pesos pré-treinados originais sem ajustes adicionais.
Dois modelos, CnnSpot e SIDA, foram então ajustados finamente nos dados de treinamento do MultiFakeVerse para avaliar se o ajuste fino melhorava o desempenho.

Resultados de detecção de deepfakes no MultiFakeVerse sob condições zero-shot e ajuste fino. Números entre parênteses mostram mudanças após o ajuste fino.
Desses resultados, os autores afirmam:
‘[Os] modelos treinados em conjuntos de dados de inpainting anteriores lutam para identificar nossas falsificações baseadas em edição de VLM, particularmente, o CNNSpot tende a classificar quase todas as imagens como reais. O AntifakePrompt tem o melhor desempenho zero-shot com 66,87% de precisão média de classe e 55,55% de pontuação F1.
‘Após o ajuste fino em nosso conjunto de treinamento, observamos uma melhoria no desempenho em ambos, CNNSpot e SIDA-13B, com o CNNSpot superando o SIDA-13B em termos de precisão média de classe (por 1,92%) e pontuação F1 (por 1,97%).’
O SIDA-13B foi avaliado no MultiFakeVerse para medir quão precisamente ele poderia localizar as regiões manipuladas dentro de cada imagem. O modelo foi testado tanto no modo zero-shot quanto após o ajuste fino no conjunto de dados.
No seu estado original, ele alcançou uma pontuação de interseção sobre união de 13,10, uma pontuação F1 de 19,92 e uma AUC de 14,06, refletindo um desempenho de localização fraco.
Após o ajuste fino, as pontuações melhoraram para 24,74 para IoU, 39,40 para F1 e 37,53 para AUC. No entanto, mesmo com o treinamento adicional, o modelo ainda teve dificuldade em encontrar exatamente onde as edições haviam sido feitas, destacando quão difícil pode ser detectar esses tipos de alterações pequenas e direcionadas.
Conclusão
O novo estudo expõe um ponto cego tanto na percepção humana quanto na máquina: enquanto grande parte do debate público em torno de deepfakes se concentrou em trocas de identidade de alto impacto, essas ‘edições narrativas’ mais silenciosas são mais difíceis de detectar e potencialmente mais corrosivas a longo prazo.
À medida que sistemas como ChatGPT e Gemini desempenham um papel mais ativo na geração desse tipo de conteúdo, e à medida que nós mesmos participamos cada vez mais na alteração da realidade de nossas próprias sequências de fotos, os modelos de detecção que confiam em detectar manipulações grosseiras podem oferecer defesa inadequada.
O que o MultiFakeVerse demonstra não é que a detecção falhou, mas que pelo menos parte do problema pode estar se movendo para uma forma mais difícil, mais lenta: uma onde pequenas mentiras visuais se acumulam despercebidas.
Publicado pela primeira vez na quinta-feira, 5 de junho de 2025


