
AGI e IA do futuro
Poder dos Rerankers e da Recuperação em Duas Etapas para Geração Aumentada por Recuperação

 Adicione Unite.AI às suas fontes preferidas no Google

Pontos-chaveA recuperação em dois estágios com rerankers melhora drasticamente a precisão do RAG…
Ver mais
- A recuperação em dois estágios com rerankers melhora drasticamente a precisão do RAG, primeiro buscando muitos documentos e depois reordenando-os com um modelo mais inteligente.
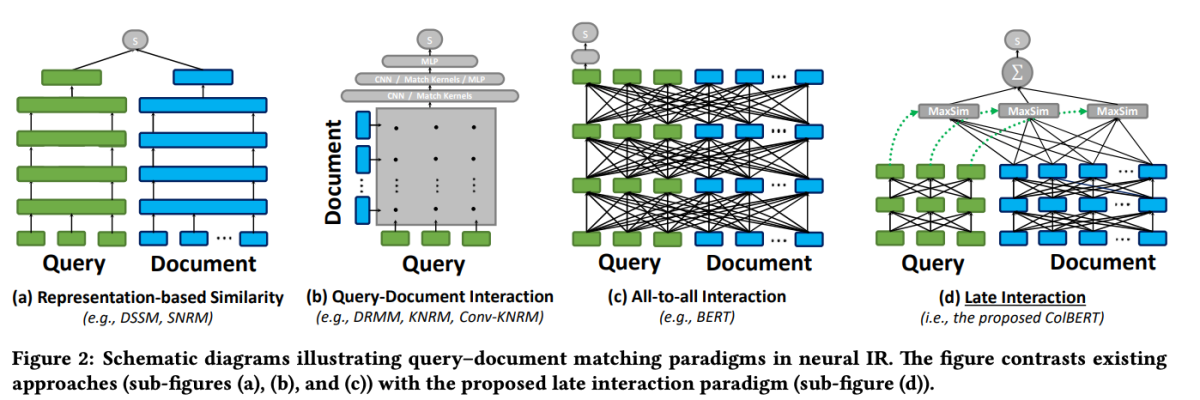
- O mecanismo de interação tardia do ColBERT permite uma busca semântica eficiente ao processar consultas e documentos separadamente até a comparação final.
- Os modelos de reranking podem ser treinados com dados específicos de domínio para resolver os problemas de fora-do-domínio comuns em modelos de embedding gerais.

Este trecho de código demonstra como configurar e usar o modelo jina-colbert-v1-en para indexar uma coleção de documentos, aproveitando sua capacidade de lidar com contextos longos de forma eficiente.
Implementando a Recuperação em Duas Etapas com Rerankers
Agora que temos uma compreensão dos princípios por trás da recuperação em duas etapas e rerankers, vamos explorar sua implementação prática dentro do contexto de um sistema RAG. Vamos aproveitar bibliotecas e frameworks populares para demonstrar a integração dessas técnicas.
Configurando o Ambiente
Antes de mergulharmos no código, vamos configurar nosso ambiente de desenvolvimento. Estaremos usando Python e várias bibliotecas de NLP populares, incluindo Hugging Face Transformers, Sentence Transformers e LanceDB.
# Instale as bibliotecas necessárias
!pip install datasets huggingface_hub sentence_transformers lancedb
Preparação de Dados
Para fins de demonstração, vamos usar o conjunto de dados “ai-arxiv-chunked” do Hugging Face Datasets, que contém mais de 400 artigos do ArXiv sobre aprendizado de máquina, processamento de linguagem natural e grandes modelos de linguagem.
from datasets import load_dataset <p>dataset = load_dataset("jamescalam/ai-arxiv-chunked", split="train")</p> &lt;pre&gt;
Em seguida, vamos pré-processar os dados e dividi-los em pedaços menores para facilitar a recuperação e processamento eficientes.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)</p>
Para a etapa de recuperação inicial, vamos usar um modelo de Sentence Transformer para codificar nossos documentos e consultas em representações de vetores densos e, em seguida, realizar uma busca de vizinhos mais próximos aproximada usando um banco de dados de vetores como o LanceDB.
from sentence_transformers import SentenceTransformer from lancedb import lancedb <p># Carregue o modelo de Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Crie um armazenamento de vetores do LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Indexe os documentos for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)</p> <p>from sentence_transformers import SentenceTransformer from lancedb import lancedb</p> <p># Carregue o modelo de Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Crie um armazenamento de vetores do LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Indexe os documentos for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)
Com os documentos indexados, podemos realizar a recuperação inicial encontrando os vizinhos mais próximos de um vetor de consulta dado.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)
Reranking
Após a recuperação inicial, vamos empregar um modelo de reranking para reordenar os documentos recuperados com base em sua relevância para a consulta. Neste exemplo, vamos usar o reranker ColBERT, um modelo de transformadores rápido e preciso, especificamente projetado para classificação de documentos.
from lancedb.rerankers import ColbertReranker

reranker = ColbertReranker()

<p># Rerank os documentos inicialmente recuperados
reranked_docs = reranker.rerank(query, initial_docs)
A lista reranked_docs agora contém os documentos reordenados com base em sua relevância para a consulta, conforme determinado pelo reranker ColBERT.
Aumento e Geração
Com os documentos reordenados e relevantes em mãos, podemos prosseguir para as etapas de aumento e geração do pipeline RAG. Vamos usar um modelo de linguagem da biblioteca Hugging Face Transformers para gerar a resposta final.
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM <p>tokenizer = AutoTokenizer.from_pretrained("t5-base") model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")</p> <p># Aumente a consulta com os documentos reordenados augmented_query = query + " " + " ".join(reranked_docs[:3])</p> <p># Gere a resposta do modelo de linguagem input_ids = tokenizer.encode(augmented_query, return_tensors="pt") output_ids = model.generate(input_ids, max_length=500) response = tokenizer.decode(output_ids[0], skip_special_tokens=True)</p> print(response)


