
Entrevistas
Nikunj Bajaj, cofundador e CEO da TrueFoundry – Série de entrevistas

 Adicione Unite.AI às suas fontes preferidas no Google
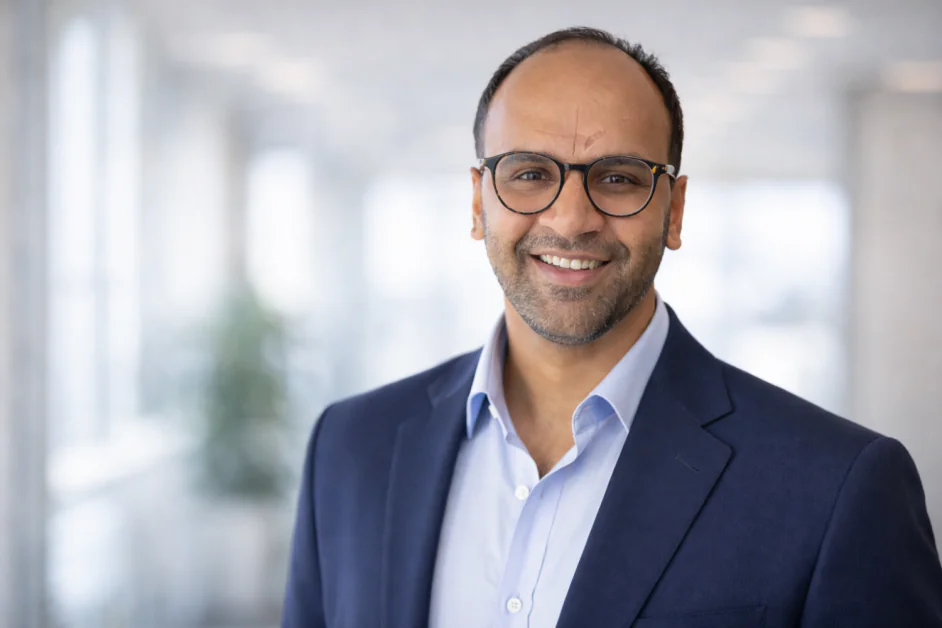
Antes de fundar a TrueFoundry, você trabalhou com pesquisa em aprendizado de máquina, IA em produção no Facebook (META ) e sistemas de recomendação em larga escala. Quais experiências o levaram mais diretamente a criar uma empresa de infraestrutura de IA empresarial e qual problema você sentia que ainda não era resolvido naquela época?
Na Meta, víamos o aprendizado de máquina como um caso particular de software e a IA generativa como um caso particular de aprendizado de máquina. Isso resultava em uma pilha tecnológica vertical, com software na base, aprendizado de máquina no meio e IA generativa no topo. Nessa estrutura, se sou um desenvolvedor de aprendizado de máquina, os modelos que construo seguem o mesmo padrão de implantação do restante do software, o que torna muito simples dimensionar os sistemas.
A maioria das empresas, porém, implantava pilhas paralelas, ou seja, pilhas separadas para software, aprendizado de máquina e IA generativa. Quando essas pilhas são paralelas, o dimensionamento se torna mais complexo devido às transferências de trabalho necessárias entre a área de aprendizado de máquina e o mundo do software.
Nossa equipe sempre trabalhou na interseção entre a criação de modelos de aprendizado de máquina e a infraestrutura para esse aprendizado. Essa perspectiva singular nos permitiu enxergar a possibilidade de levar pilhas verticais semelhantes às empresas e adaptá-las às suas necessidades específicas. No fim de 2021, também tínhamos a hipótese de que o aprendizado de máquina estava se aproximando de um ponto de inflexão. Quando isso acontecesse, mais empresas precisariam de uma pilha verticalmente integrada para implantar e dimensionar esses sistemas de forma eficaz. Foi isso que nos levou a fundar a TrueFoundry, e nossa hipótese se confirmou. A adoção de IA acelerou após o lançamento do ChatGPT no fim de 2022.
À medida que os sistemas de IA passam da experimentação às operações diárias, o que mudou na forma como as organizações devem pensar sobre confiabilidade e falhas?
Há muito mais em jogo com a IA generativa do que com os sistemas tradicionais de aprendizado de máquina. Quando esses sistemas entram em produção, as organizações enfrentam níveis muito mais altos de ambiguidade e não determinismo, porque os LLMs são estocásticos por natureza. Os sistemas de agentes construídos sobre eles acrescentam ainda mais ambiguidade.
Além disso, as falhas já não são binárias. Não se trata apenas de um sistema falhar ou não: muitos problemas aparecem como falhas parciais ou degradações silenciosas. Ao longo do tempo, os sistemas podem responder com maior latência, qualidade inferior ou comportamento incorreto. Em muitos casos, essas degradações são mais difíceis de detectar e, às vezes, ainda mais prejudiciais do que uma interrupção completa.
As organizações precisam pensar em confiabilidade não apenas em termos de tempo de atividade, mas também de degradação do desempenho ao longo do tempo.
O TrueFailover foi lançado em meio a uma onda de interrupções de serviços de nuvem e IA que tiveram grande repercussão. Quais eventos recentes deixaram claro que a confiabilidade da IA havia passado de um complemento desejável a um requisito arquitetônico fundamental?
Um de nossos clientes da área da saúde processa, em tempo real, solicitações de pacientes relacionadas a receitas médicas, nas quais o atendimento oportuno é essencial. Ele foi afetado por uma interrupção causada pela falha de um modelo. Seus fluxos de trabalho geram milhares de dólares de receita por segundo, e a interrupção prejudicou alguns desses fluxos críticos. Como esse era um dos primeiros clientes do TrueFailover, pudemos ajudá-lo a recuperar rapidamente a operação e conter o impacto.
Incidentes como esse levantam uma pergunta importante: se há cada vez mais em jogo com os sistemas de IA generativa, por que os processos de recuperação ainda são, em grande parte, manuais? Isso reforçou a ideia de que os sistemas devem ser construídos partindo do pressuposto de que falhas ocorrerão e projetados para se corrigirem automaticamente. A confiabilidade também precisa estar incorporada à própria pilha de IA por meio de gateways de IA, que podem oferecer roteamento centralizado, observabilidade, mecanismos de proteção e alternância inteligente entre modelos de diferentes provedores.
Muitas interrupções de IA ainda são descritas como pequenos contratempos técnicos. Onde você vê os verdadeiros custos econômicos e humanos começando a aparecer quando os sistemas de IA param de funcionar?
A IA empresarial evoluiu a ponto de esses contratempos já não afetarem apenas os fluxos de trabalho internos. Hoje, interrupções e degradações afetam direta e imediatamente a percepção pública e os lucros, porque as aplicações em produção agora atendem os clientes. Essa transição de testes internos para aplicações voltadas ao público, nas quais há muito em jogo, explica a crescente necessidade de atenção e supervisão da alta administração.
À medida que os sistemas de IA se integram mais profundamente aos fluxos de trabalho operacionais, as interrupções deixam de ser apenas problemas técnicos. Elas têm consequências cada vez mais diretas para os negócios, os clientes e a reputação.
Em ambientes de missão crítica, como farmácias, operações de saúde ou suporte ao cliente, com que rapidez a indisponibilidade da IA pode se transformar em risco operacional ou de reputação?
Em ambientes de missão crítica, a escalada acontece quase imediatamente, porque esses sistemas sustentam fluxos de trabalho em tempo real nos quais a resposta oportuna é fundamental. Mesmo uma breve interrupção pode paralisar processos críticos, atrasar a prestação de serviços ou interromper sistemas posteriores que dependem desses resultados, criando efeitos operacionais em cascata em toda a organização.
Em setores como a saúde, o impacto vai além da interrupção operacional e atinge a experiência do cliente e os resultados dos serviços. Se um paciente não consegue obter a tempo os medicamentos prescritos, pode haver consequências reais. Isso não é apenas um problema para o paciente: também pode prejudicar a reputação da farmácia ou do prestador de serviços de saúde. Em ambientes de missão crítica nos quais a confiança é importante, é primordial que os sistemas permaneçam em operação. Por isso, as organizações reconhecem cada vez mais que os sistemas de IA devem ser projetados com a premissa de que falhas ocorrerão e que os mecanismos de recuperação precisam ser ativados automaticamente para minimizar o risco.
Você disse que muitas equipes projetam a arquitetura pensando em capacidades, e não em continuidade. Por que acha que a resiliência historicamente recebeu menos prioridade no projeto de sistemas de IA?
Isso se deve, em grande parte, aos incentivos dentro das organizações. Novas capacidades são visíveis e empolgantes. Elas abrem caminho para demonstrações, funcionalidades e novas possibilidades do produto que a liderança pode perceber imediatamente.
A continuidade, por definição, é invisível quando tudo funciona bem. Por isso, os sistemas de recompensa tendem a favorecer o lançamento de novas funcionalidades em vez de garantir que nada deixe de funcionar. Como resultado, as organizações frequentemente investem de forma desproporcional no desenvolvimento de capacidades em comparação com a engenharia de resiliência.
Com a crescente dependência das empresas de modelos e APIs externos, que novas fragilidades estão surgindo na pilha de IA cuja importância os líderes talvez ainda não compreendam plenamente?
Os LLMs são, fundamentalmente, recursos compartilhados, e as empresas não são suas proprietárias como são da infraestrutura tradicional. Além disso, sistemas importantes e críticos para os negócios operam sobre sistemas externos que ainda não foram plenamente testados ao longo do tempo. Os próprios LLMs evoluem rapidamente, o que significa que não se pode responsabilizar um provedor de modelos por fatores como latência ou uma pequena queda no desempenho do modelo, porque ele realiza novas iterações de pesquisa muito rapidamente.
Como os LLMs são recursos compartilhados, a latência pode disparar quando outro usuário desses modelos realiza uma ação específica. A própria natureza dos LLMs introduz muitos desses pontos de falha, e as empresas, nesse novo mundo, simplesmente não têm controle total. Sem controle total, o melhor que uma empresa pode fazer é criar redundância suficiente no sistema para projetar uma solução resiliente.
Sem focar em produtos específicos, como as organizações devem repensar a arquitetura de IA para pressupor que falhas acontecerão, em vez de tratar interrupções como casos extremos raros?
As organizações devem voltar aos princípios fundamentais do projeto de sistemas distribuídos. Os sistemas de software foram construídos com a premissa de que componentes de rede e máquinas falhariam e de que uma região inteira poderia parar de funcionar.
Os sistemas de IA não devem ser diferentes. Devemos presumir que os provedores de modelos enfrentarão problemas de latência, degradações ou interrupções e incorporar redundância para que as aplicações continuem resilientes em diferentes cenários de falha.
Você espera que a resiliência da IA se torne um fator decisivo na escolha de plataformas e fornecedores, assim como o tempo de atividade e a redundância influenciaram as decisões sobre infraestrutura de nuvem?
À medida que mais sistemas de IA entram em produção, a resiliência se tornará um requisito mínimo. Se um fornecedor não conseguir apresentar gráficos e métricas de tempo de atividade e resiliência geral, nem sequer será considerado. Quando a resiliência se tornar uma expectativa básica em relação a todos os fornecedores, os fatores decisivos passarão a ser a experiência do usuário, a otimização de desempenho, a observabilidade e as capacidades do produto em níveis mais altos. Com o tempo, componentes como um gateway de IA e recursos de failover automatizado se tornarão elementos fundamentais da infraestrutura de IA empresarial.
Olhando para o futuro, o que realmente significa uma IA “pronta para produção” em um mundo no qual se espera disponibilidade contínua, e não apenas utilidade ocasional?
Sistemas de IA prontos para produção devem ser observáveis, controláveis e recuperáveis. Os três requisitos precisam ser atendidos.
Para que a IA em produção seja observável, as equipes precisam de visibilidade profunda sobre o comportamento dos modelos, a latência, as taxas de erro, o uso de tokens, a deriva e os padrões de falha. Sem uma observabilidade robusta, torna-se muito difícil detectar degradações antes que os usuários comecem a notá-las.
A capacidade de controlar os sistemas inclui modelagem do tráfego, limitação da taxa de solicitações, mecanismos de proteção, aplicação de políticas e roteamento inteligente entre modelos e provedores. É aí que um gateway de IA se torna fundamental, atuando como um plano de controle centralizado que aplica os mecanismos de proteção, oferece governança consistente e permite a alternância dinâmica de modelos quando o desempenho ou a confiabilidade caem.
Por fim, para permitir a recuperação, os sistemas devem ser construídos com a premissa de que componentes podem ficar parcial ou totalmente inoperantes, seja por interrupções dos provedores, degradação da qualidade dos modelos, limites de taxa de solicitações ou entradas inesperadas de agentes mal-intencionados. O failover automatizado e os mecanismos de autorrecuperação devem estar incorporados à arquitetura, em vez de depender de procedimentos manuais ativados apenas depois que algo dá errado.
Essa é a direção em que trabalhamos na TrueFoundry. Os fornecedores que definirem a prontidão para produção dessa forma, combinando observabilidade, controle centralizado e recuperação automatizada, conquistarão a confiança dos clientes no longo prazo e poderão continuar resolvendo novos problemas à medida que surgirem.
Obrigado pela excelente entrevista. Os leitores que desejam saber mais podem visitar TrueFoundry.


