
Fundamentos de IA
O que é Interpretabilidade Mecanicista? Como os Pesquisadores Analisam Modelos de IA

 Adicione Unite.AI às suas fontes preferidas no Google
A interpretabilidade mecanicista estuda como os componentes aprendidos dentro de uma rede neural produzem comportamento de forma causal. Em vez de apenas correlacionar entradas com saídas, os pesquisadores formulam hipóteses sobre recursos, cabeças de atenção, neurônios e circuitos, e então intervêm para testar essas hipóteses.
O campo tem produzido explicações detalhadas para comportamentos selecionados em modelos pequenos e médios, mas uma descrição completa e fiel de um modelo de ponta ainda está fora de alcance. Explicações automatizadas e visualizações atraentes podem ser pontos de partida úteis, não provas.
Principais pontos
- Recursos são padrões representados; circuitos são componentes interativos propostos para implementar um cálculo.
- Patch de ativação, ablação e rastreamento causal testam se um componente altera um comportamento.
- Superposição significa que um neurônio pode participar de muitos recursos; autoencoders esparsos tentam uma base de recursos diferente.
- Métodos de interpretabilidade precisam de verdade de base, testes falsificáveis, cobertura e avaliação contra explicações alternativas.
Da representação ao mecanismo
A sondagem pergunta se a informação pode ser decodificada a partir de uma ativação. A atribuição estima quais entradas ou componentes são relevantes. O trabalho mecanicista vai além, propondo um cálculo interno e verificando se intervenções alteram o comportamento intermediário e final esperado.
Isso o torna relacionado, mas mais restrito, que IA explicável. Uma explicação pós-hoc para uma decisão não é necessariamente um algoritmo revertido dentro do modelo.
Circuitos e intervenções causais
Os pesquisadores podem identificar uma cabeça de atenção ou recurso associado a uma tarefa, ablá-lo, aplicar patch nas ativações de outra execução ou rastrear como a informação se move entre camadas. Uma boa hipótese prediz o comportamento em novos exemplos e resiste a controles.
Intervenções podem criar estados fora da distribuição, de modo que uma mudança comportamental não revela automaticamente o cálculo natural. Use múltiplos métodos, controles correspondentes e efeitos quantitativos em vez de um único prompt ilustrativo.
Superposição e recursos esparsos
Redes neurais podem representar mais recursos do que dimensões individuais ao superpô-los. Um neurônio pode, portanto, ativar para vários padrões não relacionados, tornando rótulos ao nível do neurônio enganosos.
Autoencoders esparsos aprendem um dicionário maior de recursos a partir das ativações do modelo. Eles podem tornar os padrões mais separáveis, mas a esparsidade escolhida, os dados de treinamento, o erro de reconstrução e os rótulos automatizados afetam o que é recuperado. Os recursos de rede neural ainda requerem validação causal.
Segurança, depuração e limitações
Ferramentas mecanicistas podem ajudar a encontrar fatos memorizados, vieses, estratégias enganosas ou circuitos de falha e podem suportar edição ou monitoramento. As mesmas ferramentas podem perder cálculos distribuídos, raros ou dependentes de contexto.
Trate as descobertas como evidência delimitada: versão do modelo, tarefa, conjunto de dados, camada, intervenção, efeito e incerteza. Conecte a interpretação a avaliações comportamentais, red‑team e à governança de IA responsável em vez de usá‑la como um certificado de segurança genérico.
Representações, circuitos e evidência causal
A interpretabilidade mecanicista estuda como cálculos internos produzem o comportamento do modelo. Os pesquisadores inspecionam ativações, pesos, atenção e recursos intermediários, e então formulam hipóteses sobre representações e circuitos. Uma representação não está necessariamente armazenada em um único neurônio; pode estar distribuída por direções, camadas, tokens e combinações dependentes de contexto.
Autoencoders esparsos tentam decompor ativações densas em um conjunto maior de recursos que ativam seletivamente. Os rótulos dos recursos são interpretações humanas de exemplos observados, não verdade de base. O erro de reconstrução, a esparsidade, a divisão de recursos, a absorção e recursos mortos afetam o que a decomposição revela e o que deixa de fora.
Correlação é insuficiente para uma alegação mecanicista. Patch de ativação, ablação, rastreamento causal, direcionamento e intervenções de peso direcionadas testam se um componente altera o comportamento conforme previsto. Intervenções também podem criar estados fora da distribuição, portanto os resultados precisam de controles, análise de dose‑resposta, explicações alternativas e replicação em diferentes prompts e modelos.
Um fluxo de trabalho rigoroso de interpretabilidade
Comece com um comportamento medido com precisão e um conjunto de dados que separa hipóteses concorrentes. Localize camadas, posições, componentes ou recursos relevantes; inspecione mecanismos candidatos; intervenha; e teste se o circuito proposto prediz novos casos. Mantenha exemplos exploratórios separados da avaliação confirmatória para reduzir viés de seleção.
Ferramentas automatizadas podem classificar neurônios, recursos, cabeças ou caminhos, enquanto modelos de linguagem podem propor descrições. A automação aumenta a cobertura, mas pode fabricar histórias plausíveis. Avalie explicações em exemplos de ativação reservados e previsões causais, registre a incerteza e torne os artefatos reproduzíveis com versão do modelo, tokenizador, prompts e código.
Mecanismos podem ser polissêmicos, redundantes, não lineares e distribuídos. Remover um componente pode ser compensado por outros, enquanto um recurso pode participar de vários comportamentos. Descobertas negativas são informativas: um circuito aparente que falha fora de exemplos curados deve ser restringido ou rejeitado, em vez de ser salvo com uma explicação cada vez mais vaga.
Aplicações, limitações e alegações de segurança
A interpretabilidade pode ajudar a depurar alucinações, vieses, memorização, comportamento de jailbreak ou generalização inesperada; comparar modelos; e gerar hipóteses científicas. Também pode identificar recursos para monitoramento ou intervenção. Esses usos requerem validação específica da tarefa, pois uma visualização de pesquisa útil não é automaticamente um controle de produção confiável.
A ausência de um recurso detectado não prova a ausência de uma capacidade ou intenção, e um recurso legível não prova que o modelo o utiliza em uma determinada resposta. As ferramentas observam uma projeção do cálculo com cobertura limitada. Alegações de segurança devem especificar sensibilidade de detecção, falsos positivos, distribuição, adversário e pontos cegos conhecidos.
Use a interpretabilidade juntamente com avaliações comportamentais, red‑team, governança de dados, controles de acesso, monitoramento e resposta a incidentes. Publique métodos e contra‑exemplos quando possível. O campo está progredindo rapidamente, mas as técnicas atuais não fornecem uma explicação completa e fiel do raciocínio de modelos de ponta nem uma garantia geral de alinhamento.
Exemplo prático: testando um circuito proposto do modelo
Suponha que um modelo pareça usar um conjunto de cabeças de atenção e recursos para resolver um objeto indireto em uma frase. Os pesquisadores definem um conjunto de dados controlado com nomes, posições, distrações e contra‑exemplos variados, e então medem o comportamento. A inspeção de ativações identifica componentes candidatos, mas a hipótese é escrita antes da intervenção: quais informações cada componente transporta, para onde se desloca e como alterá‑lo deve mudar a saída.
Patch de ativação e ablação testam necessidade e suficiência em exemplos reservados. Uma edição direcionada que altera o token previsto na direção esperada apoia o mecanismo; danos amplos ao desempenho não o fazem. Controles aplicam patch em posições e componentes não relacionados, variam a magnitude da intervenção e comparam circuitos alternativos. A equipe publica casos negativos onde a explicação falha e evita atribuir um propósito legível por humanos apenas a partir da correlação.
Para reivindicar uma aplicação de segurança, o método deve detectar o comportamento relevante com sensibilidade conhecida sob prompts realistas e adaptação adversária. Monitores de recursos são avaliados quanto a falsos positivos, evasão, atualizações do modelo e relevância causal. Evidências de interpretabilidade podem orientar depuração e testes adicionais, mas a aplicação permanece em controles externos e monitoramento comportamental. Um diagrama de circuito convincente é uma hipótese científica com evidência — não uma explicação completa de um modelo ou uma garantia sobre comportamentos não observados.
Lista de verificação de implementação prática
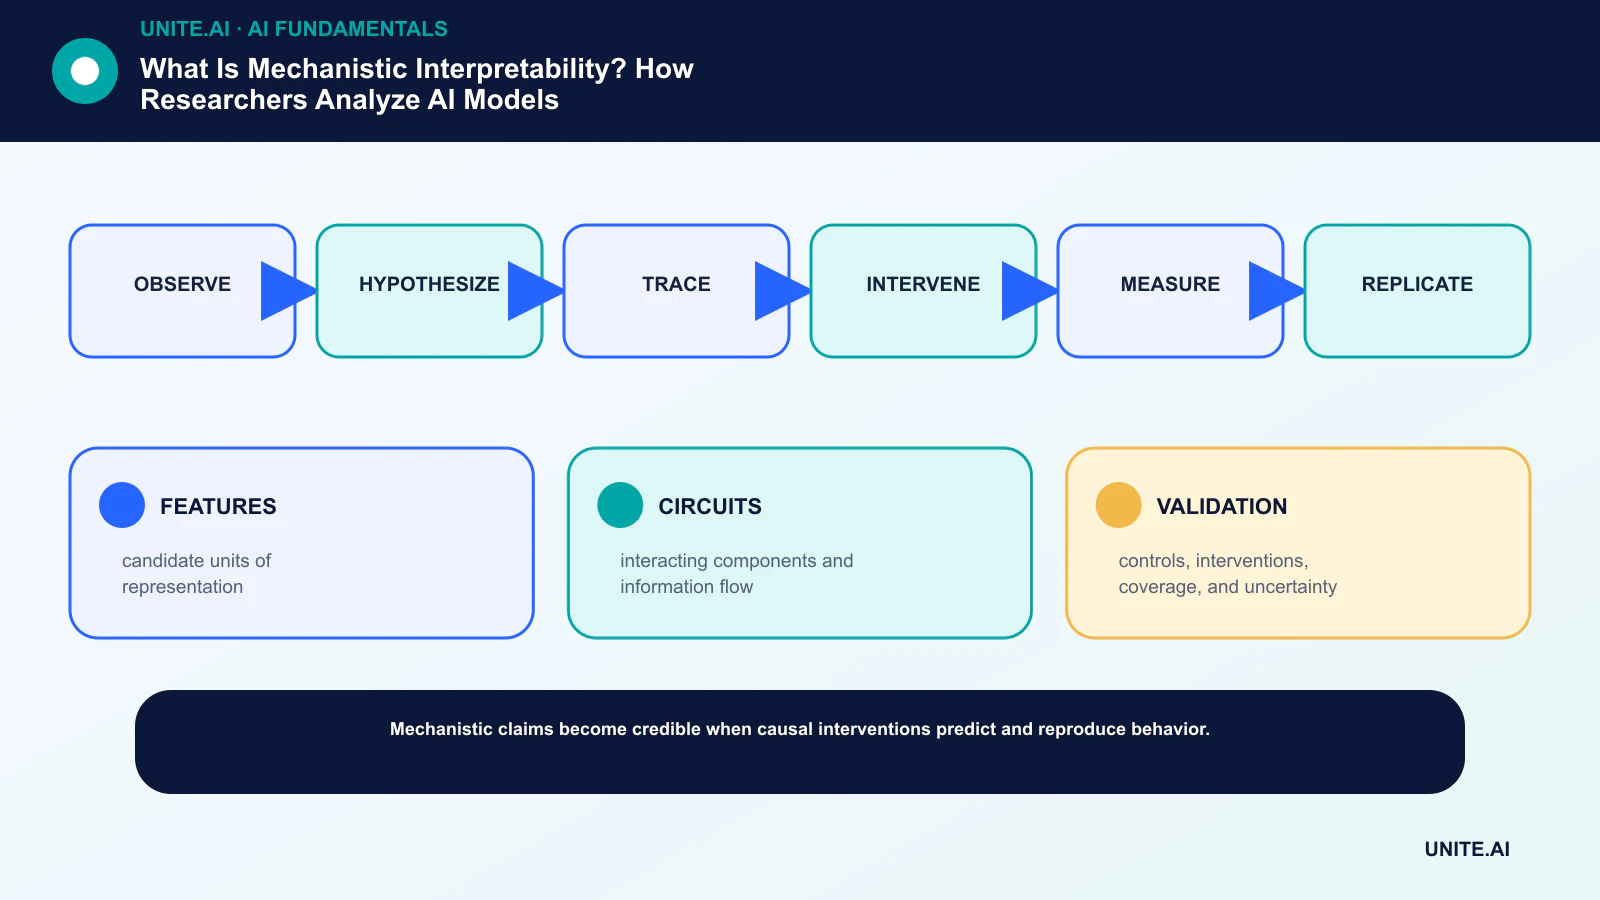
Transforme o conceito em um fluxo de trabalho delimitado e testável: observar → formular hipótese → rastrear → intervir → medir → replicar. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e interrupção, teste falhas representativas e defina monitoramento, reversão e revisão antes de ampliar o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, realize uma revisão de prontidão documentada com as pessoas que constroem, operam, protegem e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever uma saída ou interromper a operação. Revise a decisão após a chegada de dados do mundo real, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- RECURSOS: unidades candidatas de representação.
- CIRCUITOS: componentes interativos e fluxo de informação.
- VALIDAÇÃO: controles, intervenções, cobertura e incerteza.
Perguntas frequentes
A interpretabilidade mecanicista é a mesma que ler os pesos do modelo?
Não. Pesos brutos não são autoexplicativos. Os pesquisadores analisam ativações, recursos, componentes e intervenções para construir e testar hipóteses causais.
Autoencoders esparsos podem explicar totalmente um LLM?
Não. Eles oferecem uma base de recursos candidata e podem apoiar a análise de circuitos, mas cobertura, fidelidade, reconstrução, rotulagem e escalabilidade ainda são problemas em aberto.
Referências principais












