
Ângulo de Anderson
Identificando Deepfakes de Celebridades a Partir de Regiões Faciais Externas

 Adicione Unite.AI às suas fontes preferidas no Google
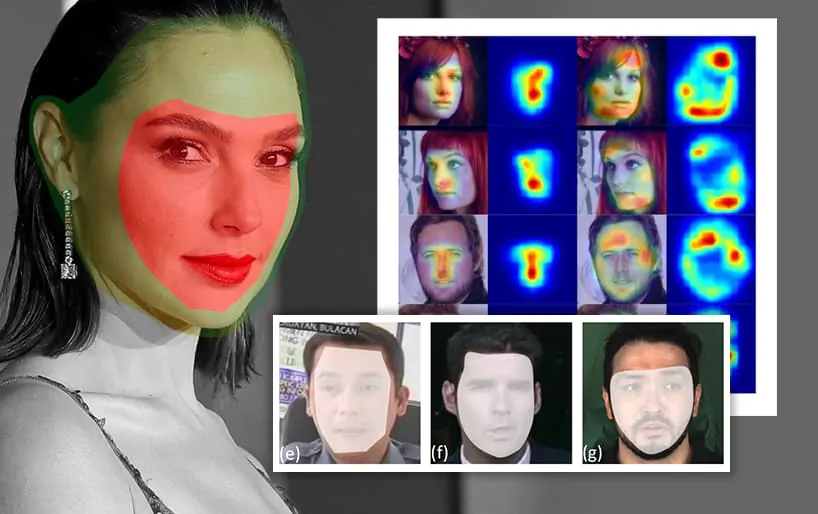
Uma nova colaboração entre a Microsoft (MSFT ) e uma universidade chinesa propôs uma nova maneira de identificar deepfakes de celebridades, aproveitando as limitações das técnicas de deepfake atuais para reconhecer identidades que foram “projetadas” em outras pessoas.
A abordagem é chamada de Identity Consistency Transformer (ICT), e funciona comparando as partes mais externas do rosto (mandíbula, maçãs do rosto, linha do cabelo e outras linhas marginais externas) com o interior do rosto. O sistema explora dados de imagens públicas disponíveis de pessoas famosas, o que limita sua eficácia a celebridades populares, cujas imagens estão disponíveis em grandes números em conjuntos de dados de visão computacional amplamente disponíveis e na internet.

A cobertura de falsificação de faces em sete técnicas: DeepFake em FF+; DeepFake no Google DeepFake Detection; DeepFaceLab; Face2Face; FSGAN; e DF-VAE. Pacotes populares como DeepFaceLab e FaceSwap fornecem cobertura semelhantemente limitada. Fonte: https://arxiv.org/pdf/2203.01318.pdf
Como a imagem acima ilustra, os métodos atuais de deepfaking são bastante limitados em termos de recursos e dependem de “rostos hospedeiros” (a imagem ou vídeo de uma pessoa que terá sua identidade substituída pelo deepfake) para minimizar evidências de substituição facial.
Embora métodos variados possam abranger a testa completa e uma grande parte das áreas da mandíbula e da maçã do rosto, todos são mais ou menos limitados dentro do quadro do rosto hospedeiro.

Um mapa de saliência que enfatiza as ‘identidades internas’ e ‘externas’ calculadas pelo ICT. Onde uma correspondência facial interna é estabelecida, mas a identidade externa não corresponde, o ICT avalia a imagem como falsa.
Nos testes, o ICT provou ser capaz de detectar conteúdo de deepfake em ambientes favoráveis ao deepfake, como vídeos de baixa resolução, onde o conteúdo do vídeo inteiro é degradado por artefatos de compressão, ajudando a esconder evidências residuais do processo de deepfake – uma circunstância que confunde muitos métodos de detecção de deepfake concorrentes.

O ICT supera os concorrentes no reconhecimento de conteúdo de deepfake. Veja o vídeo incorporado no final do artigo para mais exemplos e melhor resolução. Veja o vídeo de fonte incorporado no final do artigo para mais exemplos. Fonte: https://www.youtube.com/watch?v=zgF50dcymj8
O artigo é intitulado Proteger Celebridades com Identity Consistency Transformer, e vem de nove pesquisadores afiliados à Universidade de Ciência e Tecnologia da China, Microsoft Research Asia e Microsoft Cloud + AI.
A Lacuna de Credibilidade
Existem pelo menos um par de razões pelas quais algoritmos de troca de faces populares, como DeepFaceLab e FaceSwap, negligenciam a área mais externa das identidades faciais trocadas.
Em primeiro lugar, o treinamento de modelos de deepfake é demorado e crítico em termos de recursos, e a adoção de “rostos hospedeiros” compatíveis libera ciclos de GPU e épocas para se concentrar nas áreas internas relativamente imutáveis do rosto, que usamos para distinguir a identidade (já que variáveis como flutuação de peso e envelhecimento são menos prováveis de alterar esses traços faciais centrais no curto prazo).
Em segundo lugar, a maioria das abordagens de deepfake (e isso certamente é o caso com o DeepFaceLab, o software usado pelos praticantes mais populares ou notórios) tem uma capacidade limitada de replicar “margens de face” como áreas da bochecha e da mandíbula, e é limitada pelo fato de que seu código upstream (2017) não abordou extensivamente essa questão.
Nos casos em que as identidades não correspondem bem, o algoritmo de deepfake deve “pintar” áreas de fundo ao redor do rosto, o que ele faz de forma desajeitada, mesmo nas mãos dos melhores deepfakers, como Ctrl Shift Face, cuja saída foi usada nos estudos do artigo.

O melhor dos melhores: stills de um vídeo de deepfake do renomado deepfaker Ctrl-Shift-Face, trocando Jim Carrey por Gary Oldman. Esse trabalho representa provavelmente o melhor resultado atualmente disponível via DeepFaceLab e técnicas de pós-processamento. No entanto, as trocas permanecem limitadas à atenção relativamente escassa que o DFL dá à face externa, exigindo um esforço hercúleo de curação de dados e treinamento para abordar as linhas mais externas. Fonte: https://www.youtube.com/watch?v=x8igrh1eyLk
Essa “arte de distração”, ou desvio de atenção, em grande parte escapa à atenção pública na preocupação atual com o realismo crescente dos deepfakes, porque nossas faculdades críticas em torno dos deepfakes ainda estão se desenvolvendo além da fase de “choque e admiração”.
Identidades Divididas
O novo artigo observa que a maioria dos métodos anteriores de detecção de deepfake confia em artefatos que traem o processo de troca, como poses de cabeça inconsistentes e piscar, entre numerous outras técnicas. Apenas esta semana, um novo artigo de detecção de deepfake propôs usar a “assinatura” dos diferentes tipos de modelos no framework FaceSwap para ajudar a identificar vídeo forjado criado com ele (veja imagem abaixo).

Identificando deepfakes caracterizando as assinaturas de diferentes tipos de modelos no framework FaceSwap. Fonte: https://arxiv.org/pdf/2202.12951.pdf
Ao contrário, a arquitetura do ICT cria duas identidades aninhadas separadas para uma pessoa, cada uma das quais deve ser verificada antes que a identidade inteira seja concluída como “verdadeira” ou “falsa”.

Arquitetura para as fases de treinamento e teste do ICT.
A divisão de identidades é facilitada por um Transformador de visão, que realiza identificação facial antes de dividir as regiões pesquisadas em tokens pertencentes às identidades internas ou externas.

Distribuindo patches entre os dois signos de identidade paralelos.
O artigo afirma:
‘Infelizmente, os métodos existentes de verificação facial tendem a caracterizar a região mais discriminativa, ou seja, a face interna para verificação e falham em capturar as informações de identidade na face externa. Com o Identity Consistency Transformer, treinamos um modelo para aprender um par de vetores de identidade, um para a face interna e o outro para a face externa, projetando um Transformador tal que as identidades internas e externas possam ser aprendidas simultaneamente em um modelo unificado.’
Como não há um modelo existente para esse protocolo de identificação, os autores criaram uma nova forma de perda de consistência que pode atuar como uma métrica de autenticidade. O “token interno” e o “token externo” que resultam do modelo de extração de identidade são adicionados aos patches de incorporação produzidos por frameworks de identificação facial.
Dados e Treinamento
A rede ICT foi treinada no conjunto de dados MS-Celeb-1M da Microsoft Research, que contém 10 milhões de imagens de faces de celebridades que cobrem um milhão de identidades, incluindo atores, políticos e muitos outros tipos de figuras proeminentes. De acordo com o procedimento do método anterior Face X-ray (outra iniciativa da Microsoft Research), a rotina de geração de deepfakes do ICT troca regiões internas e externas de faces tiradas desse conjunto de dados para criar material para testar o algoritmo.
Para realizar essas trocas internas, o ICT identifica duas imagens no conjunto de dados que exibem poses de cabeça e marcos faciais semelhantes, gera uma região de máscara das características centrais (na qual uma troca pode ser realizada) e realiza uma troca de deepfake com correção de cor RGB.
A razão pela qual o ICT é limitado à identificação de celebridades é que ele depende (em sua variação mais eficaz) de um conjunto de referência novo que incorpora vetores faciais derivados de um corpus central (neste caso, MS-Celeb-1M, embora a referência possa ser estendida a imagens disponíveis na rede, o que provavelmente existiria apenas em qualidade e quantidade suficientes para figuras públicas bem conhecidas).
Esses pares de vetores derivados atuam como tokens de autenticidade para verificar as regiões da face interna e externa em conjunto.
Os autores observam que os tokens obtidos desses métodos representam “recursos de alto nível”, resultando em um processo de detecção de deepfake que é mais provável de sobreviver em ambientes desafiadores, como vídeo de baixa resolução ou degradado.
Crucialmente, o ICT não procura evidências baseadas em artefatos, mas sim se concentra em métodos de verificação de identidade mais de acordo com técnicas de reconhecimento facial – uma abordagem que é difícil com dados de baixo volume, como é o caso da investigação de incidentes de deepfake revenge porn contra alvos não famosos.
Testes
Treinado no MS-Celeb-1M, o ICT foi então dividido em versões auxiliadas por referência e “cegas” do algoritmo e testado contra uma variedade de conjuntos de dados e métodos concorrentes. Esses incluíam FaceForensics++ (FF++), um conjunto de dados de 1000 vídeos autênticos e de deepfake criados em quatro métodos, incluindo Face2Face e FaceSwap; o Deepfake Detection (DFD) do Google, que também é composto por milhares de vídeos de deepfake gerados pelo Google; Celeb-DeepFake v1 (CD1), que apresenta 408 vídeos reais e 795 sintetizados de baixo artefato; Celeb-DeepFake v2, uma extensão do V1 que contém 590 vídeos reais e 5.639 falsos; e o Deeper-Forensics (Deeper) da China em 2020.
Esses são os conjuntos de dados; os métodos de detecção nos desafios de teste foram Multi-task, MesoInc4, Capsule, Xception-c0, c2 (um método empregado no FF++), FWA/DSP-FW da Universidade de Albany, Two-Branch, PCL+I2G e o método de discrepância de contexto de Yuval Nirkin.
Os métodos de detecção mencionados visam detectar tipos específicos de manipulação facial. Além disso, os autores do novo artigo testaram ofertas mais gerais de detecção de deepfake Face X-ray, FFD da Universidade Estadual de Michigan, CNNDetection e Patch-Forensics do MIT CSAIL.
O resultado mais evidente dos testes é que os métodos concorrentes caem drasticamente em eficácia à medida que a resolução e a qualidade do vídeo diminuem. Como parte do potencial mais grave para a penetração de deepfakes em nossos poderes discriminativos reside (não menos no momento atual) em vídeos não HD ou degradados, isso parece ser um resultado significativo.

Na figura acima, as linhas azul e vermelha indicam a resiliência dos métodos ICT à degradação de imagem em todas as áreas, exceto o obstáculo do ruído gaussiano (não uma probabilidade em footagens do tipo Zoom e webcam), enquanto a confiabilidade dos métodos concorrentes despencam.
Na tabela de resultados abaixo, vemos a eficácia dos vários métodos de detecção de deepfake nos conjuntos de dados não vistos. Resultados cinza e asteriscados indicam comparação a partir de resultados publicados originalmente em projetos de código fechado, que não podem ser verificados externamente. Em quase todos os quadros comparáveis, o ICT supera as abordagens de detecção de deepfake concorrentes (mostradas em negrito) nos conjuntos de dados testados.

Como um teste adicional, os autores executaram o conteúdo do canal do YouTube do aclamado deepfaker Ctrl Shift Face e encontraram que os métodos concorrentes alcançaram pontuações de identificação notavelmente inferiores:

Notável aqui é que os métodos FF++ (Xception-c23) e FFD, que alcançam algumas das pontuações mais altas em alguns dos testes gerais do novo artigo, aqui alcançam uma pontuação muito mais baixa do que o ICT em um contexto “real” de conteúdo de deepfake de alto esforço.
Os autores concluem o artigo com a esperança de que seus resultados direcionem a comunidade de detecção de deepfake para iniciativas semelhantes que se concentrem em recursos de alto nível mais facilmente generalizáveis e se afastem da “guerra fria” da detecção de artefatos, na qual os métodos mais recentes são rotineiramente obviados por
Check out the accompanying supplementary video below for more examples of ICT identifying deepfake content that often outfoxes alternative methods.
Publicado pela primeira vez em 4 de março de 2022.


