
Ângulo de Anderson
GAN como Renderizador de Rostos para CGI “Tradicional”

 Adicione Unite.AI às suas fontes preferidas no Google

Pontos-chaveDesvincular a identidade da expressão no espaço latente das GANs continua sendo o…
Ver mais
- Desvincular a identidade da expressão no espaço latente das GANs continua sendo o principal desafio não resolvido para a síntese de vídeos faciais.
- Modelos CGI paramétricos como SMPL e 3DMMs são cada vez mais utilizados para impor ordem aos códigos latentes indisciplinados das GANs.
- A abordagem híbrida de Renderização com Estilo da Disney produziu resultados estranhos ao mesclar mapas de textura tradicionais com imagens geradas por GANs.
Opinião Quando as Redes Adversárias Generativas (GANs) demonstraram pela primeira vez sua capacidade de reproduzir rostos 3D impressionantemente realistas, o advento desencadeou uma corrida ao ouro para o potencial inexplorado das GANs para criar vídeos temporalmente consistentes com rostos humanos.
Em algum lugar no espaço latente da GAN, parecia que devia haver uma ordem e racionalidade ocultas – um esquema de lógica semântica nascente, enterrado nos códigos latentes, que permitiria que uma GAN gerasse vistas e interpretações consistentes (como mudanças de expressão) do mesmo rosto – e, subsequentemente, oferecesse um método de vídeo deepfake temporalmente convincente que superaria os autoencoders.
A saída de alta resolução seria trivial, em comparação com os ambientes de baixa resolução nos quais as restrições de GPU forçam o DeepFaceLab e o FaceSwap a operar, enquanto a “zona de troca” de um rosto (nos fluxos de trabalho de autoencoders) se tornaria a “zona de criação” de uma GAN, informada por um pequeno conjunto de imagens de entrada, ou mesmo apenas uma imagem.
Não haveria mais disparidade entre os rostos “troca” e “hospedeiro”, porque a totalidade da imagem seria gerada do zero, incluindo cabelo, linhas da mandíbula e as extremidades mais externas das linhas faciais, que frequentemente provam ser um desafio para os deepfakes “tradicionais” de autoencoders.
O Inverno de Vídeo Facial GAN
Como se revelou, não seria tão fácil. Em última análise, o desacoplamento dos fatores provou ser a questão central e continua sendo o principal desafio. Como manter uma identidade facial distinta e mudar sua pose ou expressão sem reunir um corpus de milhares de imagens de referência que ensinem uma rede neural o que acontece quando essas mudanças são realizadas, da mesma forma que os sistemas de autoencoders fazem laboriosamente?
Em vez disso, o pensamento subsequente na pesquisa de síntese e atuação facial GAN foi que uma identidade de entrada poderia talvez ser submetida a transformações orientadas a um objetivo, genéricas, baseadas em modelos e não específicas de identidade. Um exemplo disso seria aplicar uma expressão a um rosto GAN que não estava presente em nenhuma das imagens daquela pessoa que a GAN conhece.

A partir do artigo de 2022 Tensor-based Emotion Editing in the StyleGAN Latent Space, expressões baseadas em modelos são aplicadas a um rosto de entrada do conjunto de dados FFHQ. Fonte: https://arxiv.org/pdf/2205.06102.pdf
É óbvio que uma abordagem “tamanho único” não pode cobrir a diversidade de expressões faciais únicas de um indivíduo. Devemos nos perguntar se um sorriso tão único quanto o de Jack Nicholson ou Willem Dafoe poderia receber uma interpretação fiel sob a influência de tais códigos latentes de “média expressão”.

Quem é este charmoso estranho latino? Embora o método GAN produza um rosto mais realista e de alta resolução, a transformação não é informada por múltiplas imagens do mundo real do ator, como é o caso do DeepFaceLab, que treina extensivamente em um banco de dados de milhares de tais imagens, e consequentemente a semelhança é comprometida. Aqui (fundo) um modelo DeepFaceLab é importado para o DeepFaceLive, uma implementação de streaming do software popular e controverso. Exemplos são de https://www.youtube.com/watch?v=9tr35y-yQRY (2022) e https://arxiv.org/pdf/2205.06102.pdf.
Um número de editores de expressão facial GAN foram propostos nos últimos anos, a maioria deles lidando com identidades desconhecidas, onde a fidelidade das transformações é impossível para o leitor casual saber, pois esses não são rostos familiares.

Identidades obscuras transformadas na oferta de 2020 Cascade-EF-GAN. Fonte: https://arxiv.org/pdf/2003.05905.pdf
Talvez o editor de rosto GAN que tenha recebido o maior interesse (e citações) nos últimos três anos seja InterFaceGAN, que pode realizar travessias no espaço latente em códigos latentes relacionados à pose (ângulo da câmera/rosto), expressão, idade, raça, gênero e outras qualidades essenciais.
As capacidades de “morphing” do estilo dos anos 80 do InterFaceGAN e frameworks semelhantes são principalmente uma forma de ilustrar o caminho em direção à transformação enquanto uma imagem é reprojeta de volta por meio de um código latente apropriado (como “idade”). Em termos de produzir filmagens de vídeo com continuidade temporal, esses esquemas até o momento se qualificam como “desastres impressionantes”.
Se você acrescentar a isso a dificuldade de criar cabelo temporalmente consistente, e o fato de que a técnica de exploração/manipulação de códigos latentes não tem diretrizes temporais inatas para trabalhar (e é difícil saber como injetar essas diretrizes em um framework projetado para acomodar e gerar imagens estáticas, e que não tem provisão nativa para saída de vídeo), pode ser lógico concluir que GAN não é Tudo o que Você Precisa ™ para síntese de vídeo facial.
Portanto, esforços subsequentes renderam melhorias incrementais no desacoplamento dos fatores, enquanto outros acoplaram outras convenções em visão computacional como uma “camada de orientação”, como o uso de segmentação semântica como um mecanismo de controle no artigo de 2021 estudo SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
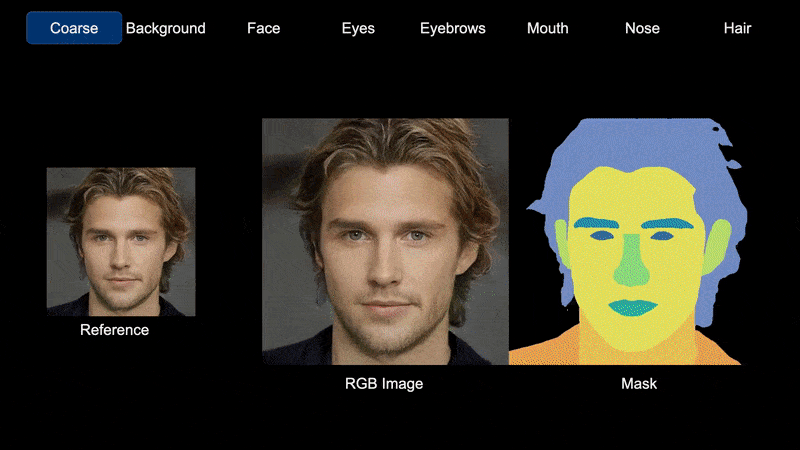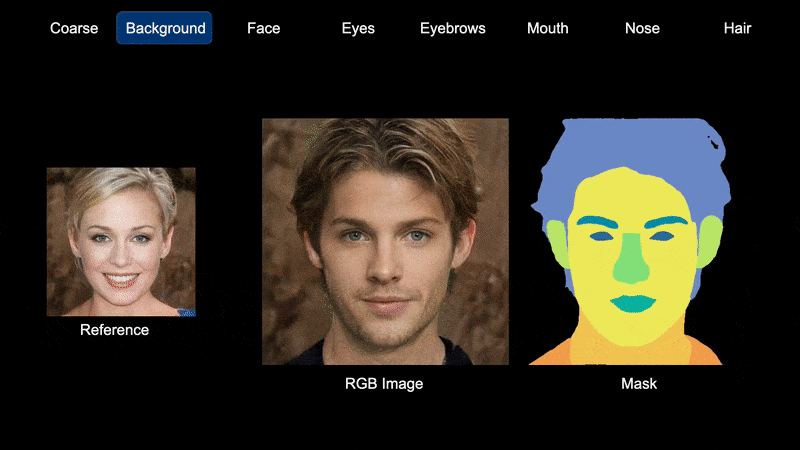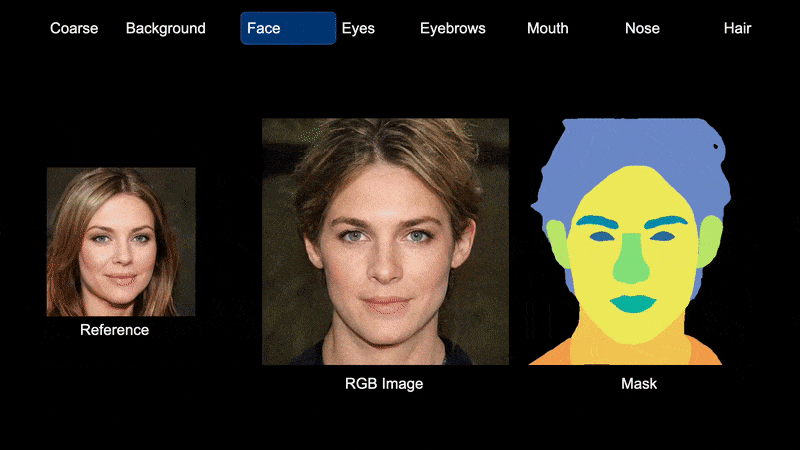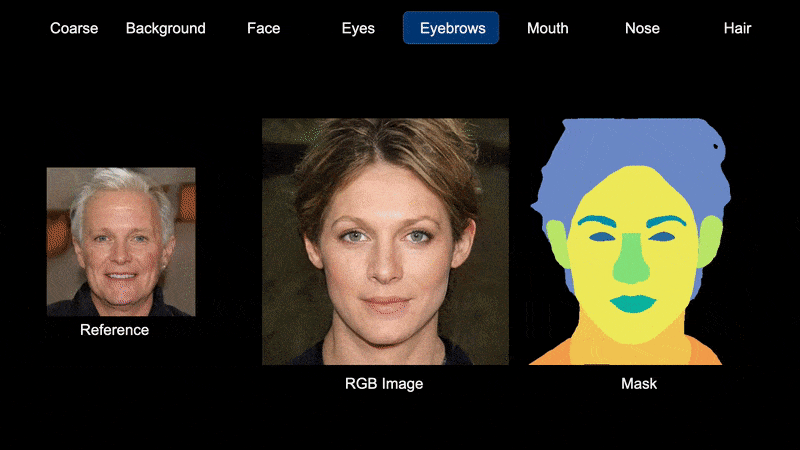
Segmentação semântica como um método de controle do espaço latente em SemanticStyleGAN. Fonte: https://semanticstylegan.github.io/
Orientação Paramétrica
A comunidade de pesquisa de síntese facial GAN está se dirigindo cada vez mais para o uso de “CGI tradicional” paramétrico como um método para guiar e trazer ordem para os códigos latentes impressionantes, mas indisciplinados, no espaço latente de uma GAN.
Embora os primitivos faciais paramétricos tenham sido uma característica da pesquisa de visão computacional por mais de vinte anos, o interesse nessa abordagem cresceu recentemente, com o uso crescente do Skinned Multi-Person Linear Model (SMPL) primitivos CGI, uma abordagem pioneira pelo Instituto Max Planck e ILM, e desde então aprimorada com o Sparse Trained Articulated Human Body Regressor (STAR) framework.

SMPL (neste caso, uma variante chamada SMPL-X) pode impor uma malha paramétrica CGI que concorda com a pose estimada (incluindo expressões, se necessário) de todo o corpo humano apresentado em uma imagem, permitindo que novas operações sejam realizadas na imagem usando a malha paramétrica como uma diretriz volumétrica ou perceptual. Fonte: https://arxiv.org/pdf/1904.05866.pdf
O desenvolvimento mais aclamado nessa linha foi a iniciativa Rendering with Style da Disney em 2019, que fundiu o uso de mapas de textura tradicionais com imagens geradas por GAN, em uma tentativa de criar saídas animadas aprimoradas e “estilo deepfake”:

Velho encontra novo, na abordagem híbrida da Disney para deepfakes gerados por GAN. Fonte: https://www.youtube.com/watch?v=TwpLqTmvqVk
A abordagem da Disney impõe facetas CGI tradicionalmente renderizadas em uma rede StyleGAN2 para preencher regiões de rostos humanos em “áreas problemáticas”, onde a consistência temporal é uma questão para a geração de vídeo – áreas como textura de pele.

O fluxo de trabalho de Rendering with Style.
Como a cabeça CGI paramétrica que guia esse processo possa ser ajustada e alterada para atender ao usuário, o rosto gerado por GAN pode refletir essas alterações, incluindo mudanças de pose e expressão da cabeça.
Embora projetado para casar o controle oferecido pela CGI com o realismo natural dos rostos GAN, no final, os resultados demonstram o pior de ambos os mundos e ainda falham em manter a textura do cabelo e até mesmo a posição básica das características consistentes:
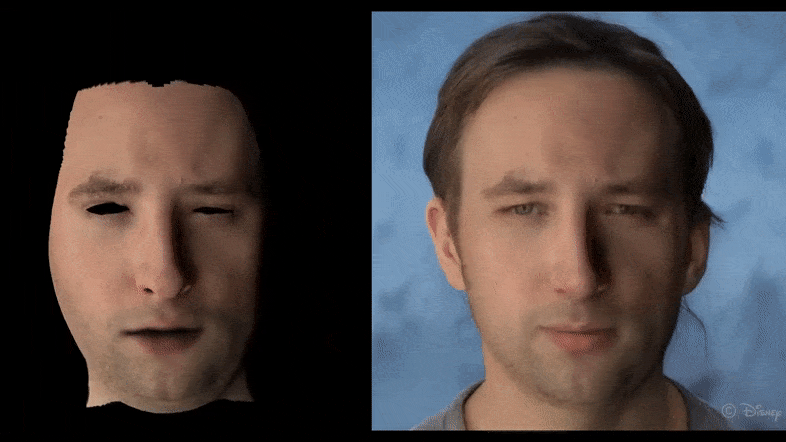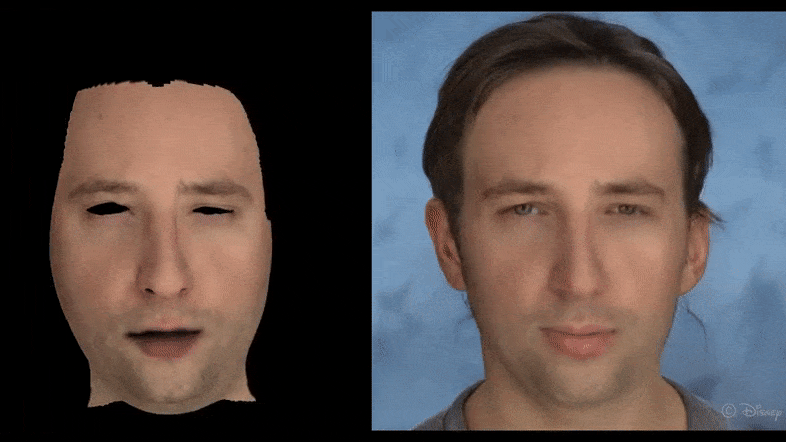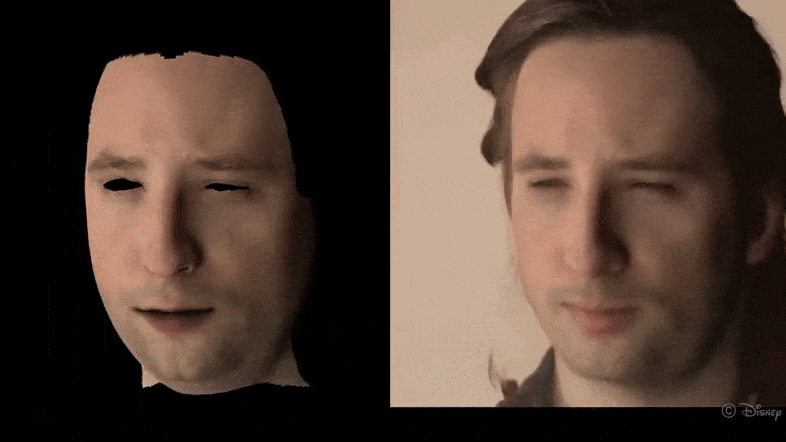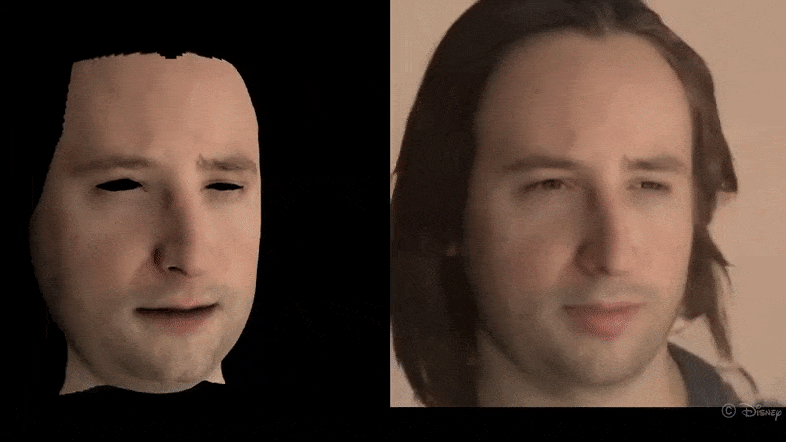
Um novo tipo de vale da estranheza emerge do Rendering with Style, embora o princípio ainda mantenha algum potencial.
O artigo de 2020 estudo StyleRig: Rigging StyleGAN for 3D Control over Portrait Images segue uma abordagem cada vez mais popular, com o uso de modelos de rosto 3D moldáveis (3DMMs) como intermediários para alterar características em um ambiente StyleGAN, neste caso por meio de uma rede de rigging chamada RigNet:

3DMMs atuam como intermediários para interpretações do espaço latente em StyleRig. Fonte: https://arxiv.org/pdf/2004.00121.pdf
No entanto, como de costume com essas iniciativas, os resultados até o momento parecem limitados a manipulações mínimas de pose e mudanças de expressão ou estado afetivo sem orientação específica.

StyleRig melhora o nível de controle, embora o cabelo temporalmente consistente permaneça um desafio não resolvido. Fonte: https://www.youtube.com/watch?v=eaW_P85wQ9k
Trabalho semelhante pode ser encontrado no MOST-GAN da Mitsubishi Research, um artigo de 2021 que usa 3DMMs não lineares como uma arquitetura de desacoplamento dos fatores, mas que também luta para alcançar movimento dinâmico e consistente.
A última pesquisa que busca controle e desacoplamento dos fatores é One-Shot Face Reenactment on Megapixels, que novamente usa cabeças paramétricas 3DMM como uma interface amigável para o StyleGAN.

No fluxo de trabalho MegaFR do One-Shot Face Reenactment, a rede realiza síntese facial combinando uma imagem real invertida para sua representação latente com parâmetros tirados de um modelo 3DMM renderizado. Fonte: https://arxiv.org/pdf/2205.13368.pdf
OSFR pertence a uma classe crescente de editores de rosto GAN que buscam desenvolver fluxos de trabalho de edição linear do estilo Photoshop/After Effects, onde o usuário pode inserir uma imagem desejada na qual transformações podem ser aplicadas, em vez de procurar pelo espaço latente por códigos latentes relacionados a uma identidade.
Novamente, expressões paramétricas representam um método abrangente e não personalizado de injeção de expressão, levando a manipulações que parecem estranhamente inquietantes de sua própria maneira, nem sempre positiva.

Expressões injetadas no OSFR.
Como trabalhos anteriores, o OSFR pode inferir poses próximas das originais de uma única imagem e também realizar “frontalização”, onde uma imagem com pose descentrada é traduzida em um retrato frontal:

Imagem original (acima) e imagem frontal inferida de uma das implementações do OSFR detalhadas no novo artigo.
Na prática, esse tipo de inferência é semelhante a alguns dos princípios de fotogrametria que fundamentam Campos de Radiância Neural (NeRF), exceto que a geometria aqui deve ser definida por uma única foto, em vez das 3-4 vistas que permitem que o NeRF interprete as poses intersticiais ausentes e crie cenas neurais 3D exploráveis com humanos.
(No entanto, o NeRF não é Tudo o que Você Precisa ™, pois apresenta um conjunto quase inteiramente diferente de obstáculos para GANs em termos de produzir síntese de vídeo facial)
O GAN Tem um Lugar na Síntese de Vídeo Facial?
Alcançar expressões dinâmicas e poses fora da distribuição de treinamento a partir de uma única imagem de origem parece ser uma obsessão alquímica na pesquisa de síntese facial GAN no momento, principalmente porque as GANs são o único método atualmente capaz de produzir rostos neurais de alta resolução e fidelidade relativamente alta: embora os frameworks de deepfake de autoencoder possam treinar em uma multidão de poses e expressões do mundo real, eles devem operar em resoluções de entrada/saída restritas por VRAM e exigem um “hospedeiro”; enquanto o NeRF é igualmente restrito e – ao contrário das outras duas abordagens – atualmente não tem metodologias estabelecidas para alterar expressões faciais e sofre de edição limitada em geral.
Parece que a única maneira de avançar para um sistema de síntese de rosto CGI/GAN preciso é que uma nova iniciativa encontre alguma maneira de montar uma entidade de identidade multi-foto dentro do espaço latente, onde um código latente para a identidade de uma pessoa não precise viajar por todo o espaço latente para explorar parâmetros de pose não relacionados, mas possa se referir às suas próprias imagens do mundo real como referências para transformações.
Mesmo nesse caso, ou mesmo se uma rede StyleGAN inteira fosse treinada em um conjunto de faces de identidade única (semelhante aos conjuntos de treinamento que os autoencoders usam), a lógica semântica ausente ainda provavelmente precisaria ser fornecida por tecnologias auxiliares, como segmentação semântica ou faces 3DMM paramétricas, que, nesse cenário, pelo menos teriam mais material para trabalhar.


