Ângulo de Anderson
Recorte de imagens por IA com compreensão das cenas

 Adicione Unite.AI às suas fontes preferidas no Google
Pontos-chaveO recorte com IA agora usa compreensão de cena para substituir os chroma keys.
Ver mais
- O recorte com IA agora usa compreensão de cena para substituir os chroma keys.
- O novo pipeline SPG-IM supera os métodos sem trimap por uma grande margem.
- Rótulos textuais oferecem uma alternativa de baixo custo à anotação de pixels dispendiosa.
No documentário de extras que acompanha o lançamento em DVD de 2003 de Alien3 (1992), o lendário especialista em efeitos visuais Richard Edlund recordou, horrorizado, a «luta de sumô» da extração fotoquímica de máscaras, que dominou o trabalho com efeitos visuais entre o final da década de 1930 e o fim da década de 1980. Edlund descreveu como «luta de sumô» a natureza imprevisível do processo, em comparação com as técnicas digitais de tela azul e verde que se impuseram no início da década de 1990 (e, desde então, ele voltou a recorrer à metáfora).
A extração de um elemento em primeiro plano (como uma pessoa ou uma maquete de nave espacial) do fundo, para que a imagem recortada possa ser composta sobre uma imagem de fundo, era originalmente feita filmando-se o objeto em primeiro plano diante de um fundo azul ou verde uniforme.
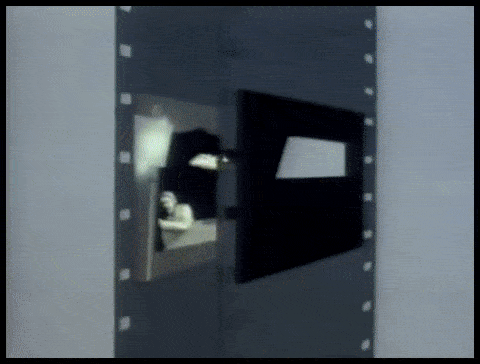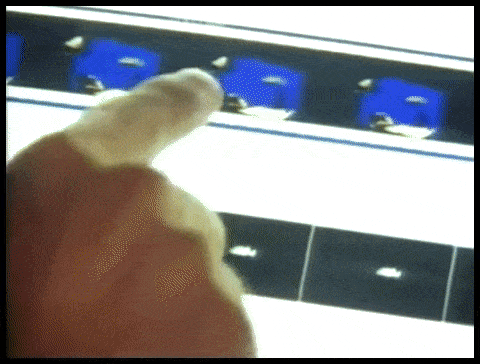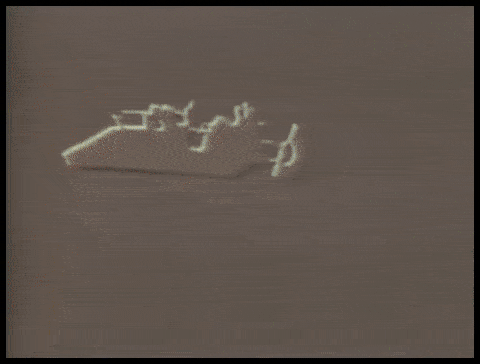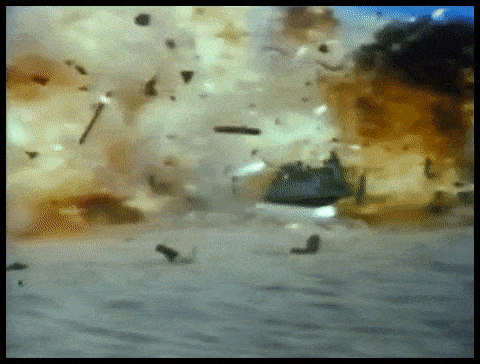
Processos trabalhosos de extração fotoquímica para uma tomada com efeitos visuais da ILM em «Return of the Jedi» (1983).
Nas imagens resultantes, a cor do fundo era posteriormente isolada por meios químicos e usada como modelo para reimprimir o objeto em primeiro plano (ou a pessoa) em uma impressora óptica, como um objeto «flutuante» em um fotograma de filme transparente.
O processo era conhecido como sobreposição por separação de cores (CSO) — embora, com o tempo, o termo tenha passado a ser mais associado aos efeitos de vídeo rudimentares de «Chromakey», usados em produções televisivas de baixo orçamento nas décadas de 1970 e 1980, que recorriam a meios analógicos, e não químicos ou digitais.

Demonstração da sobreposição por separação de cores em 1970 no programa infantil britânico «Blue Peter». Fonte: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
De todo modo, tanto no caso de elementos cinematográficos quanto de vídeo, as imagens extraídas podiam então ser inseridas em quaisquer outras imagens.
Embora o processo de vapor de sódio da Disney — notavelmente mais caro e proprietário, que usava especificamente o amarelo como cor-chave e também foi usado no filme de terror de Alfred Hitchcock de 1963, The Birds — proporcionasse maior definição e máscaras mais nítidas, a extração fotoquímica continuava sendo um processo meticuloso e pouco confiável.

O processo proprietário de extração por vapor de sódio da Disney exigia fundos em tons próximos ao amarelo no espectro. Aqui, Angela Lansbury está suspensa por fios durante a produção de uma sequência repleta de efeitos visuais para «Bedknobs and Broomsticks» (1971). Fonte
Além do recorte digital
Na década de 1990, a revolução digital eliminou os produtos químicos, mas não a necessidade de telas verdes. Passou a ser possível remover o fundo verde (ou de qualquer outra cor) simplesmente procurando pixels dentro de uma faixa de tolerância dessa cor, em programas de edição de pixels como o Photoshop e em uma nova geração de suítes de composição de vídeo capazes de remover automaticamente fundos coloridos. Quase da noite para o dia, sessenta anos da indústria de impressão óptica foram relegados à história.
As pesquisas em visão computacional acelerada por GPU realizadas nos últimos dez anos estão conduzindo a extração de máscaras a uma terceira era, e os pesquisadores têm a tarefa de desenvolver sistemas capazes de gerar máscaras de alta qualidade sem a necessidade de telas verdes. Só no Arxiv, são publicados semanalmente artigos sobre inovações na extração de elementos em primeiro plano baseada em aprendizado de máquina.
Nós também entramos em cena
Esse interesse acadêmico e industrial pela extração com IA já chegou ao mercado de consumo: todos conhecemos implementações rudimentares, mas funcionais, na forma de filtros do Zoom e do Skype, que substituem o fundo da sala de estar por ilhas tropicais e cenários semelhantes durante chamadas de videoconferência.
No entanto, as melhores máscaras ainda exigem uma tela verde, como observou o Zoom na quarta-feira passada.

À esquerda, um homem diante de uma tela verde, com os cabelos bem recortados pelo recurso Virtual Background do Zoom. À direita, uma mulher diante de uma cena doméstica comum, com os cabelos extraídos por algoritmo, com menor precisão e maior exigência computacional. Fonte: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Outra publicação da plataforma de suporte do Zoom alerta que a extração sem tela verde também exige maior poder computacional do dispositivo de captura.
A necessidade de recortar a imagem
Melhorias na qualidade, na portabilidade e na economia de recursos dos sistemas de extração de máscaras «em condições reais» (isto é, que isolam pessoas sem a necessidade de telas verdes) são relevantes para muitos outros setores e atividades, e não apenas para filtros de videoconferência.
Para o desenvolvimento de conjuntos de dados, o reconhecimento facial, de cabeça completa e de corpo completo aprimorado oferece a possibilidade de garantir que elementos de fundo estranhos não sejam treinados em modelos de visão computacional de sujeitos humanos; um isolamento mais preciso melhoraria muito as técnicas de segmentação semântica projetadas para distinguir e assimilar domínios (ou seja, ‘gato’, ‘pessoa’, ‘barco’), e melhoraria os sistemas de síntese de imagem baseados em VAE e transformador, como o novo DALL-E 2 da OpenAI; e algoritmos de extração melhores reduziriam a necessidade de rotoscopia manual cara em pipelines de VFX custosos.
Na verdade, a ascensão de metodologias multimodais (geralmente de texto e imagem), nas quais um domínio como «gato» é codificado tanto como imagem quanto por meio de referências textuais associadas, já está avançando no processamento de imagens. Um exemplo recente é a arquitetura Text2Live, que usa treinamento multimodal (texto e imagem) para criar vídeos de, entre inúmeras outras possibilidades, cisnes de cristal e girafas de vidro.
Recorte de imagens por IA com percepção de cena
Uma parcela considerável das pesquisas sobre recorte automático baseado em IA se concentrou no reconhecimento de contornos e na avaliação de agrupamentos de pixels dentro de uma imagem ou de um quadro de vídeo. No entanto, uma nova pesquisa da China apresenta um fluxo de extração que aprimora a delimitação e a qualidade da máscara ao recorrer a descrições textuais da cena (uma abordagem multimodal que ganhou espaço no setor de pesquisa em visão computacional nos últimos 3 a 4 anos), e afirma ter superado os métodos anteriores de diversas maneiras.

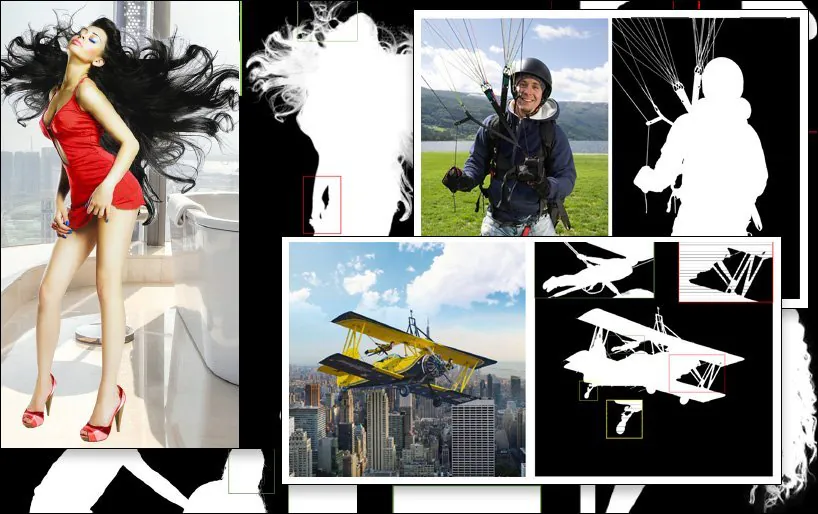
Exemplo de extração com SPG-IM (última imagem, no canto inferior direito), em comparação com métodos anteriores concorrentes. Fonte: https://arxiv.org/pdf/2204.09276.pdf
O desafio para o sub setor de pesquisa em extração é desenvolver fluxos de trabalho que exijam o mínimo possível de anotação manual e intervenção humana — idealmente, nenhuma. Além das implicações em termos de custo, os pesquisadores do novo artigo observam que as anotações e segmentações manuais realizadas por trabalhadores terceirizados de plataformas de crowdsourcing, provenientes de diferentes culturas, podem levar a imagens rotuladas ou até segmentadas de maneiras distintas, resultando em algoritmos inconsistentes e insatisfatórios.
Um exemplo disso é a interpretação subjetiva do que define um «objeto em primeiro plano»:

Do novo artigo: os métodos anteriores LFM e MODNet («GT» significa Ground Truth, um resultado «ideal» frequentemente obtido de forma manual ou por métodos não algorítmicos) apresentam interpretações distintas e de eficácia variável sobre a definição do conteúdo em primeiro plano, enquanto o novo método SPG-IM delimita com mais eficácia o «conteúdo próximo» com base no contexto da cena.
Para enfrentar esse problema, os pesquisadores desenvolveram um fluxo de trabalho em duas etapas chamado Situational Perception Guided Image Matting (SPG-IM). A arquitetura codificador/decodificador em duas etapas é composta por Situational Perception Distillation (SPD) e Situational Perception Guided Matting (SPGM).

A arquitetura SPG-IM.
Primeiro, o SPD pré-treina transformações de características visuais em textuais, gerando legendas adequadas às imagens correspondentes. Em seguida, a previsão da máscara do primeiro plano é viabilizada pela conexão do fluxo de trabalho a uma nova técnica de previsão de saliência.
Em seguida, o SPGM produz uma máscara alfa estimada com base na imagem RGB bruta de entrada e na máscara gerada no primeiro módulo.
O objetivo é orientar o processo pela percepção situacional, de modo que o sistema compreenda o contexto do que compõe a imagem e possa, por exemplo, enquadrar o desafio de extrair cabelos complexos do fundo considerando as características conhecidas dessa tarefa específica.

No exemplo abaixo, o SPG-IM entende que os cordões fazem parte de um «paraquedas», enquanto o MODNet não consegue preservar nem definir esses detalhes. Da mesma forma, acima, a estrutura completa do equipamento do parquinho se perde de maneira arbitrária no MODNet.
O novo artigo intitula-se Recorte de imagens guiado pela percepção situacional e é de autoria de pesquisadores do OPPO Research Institute, da PicUp.ai e da Xmotors.
Máscaras inteligentes automatizadas
O SPG-IM também propõe uma rede de refinamento Adaptive Focal Transformation (AFT), capaz de processar separadamente os detalhes locais e o contexto global, facilitando a criação de “máscaras inteligentes”.

Compreender o contexto da cena, neste caso, “menina com cavalo”, pode facilitar a extração do primeiro plano em comparação com métodos anteriores.
O artigo afirma:
“Acreditamos que as representações visuais provenientes da tarefa de conversão de imagem em texto, por exemplo, a geração de legendas para imagens, concentram-se em sinais semanticamente mais abrangentes entre a) um objeto e outro e b) um objeto e o ambiente ao redor, para gerar descrições capazes de abranger tanto as informações globais quanto os detalhes locais. Além disso, em comparação com a dispendiosa anotação de pixels no recorte de imagens, os rótulos textuais podem ser coletados em grande escala a um custo muito baixo.”
O ramo SPD da arquitetura é pré-treinado em conjunto com o decodificador textual baseado em transformador VirTex da University of Michigan, que aprende representações visuais a partir de legendas semanticamente densas.

O VirTex treina conjuntamente uma rede convolucional e transformers usando pares de imagem e legenda e transfere os conhecimentos obtidos para tarefas de visão computacional posteriores, como a detecção de objetos. Fonte: https://arxiv.org/pdf/2006.06666.pdf
Entre outros testes e estudos de ablação, os pesquisadores compararam o SPG-IM com métodos de ponta baseados em trimap: Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA e Semantic Image Matting (SIM).
Outras estruturas anteriores avaliadas incluíram as abordagens sem trimap LFM, HAttMatting e MODNet. Para garantir uma comparação justa, os métodos de teste foram adaptados de acordo com as diferentes metodologias; quando o código não estava disponível, as técnicas do artigo foram reproduzidas com base na arquitetura descrita.
O novo artigo afirma:
«Nosso SPG-IM supera com ampla margem todos os métodos concorrentes sem trimap ([LFM], [HAttMatting] e [MODNet]). Além disso, nosso modelo também demonstra superioridade notável em relação aos métodos de última geração (SOTA) baseados em trimap e guiados por máscara nas quatro métricas avaliadas nos conjuntos de dados públicos (isto é, Composition-1K, Distinction-646 e Human-2K) e em nosso benchmark Multi-Object-1K.»
E acrescenta:
«É possível observar claramente que nosso método preserva detalhes minuciosos (por exemplo, pontas dos fios de cabelo, texturas transparentes e contornos) sem a orientação de um trimap. Além disso, em comparação com outros modelos concorrentes sem trimap, nosso SPG-IM consegue preservar melhor a completude semântica global.»


Publicado originalmente em 24 de abril de 2022.