Ângulo de Anderson
Edição de Vídeo Consistente com Entrada Orientada por Texto

 Adicione Unite.AI às suas fontes preferidas no Google
Enquanto a comunidade profissional de efeitos visuais está intrigada – e ocasionalmente se sente um pouco ameaçada – pelas novas inovações em síntese de imagem e vídeo, a falta de continuidade temporal em muitos projetos de edição de vídeo baseados em IA relega muitos desses esforços à esfera “psicodélica”, com texturas e estruturas cintilantes e rapidamente alteradas, efeitos inconsistentes e o tipo de tecnologia bruta que lembra a era fotoquímica dos efeitos visuais.
Se você deseja alterar algo muito específico em um vídeo que não se encaixa na categoria de deepfakes (ou seja, impor uma nova identidade em imagens existentes de uma pessoa), a maioria das soluções atuais opera sob limitações bastante severas, em termos de precisão necessária para efeitos visuais de produção de qualidade.
Uma exceção é o trabalho contínuo de um grupo de acadêmicos do Instituto de Ciência de Weizmann. Em 2021, três de seus pesquisadores, em associação com a Adobe (ADBE ), anunciaram um método inovador para decompor vídeo e superpor um mapeamento interno consistente – um atlas neural em camadas – em uma saída composta, completa com canais alfa e saída temporalmente coesa.
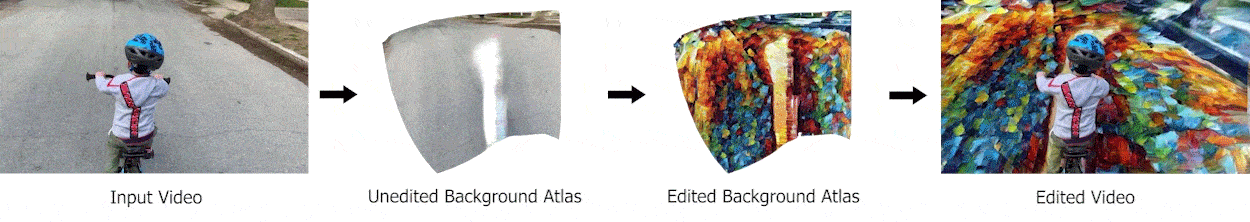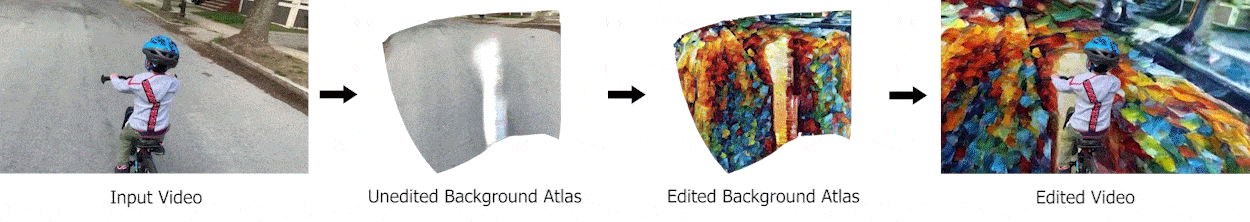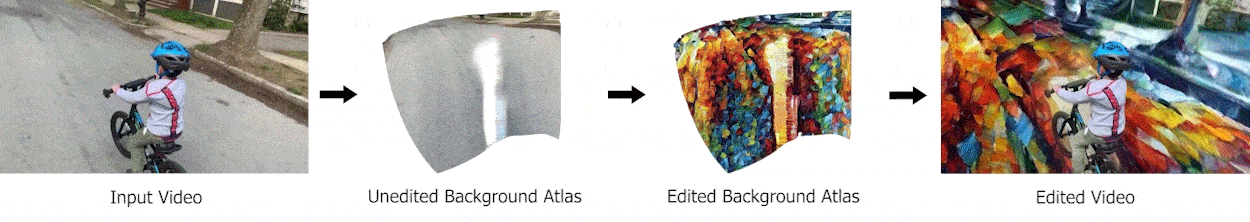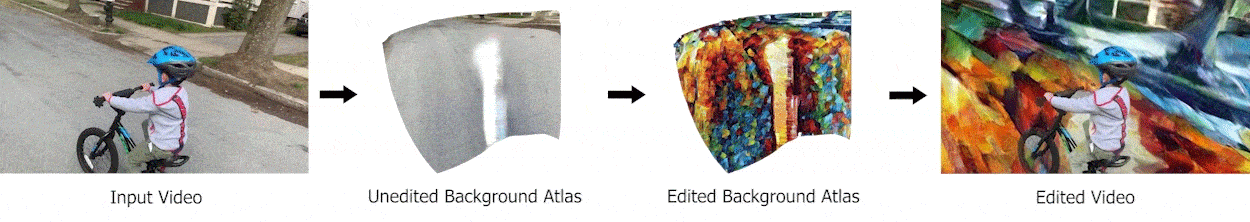
Do artigo de 2021: uma estimativa da travessia completa da estrada no clipe de origem é editada por meio de uma rede neural de maneira que tradicionalmente exigiria rotoscopia e match-moving extensivos. Como os elementos de fundo e primeiro plano são tratados por redes diferentes, as máscaras são verdadeiramente ‘automáticas’. Fonte: https://layered-neural-atlases.github.io/
Embora caia em algum lugar no domínio coberto por fluxo óptico em pipelines de VFX, o atlas em camadas não tem um equivalente direto em fluxos de trabalho de CGI tradicionais, pois constitui essencialmente um ‘mapa de textura temporal’ que pode ser produzido e editado por meio de métodos de software tradicionais. Na segunda imagem da ilustração acima, o fundo da superfície da estrada é representado (figurativamente) ao longo de toda a duração do vídeo. Alterar essa imagem de base (terceira imagem da esquerda na ilustração acima) produz uma mudança consistente no fundo.
As imagens do ‘atlas desdobrado’ acima representam apenas quadros interpretados individualmente; mudanças consistentes em qualquer quadro de vídeo alvo são mapeadas de volta para o quadro original, mantendo qualquer oclusão necessária e outros efeitos de cena necessários, como sombras ou reflexos.
A arquitetura central usa um Perceptron Multicamada (MLP) para representar os atlas desdobrados, canais alfa e mapeamentos, todos otimizados em conjunto e inteiramente em um espaço 2D, dispensando o conhecimento prévio de pontos de geometria 3D, mapas de profundidade e outros recursos de CGI.
O atlas de referência de objetos individuais também pode ser alterado de forma confiável:
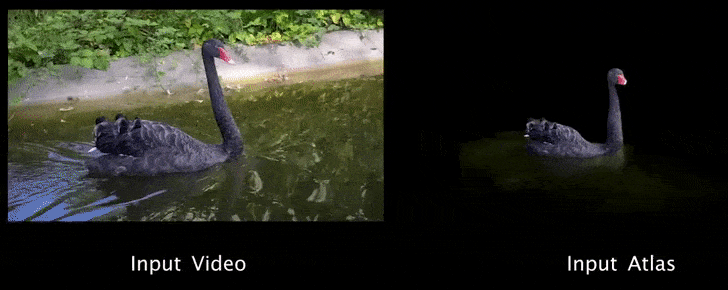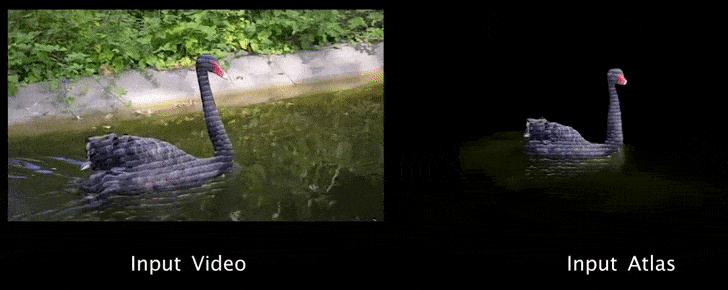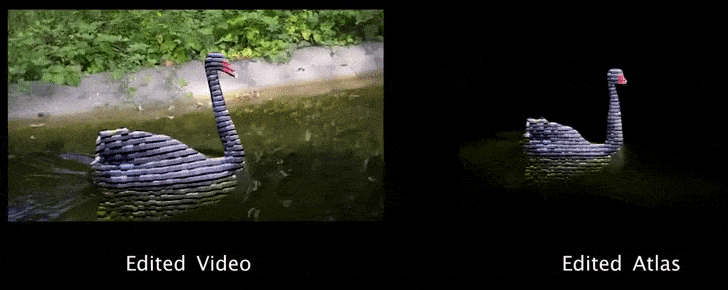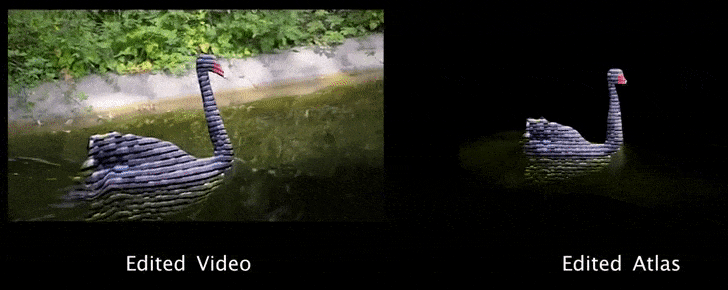
Mudança consistente em um objeto em movimento sob o framework de 2021. Fonte: https://www.youtube.com/watch?v=aQhakPFC4oQ
Essencialmente, o sistema de 2021 combina alinhamento de geometria, match-moving, mapeamento, retexturização e rotoscopia em um processo neural discreto.
Text2Live
Os três pesquisadores originais do artigo de 2021, juntamente com a NVIDIA (NVDA ) Research, estão entre os contribuintes para uma nova inovação na técnica que combina o poder dos atlas em camadas com o tipo de tecnologia CLIP orientada por texto que voltou a ganhar destaque esta semana com o lançamento do framework DALL-E 2 da OpenAI.
A nova arquitetura, intitulada Text2Live, permite que um usuário final crie edições localizadas em conteúdo de vídeo real com base em prompts de texto:
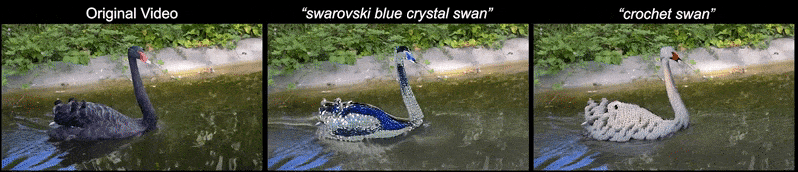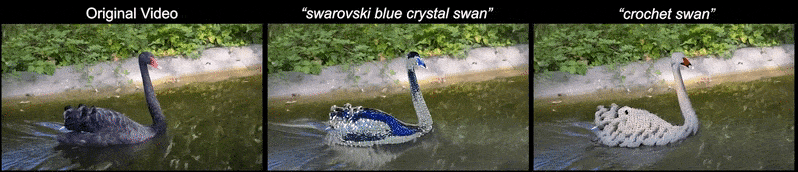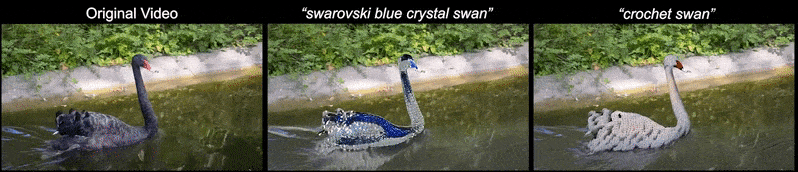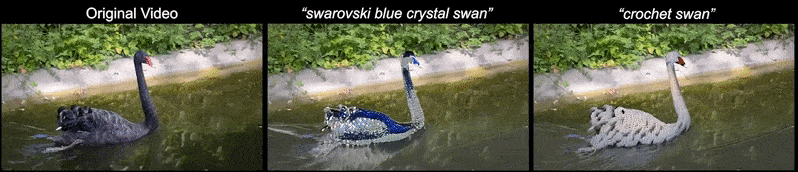
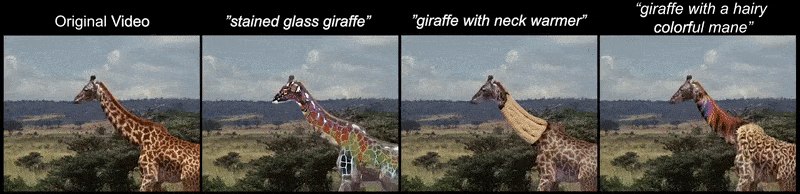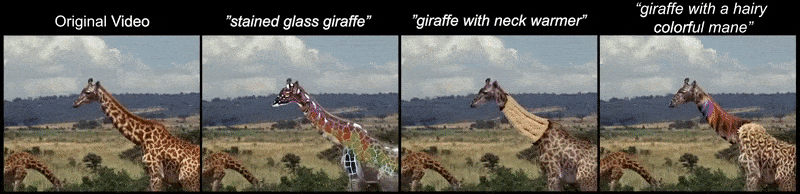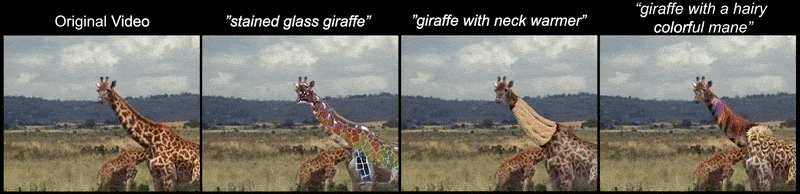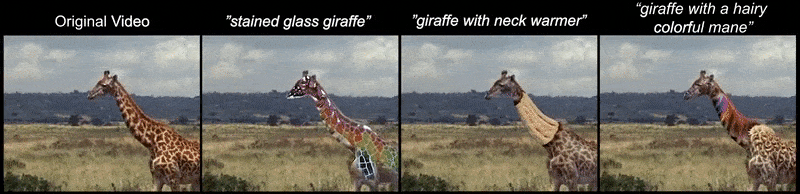
Dois exemplos de edição de primeiro plano. Para melhor resolução e definição, verifique os vídeos originais em https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live oferece edição semântica e altamente localizada sem o uso de um gerador pré-treinado, utilizando um banco de dados interno específico do clipe de vídeo afetado.

Transformações de fundo e primeiro plano (objeto) sob Text2Live. Fonte: https://text2live.github.io/sm/pages/video_results_atlases.html
A técnica não requer máscaras fornecidas pelo usuário, como um fluxo de trabalho típico de rotoscopia ou chroma key, mas sim estima mapas de relevância por meio de uma técnica de inicialização baseada em pesquisa de 2021 da Escola de Ciência da Computação da Universidade de Tel Aviv e da Facebook AI Research (FAIR).

Mapas de saída gerados por meio de um modelo de atenção genérico baseado em transformador.
O novo artigo é intitulado Text2LIVE: Edição de Imagem e Vídeo Orientada por Texto em Camadas. A equipe original de 2021 é acompanhada por Omer Bar-Tal, do Weizmann, e Yoni Kasten, da NVIDIA Research.
Arquitetura
Text2Live compreende um gerador treinado em uma única imagem de entrada e prompts de texto. Um modelo CLIP pré-treinado em 400 milhões de pares de texto/imagens fornece material visual associado a partir do qual transformações de entrada do usuário podem ser interpretadas.

O gerador aceita uma imagem de entrada (quadro) e produz uma camada RGBA de destino contendo informações de cor e opacidade. Essa camada é então composta no footage original com aumentos adicionais.

O canal alfa na camada RGBA gerada fornece uma função de composição interna sem recorrer a pipelines tradicionais que envolvem software baseado em pixels, como o After Effects.
Ao treinar em imagens internas relevantes para o vídeo ou imagem de destino, Text2Live evita a necessidade de inverter a imagem de entrada no espaço latente de uma Rede Adversária Generativa (GAN), uma prática que atualmente está longe de ser exata o suficiente para requisitos de edição de vídeo de produção, ou usar um modelo de difusão que é mais preciso e configurável, mas não pode manter a fidelidade ao vídeo de destino.

Diversas edições de transformação baseadas em prompts do Text2Live.
Abordagens anteriores usaram métodos baseados em propagação ou abordagens baseadas em fluxo óptico. Como essas técnicas são, em algum grau, baseadas em quadros, nenhuma delas é capaz de criar uma aparência temporal consistente de mudanças no vídeo de saída. Um atlas neural em camadas, por outro lado, fornece um único espaço para abordar mudanças, que podem então permanecer fiéis à mudança comprometida à medida que o vídeo avança.
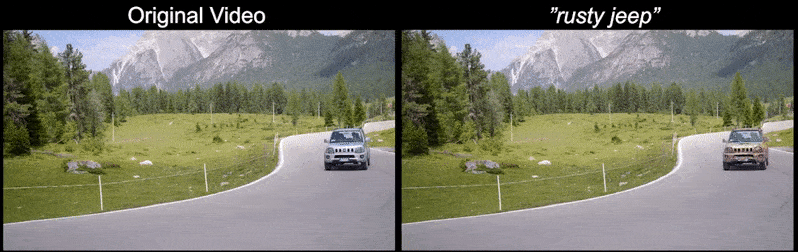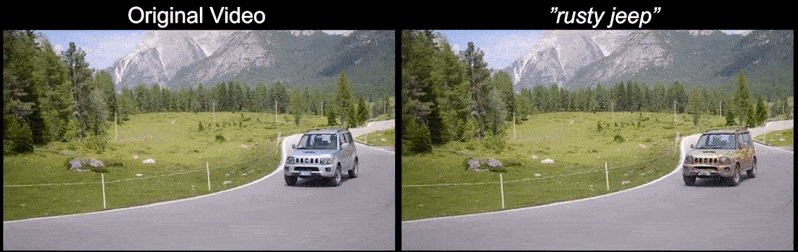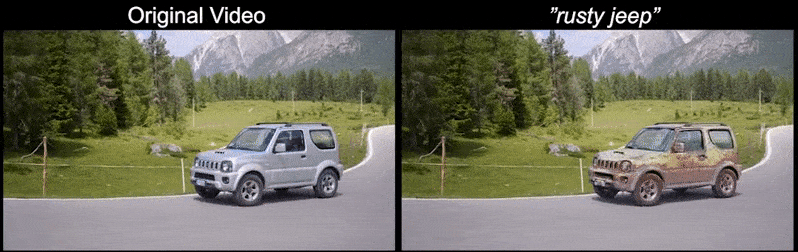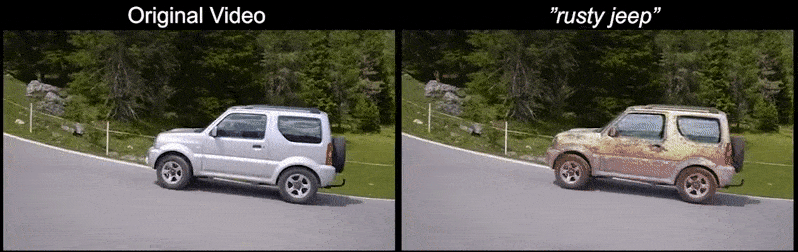
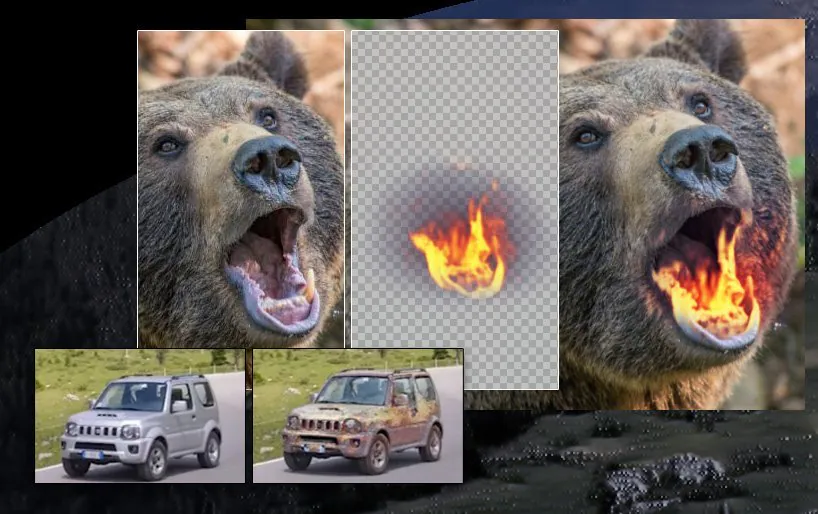
Sem ‘sizzling’ ou alucinações aleatórias: Text2Live obtém uma interpretação do prompt de texto ‘jeep enferrujado’ e aplica-o uma vez ao atlas neural em camadas do carro no vídeo, em vez de reiniciar a transformação para cada quadro interpretado.

Fluxo de trabalho da transformação consistente do Text2Live de um Jeep em uma relíquia enferrujada.
Text2Live está mais próximo de uma inovação na composição baseada em IA do que no fértil espaço de texto para imagem, que atraiu tanta atenção esta semana com o lançamento da segunda geração do framework DALL-E da OpenAI (que pode incorporar imagens de destino como parte do processo de transformação, mas permanece limitado em sua capacidade de intervir diretamente em uma foto, além da censura de dados de treinamento de origem e imposição de filtros projetados para prevenir o abuso do usuário).
Em vez disso, Text2Live permite que o usuário final extraia um atlas e, em seguida, edite-o em uma única passagem em ambientes de pixels de alto controle, como o Photoshop (e, argumenta-se, mesmo em frameworks de síntese de imagem mais abstratos, como o NeRF), antes de alimentá-lo de volta em um ambiente corretamente orientado que, no entanto, não depende de estimativa 3D ou abordagens baseadas em CGI.
Além disso, Text2Live, segundo os autores, é o primeiro framework comparável a alcançar mascaramento e composição de forma completamente automática.
Publicado pela primeira vez em 7 de abril de 2022.