
Ângulo de Anderson
Edição de objetos assistida por IA com Imagic do Google e Erase and Replace da Runway

 Adicione Unite.AI às suas fontes preferidas no Google

Pontos-chaveO Imagic ajusta modelos de difusão para edições granulares de objetos, ao contrário do…
Ver mais
- O Imagic ajusta modelos de difusão para edições granulares de objetos, ao contrário do Erase and Replace da Runway, que apenas substitui.
- O Erase and Replace da Runway substitui objetos rapidamente, mas não consegue editar o conteúdo existente, apenas substituí-lo.
- A otimização por imagem do Imagic leva oito minutos em chips TPUV4 duplos, o que a limita ao uso via API.
Esta semana, dois novos, porém contrastantes, algoritmos gráficos impulsionados por IA estão oferecendo maneiras inovadoras para que os usuários finais façam alterações altamente granulares e eficazes em objetos nas fotos.
O primeiro é Imagic, da Google Research, em associação com o Instituto de Tecnologia de Israel e o Instituto Weizmann de Ciências. Imagic oferece edição de objetos condicionada por texto e de alta granularidade por meio do ajuste fino de modelos de difusão.

Mude o que quiser e deixe o restante intacto: Imagic promete editar com precisão apenas as partes que você deseja alterar. Fonte: https://arxiv.org/pdf/2210.09276.pdf
Qualquer pessoa que já tentou mudar apenas um elemento em uma re‑renderização do Stable Diffusion sabe muito bem que, para cada edição bem‑sucedida, o sistema altera cinco coisas que você gostava exatamente como estavam. É uma limitação que atualmente faz com que muitos dos mais talentosos entusiastas do SD alternem constantemente entre Stable Diffusion e Photoshop para corrigir esse tipo de “dano colateral”. Só por esse ponto de vista, as conquistas do Imagic parecem notáveis.
No momento da redação, o Imagic ainda não possui nem mesmo um vídeo promocional e, dada a atitude cautelosa da Google em lançar ferramentas de síntese de imagens sem restrições, não está claro até que ponto, se houver, teremos a oportunidade de testar o sistema.
A segunda oferta é a funcionalidade Erase and Replace da Runway ML, um novo recurso na seção ‘AI Magic Tools’ de sua suíte exclusivamente online de utilitários de efeitos visuais baseados em aprendizado de máquina.
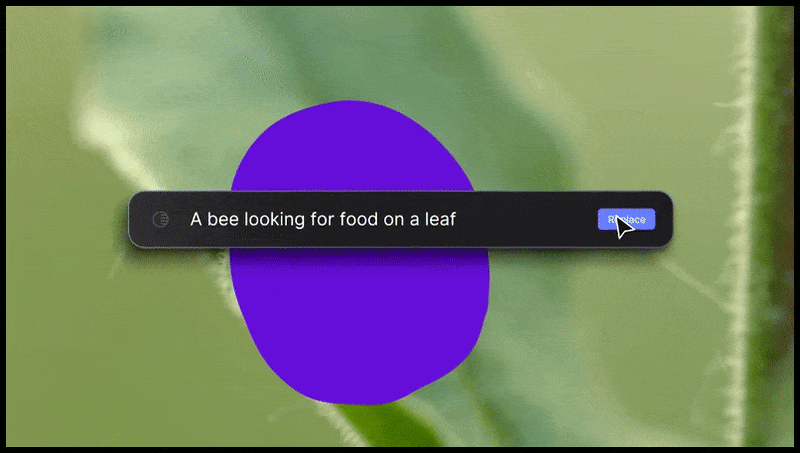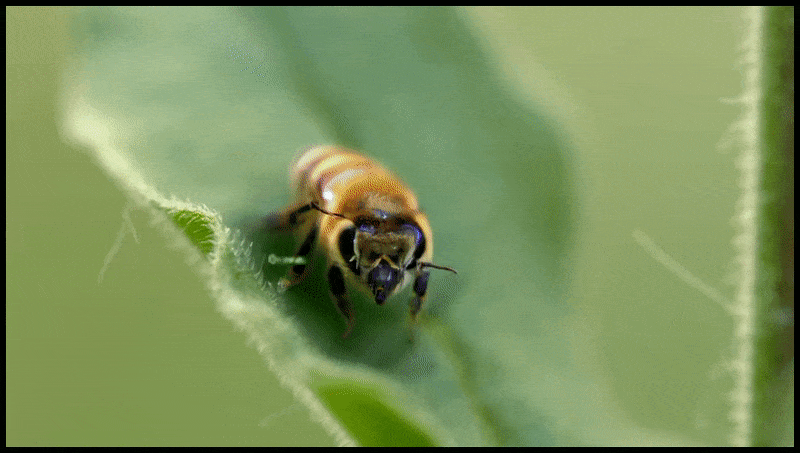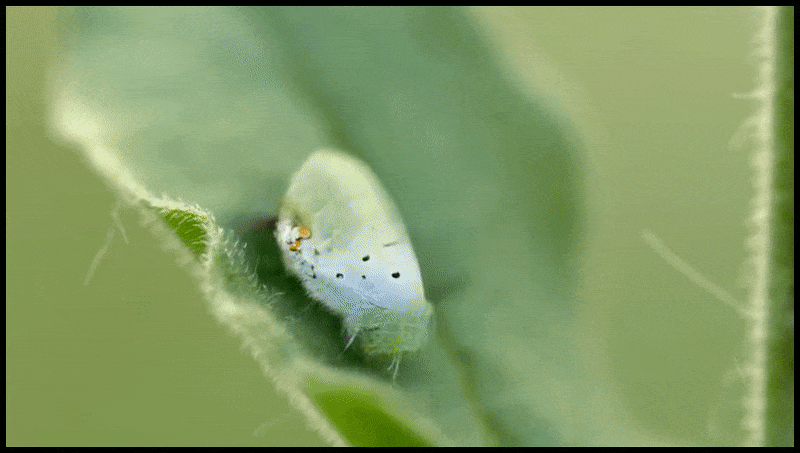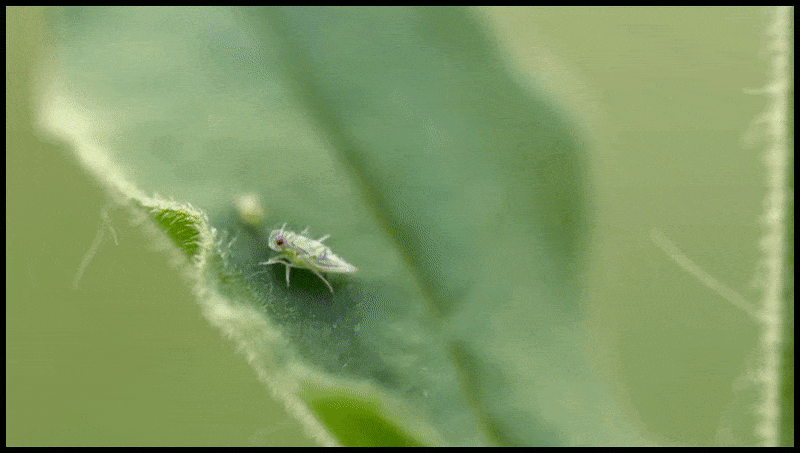
A função Erase and Replace da Runway ML, já mostrada em uma prévia de um sistema de edição de vídeo por texto.
Vamos dar uma olhada na apresentação da Runway primeiro.
Apagar e Substituir
Assim como o Imagic, Apagar e Substituir lida exclusivamente com imagens estáticas, embora a Runway tenha apresentado a mesma funcionalidade em uma solução de edição texto‑para‑vídeo que ainda não foi lançada:
Qualquer pessoa pode testar a nova Erase and Replace em imagens, mas a versão de vídeo ainda não está disponível publicamente. Fonte: https://twitter.com/runwayml/status/1568220303808991232
Embora a Runway ML não tenha divulgado detalhes das tecnologias por trás de Apagar e Substituir, a velocidade com que você pode substituir uma planta de interior por um busto razoavelmente convincente de Ronald Reagan sugere que um modelo de difusão como o Stable Diffusion (ou, muito menos provável, um DALL‑E 2 licenciado) é o motor que está recriando o objeto de sua escolha em Apagar e Substituir.

Trocar uma planta de interior por um busto de The Gipper não é tão rápido quanto aqui, mas ainda é bastante rápido. Fonte: https://app.runwayml.com/
O sistema possui algumas restrições do tipo DALL‑E 2 – imagens ou textos que acionam os filtros de Apagar e Substituir gerarão um aviso sobre possível suspensão de conta em caso de novas infrações – praticamente uma cópia padrão das políticas vigentes da OpenAI para o DALL‑E 2.
Muitos dos resultados carecem das típicas imperfeições do Stable Diffusion. A Runway ML é investidora e parceira de pesquisa no SD, e é possível que tenham treinado um modelo proprietário que supera os pesos de checkpoint 1.4 de código aberto com os quais o resto de nós estamos lidando atualmente (assim como muitos outros grupos de desenvolvimento, amadores e profissionais, estão treinando ou ajustando modelos Stable Diffusion).
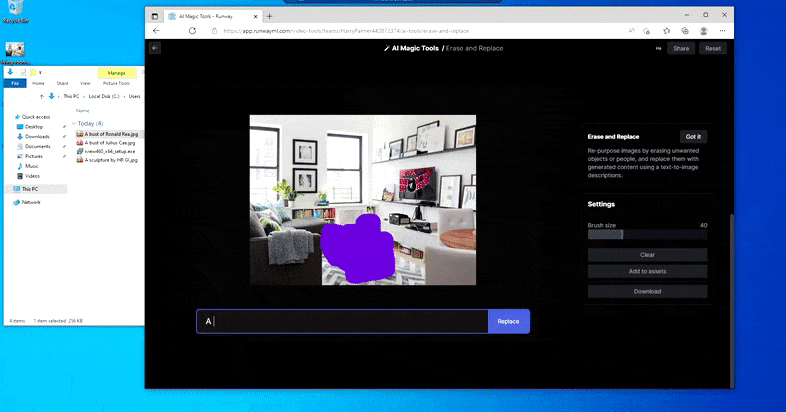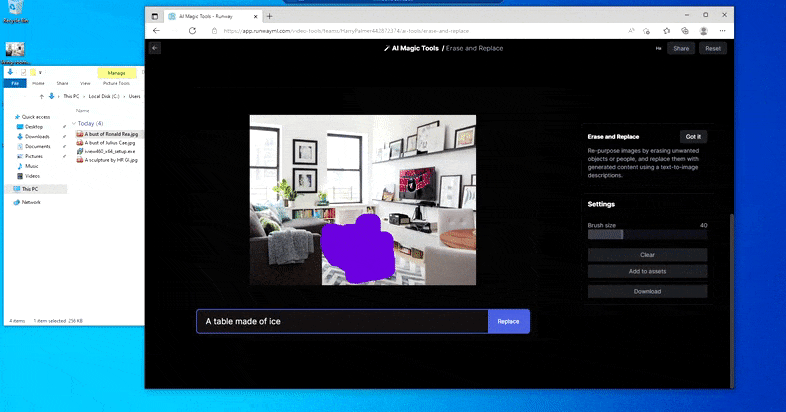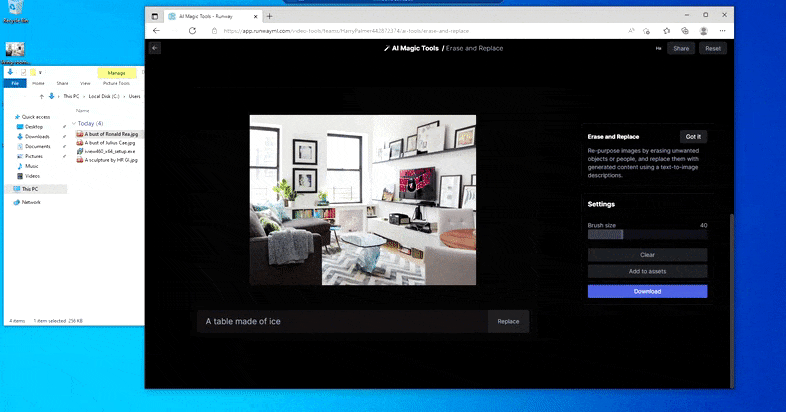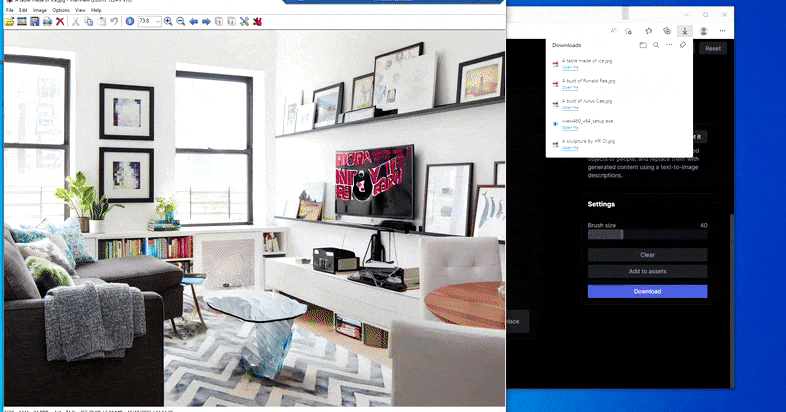
Substituição de uma mesa doméstica por uma mesa feita de gelo na Erase and Replace da Runway ML.
Assim como o Imagic (veja abaixo), Apagar e Substituir é ‘orientado a objetos’, por assim dizer – você não pode simplesmente apagar uma parte ‘vazia’ da imagem e preenchê‑la com o resultado do seu prompt de texto; nesse cenário, o sistema simplesmente rastreia o objeto aparente mais próximo ao longo da linha de visão da máscara (como uma parede ou uma televisão) e aplica a transformação ali.
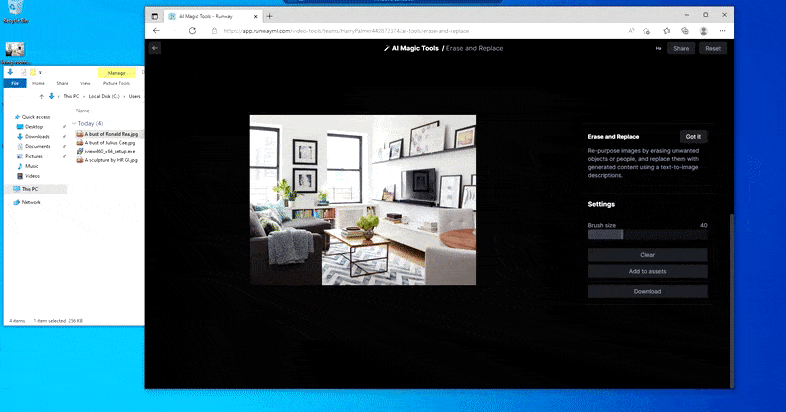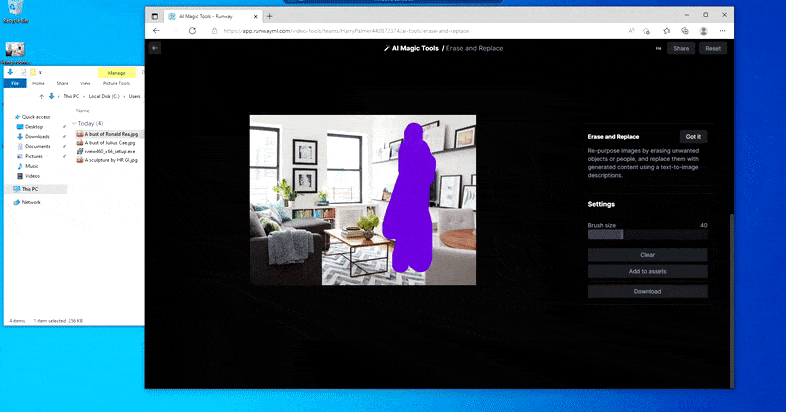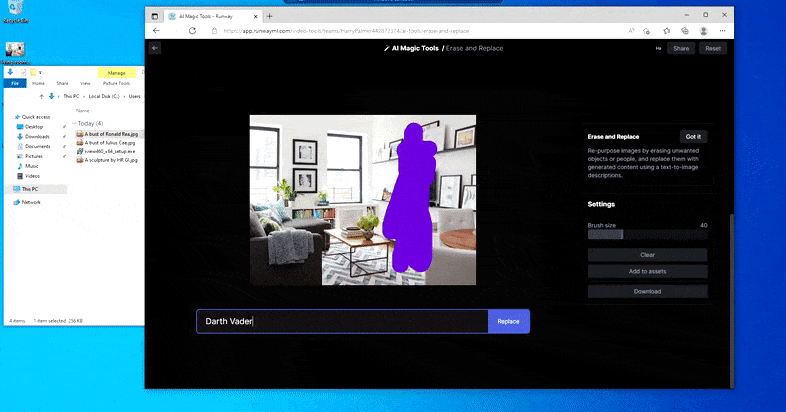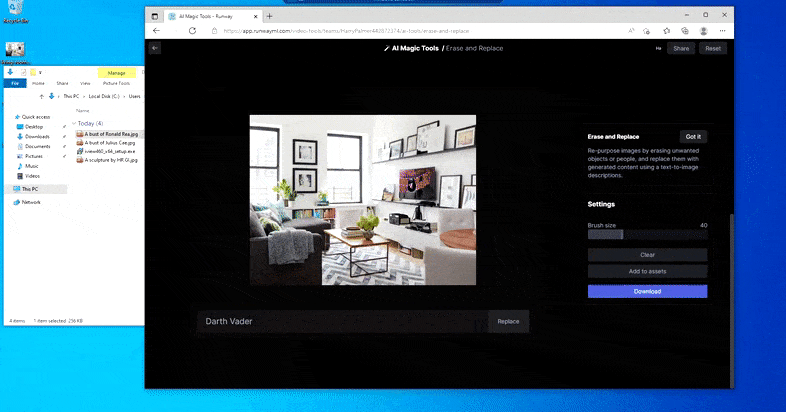
Como o nome indica, não é possível inserir objetos em espaços vazios na Erase and Replace. Aqui, uma tentativa de invocar o mais famoso dos lordes Sith cria um estranho mural relacionado a Vader na TV, aproximadamente onde a área de substituição foi desenhada.
É difícil determinar se Apagar e Substituir está sendo evasivo quanto ao uso de imagens protegidas por direitos autorais (que ainda são amplamente bloqueadas, embora com sucesso variável, no DALL‑E 2), ou se o modelo usado no motor de renderização de fundo simplesmente não está otimizado para esse tipo de situação.

O mural ligeiramente impróprio para o trabalho de Nicole Kidman indica que o modelo, presumivelmente baseado em difusão, não tem a antiga rejeição sistemática do DALL-E 2 a rostos realistas ou conteúdo provocante. Os resultados de tentativas de reproduzir obras protegidas variam do ambíguo (xenomorfo) ao absurdo (trono de ferro). A imagem original aparece em uma inserção no canto inferior direito.
Seria interessante saber quais métodos Apagar e Substituir está usando para isolar os objetos que pode substituir. Presumivelmente a imagem passa por alguma derivação do CLIP, com os itens discretos individualizados por reconhecimento de objetos e segmentação semântica subsequente. Nenhuma dessas operações funciona nem de perto tão bem em uma instalação padrão do Stable Diffusion.
Mas nada é perfeito – às vezes o sistema parece apagar e não substituir, mesmo quando (como vimos na imagem acima) o mecanismo de renderização subjacente definitivamente entende o que um prompt de texto significa. Nesse caso, prova ser impossível transformar uma mesa de centro em um xenomorfo – a mesa simplesmente desaparece.
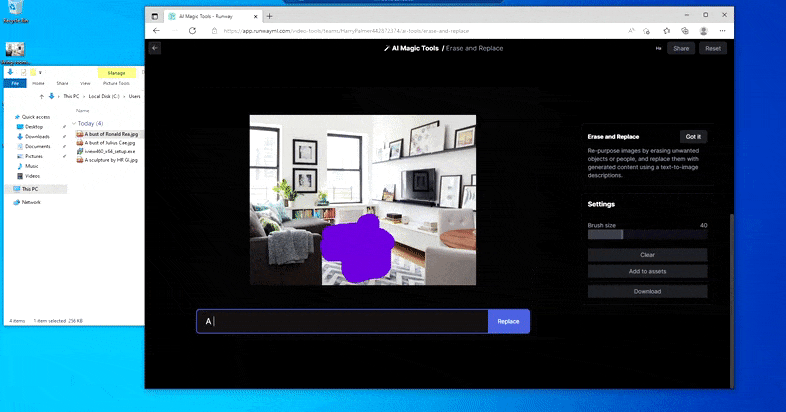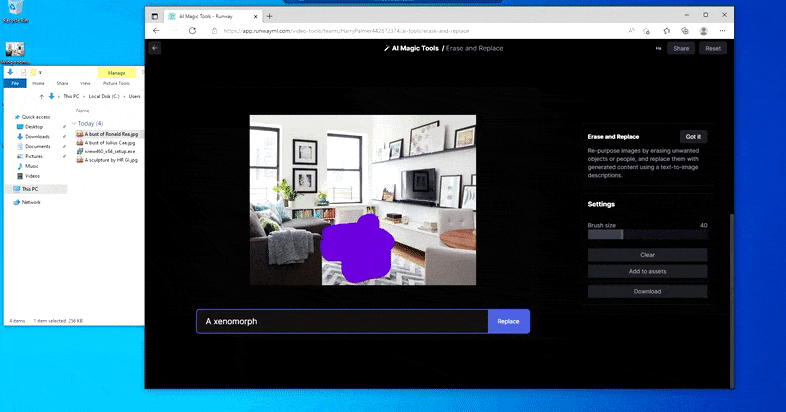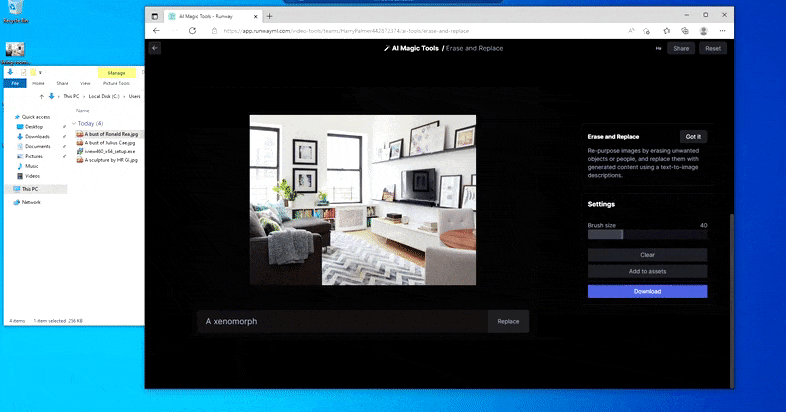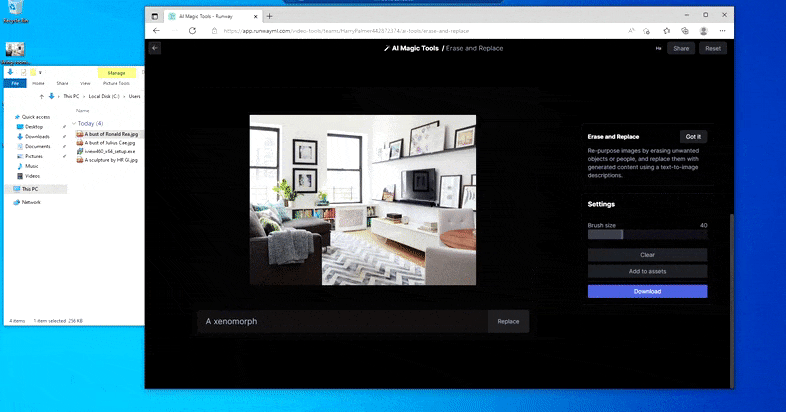
Uma versão mais assustadora de Onde Está Wally, já que Erase and Replace não consegue produzir um alienígena.
Apagar e Substituir parece ser um sistema eficaz de substituição de objetos, com excelente preenchimento. No entanto, ele não pode editar objetos percebidos existentes, apenas substituí‑los. Alterar realmente o conteúdo de uma imagem existente sem comprometer o material ambiente é, sem dúvida, uma tarefa muito mais difícil, ligada à longa luta do setor de pesquisa em visão computacional pela separação de representações (disentanglement) nos diversos espaços latentes das estruturas populares.
Imagic
É uma tarefa que o Imagic aborda. O novo artigo oferece inúmeros exemplos de edições que alteram com sucesso facetas individuais de uma foto enquanto deixam o restante da imagem intacto.

No Imagic, as imagens alteradas não sofrem o alongamento, a distorção e a adivinhação de regiões ocultas típicos da animação de marionetes deepfake, que usa informações prévias limitadas extraídas de uma única imagem.
O sistema utiliza um processo de três etapas – otimização de incorporação de texto; ajuste fino do modelo; e, finalmente, a geração da imagem modificada.

Imagic codifica o prompt de texto desejado para obter a representação inicial e otimiza o resultado para obter a imagem de entrada. Depois, o modelo generativo é ajustado à imagem original, acrescentando parâmetros antes da interpolação solicitada.
Não surpreendentemente, a estrutura baseia‑se na arquitetura de texto‑para‑vídeo Imagen da Google, embora os pesquisadores afirmem que os princípios do sistema são amplamente aplicáveis a modelos de difusão latente.
A Imagen utiliza uma arquitetura de três camadas, em vez da matriz de sete camadas usada na iteração mais recente de texto‑para‑vídeo da empresa. Os três módulos distintos compreendem um modelo de difusão generativa operando em resolução 64 × 64 px; um modelo de super‑resolução que amplia essa saída para 256 × 256 px; e um modelo adicional de super‑resolução que eleva a saída até 1024 × 1024 px.
O Imagic intervém na fase mais inicial desse processo, otimizando a incorporação de texto solicitada na etapa de 64 px usando um otimizador Adam com taxa de aprendizado estática de 0,0001.

Uma demonstração magistral de separação de representações: quem já tentou mudar algo tão simples como a cor de um objeto renderizado em um modelo de difusão, GAN ou NeRF sabe como é importante que Imagic o faça sem romper a consistência do restante da imagem.
O ajuste fino então ocorre no modelo base da Imagen, por 1500 passos por imagem de entrada, condicionado à incorporação revisada. Ao mesmo tempo, a camada secundária 64 px > 256 px é otimizada em paralelo na imagem condicionada. Os pesquisadores observam que uma otimização semelhante para a camada final 256 px > 1024 px tem ‘pouco ou nenhum efeito’ nos resultados finais, e, por isso, não a implementaram.
O artigo afirma que o processo de otimização leva aproximadamente oito minutos por imagem em dois chips TPUV4. A renderização final ocorre no núcleo da Imagen sob o esquema de amostragem DDIM.
Em comum com processos de ajuste fino semelhantes para o DreamBooth da Google, as incorporações resultantes podem ainda ser usadas para estilização, bem como para edições fotorrealistas que contêm informações extraídas do amplo banco de dados subjacente que alimenta a Imagen (já que, como mostra a primeira coluna abaixo, as imagens de origem não possuem o conteúdo necessário para efetuar essas transformações).

Imagic permite movimentos e edições fotorrealistas flexíveis, enquanto os códigos derivados e separados no processo podem ser usados com a mesma facilidade para resultados estilizados.
Os pesquisadores compararam o Imagic a trabalhos anteriores: SDEdit, uma abordagem baseada em GAN de 2021, uma colaboração entre a Universidade de Stanford e a Carnegie Mellon University; e Text2Live, uma colaboração de abril de 2022 entre o Instituto Weizmann de Ciências e a NVIDIA.

Comparação visual entre Imagic, SDEdit e Text2Live.
É evidente que as abordagens anteriores estão enfrentando dificuldades, mas na linha inferior, que envolve uma mudança massiva de pose, os concorrentes falham completamente em refazer o material de origem, ao contrário do notável sucesso do Imagic.
Os requisitos de recursos e o tempo de treinamento por imagem do Imagic, embora curtos pelos padrões dessas buscas, tornam sua inclusão em um aplicativo local de edição de imagens em computadores pessoais improvável – e não está claro até que ponto o processo de ajuste fino poderia ser reduzido a níveis de consumo.
Na prática, o Imagic é uma oferta impressionante que se adapta melhor a APIs – um ambiente que a Google Research, cautelosa quanto a críticas relacionadas à facilitação de deepfakes, pode, de qualquer forma, considerar mais confortável.
Primeira publicação 18 de outubro de 2022.


