
Fundamentos de IA
O que é um Data Warehouse? Arquitetura, ETL e Casos de Uso

 Adicione Unite.AI às suas fontes preferidas no Google
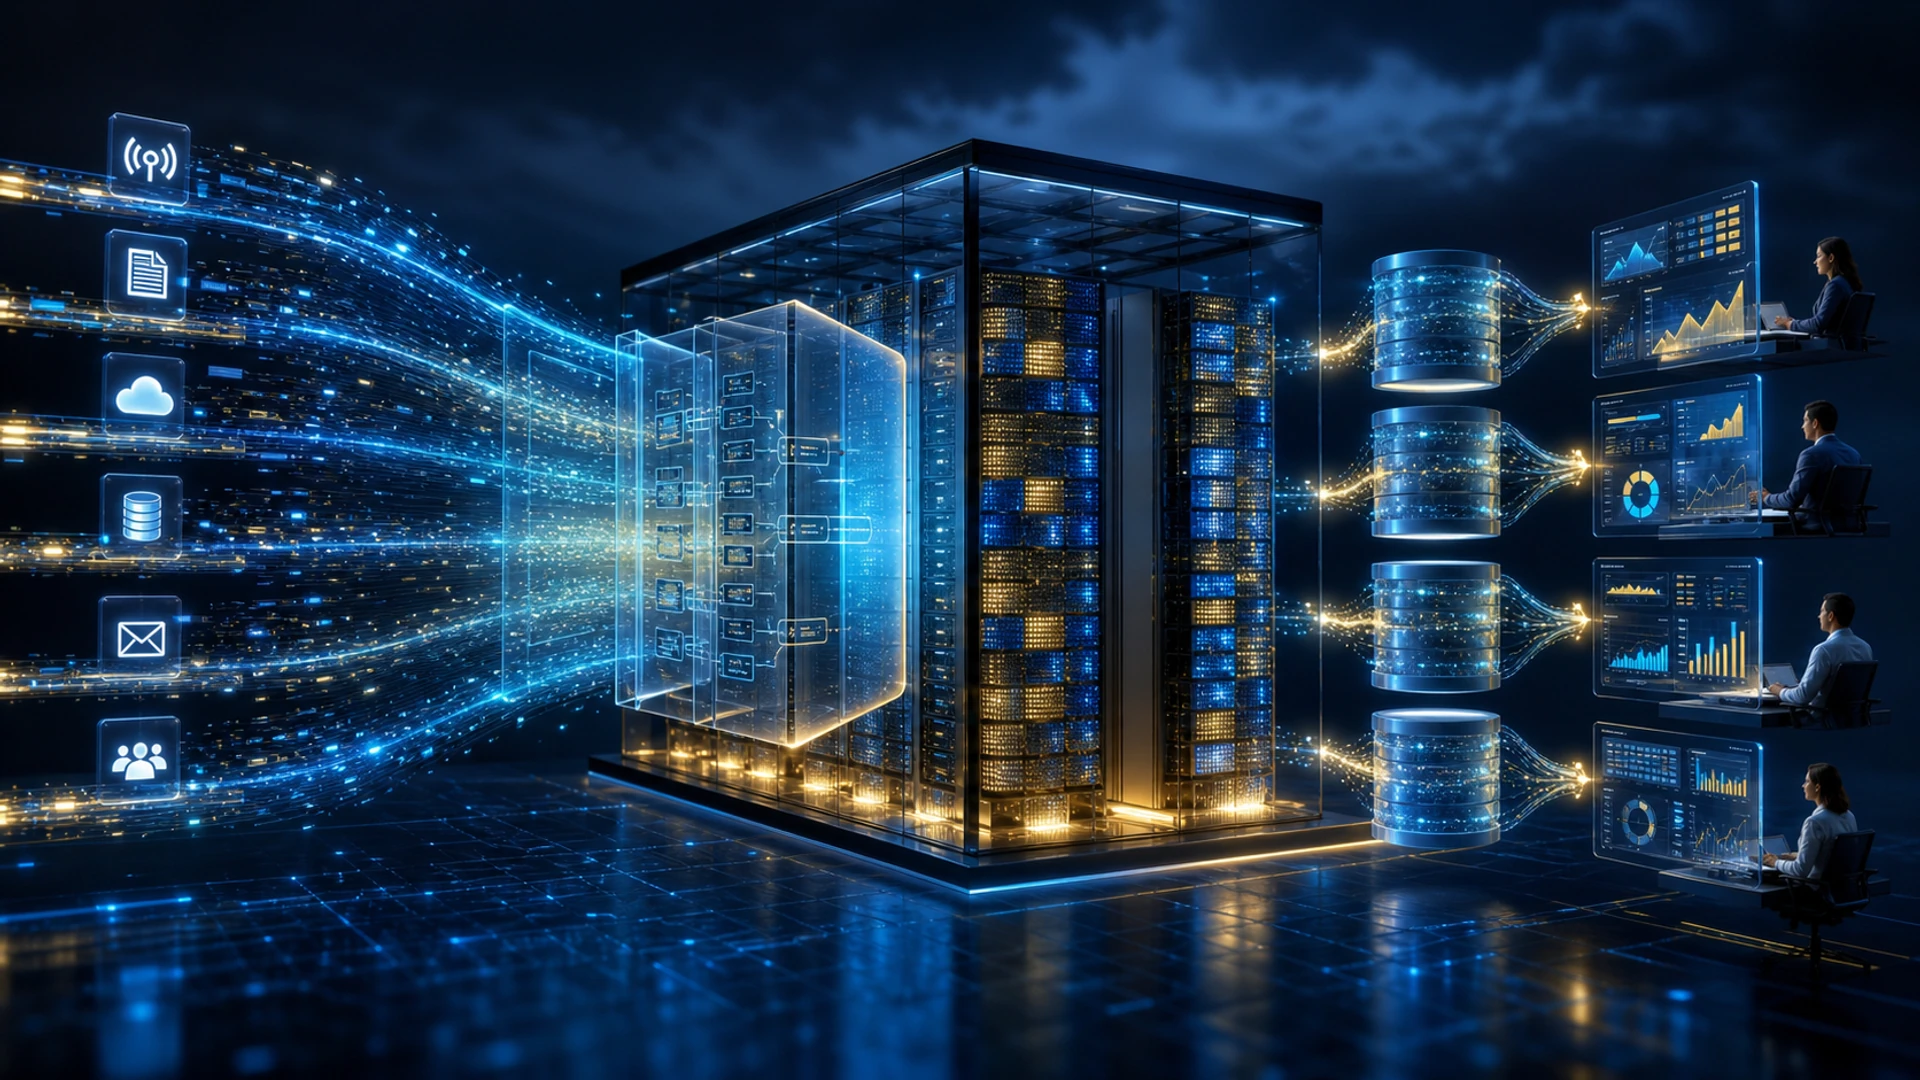
Um data warehouse é um sistema de dados analítico que integra informações de fontes operacionais e as organiza para relatórios, business intelligence e análises repetíveis. Ele separa muitas cargas de trabalho analíticas das aplicações que registram transações.
Os data warehouses modernos podem ser columnares, distribuídos, serverless ou conectados a armazenamento de objetos. O trabalho definidor permanece consistente: ingestão governada, significado modelado, histórico, desempenho de consultas, segurança, qualidade e entrega confiável aos usuários.
Principais pontos
- Sistemas operacionais otimizam transações atuais; data warehouses otimizam análises históricas entre fontes.
- ETL transforma antes de carregar, enquanto ELT carrega primeiro e transforma dentro da plataforma analítica.
- Modelos dimensionais, normalizados e de tabelas largas atendem a diferentes cargas de trabalho e necessidades de governança.
- A confiança depende de linhagem, testes, atualidade, controle de acesso, definições semânticas e monitoramento de custos.
Fontes, ingestão e armazenamento
Os dados podem chegar por lotes, captura de mudanças (change-data capture), fluxos, arquivos e APIs. Uma camada de aterrissagem preserva o contexto da fonte; as transformações padronizam tipos, deduplicam registros, tratam eventos tardios e criam entidades analíticas reutilizáveis.
Isso amplia o fluxo de trabalho de ETL. ELT usa o poder de computação do warehouse para transformação, enquanto ETL pode reduzir ou validar os dados antes de carregá‑los. A escolha correta depende de latência, privacidade, escala e cadeia de ferramentas.
Modelar dados para perguntas
Modelos dimensionais organizam fatos mensuráveis em torno de dimensões descritivas como cliente, produto e tempo. Modelos centrais normalizados podem preservar relacionamentos empresariais, enquanto marts desnormalizados simplificam consultas comuns.
Uma camada semântica fornece definições consistentes para métricas. Sem ela, equipes podem gerar várias cifras de receita ou retenção aparentemente válidas a partir das mesmas linhas. Dados estruturados ainda exigem um significado acordado.
Warehouse, lake e lakehouse
Um data lake normalmente armazena arquivos e dados brutos ou processados diversos em armazenamento de objetos. Um warehouse fornece tabelas analíticas gerenciadas e serviços de consulta. Designs de lakehouse adicionam metadados de tabelas, transações e governança ao armazenamento do lake.
Esses são padrões arquiteturais, não garantias. As organizações costumam combiná‑los por meio de um data fabric ou camada de governança compartilhada. Carga de trabalho, habilidades, interoperabilidade e custo de ciclo de vida importam mais que o rótulo.
Qualidade, segurança e operações
Defina proprietários, contratos, metas de atualidade, linhagem, testes, retenção e acesso a linhas ou colunas. Separe dados pessoalmente identificáveis, use o princípio de menor privilégio e audite consultas sensíveis. Backfills e alterações de esquema requerem procedimentos controlados e observáveis.
Meça atualizações bem‑sucedidas, atraso de dados, falhas de teste, desempenho de consultas, adoção, impacto de incidentes e custo por carga de trabalho. Um warehouse é útil quando as pessoas podem rastrear uma métrica até dados governados e reproduzir o resultado.
Modelagem dimensional e semântica
Uma tabela de fatos registra eventos ou medições periódicas em um nível de granularidade declarado, como uma linha de pedido ou um dispositivo por hora. As dimensões fornecem contexto descritivo. Declarar a granularidade antes de selecionar colunas evita a mistura de níveis que causa dupla contagem. Medidas aditivas podem ser somadas em todas as dimensões; medidas semi‑aditivas exigem cuidado ao longo do tempo.
Chaves substitutas desacoplam o histórico do warehouse dos identificadores de origem que mudam. Dimensões lentamente mutáveis definem como as alterações de atributos são tratadas: sobrescrever, preservar uma nova linha histórica ou manter valores anteriores limitados. O método correto segue a pergunta analítica e as obrigações de retenção.
Uma métrica semântica deve definir fórmula, filtros, comportamento temporal, moeda, exclusões, proprietário e testes. Definições centrais reduzem inconsistências, mas a governança deve permitir mudanças propostas e versionamento. Uma camada semântica única torna‑se um gargalo se os usuários não puderem inspecioná‑la ou estendê‑la de forma responsável.
Arquitetura moderna de armazenamento e consulta
O armazenamento columnar mantém os valores de uma coluna juntos, melhorando a compressão e a varredura apenas dos campos necessários. Particionamento elimina grandes trechos por data ou outra chave; clustering agrupa valores relacionados; visualizações materializadas e caches reutilizam resultados. Más escolhas de partição criam arquivos pequenos, desbalanceamento ou varreduras completas caras.
Motores de consulta massivamente paralelos dividem varreduras, junções e agregações entre workers. O movimento de dados durante junções pode dominar o tempo de execução, portanto distribuição, estatísticas e ordem de junção são importantes. Autoscaling e serviços serverless simplificam a capacidade, mas exigem controle de custos, prioridades de carga de trabalho e limites para consultas descontroladas.
Formatos de tabelas lakehouse adicionam metadados, snapshots, evolução de esquema e semântica de transação sobre arquivos de objetos. Eles melhoram a interoperabilidade, mas introduzem responsabilidades de catálogo e manutenção. Formatos abertos reduzem o lock‑in apenas quando motores de computação, governança e procedimentos operacionais podem realmente utilizá‑los.
Pipelines confiáveis e produtos de dados
Os pipelines devem ser idempotentes ou capazes de reconciliar duplicatas. Watermarks e tempo de evento tratam chegadas tardias; backfills reproduzem transformações históricas; contratos de esquema definem alterações compatíveis. Testes de dados cobrem unicidade, completude, valores aceitos, relacionamentos e invariantes de negócio — não apenas se um job foi executado.
Trate conjuntos de dados importantes como produtos com proprietários, documentação, expectativas de serviço, descobribilidade, suporte e usuários. A linhagem conecta campos de origem através de transformações até os relatórios, tornando o impacto de mudanças e a investigação de incidentes mais rápidas. Políticas de acesso devem ser propagadas ou reavaliadas quando os dados são copiados.
Um programa de warehouse tem sucesso quando as decisões se tornam mais confiáveis e rápidas, não quando o volume de armazenamento cresce. Desative tabelas não utilizadas, exponha custos de consulta e armazenamento, revise acessos sensíveis e meça se as equipes confiam e reutilizam métricas governadas em vez de manter planilhas privadas.
Exemplo prático: projetando um warehouse de análise de vendas
Defina a granularidade do fato como uma linha de pedido concluída, então vincule as dimensões de produto, cliente, canal, promoção, geografia e data por meio de chaves substitutas. Mantenha os eventos de status de pedido em uma tabela de fatos separada, em vez de misturar snapshots e transações. Receita, quantidade, desconto, imposto e custo precisam de moeda explícita, regras de devolução, cancelamento e reconhecimento. A definição da métrica deve gerar a mesma resposta em dashboards, notebooks e reconciliação financeira.
A ingestão captura alterações da fonte, aterrissa dados brutos imutáveis, valida o esquema e os transforma em modelos de staging e dimensionais testados. Atualizações tardias devem corrigir o período histórico adequado sem duplicar fatos. Compare contagens de linhas e totais monetários com os sistemas de origem, teste unicidade e relacionamentos, e registre a linhagem do campo de relatório até a fonte. Backfills utilizam código versionado e validação isolada antes de substituir tabelas confiáveis.
O acesso separa identificadores de cliente de agregados amplamente disponíveis e aplica o princípio de menor privilégio por função e propósito. O gerenciamento de carga de trabalho mantém dashboards executivos responsivos enquanto analistas executam consultas exploratórias. Monitore atualidade, testes falhos, custo de consultas, tabelas não utilizadas e mudanças semânticas. Um warehouse tem sucesso quando métricas governadas suportam decisões repetíveis; simplesmente centralizar dados pode centralizar confusão se propriedade, qualidade e definições permanecerem não resolvidas.
Recuperação de desastres deve especificar cobertura de backup, cópias entre regiões, restauração de catálogo e permissões, perda de dados aceitável e tempo de recuperação. Teste a restauração em um ambiente isolado e verifique as métricas, não apenas os arquivos. Chaves de criptografia, configuração de identidade, código de orquestração e definições semânticas fazem parte do sistema recuperável. Um warehouse que pode restaurar petabytes mas não consegue reproduzir a política de acesso ou cálculos confiáveis não recuperou seu serviço analítico.
Lista de verificação de implementação prática
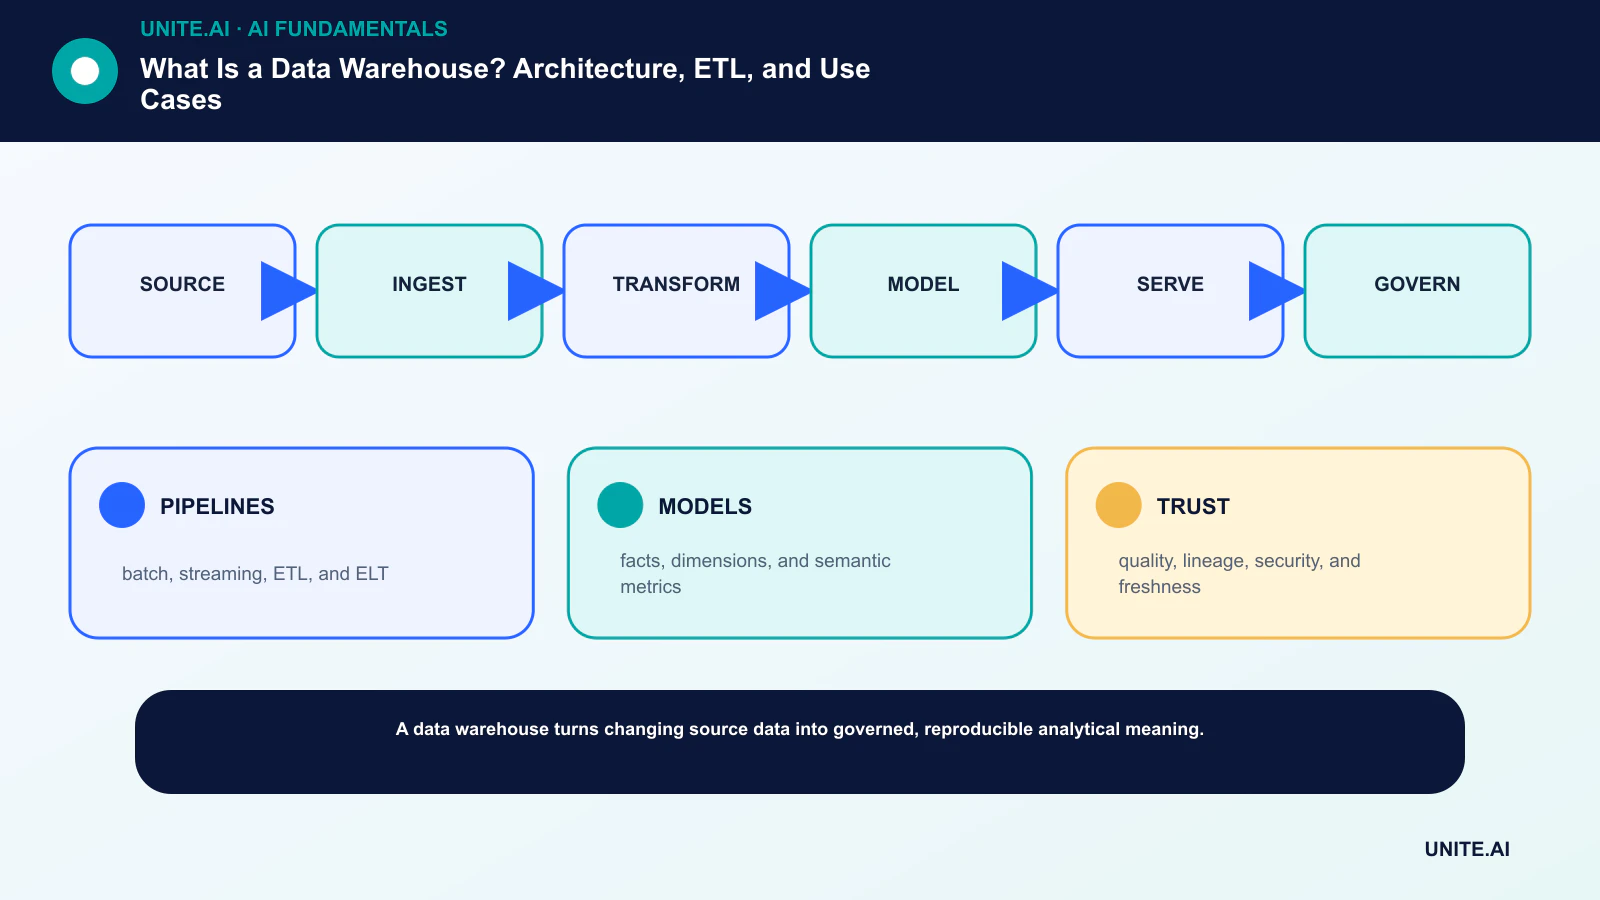
Transforme o conceito em um fluxo de trabalho delimitado e testável: fonte → ingestão → transformação → modelagem → serviço → governança. Nomeie um proprietário responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e interrupção, teste falhas representativas e defina monitoramento, rollback e revisão antes de expandir o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, execute uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever uma saída ou interromper a operação. Reavalie a decisão após a chegada de dados reais, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- PIPELINES: batch, streaming, ETL, e ELT.
- MODELS: fatos, dimensões e métricas semânticas.
- TRUST: qualidade, linhagem, segurança e atualidade.
Perguntas frequentes
Um data warehouse é apenas um grande banco de dados?
É um banco de dados ou plataforma analítica projetada em torno de análise integrada e histórica. Sua modelagem, ingestão, governança e padrões de carga de trabalho diferem de um banco de dados de aplicação transacional.
Uma empresa deve usar ETL ou ELT?
Muitas utilizam ambos. Transforme cedo quando privacidade, validação ou largura de banda exigirem; transforme após o carregamento quando o poder de computação do warehouse e a iteração rápida forem vantajosos.
Referências principais











