
Wywiady
Zaid Al Hamani, CEO i założyciel Boost Security – seria wywiadów

 Dodaj Unite.AI do preferowanych źródeł w Google
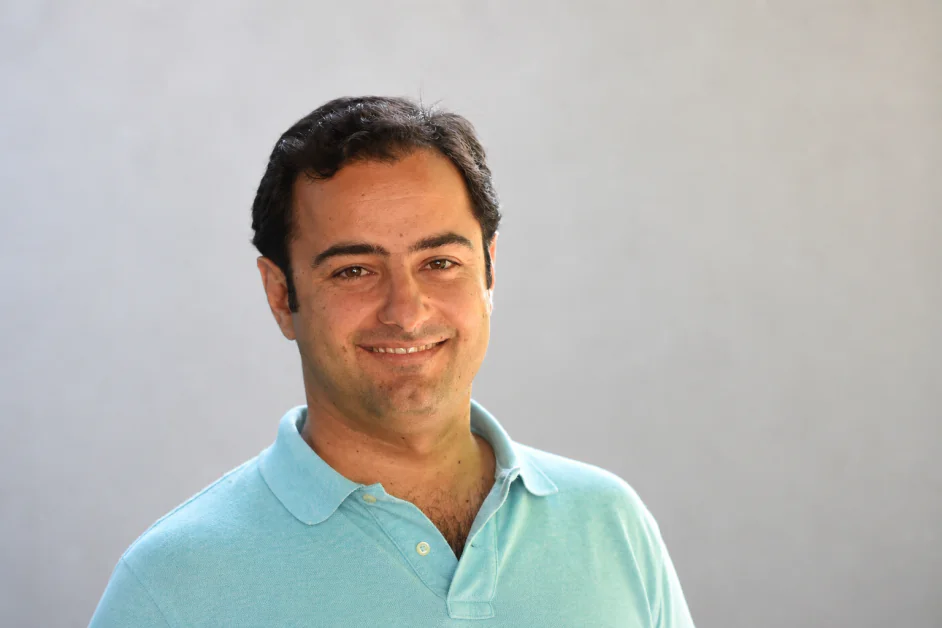
Zaid Al Hamani, CEO i założyciel Boost Security, to lider w dziedzinie cyberbezpieczeństwa i DevSecOps z ponad dwudziestoletnim doświadczeniem w tworzeniu i skalowaniu globalnych operacji technologicznych. Od założenia Boost Security w 2020 roku, skupił się na modernizacji sposobu, w jaki organizacje zabezpieczają rozwój oprogramowania, wykorzystując doświadczenie z poprzednich ról, w tym VP of Application Security w Trend Micro i współzałożyciela/CEO IMMUNIO. Wcześniej zajmował stanowiska kierownicze w Canonical, gdzie kierował produktami, inżynierią i globalnymi inicjatywami wsparcia, oraz w SITA, gdzie zarządzał dużymi, krytycznymi dla misji operacjami IT. Jego kariera odzwierciedla silną historię budowania zespołów, optymalizacji systemów i rozwoju nowoczesnych praktyk bezpieczeństwa.
Boost Security to firma zajmująca się cyberbezpieczeństwem, skupiająca się na zabezpieczaniu nowoczesnego łańcucha dostaw oprogramowania za pomocą platformy DevSecOps dla deweloperów. Technologia integruje się bezpośrednio z potokami CI/CD, aby automatycznie wykrywać, priorytetyzować i rozwiązywać problemy z zabezpieczeniami, redukując manualne obciążenie przy zachowaniu szybkości rozwoju. Poprzez połączenie zabezpieczeń aplikacji i łańcucha dostaw w jeden system, platforma zapewnia pełną widoczność kodu, zależności i infrastruktury, pomagając organizacjom wzmocnić odporność w złożonych, natywnych środowiskach chmurowych.
Poprzednio kierowałeś zabezpieczeniami aplikacji w Trend Micro i byłeś współzałożycielem IMMUNIO. Co skłoniło Cię do założenia Boost Security, a jaki był lukę na rynku, którą byłeś w stanie zidentyfikować wcześnie?
IMMUN.IO było jedną z pierwszych firm RASP, które zostały założone – a nasze doświadczenie do tego momentu było takie, że WAF-y jako technologia zabezpieczeń w czasie wykonywania były niezwykle trudne do utrzymania i nieskuteczne. Wyobrażaliśmy sobie sposób, w jaki WAF-y zostaną zastąpione przez bardziej dokładne i łatwiejsze w utrzymaniu rozwiązanie – poprzez instrumentację aplikacji.
To było w 2012 roku, DevOps wciąż było we wczesnej fazie, a większość zespołów nie stosowała jeszcze Agile, a Kubernetes jeszcze nie istniał.
Trend Micro przejął IMMUN.IO w 2017 roku. Do tego czasu DevOps rozwinął się bardziej: potoki CI/CD, praktyki Agile, szybsze iteracje i cykle wydawnicze, chmura itd. Zespoły programistyczne stały się lepsze w tworzeniu oprogramowania i jego wysyłaniu. Bezpieczeństwo wciąż było jednak złamane:
- Skany są zbyt wolne lub wyniki przychodzą zbyt późno
- Wyniki są zbyt skomplikowane dla deweloperów, aby mogli je wykonać
- Istnieje generalnie nieakceptowalny poziom fałszywych pozytywów
- Wiele nowych typów artefaktów nie jest skanowanych: infrastruktura jako kod, kontenery, API itp.
Tworzenie oprogramowania szybko stało się łatwiejsze. Tworzenie bezpiecznego oprogramowania nadal było trudne.
To był pierwotny problem, który postanowiliśmy rozwiązać. Uczynić DevSecOps skutecznym w świecie rzeczywistym; czy można uzyskać, aby zespół programistyczny łatwo dodał zabezpieczenia do SDLC, z szybkością odpowiadającą nowym standardom prędkości? Czy można to uczynić tak, aby jeden platforma była wszystkim, czego potrzebujesz? Czy można to uczynić tak, aby deweloperzy, a nie tylko przyjęli tę technologię, ale także ją zaakceptowali i zobaczyli korzyści? Czy można to uczynić tak, aby się skalowało, aby nie potrzebować armii specjalistów od bezpieczeństwa, aby nadążyć za ilością napisanego kodu…
Pomogliśmy firmom wstrzyknąć zabezpieczenia do SDLC podczas ery DevOps. To było przechodzenie od 1 do 10. Teraz jesteśmy w erze kodowania agenty – gdzie agenci piszą ogromną ilość kodu – ale jest to fundamentalnie ten sam problem – prędkość i ilość kodu wzrosły z 10 do 100; a naszym celem jest kontynuowanie tej samej trajektorii.
Twierdziłeś, że cykl życia rozwoju oprogramowania (SDLC) zmienił się fundamentalnie w górę. Jaki był moment, w którym zrealizowałeś, że tradycyjne podejścia DevSecOps są już niewystarczające?
To było obserwowanie, w jaki sposób atakujący naprawdę dostają się do systemu. Zawsze widzieliśmy ten sam wzorzec: narażony workflow GitHub Actions, który nikt nie przeglądał od momentu forkowania repozytorium, token z dostępem do chmury produkcyjnej osadzony w konfiguracji uruchamiania, legitymacja CI jobu, która została przechwycona w celu wdrożenia ładunku atakującego. Te ataki stały się znane jako „żyjące z potoku” ataki, ponieważ przeciwnik wykorzystuje Twoją własną automatyzację przeciwko Tobie, z pozwoleniami, które Twoim zespołem bezpieczeństwa już zatwierdził.
Stos DevSecOps, który zbudowaliśmy przez dekadę, nie miał odpowiedzi na to. SAST skanuje źródło aplikacji. SCA skanuje zależności aplikacji. Oba zakładają, że potok uruchamiający je jest godny zaufania. Tymczasem sam potok jest plikiem YAML z poleceniami shell, dostępem do sieci i wrażliwymi poświadczeniami, i prawie nikt go nie przegląda.
Kiedy to staje się najłatwiejszą drogą, możesz wysłać idealnie czysty kod i nadal oddać atakującym Twoją chmurę.
Jak powinny firmy przemyśleć SDLC w świecie, w którym agenci AI generują kod w sposób ciągły, a nie krok po kroku?
Wszyscy musimy przestać myśleć o SDLC jako o sekwencji punktów kontrolnych. Agenci AI skurczyli czas między „ktoś to napisał” a „to jest w produkcji” z tygodni do minut. Stary model zakładał ludzki rytm między przeglądem kodu, SAST, SCA i wdrożeniem, ale już tego nie mamy.
Bezpieczeństwo musi działać tam, gdzie działa agent: na maszynie dewelopera, w kontekście promptu, w połączeniach agenta z serwerami MCP i zewnętrznymi modelami. Zanim kod dotrze do potoku, już straciłeś szansę na jego ukształtowanie. Agent już ściągnął zależność. Model już zobaczył poświadczenie. Przenieś kontrolę w górę, tam gdzie naprawdę wykonuje się pracę.
Wiele organizacji nadal traktuje narzędzia kodowania AI jako warstwy produktywności. Dlaczego uważasz, że reprezentują one całkowicie nową powierzchnię ataku, a nie tylko rozszerzenie istniejących przepływów pracy?
Traktowanie narzędzia kodowania AI jako warstwy produktywności jest jak traktowanie junior developera z dostępem root jako warstwy produktywności. Oznaczenie jest technicznie prawidłowe, ale nie daje żadnego użytecznego ramienia do myślenia o tym, co może się nie udać.
Agent kodowania czyta Twoją gałąź plików, wyłuskuje zmienne środowiskowe w celu uzyskania kontekstu, pobiera zależności z publicznych rejestrów, otwiera połączenia wychodzące do dostawców modeli zdalnych i serwerów MCP, oraz wykonuje polecenia shell. Każda z tych akcji wymagała wcześniej interwencji człowieka. Teraz wszystko to dzieje się w milisekundach, z tymi samymi uprawnieniami, co deweloper, który uruchomił agenta.
To kurczy granice zaufania, które wcześniej były oddzielne: uprawnienia dewelopera, to, co może pobrać zewnętrzne narzędzie, oraz to, co może wykonać niezaufany kod. To tworzy nowe możliwości dla atakujących i punkty ślepe, których obrońcy nawet nie widzą, nie mówiąc już o tym, żeby je bronić.
Boost przedstawia laptop dewelopera jako nowy płaszczyznę kontroli. Jakie ryzyka istnieją na punkcie końcowym, których zespoły bezpieczeństwa obecnie pomijają?
Największym z nich jest inwentaryzacja. Większość zespołów bezpieczeństwa nie jest w stanie powiedzieć, które agenci AI działają na których laptopach, które serwery MCP te agenci są połączone, ani które rozszerzenia IDE są aktualnie wykorzystywane do pobierania zawartości repozytorium. EDR nie ma widoczności w warstwie agenta; SIEM również nie widzi, co ci agenci robią lokalnie. To jest problem cienia IT z uprawnieniami do wykonywania kodu.
Pod tym leży bałagan poświadczeń. Zbudowaliśmy narzędzie open-source o nazwie Bagel, aby uczynić to konkretnym. Typowy laptop dewelopera zawiera tokeny GitHub z dostępem do repozytoriów produkcyjnych, poświadczenia chmury, które mogą uruchomić infrastrukturę, tokeny npm lub PyPI, które mogą opublikować do milionów użytkowników, oraz klucze usług AI, które atakujący sprzedają. Żadne z nich nie jest zabezpieczone w sposób, w jaki zabezpieczony jest CI runner. Ta sama maszyna, która zawiera te poświadczenia, również przegląda internet i instaluje losowe rozszerzenia VS Code.
Połącz oba i masz rzeczywistą powierzchnię ataku. Nieufałomne rozszerzenie działające z uprawnieniami dewelopera w środowisku pełnym kluczy chmury jest celem o najwyższym priorytecie w nowoczesnym przedsiębiorstwie. Większość zespołów jeszcze nie zaczęła się tym zajmować.
Wskazałeś na „pułapkę kontekstu”, w której agenci AI mogą uzyskać dostęp do plików lokalnych, zmiennych środowiskowych i konfiguracji. Jak powszechne jest ryzyko wycieku danych wrażliwych za pomocą promptów, i dlaczego jest tak trudne do wykrycia?
Wystarczająco powszechne, abyśmy traktowali to jako stan domyślny każdego niezarządzanego środowiska deweloperskiego. Każdy agent kodowania, który sprawdziliśmy, agresywnie pobiera kontekst lokalny. Czytają pliki kropkowe, zmienne środowiskowe, ostatnio używane pliki, czasem całe drzewa katalogów i wysyłają ten kontekst do zdalnego modelu. Narzędzia są zaprojektowane, aby działać w ten sposób; agresywne pobieranie kontekstu jest tym, co sprawia, że są użyteczne.
Problem z wykryciem zaczyna się od tego, że ruch z wycieku wygląda identycznie jak normalne użycie produktu. Jest to TLS do api.openai.com lub api.anthropic.com. Pochodzi z zatwierdzonej aplikacji biznesowej. Standardowe DLP widzi dewelopera korzystającego z narzędzia AI, które firma właśnie kupiła. Nie widzi, że jeden ze stringów w tym prompcie jest kluczem AWS, który agent pobrał z półzapomnianego pliku .env w katalogu podrzędnym.
Można to złapać tylko przez zbadanie promptów przed ich opuszczeniem laptopa, co jest dokładnie tym miejscem, w którym prawie żaden stos bezpieczeństwa nie jest obecnie pozycjonowany.
Możesz oprowadzić przez realistyczny scenariusz, w którym agent AI wprowadza lukę w zabezpieczeniach szybciej, niż tradycyjne narzędzia bezpieczeństwa mogą ją zidentyfikować?
Oto jeden, który widzieliśmy wielokrotnie. Deweloper prosi agenta o dodanie funkcji, która wymaga biblioteki retry HTTP. Agent sugeruje nazwę pakietu. Pakiet jest brzmiący prawdopodobnie, ale nie istnieje naprawdę na npm. W ciągu godziny atakujący rejestruje go, wypełnia go działającą logiką retry plus małym skryptem post-install, który czyta ~/.aws/credentials i wysyła zawartość do webhook. Agent uruchamia npm install bez sprawdzania, bo agenci nie sprawdzają reputacji. Poświadczenie znika, zanim deweloper nawet uruchomi kod.
Atak sam w sobie nie jest technicznie zaawansowany, ale tradycyjne zabezpieczenia łańcucha dostaw są zbudowane wokół znanych luk w zabezpieczeniach w znanych pakietach: CVE, SBOM, skanowanie licencji. Ten framework nie ma nic do powiedzenia o pakiecie, który nie istniał, kiedy skanowanie było ostatnio uruchomione, został utworzony specjalnie, aby dopasować się do halucynacji AI, i zostaje spożyty przed jakimikolwiek aktualizacjami feedu zagrożeń.
Okno od publikacji do kompromisu jest teraz mierzone w minutach. Cokolwiek sprawdza po fakcie, sprawdza za późno.
Czy halucynowane zależności stają się jednym z największych ryzyk w rozwoju napędzanym przez AI, i jakie praktyczne kroki mogą podjąć organizacje, aby się bronić przed nimi?
Już nimi są. Atakujący aktywnie monitorują popularne narzędzia AI w celu halucynacji i rejestrują sugerowane nazwy pakietów w ciągu kilku minut. Badacze kilka lat temu, kiedy to się zaczęło dziać, nazwali to slopsquatting, i nazwa się przyjęła. Jak tylko nazwa zależności zostaje często zahalucynowana, siedzenie na niej jest biernym atakiem na łańcuch dostaw z zerowym wysiłkiem.
Praktyczne obrony wyglądają inaczej niż to, co większość zespołów obecnie ma. Zacznij od pobierania. Zablokuj zależności z nazwami podszytych i nowo zarejestrowanych pakietów w momencie, gdy npm install lub pip install są uruchamiane, na maszynie dewelopera, zanim cokolwiek trafi na dysk. Wykrywanie po fakcie w CI nie pomaga, kiedy skrypt post-install już wyeksfiltruje poświadczenie. Następnie dać agentowi barierki, aby działał wewnątrz. Wstrzyknij listę zatwierdzonych zależności bezpośrednio do kontekstu agenta, aby model zobaczył, co jest dozwolone, zanim wygeneruje sugestię. Prośba do deweloperów o pisanie „bezpiecznych promptów” nie jest strategią. Jeśli jesteś strategiczny, oznacza to, że bezpieczeństwo ustawia granicę, a agent ją dziedziczy. I zacznij śledzić Bill of Materials AI. Większość zespołów nie jest w stanie powiedzieć, które agenci, modele i pakiety dotykają których repozytoriów. Nie możesz bronić tego, czego nie możesz inwentaryzować.
Uważasz, że bezpieczeństwo już nie może zaczynać się w CI/CD. Wygląd nowoczesnego potoku bezpieczeństwa, gdy ochrona musi zaczynać się wcześniej w procesie rozwoju?
Jeśli bezpieczeństwo zaczyna się w CI/CD, to scedowałeś całą fazę przed zatwierdzeniem na środowisko, które nie kontrolujesz. Agent już pobrał kontekst, twoje poświadczenie może już być w logach kogoś innego. Skanujesz zwłoki.
Nowoczesny potok zaczyna się na laptopie. To oznacza inwentaryzowanie agentów i rozszerzeń działających tam, walidację, które serwery MCP i modele są dozwolone, sanitarne czyszczenie tego, co opuszcza maszynę, oraz blokowanie pakietów złośliwych przed ich zainstalowaniem. Stamtąd polityka podąża za pracą do IDE. Wstrzykujemy standardy bezpieczeństwa bezpośrednio do kontekstu okna agenta, aby wygenerowany kod pozostał w barierkach od pierwszego tokenu. Potok nadal działa, wykonując ostateczną weryfikację kontroli, które już były egzekwowane na górze.
Potok sam w sobie nie znika. Jego rola staje się weryfikacją: potwierdzeniem, że kontrola na górze była utrzymana.
Jakie są najważniejsze zmiany, które organizacje muszą wprowadzić dzisiaj, aby ich środowiska rozwoju pozostały bezpieczne w ciągu najbliższych kilku lat?
Największy błąd polega na zabezpieczaniu tylko tego, co zostaje zatwierdzone. Najciekawsze ryzyko teraz żyje w ośmiu godzinach przed zatwierdzeniem. Niewidoczna dramatyczna sytuacja może rozegrać się na laptopie, w prompcie lub w instalacji pakietu. Jeśli twoje narzędzia zaczynają się od PR, chronisz niewłaściwą połowę przepływu pracy.
Związane z tym: przestań traktować agenty kodowania jako oprogramowanie produktywne. Są to nie-ludzkie użytkownicy z dostępem do powłoki, uprawnieniami do zapisu w repozytorium i połączeniami sieciowymi. Rządź nimi w taki sam sposób, w jaki rządzisz innymi tożsamościami uprzywilejowanymi, z inwentaryzacją, zatwierdzonymi możliwościami i logami inspekcji.
Ostatnia zmiana jest trudniejsza kulturowo. Większość obecnych „narzędzi bezpieczeństwa AI” prezentuje wyniki i kieruje je do ludzi. Ludzie nie mogą triażować z prędkością, z jaką agenci generują. Cokolwiek przyjmujesz, musi rozwiązywać problemy automatycznie wewnątrz przepływu pracy, z możliwym do śledzenia powodem, lub staje się kolejnym dashboardem, który nikt nie czyta.
Dziękujemy za wspaniały wywiad, czytelnicy, którzy chcą dowiedzieć się więcej, powinni odwiedzić Boost Security.


