
Wywiady
Dr Mathilde Pavis, Kierownik Prawny, OpenOrigins – Seria Wywiadów

 Dodaj Unite.AI do preferowanych źródeł w Google
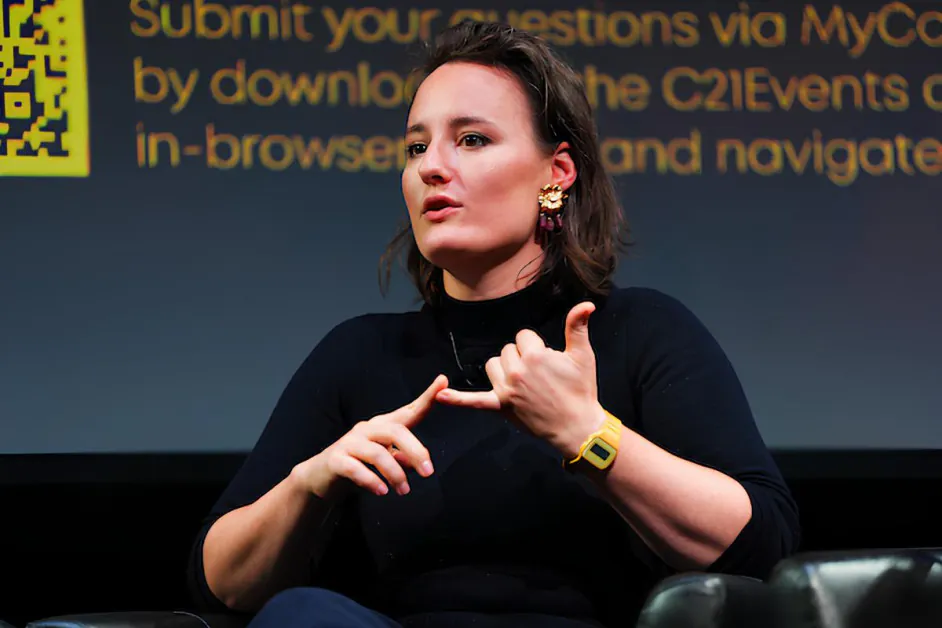
Dr Mathilde Pavis, Kierownik Prawny w OpenOrigins, jest wiodącym ekspertem w dziedzinie regulacji sztucznej inteligencji i zarządzania mediami cyfrowymi, specjalizującym się w głębokich fałszerstwach, syntetycznych mediach i pochodzeniu treści. Doradza firmom, rządom i związkom zawodowym w kwestiach zgodności, licencjonowania i ryzyka w generatywnej sztucznej inteligencji, a także współpracowała z Microsoftem i ElevenLabs nad polityką i strategią sztucznej inteligencji. Doradzała również UNESCO w kwestiach sztucznej inteligencji i własności intelektualnej, a także regularnie dostarcza ekspertów dowodów do brytyjskich decydentów.
OpenOrigins rozwija technologie do walki z dezinformacją i głębokimi fałszerstwami poprzez tworzenie weryfikowalnych, niezmienialnych rekordów cyfrowej treści. Jej platforma koncentruje się na ustanowieniu wyraźnego pochodzenia, umożliwiając mediom, twórcom i platformom udowodnienie, kiedy i jak treść została utworzona, edytowana i rozpowszechniona – coraz bardziej krytyczną zdolnością wraz ze wzrostem zaawansowania syntetycznych mediów i trudnością ich wykrycia.
Masz doświadczenie w doradzaniu rządom, globalnym instytucjom, takim jak UNESCO, oraz firmom, takim jak Microsoft (MSFT ) i ElevenLabs, w kwestiach regulacji sztucznej inteligencji. Co skłoniło Cię do skupienia się na głębokich fałszerstwach, cyfrowych replikach i syntetycznych mediach, a jak ta podróż ukształtowała Twoją decyzję o założeniu Replique?
Moja praca nad głębokimi fałszerstwami nie zaczęła się od samej technologii, ale od znacznie starszej zagadki prawnej. Kiedy zacząłem badać własność intelektualną na potrzeby mojego doktoratu w 2013 roku, zaskoczyło mnie to, jak niewiele ochrony otrzymują wykonawcy w porównaniu z autorami, kompozytorami czy filmowcami. W praktyce oznacza to, że Twoje słowa lub muzyka są lepiej chronione w prawie niż Twój głos, twarz i ciało. To niedopasowanie wydawało mi się dziwne i skłoniło mnie do zadania głębszego pytania: jak kulturowo i prawnie oceniamy pracę kogoś, którego wkładem jest jego twarz, głos i ciało na ekranie?
To pytanie skierowało mnie w stronę praw wykonawców i danych. W tamtym czasie uważano to za wąską dziedzinę o niewielkim znaczeniu komercyjnym. Aktywnie radzono mi, abym przeniósł się do bardziej “lucrative” dziedzin, takich jak patenty lub tradycyjne prawa autorskie. Założono, że kwestie związane z podobizną lub głosem były w dużej mierze zarządzane nieformalnie – poprzez normy branżowe lub “gentlemen’s agreements” w Hollywood. Ale dla mnie ten brak formalnej ochrony sygnalizował lukę, a nie ślepy zaułek dla moich badań, więc kontynuowałem.
Co się zmieniło, to to, że dziś prawie każdy jest wykonawcą. Nasze życie jest pośrednio pośredniczone przez kamery – na telefonach, laptopach, wideokonferencjach i platformach społecznościowych. Niezależnie od tego, czy jest to dla pracy, czy dla użytku osobistego, ludzie ciągle nagrywają i udostępniają wersje siebie. Prawne pytania, które kiedyś dotyczyły głównie aktorów lub muzyków, teraz dotyczą każdego, kto ma smartfona.
Głębokie fałszerstwa nie stworzyły tych problemów – one je tylko ujawniły i przyspieszyły. Badania, które prowadziłem od 2013 roku, nagle stały się pilne. Wokół 2017 i 2018 roku rozwój sieci neuronowych – szczególnie w miejscach takich jak MIT i UC Berkeley – zaczął demonstrować, jak przekonywająco można cyfrowo manipulować twarzą, głosem i ciałem osoby. W ciągu roku ta zdolność stała się powszechnie znana jako “głębokie fałszerstwa” i najpierw zyskała przyczółek w głęboko szkodliwy sposób, szczególnie poprzez niezgodną z prawem treść seksualną wymierzoną w kobiety i dzieci.
Dopiero później pojawiły się implikacje handlowe, gdy branża kreatywna zaczęła przyjmować syntetyczne media. To jest moment, kiedy umowne i ekonomiczne pytania, nad którymi pracowałem, wyszły na pierwszy plan. Prawie z dnia na dzień to, co było uważane za w dużej mierze teoretyczną lub doktrynalną dziedzinę prawa, stało się bardzo praktyczną, komercyjnie znaczącą i społecznie pilną dziedziną.
W swojej istocie prawne wyzwanie nie uległo zmianie: ludzie chcą dzielić się aspektami siebie, ale jednocześnie zachować znaczącą kontrolę. Istniejące ramy mają trudności z tym subtelnością. Tendencja do traktowania osób jako albo całkowicie prywatnych, albo całkowicie publicznych – albo chronionych, albo fair game. Ale większość ludzi istnieje gdzieś pomiędzy. To napięcie jest teraz centralne nie tylko dla profesjonalnych wykonawców, ale dla każdego uczestniczącego w cyfrowym życiu.
Zostałem uznany za kogoś, kto badał i pracował w tej dziedzinie, co skłoniło mnie do współpracy z rządami zainteresowanymi ochroną ludzi przed głębokimi fałszerstwami, a także firmami, które chcą uczynić produkty cyfrowego klonowania bezpiecznymi do użycia, takimi jak ElevenLabs. W Replique wniosłem wszystko, czego nauczyłem się, do ludzi i firm, które chcą używać technologii cyfrowego klonowania lub cyfrowej repliki w sposób odpowiedzialny i bezpieczny. Podstawowo przekształciłem moje “niebieskie niebo” badania w firmę doradczą, która dostarcza specjalistyczne porady prawne branży kreatywnej.
Jako Kierownik Prawny w OpenOrigins, firmie skupiającej się na ustanowieniu niezmienialnego rekordu pochodzenia treści w celu walki z głębokimi fałszerstwami, jak widzisz systemy oparte na pochodzeniu konkurujące lub zastępujące tradycyjne podejścia do wykrywania głębokich fałszerstw?
Porównywanie narzędzi do wykrywania głębokich fałszerstw może szybko stać się porównaniem jabłek i pomarańczy, ponieważ ich skuteczność zależy od kontekstu i celu. Z punktu widzenia polityki potrzebujemy szeregu komplementarnych narzędzi – nie ma jednego “najlepszego” rozwiązania, a OpenOrigins jest tylko częścią tego szerszego ekosystemu. Tam, gdzie technologia OpenOrigins wyróżnia się jako rozwiązanie do wykrywania głębokich fałszerstw, są sytuacje, w których twórca treści lub organizacja informacyjna musi udowodnić autentyczność treści, którą udostępnia partnerom, publiczności lub ogółowi.
Poprzez zapewnienie weryfikowalnego pochodzenia i “potwierdzeń” w momencie tworzenia, oferuje silną formę prewencji, demonstrując, że treść nie jest głębokim fałszerstwem. Jednakże, to podejście jest mniej przydatne dla codziennych użytkowników internetu, którzy chcą szybko ocenić treść, którą napotkali w sieci. W takich przypadkach wykrywanie opiera się bardziej na metodach probabilistycznych i analizie treści niż na weryfikacji opartej na pochodzeniu. Potrzebujemy różnych narzędzi dla różnych potrzeb i musimy zaakceptować, że nie ma srebrnej kuli przeciw głębokim fałszerstwom.
Z punktu widzenia prawnego, jaka jest obecnie największa luka w sposobie, w jaki jurysdykcje radzą sobie z wyrażaniem zgody i własnością w treści generowanej lub replikowanej przez sztuczną inteligencję?
Och, jak długo masz? Odpowiedzi zależą od tego, co rozumie się przez treść generowaną lub replikowaną przez sztuczną inteligencję. Problemy różnią się, czy spoglądasz na obraz sztucznie wygenerowany domu lub kota. Czy cyfrową rekreację twarzy osoby lub jej głosu. Zatrzymajmy się na temacie głębokich fałszerstw i cyfrowych replik, i odpowiem na Twoje pytanie w kontekście “cyfrowego klonowania”.
W kwestii zgody, podstawowym problemem jest to, że większość umów – czy to umów o pracę, czy warunków platform – zawiera szerokie, niejasne klauzule, które przyznają rozległe prawa do treści użytkowników. Mogą one być interpretowane jako forma “tylnych drzwi” zgody, gdzie zgoda na warunki może być uznana za zgodę na użycie takie jak klonowanie, chociaż większość ludzi będzie silnie kwestionować tę interpretację. To tworzy znaczącą lukę pomiędzy interpretacją prawną a oczekiwaniami użytkowników, co obecnie korzysta firmom, podczas gdy regulacja pozostaje w tyle.
W kwestii własności, nie ma wyraźnej odpowiedzi prawnej na to, kto włada cyfrową repliką, ponieważ istniejące ramy, takie jak ochrona danych, prawa autorskie i prawa osobiste, nie zostały zaprojektowane z myślą o tej technologii. Dziś większość ludzi jest skanowana i klonowana w pracy, na życzenie i z finansowaniem pracodawcy lub klienta. I te podmioty zwykle oczekują wysokiego stopnia kontroli nad tym aktywem, co jest zrozumiałe, ale często problematyczne, ponieważ ten aktyw jest cyfrową imitacją Twojej twarzy lub głosu i może powodować, że mówisz rzeczy, których nigdy nie mówiłeś, lub robisz rzeczy, których nigdy nie robiłeś.
Pytanie “kto włada Twoim klonem?” jest bardzo ważne, a odpowiedź pozostaje nieznana w prawie dzisiaj.
Pracowałeś ściśle nad technologiami klonowania głosu. Jakie są najbardziej niezrozumiane ryzyka prawne związane z syntetycznymi głosami, zarówno dla firm, jak i osób?
Najbardziej niezrozumiany problem w zgodności prawnej jest balans pomiędzy komercyjnym zainteresowaniem finansowaniem i eksploatowaniem cyfrowej repliki a prawem jednostki do prywatności i cyfrowej godności. To napięcie leży w wielu prawnych reżimach (głównie własności intelektualnej, ochrony danych i prywatności), które nigdy nie zostały zaprojektowane, aby działać razem i interpretują klonowanie w zasadniczo różny sposób. W efekcie, tłumaczenie tego na praktyczne, przyjazne dla biznesu praktyki jest skomplikowane i często niejasne. Firmy albo pomijają kluczowe ryzyka, albo ponoszą znaczne koszty, aby je właściwie rozpoznać. To powoduje niesprawiedliwy wynik, w którym odpowiednia zgodność staje się trudniejszym, bardziej kosztownym ścieżką, zamiast domyślną.
Jak powinny przedsiębiorstwa myśleć o architekturze zgody w systemach sztucznej inteligencji, szczególnie podczas radzenia sobie z podobizną, tożsamością i danymi szkoleniowymi?
Firmy powinny projektować swoje systemy wokół trzech podstawowych możliwości. Po pierwsze, muszą zapewnić poinformowaną, kontekstową zgodę podczas wstępnego uruchomienia. Po drugie, muszą umożliwić użytkownikom wycofanie tej zgody i usunięcie części lub wszystkich ich danych, co jest technicznie wyzwaniem i często pomijane, ale niezbędne do zgodności z prawami, takimi jak brytyjska i unijna RODO i podobne reżimy w USA. Utrzymywanie zgody w czasie oznacza budowanie systemów, w których wycofanie jest operacyjnie gładkie i zgodne z modelem biznesowym.
Zgoda musi być szczegółowa. I po trzecie, użytkownicy powinni móc zarządzać uprawnieniami na poziomie poszczególnych plików, aktualizować swoje dane podobizny i rozumieć, w jaki sposób są one wykorzystywane. To wymaga przejrzystości i kontroli – narzędzi, które pozwalają użytkownikom monitorować, przeglądać i moderować, w jaki sposób ich cyfrowe repliki są wdrożone. Ten poziom elastyczności jest nadal rzadki, ale to tam, gdzie leży przewaga konkurencyjna.
W Twoim doświadczeniu, doradzając zarówno startupom, jak i rządom, gdzie jest największa luka pomiędzy tym, jak sztuczna inteligencja jest budowana, a tym, jak jest regulowana?
Luka pomiędzy tym, jak sztuczna inteligencja jest budowana, a tym, jak jest regulowana, sprowadza się do fundamentalnie różnych misji. Rządy regulują w interesie publicznym, podczas gdy firmy sztucznej inteligencji (często wspierane przez venture capital) są napędzane głównie przez wzrost, przychody i zysk. Te priorytety nie zawsze są w konflikcie, ale często ciągną w różne strony, z regulacjami postrzeganymi jako ograniczenie, a nie wsparcie.
To tworzy strukturalne napięcie: regulatorzy i innowatorzy działają z różnymi motywacjami, wartościami i nawet językami. To sprawia, że wyrównanie jest trudne w praktyce, nawet jeśli nie jest to niemożliwe. Zaczynamy widzieć nową falę firm technologicznych, które coraz bardziej wyrównują się z celami interesu publicznego, ale nadal są one wyjątkiem, a nie regułą – szczególnie wśród tych, które skutecznie się skalują.
OpenOrigins koncentruje się na weryfikowaniu treści w momencie tworzenia przy użyciu kryptograficznego pochodzenia. Jak krytyczne jest to podejście “pierwotne” w porównaniu z zabezpieczeniami po dystrybucji?
To łączy się z moją odpowiedzią powyżej. Uwierzytelnianie treści w momencie tworzenia, “w górę strumienia” jest znacznie bardziej skuteczne niż próba weryfikacji jej w momencie dystrybucji lub konsumpcji, czyli “w dół strumienia”. Uwierzytelnianie treści w momencie tworzenia jest jak śledzenie żywności od momentu, gdy jest uprawiana na farmie, a nie próba ustalenia, skąd pochodzi, patrząc tylko na to, co jest na talerzu. Jeśli wiesz, gdzie kurczak został wyhodowany, jak był traktowany i jak przeszedł przez łańcuch dostaw, możesz ufać temu, co jesz. Jeśli zamiast tego próbujesz wywnioskować wszystko to, patrząc tylko na gotowe danie, polegasz na przypuszczeniach. To samo dotyczy odróżniania treści stworzonej przez człowieka i generowanej przez sztuczną inteligencję w sieci: pochodzenie w źródle daje weryfikowalną gwarancję, podczas gdy wykrywanie “w dół strumienia” jest niezbędnie bardziej niepewne i reaktywne.
Jaką rolę widzisz dla standardów, takich jak C2PA, w przyszłości mediów, i czy są one wystarczające same w sobie, aby przywrócić zaufanie online?
C2PA to mile widziana inicjatywa, i w wielu ways wspiera ten sam ruch na rzecz autentyczności treści, co OpenOrigins. Są one ważną częścią ekosystemu bezpieczeństwa treści i autentyczności treści. Jak każde narzędzie bezpieczeństwa, nie ma srebrnej kuli.
Dla twórców i talentów w branżach, takich jak film, muzyka i gry, jakie praktyczne kroki powinni podjąć dzisiaj, aby chronić się przed nieautoryzowaną replikacją cyfrową?
Artyści dzisiaj stają w obliczu dwóch odrębnych ryzyk: replikacji ich pracy (takiej jak muzyka, obrazy lub pisanie) i replikacji ich podobizny, w tym twarzy, głosu i ciała. Z minimalnym wkładem systemy sztucznej inteligencji mogą teraz odtworzyć obie z wysokim stopniem wierności. W praktyce ochrona zaczyna się od tego, aby być świadomym tego, co się udostępnia w sieci, uznając, że każda opublikowana treść może być pobrana i wykorzystana w zestawach danych szkoleniowych, często bez wyraźnej zgody lub widoczności.
To ryzyko jest teraz podstawową rzeczywistością działania w sieci. Ale bardziej bezpośrednie i kontrolowane ryzyko często leży w umowach. Umowy, które artyści zawierają ze swoimi współpracownikami, dystrybutorami lub platformami, mogą zawierać klauzule, które pozwalają na użycie sztucznej inteligencji, ponowne użycie lub odsprzedaż treści do celów szkoleniowych – często bez znaczącego udziału w przychodach.
Dla artystów to sprawia, że ścisła kontrola umów jest kluczowa. Zrozumienie, w jaki sposób ich praca i podobizna mogą być wykorzystywane, licencjonowane lub ponownie wykorzystywane, jest teraz tak samo ważne, jak sam proces twórczy. Większość debaty (wśród związków, organizacji branżowych i platform) koncentruje się na skorygowaniu tego dysbalansu i zapewnieniu, że twórcy zachowują kontrolę i sprawiedliwą rekompensatę.
Więc dwa kluczowe porady: bądź ostrożny, co udostępniasz w sieci, i czytaj umowy oraz szukaj klauzul związanych ze sztuczną inteligencją, zanim je podpiszesz.
Spójrzając w przyszłość, trzy do pięciu lat, czy uważasz, że osiągniemy punkt, w którym każdy kawałek cyfrowej treści musi posiadać weryfikowalne pochodzenie, czy zaufanie pozostanie fragmentowane na platformach i jurysdykcjach?
Chciałbym powiedzieć tak, ale realistycznie, nie – nie w ciągu pięciu lat. W technologiach pięć lat wydaje się długo; w kwestii zmiany zachowania i nawyków użytkowników jest to bardzo krótko. Większość konsumentów nie będzie opierać swoich decyzji na tym, czy treść posiada uwierzytelnione pochodzenie. Platformy zazwyczaj podążają za popytem użytkowników, optymalizując pod kątem zaangażowania, a nie pochodzenia.
To mogłoby się zmienić, jeśli regulacja interweniuje. Zaczynamy widzieć wczesne ruchy w miejscach takich jak Kalifornia, gdzie wymagania dotyczące oznaczeń i moderacji zaczynają się pojawiać, ale skalowanie tego na poziomie globalnym zajmie czas – prawdopodobnie bliżej dziesięciu lat niż pięciu.
Inną dziedziną zmian jest sektorowa: branże, takie jak dziennikarstwo, finanse, ubezpieczenia i opieka zdrowotna, mogą zacząć wymagać pochodzenia i uwierzytelnienia, ponieważ zaufanie jest podstawowym dla ich operacji.
Na koniec, konsumenci mogą nie dbać o informacje o pochodzeniu w krótkim terminie, ale mogą dbać o jakość treści i jakość informacji. Jeśli treść generowana przez sztuczną inteligencję stanie się zbyt jednorodna lub “nijaka”, widownia może zacząć bardziej cenić treść tworzoną przez ludzi. To mogłoby spowodować segmentację rynku, z niektórymi platformami priorytetowo traktującymi skalę i treść generowaną przez sztuczną inteligencję, a innymi – kurującymi autentyczność, pochodzenie i materiały o wysokim zaufaniu, prowadzone przez ludzi – ale ten zwrot pozostaje nieznany. Dziękuję za Twoje wspaniałe odpowiedzi, czytelnicy, którzy chcą dowiedzieć się więcej, powinni odwiedzić OpenOrigins.


