
Podstawy AI
Czym jest kompromis uprzedzenia‑wariancji? Wyjaśnienie niedopasowania i przetrenowania
Wymiana bias‑wariancja opisuje napięcie między modelami zbyt sztywnymi, by uchwycić rzeczywistą strukturę, a modelami reagującymi zbyt silnie na konkretną próbkę treningową. Ten przewodnik wyjaśnia mechanizm, kompromisy, ocenę oraz kontrole istotne w praktyce.

 Dodaj Unite.AI do preferowanych źródeł w Google
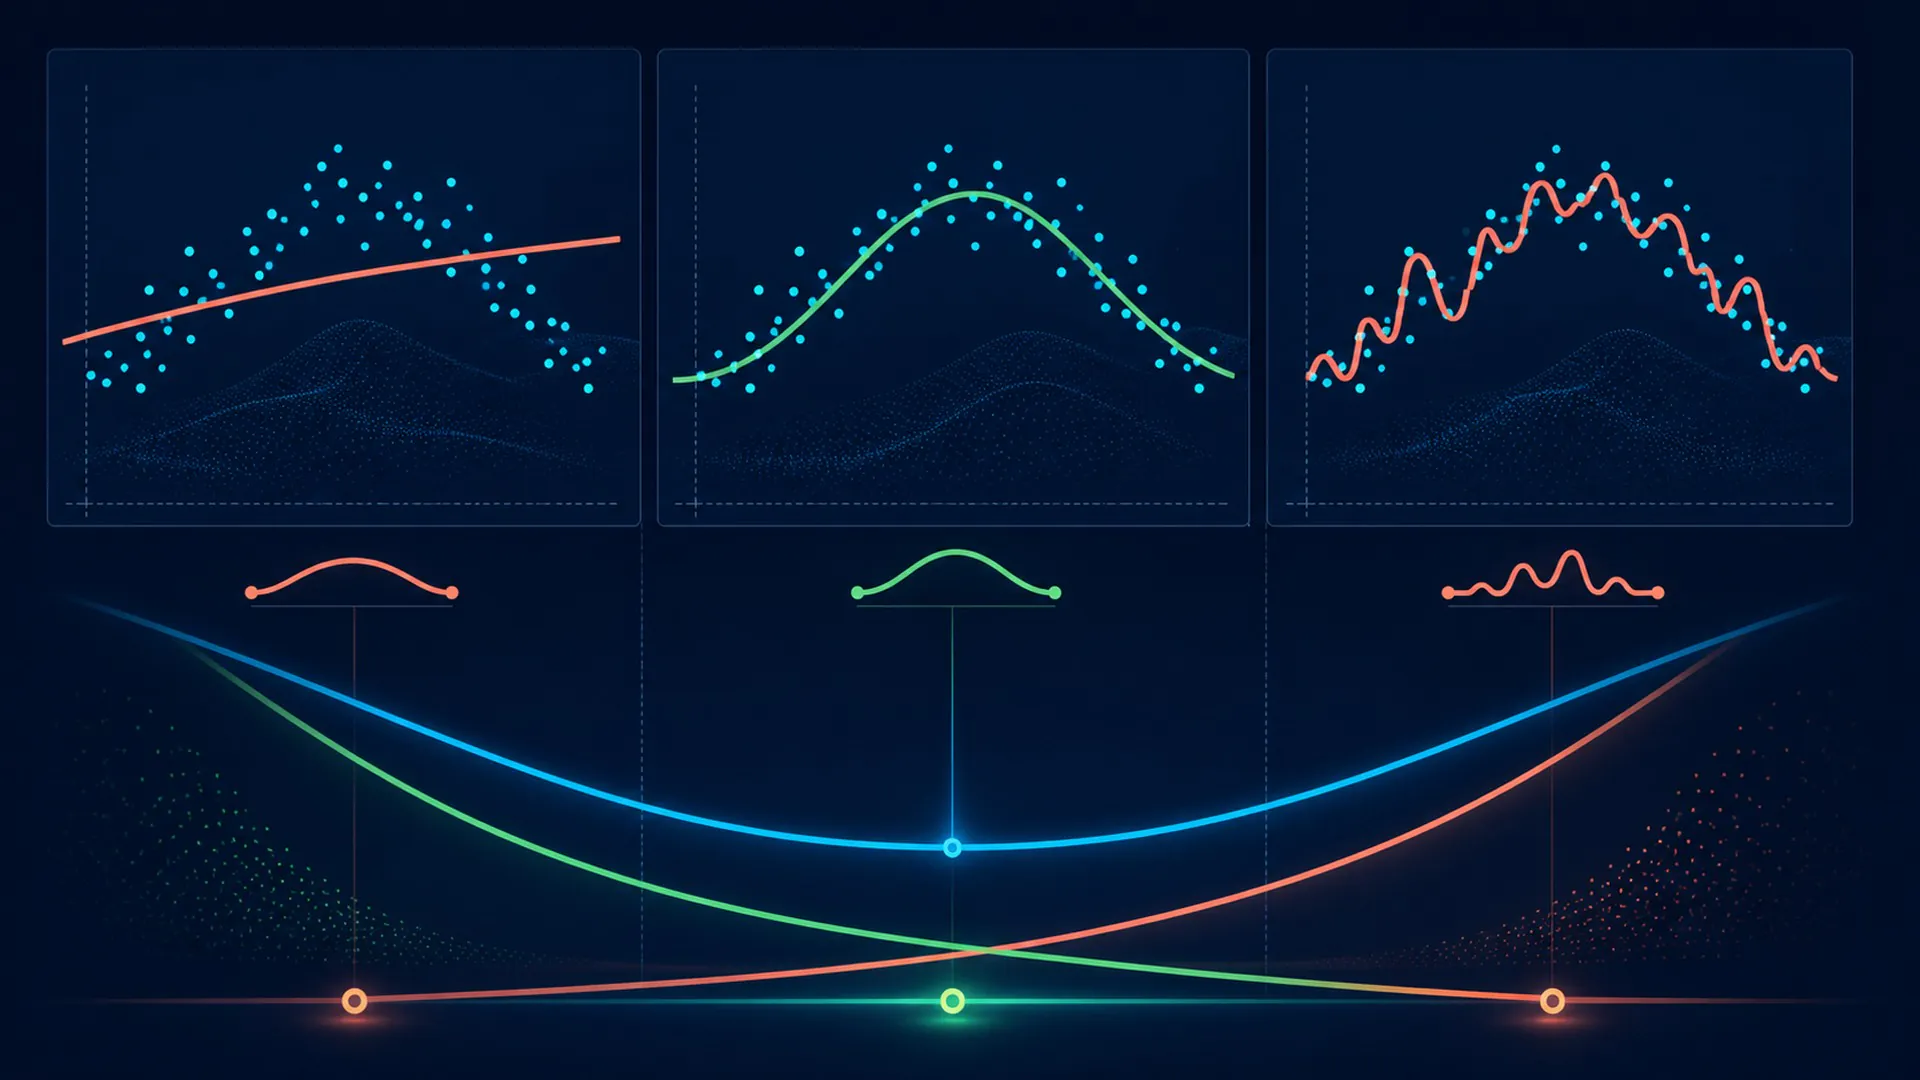
Kompromis uprzedzenia‑wariancji opisuje napięcie między modelami, które są zbyt sztywne, aby uchwycić rzeczywistą strukturę, a modelami, które reagują zbyt silnie na konkretną próbkę treningową.
Kompromis uprzedzenia‑wariancji wymaga precyzyjnego wyjaśnienia, ponieważ jego nazwa wskazuje na określony przepływ informacji, wybór treningu, mechanizm w czasie wykonywania lub granicę zarządzania. Traktowanie go jako synonimu „zaawansowanej sztucznej inteligencji” czyni roszczenia niemożliwymi do przetestowania. Ten przewodnik śledzi koncepcję od jej danych wejściowych i założeń, przez obserwowalny wynik, a następnie testuje skrót najczęściej mylony z nią.
Kompromis uprzedzenia‑wariancji: definicja, granica i cel
Kompromis uprzedzenia‑wariancji opisuje napięcie między modelami, które są zbyt sztywne, aby uchwycić rzeczywistą strukturę, a modelami, które reagują zbyt silnie na konkretną próbkę treningową. Definicja zawiera trzy praktyczne zobowiązania: istnieje rozpoznawalny input, transformacja lub decyzja charakterystyczna dla kompromisu uprzedzenia‑wariancji oraz wynik, który można ocenić względem określonego celu. Jeśli którykolwiek z tych elementów brakuje, etykieta może opisywać aspirację, a nie wdrożony mechanizm.
Uczenie statystyczne przekształca skończone próbki w twierdzenia o przyszłych danych. Dlatego podział, optymalizacja, regularizacja, metryki i monitorowanie są częścią jednego problemu uogólniania, a nie odrębnymi technikami podręcznikowymi. W kontekście kompromisu uprzedzenia‑wariancji taki systemowy pogląd ma znaczenie, ponieważ wydajność może zależeć od otaczających danych, interfejsów, sprzętu, uprawnień i osób, nawet gdy podstawowy model pozostaje niezmieniony. Użyteczne wyjaśnienie oddziela więc wyuczone zachowanie modelu od produktu, który decyduje, kiedy, gdzie i z jakim upoważnieniem to zachowanie jest wykorzystywane.
Najbliższym mylącym skrótem jest społeczne lub demograficzne znaczenie uprzedzenia w odpowiedzialnej sztucznej inteligencji. Może ono dzielić widoczną cechę z kompromisem uprzedzenia‑wariancji, lecz zmienia narrację przyczynową: inne dowody potwierdziłyby sukces, inne zasoby zdominowałyby koszty, a inne kontrole zapobiegałyby szkodom. Granica jest więc operacyjna, a nie terminologiczna.
Pięciostopniowa mapa operacyjna kompromisu uprzedzenia‑wariancji
Diagram jest zwartą mapą przyczynowo-skutkową dla kompromisu uprzedzenia‑wariancji, a nie twierdzeniem, że każda implementacja używa pięciu komponentów oprogramowania. Niektóre systemy łączą etapy, inne powtarzają je w pętli. Mapa pozostaje użyteczna, ponieważ wymusza, aby każda zmiana informacji lub upoważnienia miała właściciela, wejście, wyjście i test.
1. Dopasowanie modelu o ograniczonej lub elastycznej pojemności: dane wejściowe i założenia w kompromisie uprzedzenia‑wariancji
Na tym etapie kompromisu uprzedzenia‑wariancji system musi dopasować model o ograniczonej lub elastycznej pojemności. Istotne pytanie nie dotyczy jedynie tego, czy operacja się odbywa, ale jakie informacje ona zużywa, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od społecznego lub demograficznego znaczenia uprzedzenia w odpowiedzialnej sztucznej inteligencji oraz odtworzyć jej wynik przy tych samych określonych warunkach.
Przejście do tego etapu kompromisu uprzedzenia‑wariancji zaczyna się od określonego celu i powinno zakończyć się wynikiem, który umożliwia pomiar błędu treningowego i testowego. Należy zarejestrować niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelkie ludzkie lub programowe kontrole zastosowane na granicy. Ten ślad pozwala zespołom wykryć, czy niski błąd treningowy może maskować kruchą uogólnialność, zanim ta sama słabość przełoży się na istotny wynik.
2. Pomiar błędu treningowego i testowego: reprezentacja lub decyzja w kompromisie uprzedzenia‑wariancji
Na tym etapie kompromisu uprzedzenia‑wariancji system musi zmierzyć błąd treningowy i testowy. Istotne pytanie nie dotyczy jedynie tego, czy operacja się odbywa, ale jakie informacje ona zużywa, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od społecznego lub demograficznego znaczenia uprzedzenia w odpowiedzialnej sztucznej inteligencji oraz odtworzyć jej wynik przy tych samych określonych warunkach.
Przejście do tego etapu kompromisu bias‑variance rozpoczyna się od dopasowania modelu o ograniczonej lub elastycznej pojemności i powinno zakończyć się wynikiem, który może wspierać diagnozowanie systematycznego niedopasowania w porównaniu z niestabilnością. Rejestruj niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelką kontrolę ludzką lub programową zastosowaną na granicy. Ten ślad jest miejscem, w którym zespoły mogą wykryć, czy niski błąd treningowy może ukrywać kruchą generalizację, zanim ta sama słabość doprowadzi do istotnego wyniku.
3. Diagnozowanie systematycznego niedopasowania versus niestabilności: charakterystyczna transformacja w kompromisie bias‑variance
Na tym etapie kompromisu bias‑variance system musi diagnozować systematyczne niedopasowanie w porównaniu z niestabilnością. Przydatne pytanie nie dotyczy jedynie tego, czy operacja zachodzi, ale jakie informacje ona zużywa, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od społecznego lub demograficznego znaczenia biasu w odpowiedzialnej sztucznej inteligencji oraz odtworzyć jej wynik przy tych samych określonych warunkach.
Przejście do tego etapu kompromisu bias‑variance rozpoczyna się od pomiaru błędu treningowego i testowego i powinno zakończyć się wynikiem, który może wspierać dostosowanie cech, danych, regularizacji lub pojemności. Rejestruj niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelką kontrolę ludzką lub programową zastosowaną na granicy. Ten ślad jest miejscem, w którym zespoły mogą wykryć, czy niski błąd treningowy może ukrywać kruchą generalizację, zanim ta sama słabość doprowadzi do istotnego wyniku.
4. Dostosowanie cech, danych, regularizacji lub pojemności: granica ograniczeń i weryfikacji w kompromisie bias‑variance
Na tym etapie kompromisu bias‑variance system musi dostosować cechy, dane, regularizację lub pojemność. Przydatne pytanie nie dotyczy jedynie tego, czy operacja zachodzi, ale jakie informacje ona zużywa, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od społecznego lub demograficznego znaczenia biasu w odpowiedzialnej sztucznej inteligencji oraz odtworzyć jej wynik przy tych samych określonych warunkach.
Przejście do tego etapu kompromisu bias‑variance rozpoczyna się od diagnozowania systematycznego niedopasowania w porównaniu z niestabilnością i powinno zakończyć się wynikiem, który może wspierać powtarzanie na reprezentatywnych próbkach. Rejestruj niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelką kontrolę ludzką lub programową zastosowaną na granicy. Ten ślad jest miejscem, w którym zespoły mogą wykryć, czy niski błąd treningowy może ukrywać kruchą generalizację, zanim ta sama słabość doprowadzi do istotnego wyniku.
5. Powtarzanie na reprezentatywnych próbkach: wynik, informacja zwrotna i zasada zatrzymania w kompromisie bias‑variance
Na tym etapie kompromisu bias‑variance system musi powtarzać proces na reprezentatywnych próbkach. Przydatne pytanie nie dotyczy jedynie tego, czy operacja zachodzi, ale jakie informacje ona zużywa, jaki stan zmienia i jakie dowody potwierdzają, że zmiana była prawidłowa. Recenzent powinien być w stanie odróżnić tę operację od społecznego lub demograficznego znaczenia biasu w odpowiedzialnej sztucznej inteligencji oraz odtworzyć jej wynik przy tych samych określonych warunkach.
Przejście do tego etapu kompromisu bias‑variance rozpoczyna się od dostosowania cech, danych, regularizacji lub pojemności i powinno zakończyć się wynikiem, który może wspierać monitorowanie lub ostateczną decyzję. Rejestruj niepewność, odrzucone alternatywy, zużycie zasobów oraz wszelką kontrolę ludzką lub programową zastosowaną na granicy. Ten ślad jest miejscem, w którym zespoły mogą wykryć, czy niski błąd treningowy może ukrywać kruchą generalizację, zanim ta sama słabość doprowadzi do istotnego wyniku.
Przeglądaj mapę kompromisu bias‑variance w przód, aby zrozumieć produkcję, i w tył, aby diagnozować awarie. Analiza w przód pyta, w jaki sposób jeden etap dostarcza kolejny. Analiza wstecz zaczyna się od niepoprawnego, wolnego, kosztownego lub niebezpiecznego wyniku i śledzi, które wcześniejsze założenie je umożliwiło. Odwrócona ścieżka jest często miejscem, w którym zespół odkrywa, że decydujący błąd wystąpił przed wygenerowaniem czegokolwiek przez model.
Przykład zastosowanego kompromisu bias‑variance
Prosta linia niedopasowuje się do zakrzywionej zależności, podczas gdy bardzo falista krzywa zapamiętuje szum; średnia złożoność może lepiej generalizować.
Ten przykład jest pouczający, ponieważ kompromis bias‑variance można powiązać z obserwowalnymi danymi wejściowymi, stanami pośrednimi i wynikiem, zamiast oceniać go na podstawie dopracowanej demonstracji. Rygorystyczny test stworzyłby zwykłe, trudne i celowo wprowadzające w błąd przypadki wokół scenariusza, zachowałby bazę odniesienia bez tej techniki oraz zarejestrował zarówno średnią wydajność, jak i nasilenie poszczególnych niepowodzeń.
Zmień jedno założenie w przykładzie kompromisu bias‑variance i powtórz analizę. Usuń wymaganą zmienną wejściową, wprowadź sprzeczny sygnał, ogranicz moc obliczeniową, zmień populację użytkowników lub zmusz system do wstrzymania się. Mechanizm, który odnosi sukces tylko w jednej starannie przygotowanej demonstracji, nie wykazał, że generalizuje się do środowiska operacyjnego.
Kompromis bias‑variance vs. najczęstsze skrócenie
Kompromis bias‑variance jest często sprowadzany do społecznego lub demograficznego znaczenia biasu w odpowiedzialnej sztucznej inteligencji. To uproszczenie usuwa granicę definiującą pojęcie. Może to prowadzić nabywców do porównywania nieporównywalnych produktów, badaczy do przerysowywania tego, co eksperyment wykazuje, oraz operatorów do monitorowania niewłaściwego sygnału po wdrożeniu.
| Soczewka | Praktyczna odpowiedź |
|---|---|
| Definicja | Kompromis bias‑variance opisuje napięcie pomiędzy modelami, które są zbyt sztywne, aby uchwycić rzeczywistą strukturę, a modelami, które reagują zbyt silnie na konkretną próbkę treningową. |
| Zamieszanie | społeczne lub demograficzne znaczenie uprzedzenia w odpowiedzialnej sztucznej inteligencji. |
| Ryzyko | niski błąd treningowy może ukrywać kruchą generalizację. |
Porównanie powinno również określić jednostkę analizy. Artykuł dotyczący kompromisu bias‑variance może izolować model lub algorytm, podczas gdy wdrożona usługa dodaje wyszukiwanie, routowanie, buforowanie, polityki, tożsamość, interfejsy użytkownika i monitorowanie. Dwa produkty mogą używać tego samego nazewnictwa, jednocześnie implementując różne części tego stosu. Należy zapytać, który komponent wykonuje definiującą transformację i które inne komponenty są niezbędne dla zgłoszonego wyniku.
Dlaczego kompromis bias‑variance ma znaczenie w współczesnych systemach AI
Kompromis bias‑variance jest teraz istotny, ponieważ systemom AI przydzielane są szersze konteksty, więcej modalności, większa moc obliczeniowa w czasie działania, szerszy dostęp do narzędzi oraz głębsze powiązania z decyzjami organizacyjnymi. W takich warunkach to, co kiedyś wydawało się szczegółem badawczym, może decydować o opóźnieniach, bezpieczeństwie, dostępności, kosztach środowiskowych, jakości produktu lub odpowiedzialności prawnej.
Istotnym wskaźnikiem nie jest to, czy kompromis bias‑variance może wygenerować jeden imponujący wynik. Liczy się, czy technika poprawia rezultat istotny w reprezentatywnych warunkach i robi to skuteczniej niż prostsza podstawa. Należy raportować rozkłady, kategorie awarii, opóźnienia w ogonie, zużycie zasobów oraz dotknięte podgrupy, zamiast kompresować wszystkie wyniki do jednej średniej.
Wybieraj procedury na podstawie struktury danych i kosztu decyzji. Zachowuj grupy i czas, kwantyfikuj niepewność, analizuj podzbiory, blokuj ostateczne testy i weryfikuj, czy zyski offline przetrwają wdrożenie. Zastosowane konkretnie do kompromisu bias‑variance, to podejście czyni dowody przenośnymi: inny zespół może ocenić, czy deklarowany zysk przetrwa przy innym modelu, języku, platformie sprzętowej, zestawie danych, populacji użytkowników lub tolerancji ryzyka.
Korzyści, które może przynieść kompromis bias‑variance
Najsilniejszym powodem użycia kompromisu bias‑variance jest to, że może on bezpośrednio rozwiązać zamierzone wąskie gardło. W zależności od implementacji, korzyść może przejawiać się lepszym osadzeniem, bardziej wierną reprezentacją, ulepszoną generalizacją, niższym opóźnieniem, zmniejszonym ruchem pamięci, jaśniejszą odpowiedzialnością lub bezpieczniejszą granicą między propozycją modelu a rzeczywistym działaniem.
Korzyści powinny być wyrażane jako decyzje i pomiary. „Bardziej inteligentny” nie jest kryterium akceptacji dla kompromisu bias‑variance. Przydatny cel może określać współczynnik błędów w trudnych przypadkach, odzyskiwanie po sprzecznych dowodach, koszt na określonym percentylu ruchu, czas przeglądu przez człowieka, kalibrację lub procent działań utrzymywanych w ramach określonego limitu uprawnień.
Tryb awarii definiujący kompromis bias‑variance
Głównym ograniczeniem jest to, że niski błąd treningowy może ukrywać kruchą generalizację. Ta awaria nie jest dopiero późniejszym dodatkiem po zakończeniu rozwoju. Powinna kształtować zbieranie danych, architekturę, uprawnienia, ocenę, bramki wydania i monitorowanie kompromisu bias‑variance od samego początku.
Kontrola wymiany bias‑wariancja jest użyteczna tylko wtedy, gdy działa przed kosztownym lub nieodwracalnym skutkiem. Zidentyfikuj najwcześniejszy obserwowalny prekursor awarii, ustal próg lub regułę, przydziel odpowiedzialnego właściciela i przetestuj odzyskiwanie. W zależności od przypadku użycia odzyskiwanie może oznaczać wstrzymanie się, powrót do prostszego systemu, żądanie dodatkowych dowodów, eskalację do osoby, przywrócenie poprzedniego modelu lub całkowite zatrzymanie działania.
Plan oceny wymiany bias‑wariancja
Rozpocznij ocenę wymiany bias‑wariancja, zapisując decyzję, którą ma wspierać dowód. Zdefiniuj populację operacyjną, konsekwencję błędnego wyniku, informacje faktycznie dostępne w momencie decyzji oraz najprostszy wiarygodny alternatywny wariant. To zapobiega przekształceniu benchmarku w cel jedynie dlatego, że jest łatwy do przeprowadzenia.
Użyj niezmienionego zestawu testowego do kontrolowanych porównań, a następnie zweryfikuj wymianę bias‑wariancja w etapowym środowisku operacyjnym. Ocena offline sprawia, że warianty są porównywalne; tryb cieniowy, kanarki, limity szybkości lub bramki zatwierdzające ujawniają, jak rzeczywisty ruch, pętle sprzężenia zwrotnego i ludzie zmieniają zachowanie. Etap wdrożenia powinien mieć wyraźny warunek zatrzymania, zamiast zakładać, że każda poprawa zasługuje na pełne wdrożenie.
Zwersjonuj wejścia niezbędne do odtworzenia wymiany bias‑wariancja: dane źródłowe, przetwarzanie wstępne, tokenizator lub enkoder, wagi modelu, konfigurację, prompt lub politykę, indeks wyszukiwania, zestaw oceny, założenia sprzętowe oraz kod serwujący, o ile ma zastosowanie. Bez śladu pochodzenia zespół nie może stwierdzić, czy zmieniony wynik wynika z techniki, środowiska czy niezauważonej modyfikacji potoku.
Na koniec zapytaj, które odkrycie obaliłoby twierdzenie, że wymiana bias‑wariancja pomaga. Jeśli żaden wynik nie mógłby odwrócić decyzji o przyjęciu, ocena jest marketingowa. Wstępnie ustalone progi akceptacji i zachowany zestaw potwierdzający zamieniają ćwiczenie w dowód.
Pytania do zadania przed przyjęciem wymiany bias‑wariancja
- Cel: Jakie mierzalne wąskie gardło ma rozwiązywać wymiana bias‑wariancja?
- Mechanizm: Który z pięciu etapów zawiera charakterystyczną transformację?
- Podstawa: Jak to się ma do społecznego lub demograficznego znaczenia biasu w odpowiedzialnej AI lub innej prostszej alternatywy?
- Dane: Jakie przypadki zwykłe, trudne, adwersarialne i podgrupowe zostały przetestowane?
- Operacje: Jakie koszty opóźnień, pamięci, obliczeń, energii, utrzymania i przeglądu pojawiają się w skali?
- Ryzyko: Jak zespół wykryje, że niski błąd treningowy może maskować kruchą generalizację?
- Odzyskiwanie: Czy system może wstrzymać się, powrócić, cofnąć lub eskalować przed szkodą?
Podstawowe źródła do badania wymiany bias‑wariancja
Autorytatywne punkty wyjścia dla części stosu AI otaczającej kompromis bias‑variance obejmują przewodnik wyboru modelu scikit-learn, Google Rules of ML, NIST AI RMF. Przeczytaj je wraz z dokumentacją dotyczącą konkretnego modelu, zestawu danych, sprzętu i jurysdykcji. Ogólne źródło może definiować mechanizm, ale tylko dowody specyficzne dla wdrożenia mogą potwierdzić, że dana implementacja jest odpowiednia.
Co warto zapamiętać o wymianie bias‑wariancja
Wymiana bias‑wariancja jest określonym mechanizmem w ramach większego systemu społeczno‑technicznego. Jej wartość wynika z poprawy konkretnego wyniku pod wyraźnymi warunkami, a nie z samej nazwy. Mapę pięciu etapów ukazuje przepływ informacji, porównanie wskazuje, czym nie jest, a ścieżka kontroli pokazuje, gdzie odpowiedzialny operator może interweniować.
Praktyczna zasada wymiany bias‑wariancja polega na określeniu celu, porównaniu z wiarygodną bazą, przetestowaniu najważniejszej awarii oraz zachowaniu dowodów niezbędnych do monitorowania zmian. Gdy te elementy są obecne, koncepcja staje się wyborem inżynieryjnym i zarządczym, który można ocenić. Bez nich pozostaje obiecującą nazwą powiązaną z nieznanym ryzykiem operacyjnym.


