
Kąt Andersona
W stronę czasu rzeczywistego: AI‑ludzie dzięki renderowaniu Neural Lumigraph

 Dodaj Unite.AI do preferowanych źródeł w Google
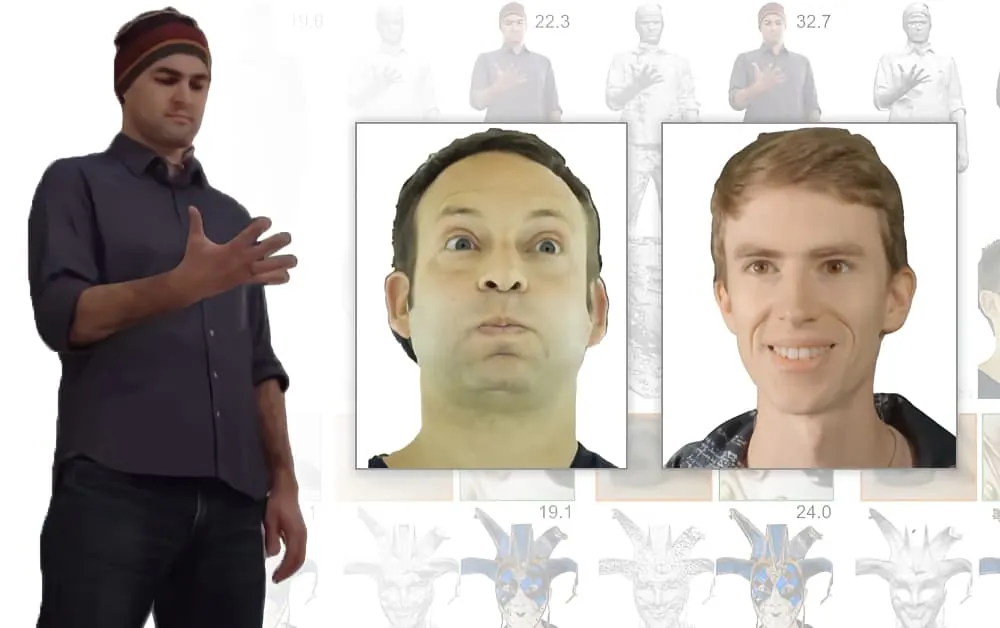
Pomimo obecnej fali zainteresowania Neural Radiance Fields (NeRF), technologią zdolną do tworzenia generowanych przez SI środowisk i obiektów 3D, to nowe podejście do syntezy obrazu wciąż wymaga znacznego czasu treningu i nie posiada implementacji umożliwiającej interfejsy w czasie rzeczywistym o wysokiej responsywności.
Jednak współpraca kilku imponujących podmiotów z przemysłu i środowiska akademickiego proponuje nowe podejście do tego wyzwania (ogólnie znane jako Novel View Synthesis, czyli NVS).
Badanie artykuł, zatytułowane Neural Lumigraph Rendering, twierdzi poprawę względem stanu techniki o około dwa rzędy wielkości, co stanowi kilka kroków w kierunku renderowania CG w czasie rzeczywistym przy użyciu pipeline’ów uczenia maszynowego.

Neural Lumigraph Rendering (right) offers better resolution of blending artifacts, and improved handling of occlusion over previous methods. Source.
Choć w podziękowaniach do artykułu wymieniono jedynie Stanford University oraz firmę technologiczną Raxium zajmującą się wyświetlaczami holograficznymi (obecnie działającą w trybie ukrytym), współtwórcy to główny architekt uczenia maszynowego w Google, informatyk w Adobe (ADBE ) oraz CTO w StoryFile (która niedawno pojawiła się w nagłówkach z AI‑wersją Williama Shatnera).
W odniesieniu do niedawnej kampanii medialnej wokół Shatnera, StoryFile wydaje się wykorzystywać NLR w nowym procesie tworzenia interaktywnych, generowanych przez SI bytów opartych na cechach i historiach poszczególnych osób.
StoryFile przewiduje zastosowanie tej technologii w wystawach muzealnych, interaktywnych narracjach online, wyświetlaczach holograficznych, rzeczywistości rozszerzonej (AR) oraz dokumentacji dziedzictwa – a także wydaje się rozważać potencjalne nowe zastosowania NLR w rozmowach rekrutacyjnych i aplikacjach wirtualnych randek:

Proposed uses from an online video by StoryFile.
Wolumetryczne przechwytywanie dla interfejsów i wideo syntezy nowych widoków
Zasada wolumetrycznego przechwytywania, opisanej w licznych publikacjach na ten temat, polega na wykonywaniu zdjęć lub nagrań wideo obiektu i wykorzystaniu uczenia maszynowego do „wypełnienia” punktów widzenia, które nie zostały objęte pierwotną siatką kamer.
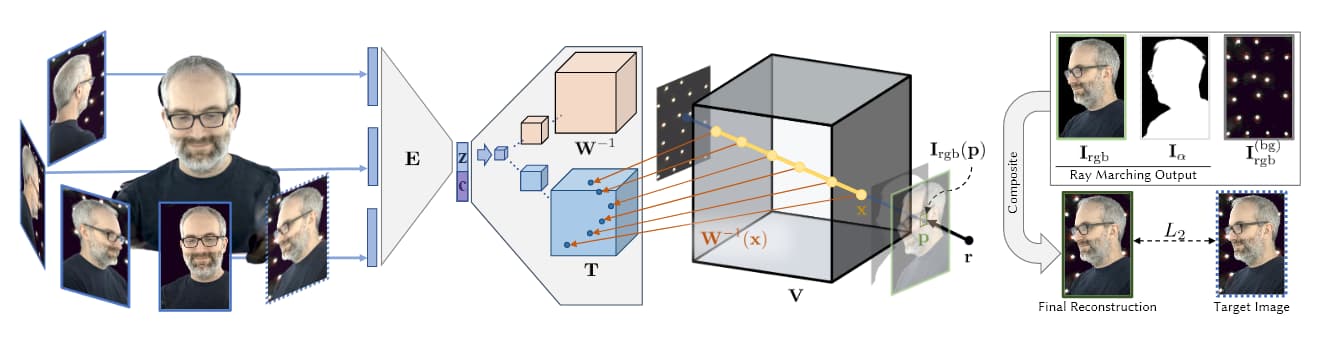
Source: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
Na powyższym obrazie, pochodzącym z badań AI Facebooka z 2019 roku (zobacz poniżej), widzimy cztery etapy wolumetrycznego przechwytywania: wiele kamer rejestruje obrazy/nagrania; architektura enkodera/dekodera (lub inne architektury) oblicza i łączy względność widoków; algorytmy ray‑marchingu wyliczają voxele (lub inne jednostki geometryczne XYZ) każdego punktu w przestrzeni wolumetrycznej; a (w najnowszych publikacjach) odbywa się trening w celu syntezy pełnego bytu, który może być manipulowany w czasie rzeczywistym.
To właśnie ta często rozbudowana i wymagająca dużej ilości danych faza treningowa dotąd uniemożliwiała syntezę nowych widoków w czasie rzeczywistym lub przy wysokiej responsywności przechwytywania.
Fakt, że Novel View Synthesis tworzy kompletną mapę 3D przestrzeni wolumetrycznej, oznacza, że stosunkowo łatwo jest połączyć te punkty w tradycyjną siatkę generowaną komputerowo, skutecznie odtwarzając i animując CGI‑człowieka (lub dowolny inny względnie ograniczony obiekt) w locie.
Podejścia wykorzystujące NeRF opierają się na chmurach punktów i mapach głębokości, aby generować interpolacje pomiędzy rzadkimi punktami widzenia urządzeń przechwytujących:
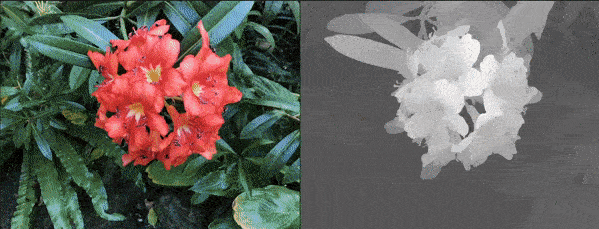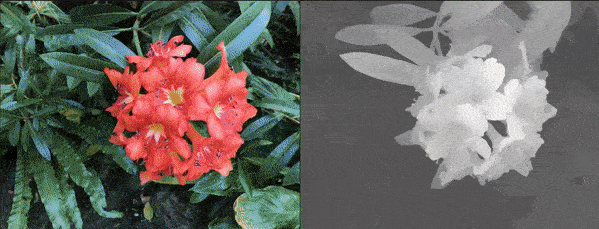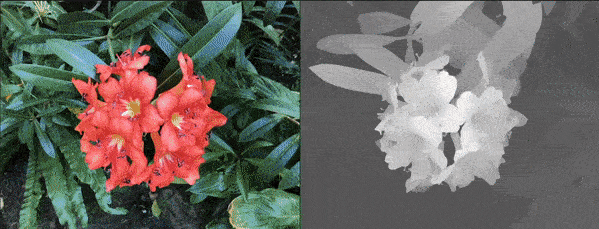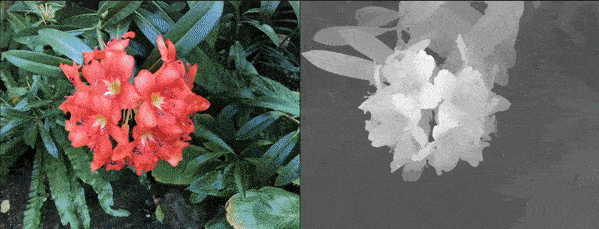
NeRF can generate volumetric depth through calculation of depth maps, rather than generation of CG meshes. Source: https://www.youtube.com/watch?v=JuH79E8rdKc
Choć NeRF jest zdolny do obliczania siatek, większość implementacji nie wykorzystuje tego do generowania scen wolumetrycznych.
Natomiast podejście Implicit Differentiable Renderer (IDR), opublikowane przez Instytut Weizmann w październiku 2020 roku, opiera się na wykorzystaniu informacji o siatce 3D automatycznie generowanej z zestawów przechwytujących:
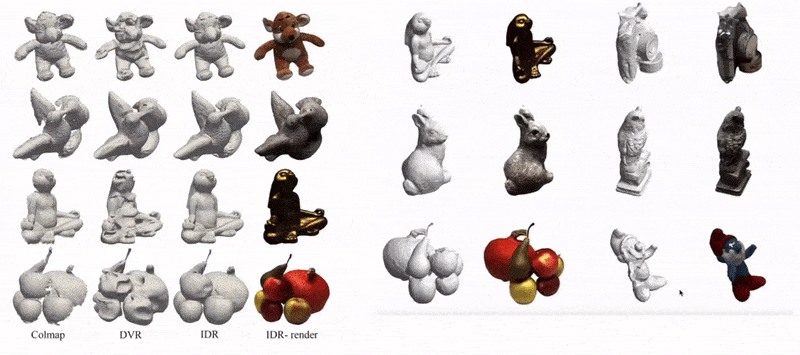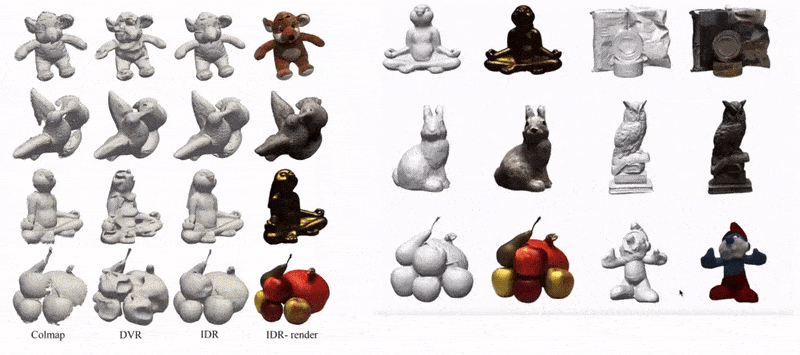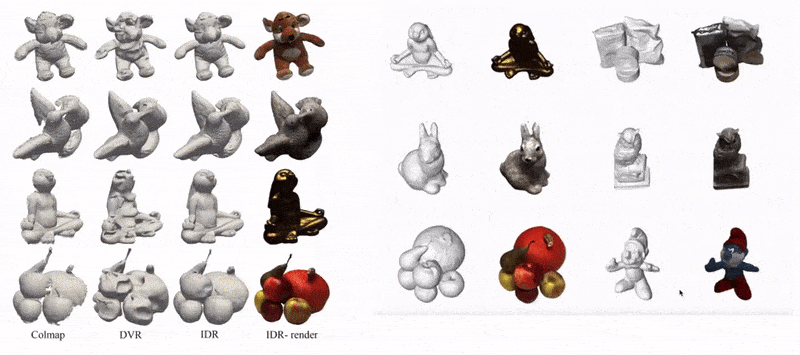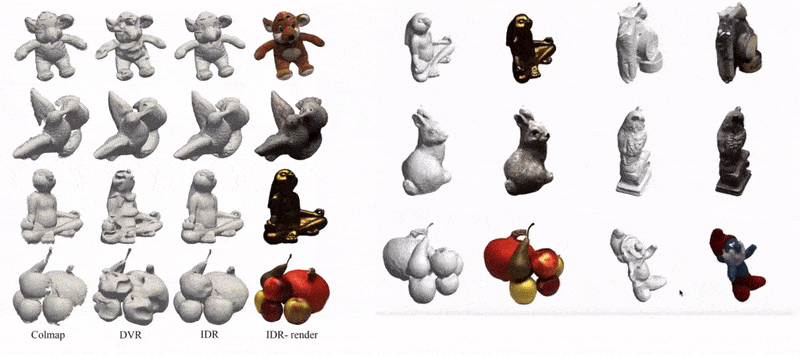
Examples of IDR captures turned into interactive CGI meshes. Source: https://www.youtube.com/watch?v=C55y7RhJ1fE
Podczas gdy NeRF nie posiada zdolności IDR do szacowania kształtu, IDR nie dorównuje jakości obrazu NeRF, a oba wymagają rozbudowanych zasobów do treningu i zestawiania (choć ostatnie innowacje w NeRF zaczynają rozwiązywać ten problem).

NLR’s Custom camera rig featuring 16 GoPro HERO7 and 6 central Back-Bone H7PRO cameras. For ‘real time’ rendering, these operate at a minimum of 60fps. Source: https://arxiv.org/pdf/2103.11571.pdf
Zamiast tego Neural Lumigraph Rendering wykorzystuje SIREN (Sinusoidal Representation Networks) do połączenia zalet obu podejść w własnym frameworku, którego celem jest generowanie wyników bezpośrednio użytecznych w istniejących pipeline’ach grafiki w czasie rzeczywistym.
SIREN był wykorzystywany w podobnych implementacjach w ciągu ostatniego roku i obecnie stanowi popularne wywołanie API dla hobbystów w społecznościach syntezy obrazu; jednak innowacją NLR jest zastosowanie SIREN‑ów do dwuwymiarowego nadzoru obrazów z wielu widoków, co jest problematyczne ze względu na tendencję SIREN do generowania nadmiernie dopasowanych, a nie uogólnionych wyników.
Po wyodrębnieniu siatki CG z obrazów z zestawu, siatka jest rasteryzowana przy użyciu OpenGL, a pozycje wierzchołków siatki mapowane na odpowiednie piksele, po czym obliczane jest mieszanie różnych map wkładowych.
Otrzymana siatka jest bardziej uogólniona i reprezentatywna niż siatka NeRF (zobacz obraz poniżej), wymaga mniej obliczeń i nie nakłada nadmiernych detali na obszary (np. gładką skórę twarzy), które nie mogą z tego skorzystać:

Source: https://arxiv.org/pdf/2103.11571.pdf
Po stronie negatywnej, NLR nie posiada jeszcze możliwości dynamicznego oświetlenia ani relighting, a wynik jest ograniczony do map cieni i innych aspektów oświetlenia uzyskanych w czasie przechwytywania. Badacze zamierzają rozwiązać ten problem w przyszłych pracach.
Dodatkowo, w artykule przyznano, że kształty generowane przez NLR nie są tak dokładne jak niektóre alternatywne podejścia, takie jak Pixelwise View Selection for Unstructured Multi-View Stereo czy badania Instytutu Weizmann wspomniane wcześniej.
Wzrost wolumetrycznej syntezy obrazu
Idea tworzenia bytów 3D z ograniczonej serii zdjęć przy użyciu sieci neuronowych sięga czasów przed NeRF, a wizjonerskie publikacje pochodzą już z 2007 roku lub wcześniej. W 2019 roku dział badań AI Facebooka wydał przełomowy artykuł, Neural Volumes: Learning Dynamic Renderable Volumes from Images, który po raz pierwszy umożliwił responsywne interfejsy dla syntetycznych ludzi generowanych przy użyciu wolumetrycznego przechwytywania opartego na uczeniu maszynowym.
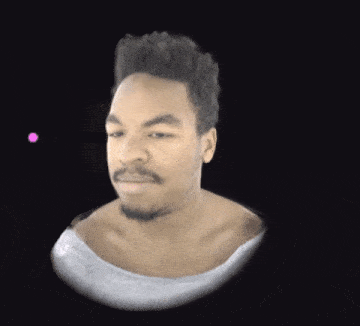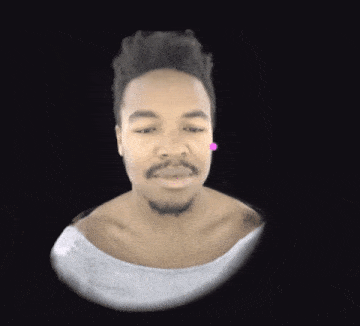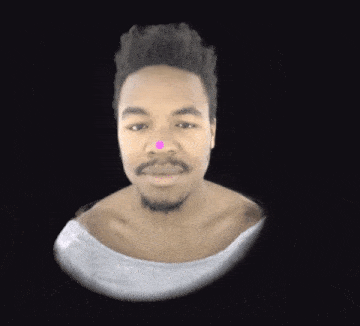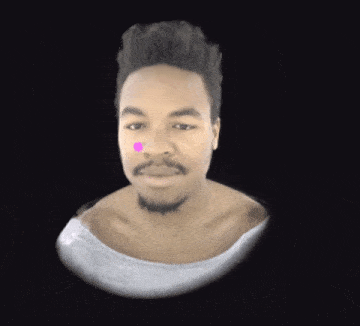
Facebook’s 2019 research enabled the creation of a responsive user interface for a volumetric person. Source: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/
przetłumacz na język polski


