
AGI i przyszłość AI
Rola baz danych wektorowych w nowoczesnych aplikacjach generatywnych AI

 Dodaj Unite.AI do preferowanych źródeł w Google

Aby duże aplikacje sztucznej inteligencji działały skutecznie, potrzebują dobrego systemu do obsługi dużej ilości danych. Jednym z takich ważnych systemów jest baza danych wektorowych. To, co odróżnia tę bazę danych, to jej zdolność do radzenia sobie z różnymi typami danych, takimi jak tekst, dźwięk, obrazy i filmy, w postaci wektorów/numerów.
Czym są bazy danych wektorowe?
Baza danych wektorowa to specjalistyczny system magazynowania zaprojektowany do efektywnej obsługi wektorów o wysokiej wymiarowości. Te wektory, które można uznać za punkty w wielowymiarowej przestrzeni, często reprezentują osadzenia lub skompresowane reprezentacje bardziej złożonych danych, takich jak obrazy, tekst lub dźwięk.
Bazy danych wektorowe umożliwiają szybkie wyszukiwania podobieństwa między tymi wektorami, co pozwala na szybkie odzyskiwanie najbardziej podobnych elementów z ogromnego zbioru danych.
Tradycyjne bazy danych vs. bazy danych wektorowe
Bazy danych wektorowe:
- Obsługa danych o wysokiej wymiarowości: Bazy danych wektorowe są zaprojektowane do zarządzania i przechowywania danych w przestrzeniach o wysokiej wymiarowości. Jest to szczególnie przydatne w aplikacjach takich jak uczenie maszynowe, gdzie punkty danych (takie jak obrazy lub tekst) mogą być reprezentowane jako wektory w wielowymiarowych przestrzeniach.
- Optymalizacja dla wyszukiwania podobieństwa: Jedną z wybitnych cech baz danych wektorowych jest ich zdolność do wykonywania wyszukiwań podobieństwa. Zamiast wyszukiwania danych na podstawie dokładnych dopasowań, te bazy danych pozwalają użytkownikom odzyskać dane, które są “podobne” do danego zapytania, co sprawia, że są one niezwykle cenne w zadaniach takich jak odzyskiwanie obrazów lub tekstu.
- Skalowalność dla dużych zbiorów danych: W miarę jak aplikacje sztucznej inteligencji i uczenia maszynowego rosną, rośnie również ilość danych, które przetwarzają. Bazy danych wektorowe są zaprojektowane do skalowania, co pozwala im radzić sobie z ogromnymi ilościami danych bez pogarszania wydajności.
Tradycyjne bazy danych:
- Przechowywanie danych strukturalnych: Tradycyjne bazy danych, takie jak relacyjne bazy danych, są zaprojektowane do przechowywania danych strukturalnych. Oznacza to, że dane są zorganizowane w predefiniowane tabele, wiersze i kolumny, co zapewnia integralność i spójność danych.
- Optymalizacja dla operacji CRUD: Tradycyjne bazy danych są przede wszystkim zoptymalizowane do operacji CRUD. Oznacza to, że są one zaprojektowane do efektywnego tworzenia, odczytywania, aktualizowania i kasowania wpisów danych, co sprawia, że są one odpowiednie dla szerokiego zakresu aplikacji, od usług internetowych po oprogramowanie przedsiębiorstw.
- Stała struktura: Jedną z cech charakterystycznych wielu tradycyjnych baz danych jest ich stała struktura. Po zdefiniowaniu struktury bazy danych, wprowadzanie zmian może być skomplikowane i czasochłonne. Ta sztywność zapewnia spójność danych, ale może być mniej elastyczna niż struktura bezschematowa lub dynamiczna niektórych nowoczesnych baz danych.
Tradycyjne bazy danych często mają trudności ze złożonością osadzeń — wyzwaniem, z którym radzą sobie bazy danych wektorowych.
Reprezentacje wektorowe
Kluczowym elementem funkcjonowania baz danych wektorowych jest podstawowa koncepcja reprezentowania różnych form danych za pomocą wektorów numerycznych. Weźmy na przykład obraz. Gdy widzimy zdjęcie kota, może to być dla nas po prostu zdjęcie kota, ale dla maszyny może być ono przekształcone w unikalny wektor 512-wymiarowy, taki jak:
[0,23, 0,54, 0,32, …, 0,12, 0,45, 0,90]
Z bazami danych wektorowymi aplikacje sztucznej inteligencji mogą robić więcej rzeczy. Mogą one wyszukiwać informacje na podstawie znaczenia i pamiętać rzeczy przez długi czas. Co ciekawe, ta metoda nie jest ograniczona tylko do obrazów. Dane tekstowe wypełnione kontekstowymi i semantycznymi znaczeniami mogą również być umieszczone w postaci wektorów.
Generatywne AI i potrzeba baz danych wektorowych
Generatywna AI często wykorzystuje osadzenia. Weźmy na przykład osadzanie słów w przetwarzaniu języka naturalnego (NLP). Słowa lub zdania są przekształcane w wektory, które ujmują znaczenie semantyczne. Podczas generowania tekstów podobnych do ludzkich modele muszą szybko porównywać i odzyskiwać odpowiednie osadzania, aby zapewnić, że wygenerowany tekst zachowuje kontekstowe znaczenia.
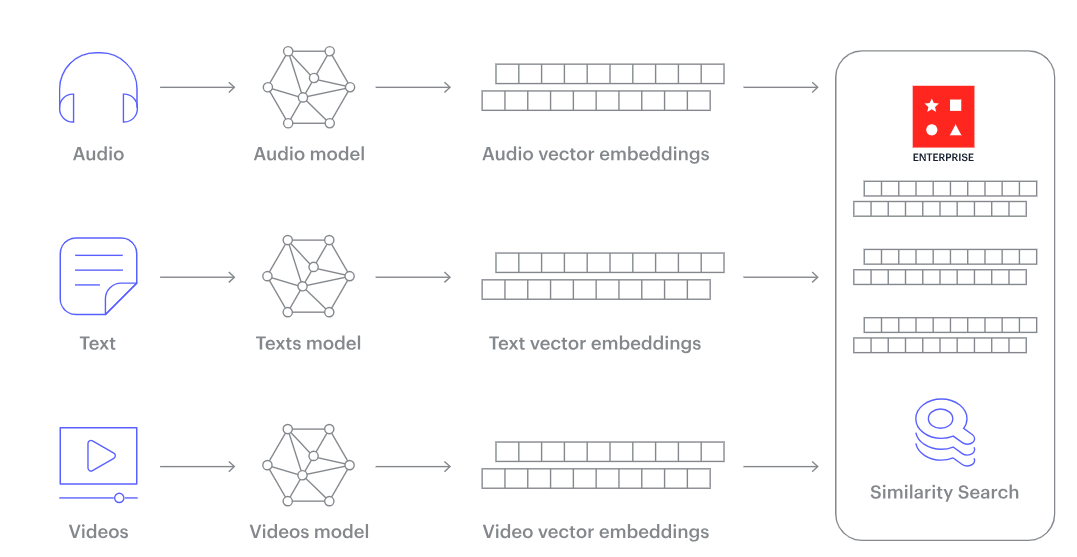
Podobnie, w przypadku generowania obrazów lub dźwięku osadzanie odgrywa kluczową rolę w kodowaniu wzorców i cech. Aby te modele działały optymalnie, wymagają one bazy danych, która pozwala na natychmiastowe odzyskiwanie podobnych wektorów, co sprawia, że bazy danych wektorowe są niezbędnym elementem układanki generatywnej AI.
Tworzenie osadzania dla języka naturalnego zwykle wymaga użycia wstępnie wytrenowanych modeli, takich jak:
- GPT-3 i GPT-4: GPT-3 firmy OpenAI (Generative Pre-trained Transformer 3) był przełomowym modelem w społeczności NLP z 175 miliardami parametrów. Po nim nastąpił GPT-4, z jeszcze większą liczbą parametrów, który kontynuuje poszerzanie granic w generowaniu wysokiej jakości osadzeń. Te modele są szkolone na różnorodnych zbiorach danych, co pozwala im tworzyć osadzania, które ujmują szeroki zakres nuansów językowych.
- BERT i jego warianty: BERT (Bidirectional Encoder Representations from Transformers) od Google to kolejny znaczący model, który przeszedł wiele aktualizacji i iteracji, takich jak RoBERTa i DistillBERT. Szkolenie BERT w dwóch kierunkach, czytanie tekstu w obu kierunkach, jest szczególnie skuteczne w zrozumieniu kontekstu otaczającego słowo.
- ELECTRA: Bardziej niedawny model, który jest wydajny i osiąga wyniki porównywalne z dużo większymi modelami, takimi jak GPT-3 i BERT, przy mniejszych wymaganiach obliczeniowych. ELECTRA rozróżnia dane rzeczywiste i fałszywe podczas wstępnego szkolenia, co pomaga w generowaniu bardziej dopracowanych osadzeń.

Zrozumienie powyższego procesu:
Początkowo model osadzania jest używany do przekształcenia wybranej treści w osadzania wektorowe. Po wygenerowaniu te osadzania są przechowywane w bazie danych wektorowej. Dla łatwego śledzenia i istotności te przechowywane osadzania zachowują link lub odniesienie do oryginalnej treści, z którego zostały wygenerowane.
Później, gdy użytkownik lub system zadaje pytanie aplikacji, ten sam model osadzania jest ponownie uruchamiany. Przekształca to zapytanie w odpowiednie osadzania. Te nowo utworzone osadzania wyszukują bazę danych wektorową, szukając podobnych reprezentacji wektorowych. Osadzania, które są uznane za dopasowania, mają bezpośrednie powiązanie z ich oryginalną treścią, co zapewnia, że zapytanie użytkownika jest spełnione z odpowiednimi i dokładnymi wynikami.
Rosnące inwestycje w nowych bazach danych wektorowych
Z racji rosnącej popularności AI, wiele firm inwestuje w bazy danych wektorowe, aby poprawić swoje algorytmy i wydajność. Można to zobaczyć w ostatnich inwestycjach w startupy baz danych wektorowych, takie jak Pinecone, Chroma DB i Weaviate.

Duże firmy, takie jak Microsoft (MSFT ), również mają swoje własne narzędzia. Na przykład, Azure Cognitive Search pozwala firmom tworzyć aplikacje AI z wykorzystaniem baz danych wektorowych.
Firma Oracle (ORCL ) również ogłosiła nowe funkcje swojej bazy danych Database 23c, wprowadzając zintegrowaną bazę danych wektorowych. Funkcja „AI Vector Search” ma udostępniać nowy typ danych, indeksy i narzędzia wyszukiwania do przechowywania oraz przeszukiwania dokumentów i obrazów w postaci wektorów. Obsługuje generowanie wspomagane wyszukiwaniem (RAG), które łączy duże modele językowe z danymi przedsiębiorstwa, aby udzielać lepszych odpowiedzi na pytania bez udostępniania prywatnych danych.
Najważniejsze aspekty baz danych wektorowych
Miary odległości
Skuteczność wyszukiwania podobieństwa zależy od wybranej miary. Do popularnych miar należą odległość euklidesowa i podobieństwo kosinusowe, odpowiednie dla różnych rozkładów wektorów.
Indeksowanie
Ze względu na wysoką wymiarowość wektorów tradycyjne metody indeksowania nie wystarczają. Bazy danych wektorowych wykorzystują techniki takie jak grafy Hierarchical Navigable Small World (HNSW) lub drzewa Annoy, umożliwiające efektywne dzielenie przestrzeni wektorowej i szybkie wyszukiwanie najbliższych sąsiadów.

Drzewo Annoy (Źródło)
Annoy wykorzystuje binarne drzewa wyszukiwania. Wielokrotnie dzieli przestrzeń danych i przeszukuje tylko jej część, aby znaleźć bliskich sąsiadów.
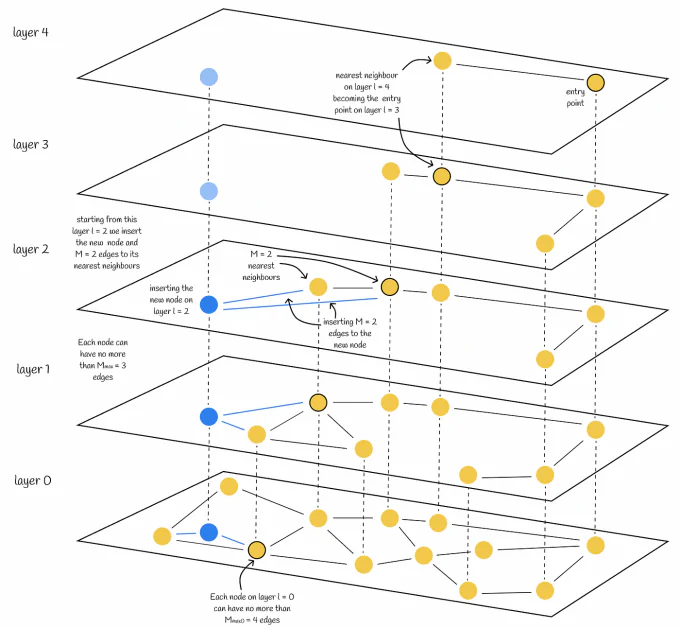
Grafy Hierarchical Navigable Small World (HNSW) (Źródło)
Grafy HNSW przypominają sieci. Łączą punkty danych w specjalny sposób, aby przyspieszyć wyszukiwanie. Dzięki temu pomagają szybko odnajdywać pobliskie punkty w zbiorze danych.
Skalowalność
Wraz ze wzrostem zbiorów danych utrzymanie krótkiego czasu wyszukiwania staje się trudniejsze. Systemy rozproszone, przyspieszenie za pomocą GPU i zoptymalizowane zarządzanie pamięcią to niektóre ze sposobów, w jakie bazy danych wektorowych radzą sobie z tym wyzwaniem.
Rola baz danych wektorowych: zastosowania i możliwości
1. Dane treningowe dla zaawansowanych modeli generatywnej AI: Modele takie jak DALL-E i GPT-3 trenuje się na ogromnych ilościach danych. Dane te często obejmują wektory pochodzące z wielu źródeł, w tym obrazów, tekstów, kodu i innych dziedzin. Bazy danych wektorowych porządkują te zbiory i nimi zarządzają, umożliwiając modelom przyswajanie oraz analizowanie wiedzy poprzez identyfikowanie wzorców i zależności między wektorami.
2. Rozwój uczenia na niewielu przykładach: Few-shot learning to technika uczenia AI przy ograniczonej ilości danych. Bazy danych wektorowych wspomagają ją dzięki rozbudowanemu indeksowi wektorów. Gdy model otrzyma zaledwie kilka wektorów, na przykład reprezentujących zdjęcia ptaków, może wywnioskować szersze pojęcie ptaka, rozpoznając podobieństwa i zależności między nimi.
3. Usprawnianie systemów rekomendacyjnych: Systemy rekomendacyjne wykorzystują bazy danych wektorowych, aby proponować treści zgodne z preferencjami użytkownika. Analizując jego zachowanie, profil i zapytania, wyodrębniają wektory odzwierciedlające zainteresowania. Następnie przeszukują bazę w poszukiwaniu podobnych wektorów treści, co pozwala precyzyjnie dobierać rekomendacje.
4. Semantyczne wyszukiwanie informacji: Tradycyjne metody wyszukiwania opierają się na dokładnym dopasowaniu słów kluczowych. Bazy danych wektorowych umożliwiają rozumienie i wyszukiwanie treści na podstawie podobieństwa semantycznego. Wyszukiwanie staje się bardziej intuicyjne, ponieważ uwzględnia znaczenie zapytania. Wektor zapytania użytkownika porównuje się z wektorami w bazie, aby znaleźć treści odpowiadające jego intencji, a nie tylko sformułowaniu.
5. Wyszukiwanie multimodalne: Wyszukiwanie multimodalne łączy dane z różnych źródeł, takich jak tekst, obrazy, dźwięk i wideo. Bazy danych wektorowych stanowią jego podstawę, umożliwiając wspólną analizę wektorów reprezentujących różne modalności. Użytkownik może uzyskać informacje z wielu źródeł na podstawie jednego zapytania, otrzymując bogatsze i bardziej kompleksowe wyniki.
Podsumowanie
Świat AI szybko się zmienia, wpływając na wiele branż oraz przynosząc korzyści i nowe wyzwania. Szybki rozwój generatywnej AI podkreśla kluczową rolę baz danych wektorowych w zarządzaniu wielowymiarowymi danymi i ich analizowaniu.
Te wyspecjalizowane systemy przechowywania, przystosowane do obsługi wektorów o wysokiej wymiarowości pochodzących z obrazów, tekstu czy dźwięku, stanowią ważną podstawę działania nowoczesnych aplikacji AI, zwłaszcza wyszukiwania podobieństwa.
Ich rosnące znaczenie potwierdzają inwestycje w ten sektor, w którym zarówno startupy takie jak Pinecone, jak i duże firmy takie jak Microsoft aktywnie przyczyniają się do rozwoju technologii.


