
Wywiady
Nikunj Bajaj, współzałożyciel i dyrektor generalny TrueFoundry – cykl wywiadów

 Dodaj Unite.AI do preferowanych źródeł w Google
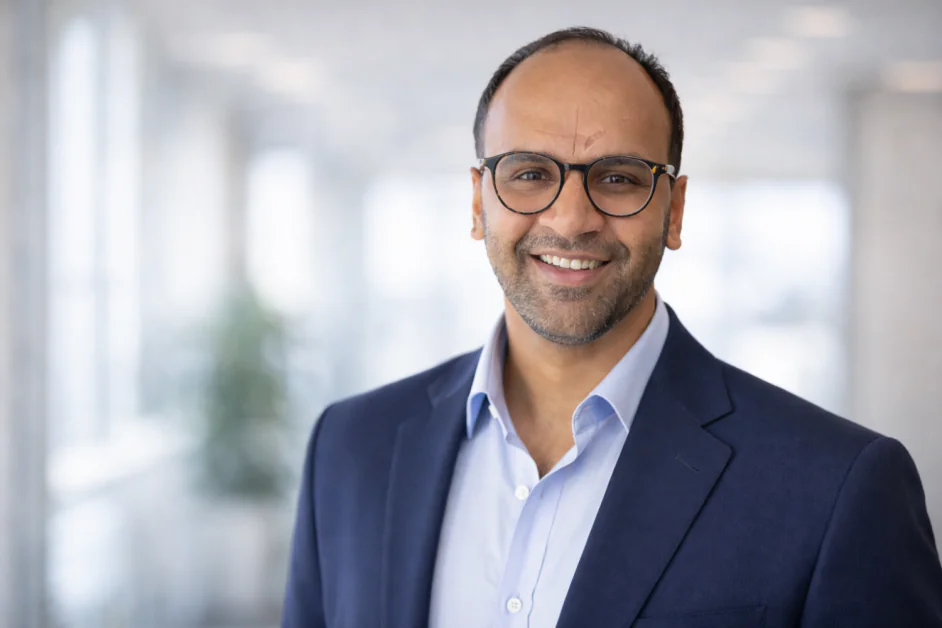
Przed założeniem TrueFoundry zajmowałeś się badaniami nad uczeniem maszynowym, systemami AI działającymi produkcyjnie w Facebooku (META ) oraz systemami rekomendacji na dużą skalę. Które doświadczenia najbardziej bezpośrednio skłoniły Cię do stworzenia firmy zajmującej się infrastrukturą AI dla przedsiębiorstw i jaki problem, Twoim zdaniem, pozostawał wówczas nierozwiązany?
W Meta traktowaliśmy uczenie maszynowe jako szczególny przypadek oprogramowania, a generatywną AI jako szczególny przypadek uczenia maszynowego. Powstał w ten sposób pionowy stos technologiczny z oprogramowaniem u podstawy, uczeniem maszynowym pośrodku i generatywną AI na szczycie. W takim układzie modele, które tworzę jako programista uczenia maszynowego, są wdrażane według tego samego schematu co pozostałe oprogramowanie, co znacznie upraszcza skalowanie systemów.
Większość przedsiębiorstw wdrażała jednak równoległe stosy technologiczne, czyli oddzielne stosy dla oprogramowania, uczenia maszynowego i generatywnej AI. Gdy stosy są równoległe, skalowanie staje się bardziej złożone ze względu na konieczność przekazywania pracy między obszarem uczenia maszynowego a obszarem oprogramowania.
Nasz zespół zawsze pracował na styku tworzenia modeli uczenia maszynowego i infrastruktury do ich obsługi. Dzięki tej wyjątkowej perspektywie dostrzegliśmy możliwość wprowadzenia podobnych pionowych stosów do przedsiębiorstw i dostosowania ich do konkretnych wymagań. Pod koniec 2021 roku postawiliśmy też hipotezę, że uczenie maszynowe zbliża się do punktu przełomowego, po którego osiągnięciu więcej firm będzie potrzebowało pionowo zintegrowanego stosu, aby skutecznie wdrażać i skalować te systemy. To ostatecznie doprowadziło nas do założenia TrueFoundry, a nasza hipoteza okazała się trafna. Upowszechnianie AI przyspieszyło po udostępnieniu ChatGPT pod koniec 2022 roku.
Co zmieniło się w sposobie, w jaki organizacje powinny myśleć o niezawodności i awariach, w miarę jak systemy AI przechodzą od eksperymentów do codziennej działalności?
W przypadku generatywnej AI stawka jest znacznie wyższa niż w tradycyjnych systemach uczenia maszynowego. Gdy systemy te trafiają do środowisk produkcyjnych, organizacje muszą radzić sobie ze znacznie większą niejednoznacznością i niedeterministycznością, ponieważ LLM mają z natury charakter stochastyczny. Oparte na nich systemy agentowe wprowadzają kolejną warstwę niejednoznaczności.
Ponadto awarie przestały mieć charakter binarny. Zamiast sytuacji, w której system po prostu działa albo nie działa, wiele problemów przybiera postać częściowych awarii lub niezauważalnego pogarszania się działania. Z czasem systemy mogą odpowiadać z większym opóźnieniem, oferować niższą jakość lub zachowywać się nieprawidłowo. W wielu przypadkach takie pogorszenie działania jest trudniejsze do wykrycia, a czasem nawet bardziej szkodliwe niż całkowita przerwa w działaniu.
Organizacje muszą rozpatrywać niezawodność nie tylko pod kątem czasu nieprzerwanej pracy, lecz także pogarszania się wydajności w czasie.
TrueFailover wprowadzono na rynek w czasie fali głośnych zakłóceń usług chmurowych i AI. Jakie niedawne wydarzenia pokazały wyraźnie, że niezawodność AI z pożądanego dodatku stała się podstawowym wymogiem architektonicznym?
Jeden z naszych klientów z sektora ochrony zdrowia przetwarza w czasie rzeczywistym zgłoszenia pacjentów dotyczące recept, w których czas ma kluczowe znaczenie. Dotknęła go przerwa w działaniu spowodowana awarią modelu. Jego przepływy pracy generują tysiące dolarów przychodu na sekundę, a awaria zakłóciła część tych krytycznych procesów. Był to jeden z pierwszych klientów TrueFailover, dzięki czemu mogliśmy pomóc mu szybko przywrócić działanie i ograniczyć skutki awarii.
Takie incydenty rodzą ważne pytanie: skoro stawka związana z systemami generatywnej AI wciąż rośnie, dlaczego procesy przywracania działania nadal w dużej mierze wymagają ręcznej interwencji? Utwierdziło nas to w przekonaniu, że systemy należy budować z założeniem, iż awarie będą występować, i projektować tak, aby automatycznie usuwały ich skutki. Niezawodność musi być też wbudowana w sam stos AI dzięki bramom AI, które zapewniają scentralizowane kierowanie ruchem, obserwowalność, mechanizmy zabezpieczające oraz inteligentne przełączanie modeli między dostawcami.
Wiele przerw w działaniu AI nadal przedstawia się jako drobne problemy techniczne. Gdzie Twoim zdaniem zaczynają ujawniać się rzeczywiste koszty ekonomiczne i ludzkie awarii systemów AI?
AI w przedsiębiorstwach rozwinęła się do tego stopnia, że te problemy nie dotyczą już wyłącznie wewnętrznych przepływów pracy. Dziś przerwy w działaniu i pogorszenie jakości wpływają bezpośrednio i natychmiast na odbiór firmy przez opinię publiczną oraz na zyski, ponieważ zastosowania produkcyjne służą już klientom. To przejście od testów wewnętrznych do aplikacji dostępnych publicznie, których działanie wiąże się z wysoką stawką, sprawia, że rośnie zapotrzebowanie na uwagę i nadzór ze strony najwyższego kierownictwa.
W miarę coraz głębszego włączania systemów AI w procesy operacyjne awarie przestają być wyłącznie problemami technicznymi. Coraz częściej mają bezpośrednie konsekwencje dla działalności firmy, klientów i reputacji.
Jak szybko w środowiskach o krytycznym znaczeniu, takich jak apteki, świadczenie opieki zdrowotnej czy obsługa klienta, przestój AI może przerodzić się w ryzyko operacyjne lub reputacyjne?
W środowiskach o krytycznym znaczeniu dzieje się to niemal natychmiast, ponieważ systemy te obsługują procesy realizowane w czasie rzeczywistym, w których liczy się czas. Nawet krótka przerwa może zatrzymać kluczowe procesy, opóźnić świadczenie usług lub zakłócić działanie kolejnych systemów zależnych od ich wyników, wywołując kaskadowe skutki operacyjne w całej organizacji.
W sektorach takich jak ochrona zdrowia skutki wykraczają poza zakłócenia operacyjne i obejmują doświadczenia klientów oraz rezultaty świadczonych usług. Jeśli pacjent nie może na czas zrealizować recepty, może to mieć realne konsekwencje. Jest to problem nie tylko dla pacjenta — może też zaszkodzić reputacji apteki lub świadczeniodawcy. W środowiskach o krytycznym znaczeniu, gdzie ważne jest zaufanie, utrzymanie dostępności systemów jest sprawą najwyższej wagi. Dlatego organizacje coraz częściej dostrzegają, że systemy AI trzeba projektować z założeniem występowania awarii, a mechanizmy przywracania działania muszą uruchamiać się automatycznie, aby zminimalizować ryzyko.
Mówiłeś, że wiele zespołów projektuje architekturę z myślą o możliwościach, a nie o ciągłości działania. Dlaczego Twoim zdaniem odporność na awarie przez lata miała niższy priorytet w projektowaniu systemów AI?
W dużej mierze wynika to z systemu zachęt w organizacjach. Nowe możliwości są widoczne i ekscytujące. Otwierają drogę do demonstracji, funkcji i nowych zastosowań produktu, które kierownictwo może natychmiast dostrzec.
Ciągłość działania z definicji pozostaje niewidoczna, gdy wszystko funkcjonuje prawidłowo. Z tego powodu systemy nagradzania zwykle premiują dostarczanie nowych funkcji bardziej niż dbanie o to, by nic się nie psuło. W rezultacie organizacje często inwestują nieproporcjonalnie dużo w rozwój możliwości w porównaniu z inżynierią odporności na awarie.
Jakie nowe słabe punkty pojawiają się w stosie AI wraz z rosnącą zależnością przedsiębiorstw od zewnętrznych modeli i interfejsów API, a ich znaczenia kierownictwo może jeszcze nie w pełni dostrzegać?
LLM są z natury zasobami współdzielonymi i przedsiębiorstwa nie są ich właścicielami, tak jak w przypadku tradycyjnej infrastruktury. Ponadto ważne systemy o krytycznym znaczeniu dla działalności przedsiębiorstw działają na zewnętrznych systemach, które nie zostały jeszcze w pełni sprawdzone w dłuższej perspektywie. Same LLM rozwijają się bardzo szybko, co oznacza, że dostawcy modelu nie można pociągać do odpowiedzialności za takie kwestie jak opóźnienia czy niewielki spadek jakości działania modelu, ponieważ bardzo szybko prowadzi on kolejne iteracje badań.
Ponieważ LLM są zasobami współdzielonymi, określone działanie innego ich użytkownika może spowodować gwałtowny wzrost opóźnień. Sama natura LLM wprowadza wiele takich punktów podatnych na awarie, a przedsiębiorstwa w tym nowym świecie po prostu nie mają pełnej kontroli. W tej sytuacji najlepszym rozwiązaniem jest zapewnienie wystarczającej redundancji systemu, by zbudować odporność na awarie.
Nie skupiając się na konkretnych produktach: jak organizacje powinny na nowo podejść do architektury AI, aby zakładać występowanie awarii, zamiast traktować przestoje jako rzadkie przypadki brzegowe?
Organizacje powinny wrócić do podstawowych zasad projektowania systemów rozproszonych. Systemy oprogramowania budowano z założeniem, że elementy sieci i maszyny będą ulegać awariom, a cały region może przestać działać.
Systemy AI nie powinny być wyjątkiem. Należy zakładać, że dostawcy modeli będą doświadczać opóźnień, pogorszenia działania lub awarii, i uwzględniać redundancję, aby aplikacje zachowały odporność w różnych scenariuszach awarii.
Czy spodziewasz się, że odporność AI na awarie stanie się czynnikiem decydującym o wyborze platformy i dostawcy, podobnie jak czas nieprzerwanej pracy i redundancja kształtowały decyzje dotyczące infrastruktury chmurowej?
W miarę trafiania kolejnych systemów AI do środowisk produkcyjnych odporność na awarie stanie się warunkiem koniecznym. Jeśli dostawca nie potrafi przedstawić wykresów i wskaźników dotyczących czasu nieprzerwanej pracy oraz ogólnej odporności, nie będzie nawet brany pod uwagę. Gdy odporność stanie się podstawowym oczekiwaniem wobec wszystkich dostawców, o wyborze zaczną decydować doświadczenia użytkowników, optymalizacja wydajności, obserwowalność i bardziej zaawansowane możliwości produktu. Z czasem takie elementy jak brama AI i automatyczne przełączanie awaryjne staną się podstawowymi składnikami infrastruktury AI dla przedsiębiorstw.
Co w przyszłości będzie naprawdę oznaczać AI „gotowa do pracy produkcyjnej” w świecie, w którym oczekuje się od niej ciągłej dostępności, a nie tylko sporadycznej przydatności?
Systemy AI gotowe do pracy produkcyjnej powinny zapewniać obserwowalność, możliwość sterowania i możliwość przywrócenia działania po awarii. Muszą spełniać wszystkie trzy warunki.
Aby AI działająca produkcyjnie zapewniała obserwowalność, zespoły potrzebują szczegółowego wglądu w zachowanie modelu, opóźnienia, częstotliwość błędów, zużycie tokenów, dryf i wzorce awarii. Bez rozbudowanej obserwowalności bardzo trudno wykryć pogorszenie działania, zanim zauważą je użytkownicy.
Możliwość sterowania systemami obejmuje kształtowanie ruchu, ograniczanie częstotliwości żądań, mechanizmy zabezpieczające, egzekwowanie polityk i inteligentne kierowanie ruchem między modelami i dostawcami. W tym obszarze brama AI staje się fundamentem: działa jako scentralizowana warstwa sterowania, która egzekwuje zabezpieczenia, zapewnia spójny nadzór i umożliwia dynamiczne przełączanie modeli, gdy spada wydajność lub niezawodność.
Wreszcie możliwość przywrócenia działania wymaga budowania systemów z założeniem, że komponenty mogą działać częściowo nieprawidłowo lub być całkowicie niesprawne — z powodu awarii u dostawców, pogorszenia jakości modeli, limitów częstotliwości żądań czy nieoczekiwanych danych wejściowych od podmiotów działających w złej wierze. Automatyczne przełączanie awaryjne i mechanizmy samonaprawy powinny być integralną częścią architektury, a nie ręcznie realizowanymi procedurami uruchamianymi dopiero po wystąpieniu problemu.
W tym kierunku zmierzamy w TrueFoundry. Dostawcy, którzy w ten sposób definiują gotowość do pracy produkcyjnej — łącząc obserwowalność, scentralizowane sterowanie i automatyczne przywracanie działania — zdobędą długoterminowe zaufanie klientów i będą mogli nadal rozwiązywać nowe problemy w miarę ich pojawiania się.
Dziękuję za świetny wywiad. Czytelnicy, którzy chcą dowiedzieć się więcej, powinni odwiedzić TrueFoundry.


