
Modele i platformy AI
Nowe gotowe zestawy danych (OTS) od Appen przyspieszają wdrożenie sztucznej inteligencji

 Dodaj Unite.AI do preferowanych źródeł w Google
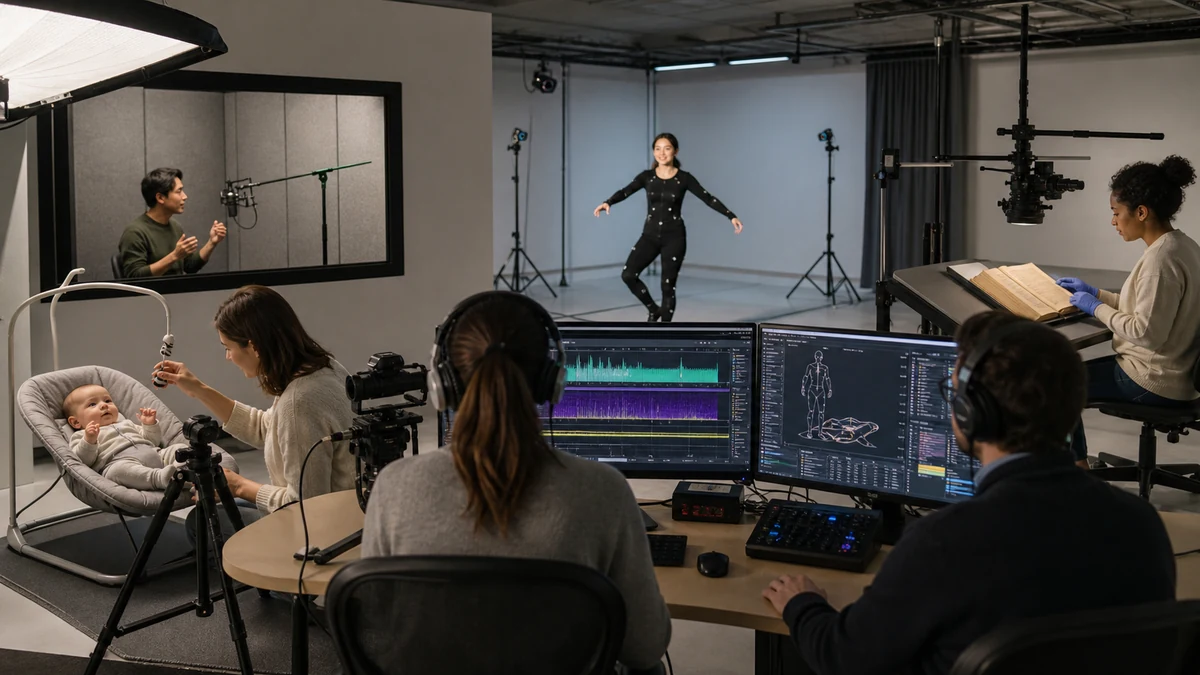
Appen Limited (ASX:APX), wiodący dostawca wysokiej jakości danych szkoleniowych dla organizacji, które budują skuteczne systemy sztucznej inteligencji na dużą skalę, ogłosił dziś nowe gotowe zestawy danych (OTS). Zestawy te są zaprojektowane, aby ułatwić i przyspieszyć pozyskiwanie przez firmy wysokiej jakości danych szkoleniowych niezbędnych do przyspieszenia ich projektów sztucznej inteligencji (AI) i uczenia maszynowego (ML). Nowe zestawy OTS obejmują ruchy ludzkiego ciała i innowacyjne dźwięki płaczu niemowląt, a także nagrania mówione i obrazy z tekstem odpowiednie do optycznego rozpoznawania znaków (OCR) dla języków o wysokim popycie, ale trudnych do pozyskania, takich jak arabski, chorwacki, grecki, węgierski, tajski i wiele innych. Wraz z rozszerzonymi zestawami danych, łączna oferta OTS Appen obejmuje ponad 250 zestawów, składających się z ponad 11 000 godzin audio, ponad 25 000 obrazów i ponad 8,7 miliona słów w 80 językach i wielu dialektach.
Zestawy OTS Appen to szybki i ekonomiczny sposób, aby rozpocząć projekt AI lub ML z wysokiej jakości danymi szkoleniowymi. Zespoły rozwijające swoje możliwości AI mogą również wykorzystywać zestawy OTS, aby skutecznie poprawić dokładność, rozwijać nowe umiejętności modelu i wdrażać inne ulepszenia w swoich modelach AI. Zestaw OTS jest często dostarczany w ciągu jednego tygodnia, na przykład, w porównaniu z ośmioma do dwunastu tygodni na nowy projekt zbierania i annotacji danych – lub nawet dłużej, w zależności od złożoności. Wszystkie zestawy danych Appen są opracowane przy użyciu w pełni przejrzystej, dobrowolnej metodyki, dzięki czemu specjaliści AI mogą być pewni, że ich dane są czyste i zgodne, eliminując potencjalne ryzyko negatywnej reakcji i uszczerbku dla reputacji.
„Zespoły AI na całym świecie, pracujące nad projektami o ścisłych terminach i elastycznych wymaganiach danych, mogą skorzystać z korzystania z gotowych zestawów danych”, powiedział Wilson Pang, dyrektor techniczny Appen. „Zestawy OTS skracają czas potrzebny do osiągnięcia efektów i zapewniają dostęp do wysokiej jakości danych przy niższych kosztach ogólnych w porównaniu z tradycyjnymi metodami. W Appen podejmujemy niezbędne kroki, aby upewnić się, że wszystkie nasze zestawy danych są pozyskiwane w sposób etyczny i zrównoważony demograficznie, umożliwiając firmom utrzymanie odpowiedzialnych praktyk AI, minimalizując stronniczość w ich modelach i zapewniając sprawiedliwe traktowanie anotatorów danych. Zawsze wiesz, jaka jest dokładna jakość zestawu OTS, co pomaga budować lepsze AI, które działają w świecie rzeczywistym”.
MediaInterface dostarcza rozwiązania związane z technologią języka do instytucji opieki zdrowotnej w Niemczech i innych częściach Europy od ponad 20 lat. Gdy firma rozszerzała się na Francję, miała w pełni zlokalizowane oprogramowanie, ale brakowało jej danych leksykalnych w języku francuskim, zwłaszcza francuskich nazw i miejsc, które są często odniesione w informacjach o zdrowiu pacjentów. Korzystając z zestawów OTS Appen, MediaInterface pozyskała około 21 000 francuskich nazw i 14 000 nazw miejsc. „Krytyczne dane z Appen zostały zintegrowane z naszym leksykonem tła, aby pomyślnie uruchomić nowy rynek, co pomaga nam rozwijać nowe słownictwo dla naszych klientów i wzmocnić nasze podejście do przyszłych startów rynkowych”, powiedziała Ines Wendler, menedżer produktu w MediaInterface.
Najbardziej doświadczeni eksperci AI łączą zestawy OTS z projektami zbierania i annotacji danych na żądanie, aby spełnić ich złożone potrzeby danych szkoleniowych dla modeli AI. Appen jest liderem w oferowaniu ciągłego wsparcia poprzez szereg specyficznych usług zbierania danych, takich jak ciągła annotacja danych i inteligentne etykietowanie, za pomocą narzędzi i przepływów pracy zasilanych przez AI, aby maksymalizować wydajność.
„Wchodzimy w interakcję z AI od momentu, gdy się budzimy, aż do momentu, gdy idziemy spać – poprzez asystentów wirtualnych, czatboty, wyszukiwarki, sieci społeczne, urządzenia medyczne, samochody inteligentne i inne aplikacje”, powiedziała Judith Bishop, starszy dyrektor ds. specjalistów AI w Appen, który kieruje zespołem 100 lingwistów AI i ekspertów językowych. „Język jest często głównym interfejsem dla wielu tych przypadków użycia AI, więc aby zagwarantować dobrą jakość doświadczenia, model musi być przeszkolony, aby działał dla wszystkich. Zobowiązanie Appen do wysokiej jakości danych i odpowiedzialnego, etycznego rozwoju AI pozwala firmom kupującym nasze gotowe zestawy danych na przyspieszenie swoich projektów AI z pełnym zaufaniem do swoich danych”.
Dołączając do istniejących setek zestawów danych już dostępnych na appen.com, lista nowych zestawów OTS Appen, które są teraz dostępne, obejmuje:
- Mówiona mowa dla języka arabskiego (Egipt), arabskiego (Arabia Saudyjska), arabskiego (Zjednoczone Emiraty Arabskie), centralnego khmerskiego (Kambodża), chorwackiego, greckiego, węgierskiego, polskiego, hiszpańskiego (Hiszpania) i tureckiego
- OCR obrazu dla chińskiego tekstu drukowanego, tajskiego tekstu drukowanego i fińskiego tekstu drukowanego – Zawiera nagrane tablice reklamowe, zewnętrzne opakowania, znaki, magazyny i menu, aby trenować i aktualizować modele OCR komputerowego widzenia
- Ruchy ludzkiego ciała (Chiny) – Zawiera opatrzony adnotacjami film wideo ludzi poruszających się, śledzonych na poziomie pikseli, odpowiednich dla rozwoju gier, aplikacji fitness i więcej
- Dźwięki płaczu niemowląt (Chiny) – Zawiera nagrane i opatrzony adnotacjami dźwięki niemowląt, które mogą być wykorzystane do trenowania modeli AI w celu rozpoznania różnych dźwięków płaczu i powiadomienia rodziców
Aby uzyskać więcej informacji i poprosić o próbkę zestawu OTS Appen, kliknij tutaj.


