
Kąt Andersona
NeRF zbliża się o krok do zastąpienia CGI

 Dodaj Unite.AI do preferowanych źródeł w Google

Badacze z MIT i Google dokonali dużego postępu w rozwiązaniu jednego z najbardziej fundamentalnych przeszkód dla wschodzącej technologii opartej na sztucznej inteligencji, która może ostatecznie zastąpić CGI – oddzielenie obrazów neural radiance field (NeRF) na ich składowe wizualne, tak aby obrazy mogły być ponownie teksturyzowane i oświetlone.
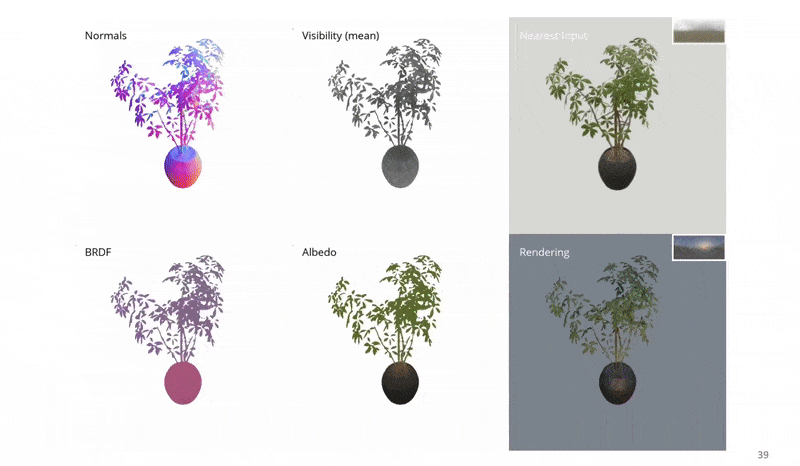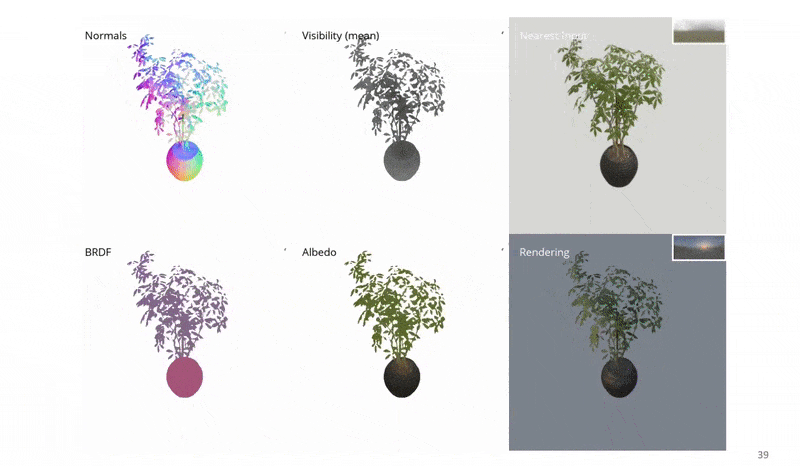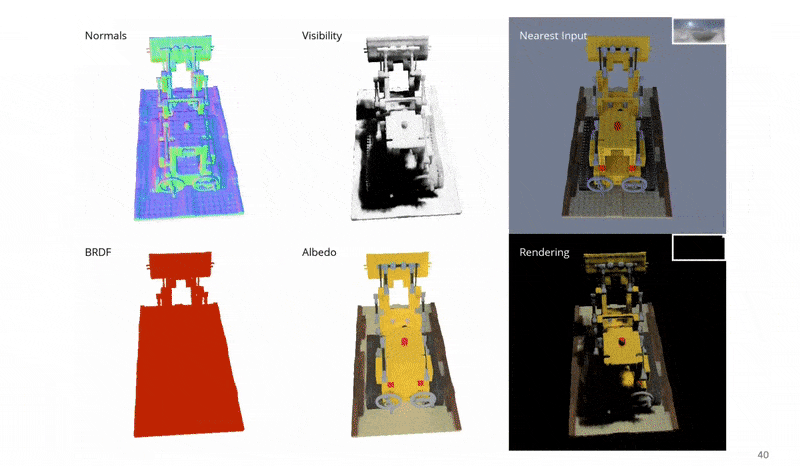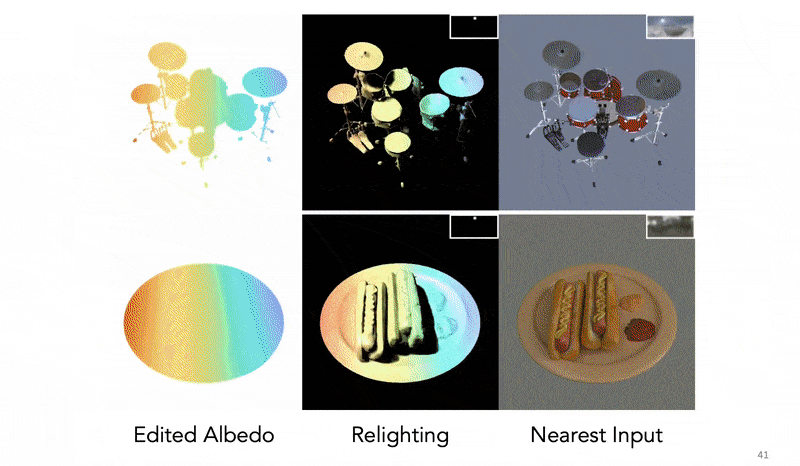
Nowy podejście, nazwane NeRFactor, skutecznie dzieli przechwytywane obrazy na per-objektowe normalne (na które można przypisać tekstury), widoczność światła, albedo (proporcję światła przypadkowego, które jest odbite od powierzchni) i Bidirectional Reflectance Distribution Functions (BRDFs).
Z tymi aspektami izolowanymi, możliwe jest nie tylko przełączanie tekstur dla poszczególnych obiektów lub grup obiektów, ale również dodawanie nowych i unikalnych źródeł światła i implementacji cieni, dyskwalifikując te, które zostały przechwycone przez wieloobiektywowe tablice, które generują dane wejściowe dla obrazów NeRF.
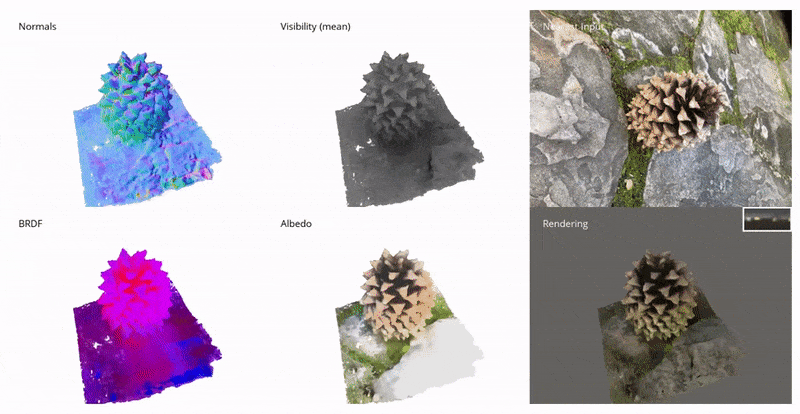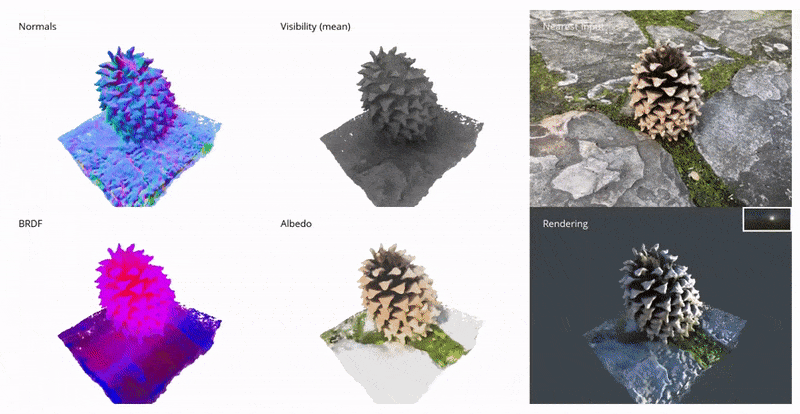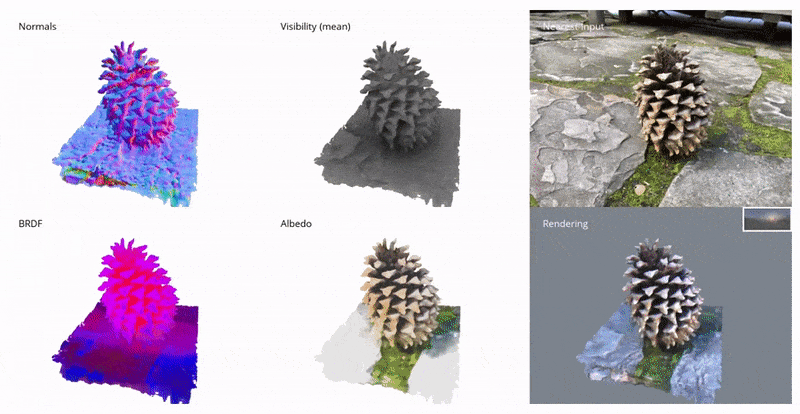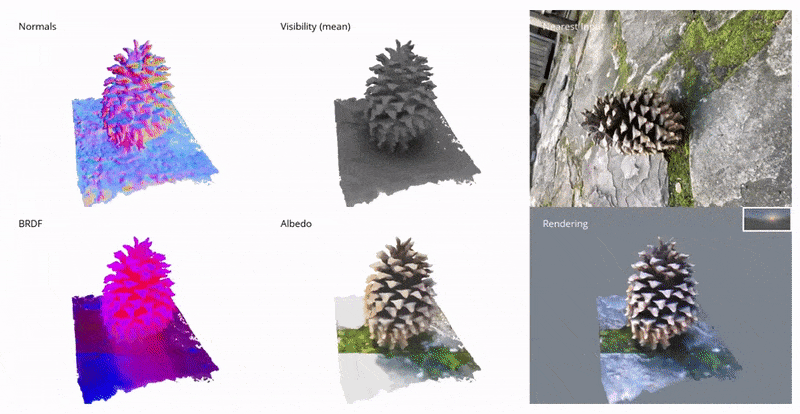
Normals, visibility, albedo and BRDF separated under NeRFactor. Source: https://www.youtube.com/watch?v=UUVSPJlwhPg
Model obsługuje miękkie lub twarde cienie z dowolnych, zdefiniowanych przez użytkownika źródeł światła i oddziela cztery aspekty przechwytywanego wideo programowo, przy użyciu straty rekonstrukcji, danych z poprzednich obliczeń BRDF i podstawowej prostej regularyzacji gładkości.


NeRFactor’s work-flow, extracting separately actionable facets of imagery derived from multiple-camera arrays. Source: https://arxiv.org/pdf/2106.01970.pdf
NeRFactor wykorzystuje sondę światła HDR, dobrze ugruntowane podejście, które od 1998 roku jest powszechnie stosowane w przemyśle wizualnym i artystycznym, do oceny możliwych tras promieni, co umożliwia dowolne oświetlenie. Ponieważ generuje to niekontrolowaną liczbę parametrów, sonda światła jest filtrowana przez wielowarstwowy perceptron (MLP), który mapuje postrzeganą geometrię na sondę bez próby obliczania pełnej mapy objętości oświetlenia dla przestrzeni modelu.

Two neural radiance field models are used to demonstrate five lighting models possible under NeRFactor. Click image for higher resolution.
Przyczyna do refleksji
Nowe badanie jest być może najbardziej istotne w oddzieleniu warstw przechwytywanych obrazów, które kontrolują odbicie. Pozostaje to jednym z największych wyzwań dla obrazów neural radiance field, ponieważ prawdziwie nowy i elastyczny system NeRF będzie musiał nie tylko móc zastąpić tekstury, ale również będzie musiał znaleźć sposób na odbicie poruszających się obiektów (poza tylko stałym środowiskiem), które zwykle są uwzględnione w przepływie pracy CGI.
Ten problem został zauważony niedawno w odniesieniu do nowego badania Intelu przetwarzania filmów wideo w celu uzyskania fotorealistycznych obrazów za pomocą sieci neuronowych. W takich przepływach pracy wiele “upieczonych” aspektów materiału źródłowego musiałoby się stać dyskretnymi i wymiennymi, a to jest najprawdopodobniej łatwiejsze do rozwiązania dla oświetlenia (które jest funkcją geometrii renderowanej w NeRF) niż dla odbić (które wykorzystują “pozaekranową” geometrię, która jest całkowicie poza zakresem modelu).
Użycie środowiska HDR już rozwiązuje problem generowania odbić środowiska (tj. nieba, krajobrazu i innych “stałych” czynników otoczenia), ale nowe podejścia będą potrzebne, aby wprowadzić poruszające się i dynamiczne odbicia.
Fotogrametria z NeRF
Obrazy Neural Radiance Field wykorzystują analizę z użyciem sztucznej inteligencji do opracowania całkowicie objętościowej przestrzeni z sceny lub obiektu, który został przechwycony z wielu kątów.

Różne schematy oparte na NeRF, które pojawiły się w ciągu ostatniego roku, wykorzystywały różnorodną liczbę urządzeń kamery; niektóre używały 16 lub więcej kamer, inne tylko jednej lub dwóch. We wszystkich przypadkach pośrednie punkty widzenia są “wypełnione” (tj. interpretowane), aby scena lub obiekt mogły być płynnie nawigowane.
Wynikającą z tego jest całkowicie objętościowa przestrzeń, z wewnętrznym trójwymiarowym zrozumieniem, które może być wykorzystane na wiele sposobów, w tym możliwość generowania tradycyjnych siatek CG z trójwymiarowej sumy obrazów wejściowych.
NeRF w kontekście nowego CGI
Obrazy neural radiance field są wykreślone bezpośrednio z obrazów świata rzeczywistego, w tym poruszających się obrazów ludzi, obiektów i scen. W przeciwieństwie do tego, metodyka CGI “studiuje” i interpretuje świat, wymagając wykwalifikowanych pracowników do budowy siatek, szkieletów i tekstur, które wykorzystują obrazy świata rzeczywistego (tj. przechwytywanie twarzy i środowiska). Pozostaje to podstawowo interpretacyjnym i rzemieślniczym podejściem, które jest drogie i pracochłonne.
Dodatkowo, CGI miało trwające problemy z efektem “doliną nieprzyjemności” w swoich próbach odtworzenia podobieństw ludzkich, co nie stanowi ograniczenia dla podejścia opartego na NeRF, które po prostu przechwytuje filmy wideo lub obrazy prawdziwych ludzi i manipuluje nimi.
Ponadto, NeRF może generować tradycyjną geometrię siatki CGI bezpośrednio z fotografii, jeśli jest to konieczne, i w efekcie zastępuje wiele ręcznych procedur, które zawsze były konieczne w generowanych komputerowo obrazach.
Wyzwania dla NeRF
To najnowsze badanie z MIT i Google pochodzi w kontekście wielu prac nad NeRF w ciągu ostatniego roku, z których wiele zaproponowało rozwiązania różnych wyzwań wynikających z pierwotnego artykułu z 2020 roku.
W kwietniu, innowacja chińskiego konsorcjum badawczego dostarczyła sposób na oddzielenie poszczególnych czasowych linii aspektów w scenie NeRF, w tym ludzi.
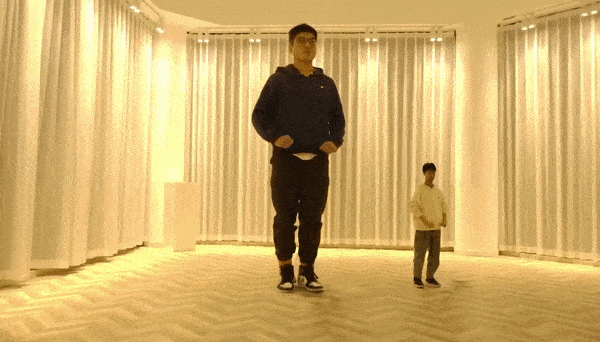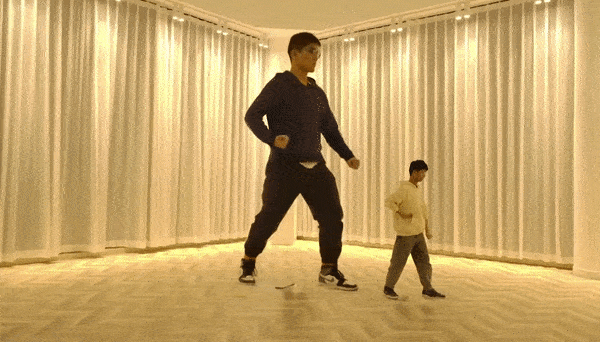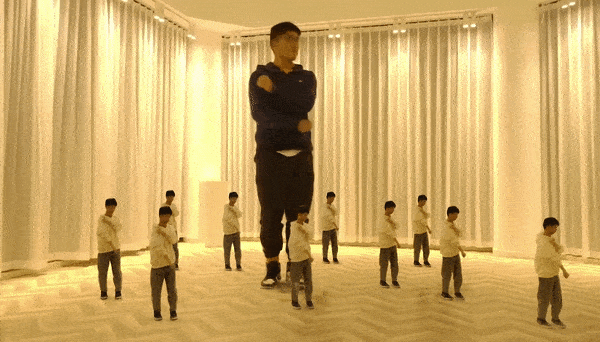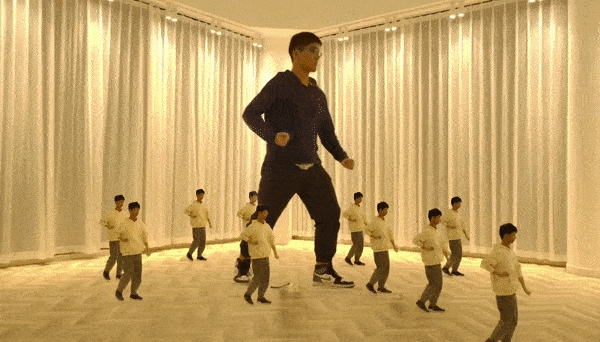
Chińskie badanie pozwala użytkownikom na kopiowanie, wklejanie i zmianę rozmiaru przechwyconych elementów, odłączając je od liniowego czasowego toku oryginalnego filmu wideo. Source: https://www.youtube.com/watch?v=Wp4HfOwFGP4
To podejście nie tylko umożliwia wyobrażenie sobie sceny z dowolnego kąta przechwyconego przez tablicę kamer (a nie tylko z jednego widoku reprezentowanego w typowym przechwytywaniu wideo), ale również umożliwia wszechstronne komponowanie – i nawet możliwość reprezentowania dwóch aspektów z tego samego filmu wideo, które są uruchamiane w swoich własnych ramach czasowych (lub nawet biegną wstecz, jeśli jest to konieczne).
Chińskie badanie pozwala użytkownikom na kopiowanie, wklejanie i zmianę rozmiaru przechwyconych elementów, odłączając je od liniowego czasowego toku oryginalnego filmu wideo. Source: https://www.youtube.com/watch?v=Wp4HfOwFGP4
Jednym z największych wyzwań dla NeRF jest obniżenie znacznych zasobów potrzebnych do szkolenia sceny, a to zostało zaadresowane w kilku ostatnich pracach. Na przykład, Instytut Maxa Plancka ds. Systemów Inteligentnych wprowadził KiloNeRF, który nie tylko przyspiesza czasy renderowania o czynnik 1000, ale również umożliwia NeRF działać interaktywnie.
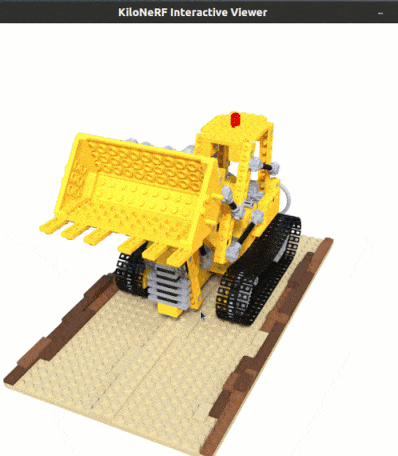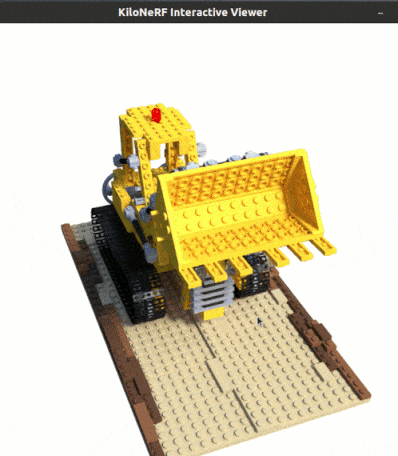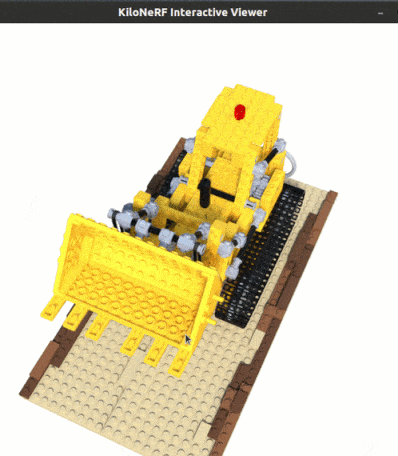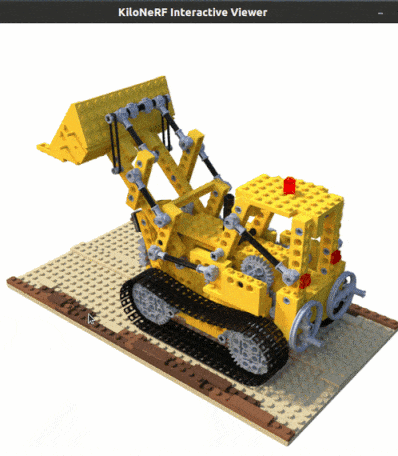
KiloNeRF running an interactive environment at 50fps on a GTX 1080ti. Source: https://github.com/creiser/kilonerf
Jednak innowacja NeRF, która naprawdę zdobyła wyobraźnię badaczy i publiczności w 2021 roku, była PlenOctrees współpracą, prowadzoną przez UC Berkeley, która oferuje rendering w czasie rzeczywistym Neural Radiance Fields:
Wpływ interaktywnych możliwości PlenOctrees został odtworzony w interaktywnym, internetowym interfejsie.
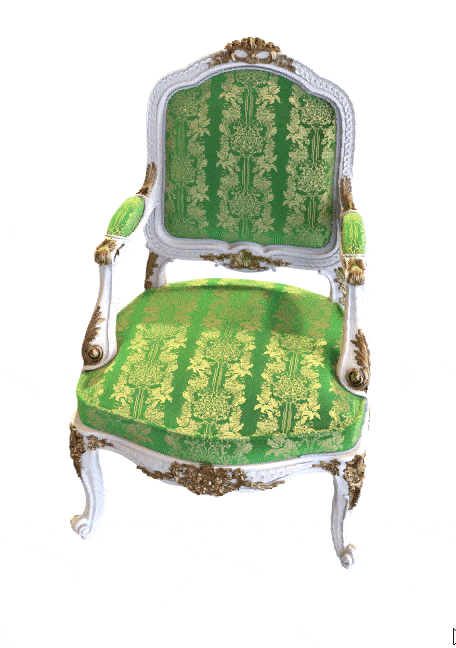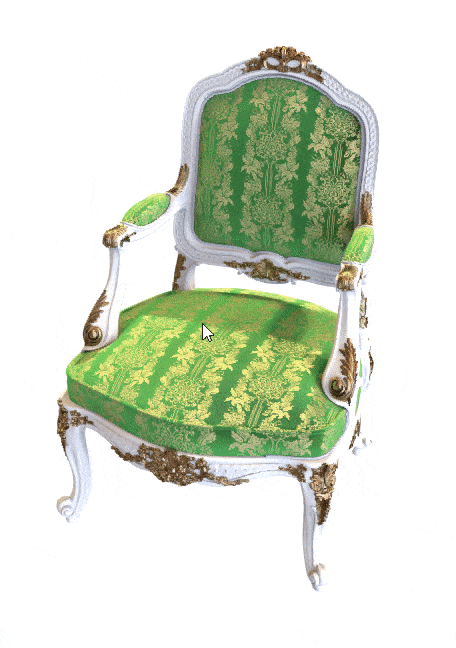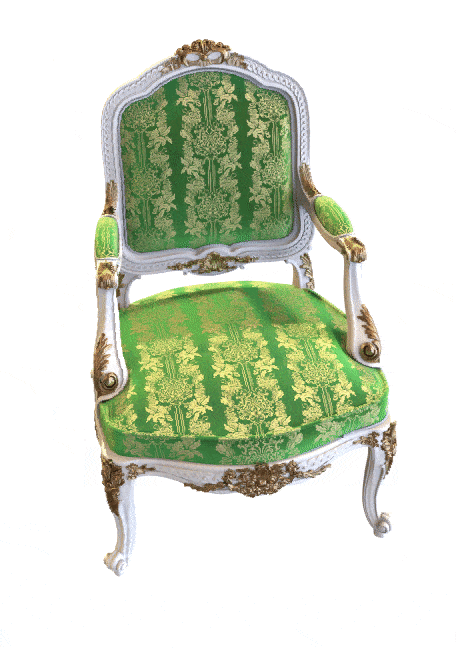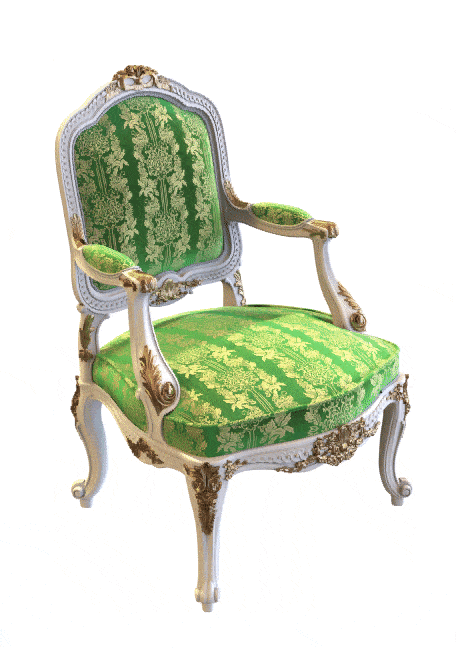
Live interactive movement of a PlenOctrees object in Firefox (movement is smoother and more dynamic than this GIF represents). Source: http://alexyu.net/plenoctrees/demo/
Dodatkowo, Recursive-NeRF (z maja 2021 roku pracy badawczej przez badaczy z Uniwersytetu Tsinghua) oferuje renderowanie o wysokiej jakości w sposób rekursywny na żądanie. Zamiast zmuszać użytkownika do renderowania całych scen, w tym części, które mogą nie być widoczne, Recursive-NeRF zapewnia coś w rodzaju kompresji stratnej JPEG, i może generować dyskretne sub-NeRF, aby obsłużyć dodatkowe obrazy na żądanie – osiągając ogromne oszczędności w zasobach obliczeniowych.

Retaining detail while dumping unnecessary render calculations with Recursive-NeRF. Click on image for higher resolution. Source: https://arxiv.org/pdf/2105.09103.pdf
Inne podejścia obejmują FastNeRF, które twierdzi, że osiąga renderowanie neuronowe o wysokiej wierności przy 200 klatkach na sekundę.
Zauważono, że wiele technik optymalizacji NeRF obejmuje ‘upieczenie’ sceny, poprzez zobowiązanie się do aspektów, które mają być renderowane, i odrzucenie innych aspektów, co ogranicza eksplorację, ale znacznie przyspiesza interakcję.
Wadą tego jest to, że stres przechodzi z procesora graficznego na pamięć, ponieważ upieczone sceny zajmują ogromną ilość miejsca na dysku; w pewnym stopniu można to złagodzić, zmniejszając rozdzielczość upieczonych danych, chociaż również wymaga to pewnego zobowiązania, w zakresie zamykania dróg eksploracji lub interakcji.
Odnosząc się do przechwytywania ruchu i szkieletu, nowe podejście z Uniwersytetów Zheijang i Cornell, ujawnione w maju, zaproponowało metodę odtwarzania animowalnych ludzi przy użyciu pól wagowych i struktur szkieletowych interpretowanych z danych wejściowych wideo:
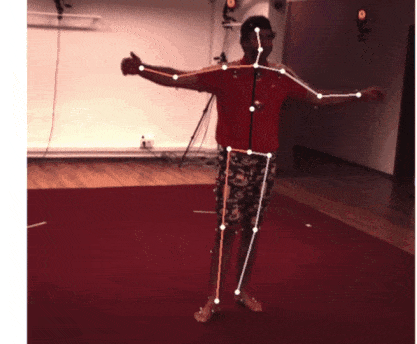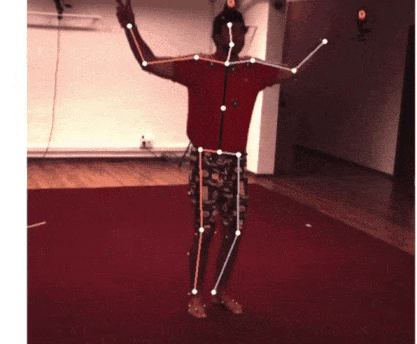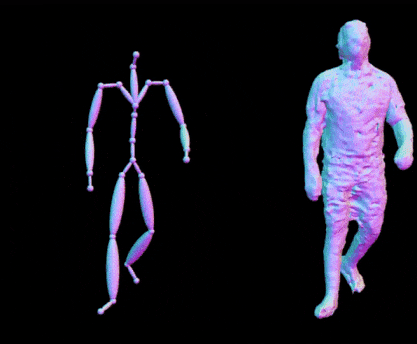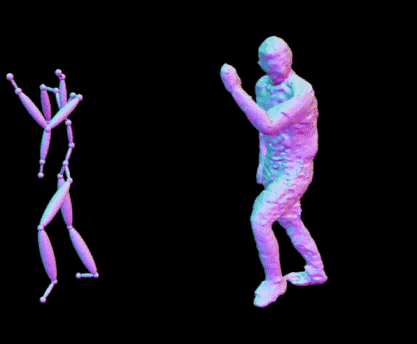
Derived skeletal structure in Animatable NeRF. Source: https://www.youtube.com/watch?v=eWOSWbmfJo4

Kiedy NeRF będzie miał swój moment ‘Parku Jurajskiego’?
Pomimo szybkiego tempa postępu z syntezą obrazu za pomocą pól promieniowania neuronowego, jest to dopiero okres, w którym jakiś rodzaj “prawa termodynamiki” zostanie ustalony dla tego, jak można wdrożyć NeRF. W kwestii chronologii podobnej do historii CGI, NeRF unoszą się obecnie wokół 1973 roku, tuż przed pierwszym użyciem CGI w Westworld.
To nie oznacza, że NeRF będzie musiał czekać dziewięć lat na swój odpowiednik Wrath Of Khan kamień milowy, lub dziesięciolecia na przełomowe osiągnięcia, które CGI osiągnęło pod entuzjastycznym patronatem Jamesa Camerona w 1989 roku w The Abyss lub w 1991 roku w Terminator 2 – a potem, prawdziwie rewolucyjny moment przełomowy w 1993 roku w Parku Jurajskim.

Scena obrazowa zmieniła się znacznie od długiego okresu stagnacji efektów wizualnych fotochemicznych, które dominowały produkcję filmową i telewizyjną od narodzin kina do wczesnych lat 90. XX wieku. Nadejście rewolucji komputerowej i przyspieszenie prawa Moore’a doprowadziło do rewolucji CGI, która w przeciwnym razie mogłaby się wydarzyć już w latach 60. XX wieku.
Nie wiadomo, czy istnieje jakaś bariera tak nieprzekraczalna, że mogłaby powstrzymać postęp NeRF przez tak długi czas – i czy późniejsze innowacje w dziedzinie widzenia komputerowego nie mogą w międzyczasie całkowicie przejąć NeRF jako głównego kandydata do korony CGI, charakteryzując pola promieniowania neuronowego jako krótkotrwały “faks” syntezowania obrazu neuronowego.
Jak dotąd, NeRF nie został wykorzystany w żadnym kontekście poza badaniami akademickimi; jednak warto zauważyć, że główni gracze, tacy jak Google Research, oraz wiele z najbardziej prominentnych laboratoriów badawczych widzenia komputerowego, konkurują o najnowsze przełomy NeRF.
Wiele z największych przeszkód NeRF zaczęło być bezpośrednio zaadresowanych w tym roku; jeśli późniejsze badania zapewnią rozwiązanie problemu “odblasku”, a wiele wątków badań optymalizujących NeRF zjednoczy się w decydujące rozwiązanie ogromnych wymagań technologicznych i/lub magazynowania, NeRF naprawdę ma szansę stać się “nowym CGI” w ciągu najbliższych pięciu lat.


