
Modele i platformy AI
Wewnątrz OpenAI o3 i o4-mini: Odblokowanie nowych możliwości za pomocą wielomodalnego rozumowania i zintegrowanych zestawów narzędzi

 Dodaj Unite.AI do preferowanych źródeł w Google
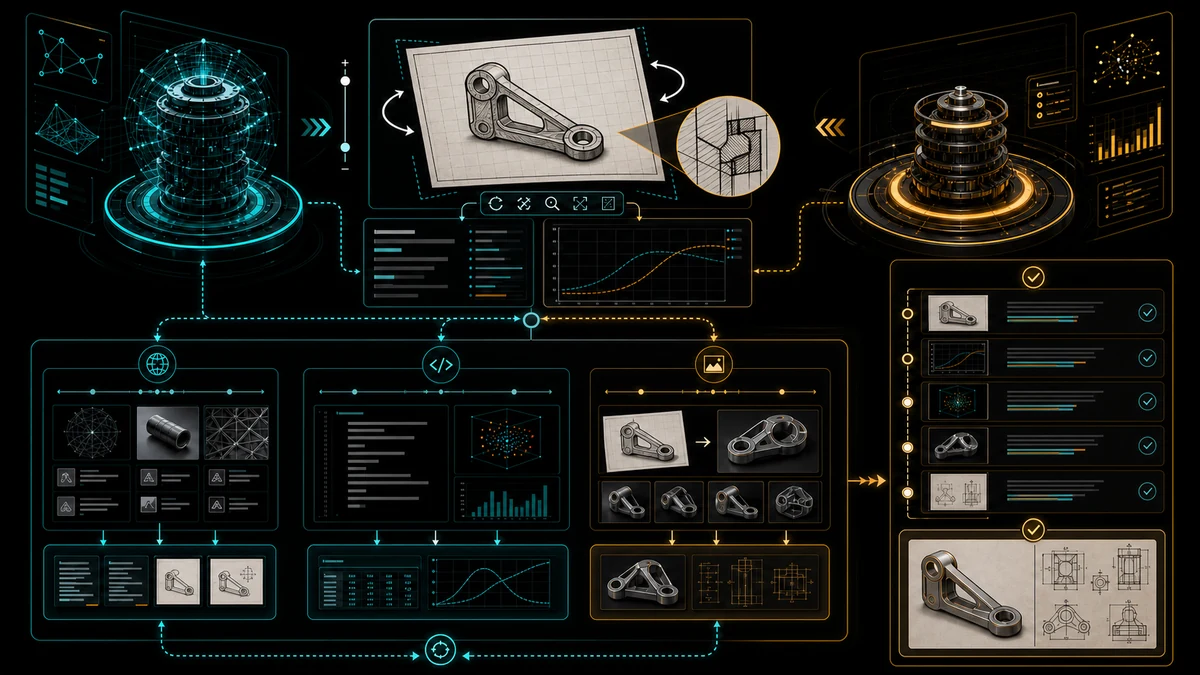
16 kwietnia 2025 r. OpenAI opublikowało ulepszone wersje swoich zaawansowanych modeli rozumowania. Te nowe modele, nazwane o3 i o4-mini, oferują ulepszenia w porównaniu z poprzednikami, o1 i o3-mini. Najnowsze modele dostarczają lepszej wydajności, nowych funkcji i większej dostępności. Artykuł ten opisuje główne korzyści o3 i o4-mini, przedstawia ich główne możliwości i omawia, jak mogą one wpłynąć na przyszłość aplikacji AI. Ale zanim zagłębimy się w to, co sprawia, że o3 i o4-mini są wyjątkowe, ważne jest zrozumienie, jak modele OpenAI ewoluowały w czasie. Zacznijmy od krótkiego przeglądu podróży OpenAI w tworzeniu coraz potężniejszych systemów językowych i rozumowania.
Ewolucja dużych modeli językowych OpenAI
Rozwój dużych modeli językowych OpenAI rozpoczął się od GPT-2 i GPT-3, które spopularyzowały ChatGPT dzięki ich zdolności do generowania płynnego i kontekstowo dokładnego tekstu. Modele te zostały szeroko przyjęte do zadań takich jak podsumowanie, tłumaczenie i odpowiedzi na pytania. Jednak gdy użytkownicy zastosowali je do bardziej złożonych scenariuszy, ich słabości stały się widoczne. Modele te często miały trudności z zadaniami, które wymagały głębokiego rozumowania, spójności logicznej i wieloetapowego rozwiązywania problemów. Aby rozwiązać te wyzwania, OpenAI wprowadziło GPT-4 i skierowało swoją uwagę na poprawę zdolności rozumowania swoich modeli. Ten kierunek doprowadził do rozwoju o1 i o3-mini. Obie te modele wykorzystywały metodę tzw. chain-of-thought prompting, która pozwalała im generować bardziej logiczne i dokładne odpowiedzi poprzez rozumowanie krok po kroku. Podczas gdy o1 jest zaprojektowany do zaawansowanych potrzeb rozwiązywania problemów, o3-mini jest zbudowany w celu dostarczenia podobnych możliwości w bardziej wydajny i ekonomiczny sposób. Kontynuując tę podstawę, OpenAI wprowadziło teraz o3 i o4-mini, które dalej poprawiają zdolności rozumowania swoich LLM. Modele te są zaprojektowane do produkcji bardziej dokładnych i przemyślanych odpowiedzi, szczególnie w dziedzinach takich jak programowanie, matematyka i analiza naukowa — obszarach, w których precyzja logiczna jest kluczowa. W następnym rozdziale będziemy badać, jak o3 i o4-mini poprawiają swoich poprzedników.
Kluczowe postępy w o3 i o4-mini
Poprawione zdolności rozumowania
Jednym z kluczowych ulepszeń w o3 i o4-mini jest ich poprawiona zdolność rozumowania dla złożonych zadań. W przeciwieństwie do poprzednich modeli, które dostarczały szybkie odpowiedzi, o3 i o4-mini potrzebują więcej czasu na przetworzenie każdego promtu. Ten dodatkowy czas przetwarzania pozwala im na bardziej gruntowne rozumowanie i produkcję bardziej dokładnych odpowiedzi, co prowadzi do lepszych wyników w testach. Na przykład, o3 przewyższa o1 o 9% w LiveBench.ai, teście, który ocenia wydajność w wielu złożonych zadaniach, takich jak logika, matematyka i kod. Na SWE-bench, który testuje rozumowanie w zadaniach inżynierii oprogramowania, o3 osiągnął wynik 69,1%, przewyższając nawet konkurencyjne modele, takie jak Gemini 2.5 Pro, który uzyskał 63,8%. Tymczasem o4-mini uzyskał 68,1% w tym samym teście, oferując niemal taką samą głębokość rozumowania przy znacznie niższych kosztach.
Wielomodalna integracja: Myślenie z obrazami
Jedną z najbardziej innowacyjnych cech o3 i o4-mini jest ich zdolność do “myślenia z obrazami”. Oznacza to, że mogą one nie tylko przetwarzać informacje tekstowe, ale także integrować dane wizualne bezpośrednio w procesie rozumowania. Mogą one rozumieć i analizować obrazy, nawet jeśli są one niskiej jakości — takie jak notatki odręczne, szkice lub diagramy. Na przykład, użytkownik mógłby przesłać diagram złożonego systemu, a model mógłby go przeanalizować, zidentyfikować potencjalne problemy lub nawet zaproponować ulepszenia. Ta zdolność zamyka lukę między danymi tekstowymi a wizualnymi, umożliwiając bardziej intuicyjne i kompleksowe interakcje z AI. Obie te modele mogą wykonywać czynności takie jak powiększanie szczegółów lub obracanie obrazów, aby lepiej je zrozumieć. To wielomodalne rozumowanie jest znaczącym postępem w porównaniu z poprzednikami, takimi jak o1, które były głównie oparte na tekście. Otwiera nowe możliwości dla aplikacji w dziedzinach takich jak edukacja, gdzie pomoce wizualne są kluczowe, i badania, gdzie diagramy i wykresy są często centralne dla zrozumienia.
Zaawansowane użycie narzędzi
o3 i o4-mini są pierwszymi modelami OpenAI, które wykorzystują wszystkie dostępne narzędzia w ChatGPT jednocześnie. Narzędzia te obejmują:
- Przeglądanie sieci: Pozwala modelom na pobieranie najnowszych informacji dla zapytań wrażliwych na czas.
- Wykonanie kodu Python: Umożliwia im wykonywanie złożonych obliczeń lub analizy danych.
- Przetwarzanie i generowanie obrazów: Ulepsza ich zdolność do pracy z danymi wizualnymi.
Poprzez zastosowanie tych narzędzi, o3 i o4-mini mogą rozwiązywać złożone, wieloetapowe problemy bardziej skutecznie. Na przykład, jeśli użytkownik zadaje pytanie wymagające bieżących danych, model może przeprowadzić wyszukiwanie w sieci, aby pobrać najnowsze informacje. Podobnie, w przypadku zadań wymagających analizy danych, może on wykonać kod Python, aby przetworzyć dane. Ta integracja jest znaczącym krokiem w kierunku bardziej autonomicznych agentów AI, które mogą obsługiwać szerszy zakres zadań bez interwencji człowieka. Wprowadzenie Codex CLI, lekkiego, otwartego agenta programistycznego, który współpracuje z o3 i o4-mini, dalej zwiększa ich użyteczność dla deweloperów.
Wnioski i nowe możliwości
Wydanie o3 i o4-mini ma szerokie implikacje w różnych branżach:
- Edukacja: Modele te mogą pomagać studentom i nauczycielom, dostarczając szczegółowe wyjaśnienia i pomoce wizualne, czyniąc naukę bardziej interaktywną i skuteczną. Na przykład, student mógłby przesłać szkic problemu matematycznego, a model mógłby dostarczyć rozwiązanie krok po kroku.
- Badania: Mogą one przyspieszyć odkrycia, analizując złożone zestawy danych, generując hipotezy i interpretując dane wizualne, takie jak wykresy i diagramy, co jest niezwykle cenne w dziedzinach takich jak fizyka czy biologia.
- Przemysł: Mogą one optymalizować procesy, poprawiać podejmowanie decyzji i ulepszać interakcje z klientami, obsługując zarówno tekstowe, jak i wizualne zapytania, takie jak analiza projektów produktów lub rozwiązywanie problemów technicznych.
- Kreatywność i media: Autorzy mogą używać tych modeli, aby przekształcić zarys rozdziału w prosty storyboard. Muzykom dopasowują wizualizacje do melodii. Redaktorzy filmowi otrzymują sugestie dotyczące tempa. Architekci konwertują ręcznie narysowane plany pięter w szczegółowe plany 3D, które zawierają notatki strukturalne i związane z zrównoważonym rozwojem.
- Dostępność i włączenie: Dla użytkowników niewidomych, modele opisują obrazy w szczegółach. Dla użytkowników głuchych, konwertują diagramy w sekwencje wizualne lub podpisane teksty. Ich tłumaczenie zarówno słów, jak i wizualizacji pomaga przezwyciężyć bariery językowe i kulturowe.
- Ku autonomicznym agentom: Ponieważ modele mogą przeglądać sieć, wykonywać kod i przetwarzać obrazy w jednym workflow, tworzą one podstawę dla autonomicznych agentów. Deweloperzy opisują funkcję; model pisze, testuje i wdraża kod. Pracownicy mogą delegować gromadzenie danych, analizę, wizualizację i pisanie raportów do jednego asystenta AI.
Ograniczenia i co dalej
Pomimo tych postępów, o3 i o4-mini nadal mają ograniczenie wiedzy do sierpnia 2023 r., co ogranicza ich zdolność do odpowiedzi na najnowsze wydarzenia lub technologie, chyba że zostaną uzupełnione przez przeglądanie sieci. Przyszłe iteracje prawdopodobnie rozwiążą tę lukę, poprawiając pobieranie danych w czasie rzeczywistym.
Możemy również oczekiwać dalszego postępu w autonomicznych agentach AI — systemach, które mogą planować, rozumieć, działać i uczyć się ciągle z minimalnym nadzorem. Integracja OpenAI narzędzi, modeli rozumowania i dostępu do danych w czasie rzeczywistym sygnalizuje, że zbliżamy się do takich systemów.
Podsumowanie
Nowe modele OpenAI, o3 i o4-mini, oferują ulepszenia w rozumowaniu, wielomodalnym zrozumieniu i integracji narzędzi. Są one bardziej dokładne, wszechstronne i użyteczne w szerokim zakresie zadań — od analizy złożonych danych i generowania kodu po interpretację obrazów. Te postępy mają potencjał znacząco zwiększyć produktywność i przyspieszyć innowacje w różnych branżach. timodal understanding, and tool integration. They are more accurate, versatile, and useful across a wide range of tasks—from analyzing complex data and generating code to interpreting images. These advancements have the potential to significantly enhance productivity and accelerate innovation across various industries.





